AI 추론 시대의 메모리 구원투수 Compute Express Link(CXL): 기술적 본질, 3대 병목, 그리고 투자 전략 보고서

그동안 AI 반도체 시장의 주연은 HBM(고대역폭메모리)이었지만, AI 서비스의 축이 ‘학습(Training)’에서 ‘추론(Inference)’으로 이동함에 따라 메모리 용량과 운용 비용(TCO)의 병목이 심화되고 있습니다. 이러한 상황에서 CXL은 HBM의 물리적·경제적 한계를 완벽히 보완할 핵심 솔루션으로 손꼽히고 있습니다.
📑 목차 (Table of Contents)
- 서론: 왜 지금 CXL인가? (AI 추론 시대의 메모리 대전환)
- 개념과 작동 원리: 직관적 이해부터 하드웨어 구조까지
- 표준 발전사
- HBM vs CXL: 대립 관계인가, 상호보완적 동반자인가?
- 상용화를 가로막는 3대 핵심 병목 (Bottlenecks)
- 글로벌 밸류체인 및 생태계 기업 지도 (Ecosystem Map)
- 투자자를 위한 단기 vs 중장기 프레임워크 & 포트폴리오 전략
- 결론 및 최종 요약
1. 서론: 왜 지금 Compute Express Link인가?
생성형 AI 패러다임이 급격히 진화하면서 빅테크 및 데이터센터들의 인프라 구축 우선순위가 크게 바뀌고 있습니다. 초기에는 ChatGPT, Claude 등 대규모 언어모델(LLM)을 빠르게 연산·학습시키기 위해 초고속 대역폭을 가진 HBM(High Bandwidth Memory) 중심의 GPU 인프라 확충이 사활을 걸었던 과제였습니다.
그러나 GPT-4o, Gemini, Claude 3.5 등 초거대 멀티모달 모델들이 대중적인 서비스로 정착하면서, 데이터센터의 핵심 지표는 단순한 연산 파워에서 ‘추론 비용 절감 및 대용량 맥락 처리’로 이동했습니다.
💡 추론형 AI의 핵심 병목: KV 캐시(Key-Value Cache)의 폭발적 증가
추론형 AI 서비스의 가장 큰 특징은 수많은 사용자가 동시에 길고 복잡한 대화를 주고받는다는 점입니다. 이때 AI 모델이 이전 대화의 문맥(Context)을 기억하고 유기적인 답변을 생성하기 위해 필연적으로 생성·저장하는 데이터가 바로 ‘KV 캐시(Key-Value Cache)’입니다.
- 문제점: 대화의 길이가 길어지고 컨텍스트 윈도우(Context Window)가 커질수록 KV 캐시 데이터는 기하급수적으로 증가합니다.
- HBM의 한계: GPU 바로 옆에 붙어 있는 HBM은 연산 속도는 극도로 빠르지만, 가격이 매우 비싸고 GPU 당 장착할 수 있는 물리적 용량(VRAM)에 엄격한 한계가 존재합니다.
- 해결책의 등장: 비싸고 용량이 작은 HBM에 대용량 KV 캐시를 모두 담을 수 없게 되면서, ‘HBM에는 당장 연산할 Hot Data만 두고, 대용량 KV 캐시는 CXL 메모리로 이관한다’는 새로운 메모리 계층화 전략이 성립하게 되었습니다.
삼성전자, SK하이닉스, 마이크론 등 메모리 3사가 최근 미국 FMS(Future Memory and Storage) 2026 등 글로벌 반도체 학회에서 CXL 기술을 전면에 내세우는 이유가 바로 여기에 있습니다.
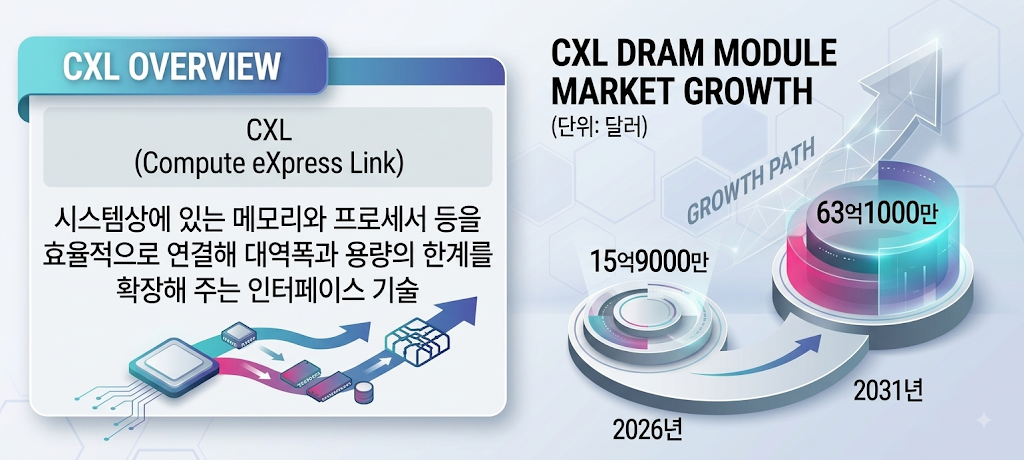
2. 기본 개념과 작동 원리: 직관적 이해부터 하드웨어 구조까지
2.1 직관적 개념: “메모리를 유연하게 나눠 쓰는 고속 고속도로”
기존 컴퓨팅 메인보드 구조에서는 CPU나 GPU에 D램 슬롯이 물리적으로 직접 결합되어 있었습니다. 마더보드 슬롯 수가 제한되어 있어 서버 1대가 쓸 수 있는 메모리 최대 용량도 고정되었습니다.
이로 인해 전통적인 데이터센터에는 ‘유휴 메모리(Stranded Memory)’ 문제가 발생했습니다:
- 기존 구조: A 서버는 메모리가 70% 남아돌고, B 서버는 메모리가 부족해 시스템이 버벅거립니다. 하지만 각자 자기 슬롯에 꽂힌 메모리만 쓸 수 있어 A 서버의 남는 메모리를 B 서버에 나눠줄 방법이 없습니다.
- CXL 구조: PCIe(그래픽카드를 꽂는 고속 슬롯 규격)를 기반으로 고성능 인터커넥트망을 구축합니다. Compute Express Link 스위치에 여러 서버와 메모리를 연결하여 하나의 ‘공용 저수지(Memory Pool)’로 묶습니다. 필요한 서버가 필요한 순간에 필요한 만큼 메모리를 동적으로 가져다 쓰고 반납하는 구조입니다.
2.2 Compute Express Link 의 3가지 핵심 프로토콜 구조
Compute Express Link 규격은 PCIe 물리 계층(PHY) 위에서 세 가지 상위 프로토콜을 결합하여 가동됩니다:
- CXL.io: 기존 PCIe 5.0/6.0 규격과 완전히 동일한 입출력(I/O) 프로토콜로, 장치 검색, 초기화, 오류 보고 등을 담당합니다. (모든 CXL 장치의 필수 기본층)
- CXL.cache: GPU, NPU 등 가속기 장치가 호스트 CPU의 메인 메모리를 극도로 낮은 지연시간(Latency)으로 직접 캐시 일관성(Cache Coherency)을 유지하며 읽고 쓸 수 있게 지원합니다.
- CXL.mem: 호스트 CPU나 GPU가 로드/스토어(Load/Store) 명령어를 사용해 외부 CXL 메모리 모듈에 직접 접근할 수 있도록 하는 핵심 프로토콜입니다.
3. Compute Express Link 표준 발전사
Compute Express Link 컨소시엄은 2019년 출범 이래 가파른 속도로 표준 고도화를 추진해 왔습니다.
| 규격 구분 | CXL 1.0 / 1.1 (2019) | CXL 2.0 (2020) | CXL 3.0 / 3.1 / 3.2 (2022~2026) |
| 핵심 연결 방식 | Point-to-Point (1:1 직접 연결) | Switch 기반 (1:N 메모리 풀링) | Fabric 기반 (N:M 대규모 메모리 공유) |
| 주요 기능 | CPU-메모리간 직접 물리적 용량 확장 | 서버간 유휴 메모리 동적 할당 지원 | P2P 직통 통신, Multi-head 장치, 랙(Rack) 단위 풀링 |
| 기반 PCIe | PCIe 5.0 (32 GT/s) | PCIe 5.0 (32 GT/s) | PCIe 6.0 / 7.0 (64 ~ 128 GT/s) |
| 상용화 현황 | PoC 완료 및 가이던스 정립 | 서버 CPU(Intel Xeon, AMD EPYC) 지원 | 메모리 3사 샘플링 완료, 하이퍼스케일러 테스트 진입 |
- 현재 위치(2026년 기준): CXL 2.0/3.2 기반 메모리 모듈(CMM-D 등) 샘플 검증(PoC)이 마무리 단계에 있으며, 글로벌 하이퍼스케일러(MS Azure, Meta, Google, AWS) 환경에서 초기 파일럿 배포 및 양산 조율이 진행되는 ‘초기 상용화의 분기점’입니다.
4. HBM vs CXL: 대립 관계인가, 상호보완적 동반자인가?
투자 시장에서 가장 빈번하게 발생하는 오해는 “CXL이 HBM을 대체하여 HBM 시장이 위축되는 것 아닌가?”라는 질문입니다. 결론부터 명확히 밝히면 CXL과 HBM은 대체재가 아닌 완벽한 역할 분담 관계(보완재)입니다.

실제로 삼성전자의 최근 논문 발표에 따르면, 긴 대화 맥락 환경에서 KV 캐시를 CXL D램으로 이관했을 때 GPU VRAM만 단독 사용한 환경 대비 추론 처리량이 최대 9배 향상되었고, 첫 토큰 생성 시간(Time-to-First-Token)이 최대 16분의 1로 단축되는 성과를 보였습니다.
5. 상용화를 가로막는 3대 핵심 병목 (Bottlenecks)
Compute Express Link 의 장점에도 불구하고, 데이터센터 현장에서의 대규모 확산을 가로막는 엔지니어링 및 생태계 차원의 병목은 크게 3가지로 나뉩니다.
상용화의 3대 병목 (Bottlenecks)

1. Hardware & Latency       로컬 DDR 대비 2~3배 긴 지연시간
2. Software & Orchestration OS/커널 레벨 Hot/Cold 페이지 이동
3. Ecosystem & Dynamic    NVLink 독점 및 메모리사 수익성
① 하드웨어 & 지연시간(Latency) 오버헤드
- 물리적 차이: CPU 컨트롤러에 직결된 메인 D램 지연시간이 약 60~80ns인 반면, CXL 메모리는 PCIe PHY + CXL 컨트롤러 + CXL 스위치 패브릭을 거치기 때문에 지연시간이 약 150~250ns로 2~3배 깁니다.
- 대응책: 1나노초의 연산 주기가 중요한 GPU 핵심 계산 루프 데이터(Hot Data)를 CXL에 두면 전체 연산 속도가 떨어지므로, 오직 캐시용 데이터(Warm/Cold Data)로 철저히 분리 제어해야 합니다.
② 소프트웨어 스택 & OS 오케스트레이션
- NUMA 노드 인식과 Page Tiering: 리눅스 커널 등 OS 레벨에서 CXL 메모리는 로컬 메모리가 아닌 별도의 NUMA(Non-Uniform Memory Access) 노드로 인식됩니다.
- 소프트웨어 최적화: 자주 쓰는 메모리 페이지를 메인 D램으로 올리고, 덜 쓰는 페이지를 CXL로 넘기는 ‘Page Tiering’ 알고리즘이 실시간으로 오류 없이 작동해야 하나, 현재 SW 스택은 고도화 과정에 있습니다.
③ 생태계 역학: 엔비디아 NVLink 독점 & 메모리 3사의 자기잠식(Cannibalization) 딜레마
- 엔비디아 NVLink의 지배력: 엔비디아는 GPU 간 대용량 통신망으로 자사 독점 규격인 NVLink(6세대 기준 초당 3.6TB 대역폭)를 우선시합니다. 엔비디아 입장에서 CXL은 GPU 내부 통신망이 아닌 “외부 대용량 캐시 확장용” 정도로만 역할이 한정되길 바랍니다.
- 메모리 IDM의 자기잠식 우려: CXL 풀링이 완벽해지면 서버 1대당 필요한 expensive 메인보드 전용 DIMM D램의 개수가 줄어들 수 있습니다. 이 때문에 삼성전자, SK하이닉스, 마이크론 등은 범용 D램 수요를 스스로 갉아먹는 자기잠식(Cannibalization) 효과를 경계하며 시장 속도를 조절하고 있습니다.
6. Compute Express Link 글로벌 밸류체인 및 생태계 기업 지도 (Ecosystem Map)
Compute Express Link 생태계는 메모리 IDM, 컨트롤러/스위치 팹리스, 반도체 IP 기업, 데이터센터 CPU 제조사, 그리고 검사장비/소부장 기업으로 세분화됩니다.
| 구분 | 핵심 참여 기업 | 핵심 역할 및 주요 제품 |
| 메모리 IDM | 삼성전자, SK하이닉스, 마이크론 | • 삼성: CMM-D(MD220, MD310), CXL 3.2 양산 조율 • SK하이닉스: CXL 3.2 샘플, CMM-Ax(근전동 연산형) 개발 • 마이크론: FMS 2026 CXL 메모리 솔루션 전면 공개 |
| 컨트롤러 & 스위치 (팹리스) | Astera Labs, Marvell, Montage, XConn | • Astera Labs (ALAB): CXL 리타이머 및 스위치(Scorpio) 독점적 지위 • Marvell: Tanzanite 인수 후 Structera A 플랫폼 고도화 • Montage / XConn: CXL 3.0/4.0 스위치 실리콘 제작 |
| IP & 인터페이스 | Rambus, Synopsys, Cadence | • CXL 3.0/4.0 패브릭용 PHY, 컨트롤러 핵심 반도체 IP 라이선스 공급 |
| CPU & 플랫폼 | Intel, AMD | • Intel Xeon, AMD EPYC 서버 CPU 내 CXL 2.0/3.0 컨트롤러 표준 내장 |
| 국내 소부장 / 검사장비 | 네오셈, 엑시콘, 큐알티 | • 네오셈: 세계 최초 CXL 검사장비 상용화, CXL 테마 대장주 • 엑시콘: CXL 1.1/2.0 테스터 및 차세대 테스터 공급 • 큐알티: CXL 신뢰성 평가 및 품질 검사 서비스 |
| 국내 IP / 팹리스 | 오픈엣지테크놀로지, 퀄리타스반도체 | • 오픈엣지: CXL 컨트롤러 개발용 메모리 컨트롤러 IP 보유 • 퀄리타스: CXL용 고속 인터페이스 PHY IP 제공 |
7. 투자자를 위한 단기 vs 중장기 프레임워크 & 포트폴리오 전략
투자자의 시각에서 HBM이 ‘초고속 연산(High Speed)’을 담당하는 주연이라면, Compute Express Link 는 ‘대용량 확장(High Capacity)’을 담당하는 최고 효율의 조연입니다.
7.1 타임라인별 투자 프레임워크

- 단기 관점 (~1년): “수주 모멘텀과 검사장비”
- 삼성전자와 SK하이닉스의 CXL 3.2 양산 스케줄 및 글로벌 하이퍼스케일러 테스트 소식에 따라 국내 소부장(네오셈, 엑시콘)과 IP 기업들의 주가 탄력성이 높게 나타납니다.
- 뉴스 모멘텀에 따른 기술적 눌림목 매수 전략이 유효합니다.
- 중장기 관점 (2~5년): “패브릭 대개막과 실적 중심 리레이팅”
- 2027년 이후 3.0/3.2 스위치를 통한 랙(Rack) 단위 메모리 풀링이 본격 구동됩니다.
- 컨트롤러 독점 기업(Astera Labs) 및 메모리 대형주의 펀더멘털 실적이 본격 반영되며 PER 중심의 정석적인 상승 장세가 연출될 것입니다.
7.2 포트폴리오 비중 전략 가이드
맞춤형 포트폴리오 자산 배분
 ■ 안정형 (60%): 삼성전자 / SK하이닉스
 - HBM 업황 수혜 기본 탑재 + CXL 시장 개막 시 멀티플 상향

 ■ 성장형 (30%): Astera Labs (ALAB)
 - 리타이머/스위치 글로벌 시장 독점력 보유 핵심 고성장주

 ■ 공격형 (10%): 네오셈 / 엑시콘 / 오픈엣지테크놀로지
 - 검사장비 수주 및 IP 모멘텀 기반 높은 시세 탄력성
8. 결론 및 최종 요약
Compute Express Link 은 일시적인 단기 테마가 아닙니다. AI 데이터센터가 추론 비용 절감(TCO 혁신)이라는 거대한 벽을 넘기 위해 반드시 도입해야만 하는 메모리 패러다임의 근본적 대전환입니다.
- 기술적 본질: CXL은 HBM을 대체하는 것이 아니라, HBM이 담지 못하는 대용량 KV 캐시와 유휴 메모리를 효율적으로 제어하는 ‘계층형 메모리 구조의 핵심 축’입니다.
- 상용화 시점: 2026년 현재 PoC 검증을 끝내고 CXL 3.2 기반 초기 양산 단계에 진입 중이며, 2027년 하이퍼스케일러 데이터센터 본격 채택이 분기점이 될 것입니다.
- 투자 방향: 단기적으로는 검사장비 및 IP 종목의 모멘텀을 활용하되, 중장기적으로는 글로벌 Compute Express Link 패브릭 시장을 독점하는 컨트롤러 팹리스 및 메모리 대형주 중심으로 포트폴리오를 구성하는 지혜가 필요합니다.
관련 기사:
답글 남기기