반도체 산업 역사에서 메모리 미세화(Design Rule Scaling) 한계 극복은 늘 새로운 성장의 신호탄이었습니다. 2026년 10월, 중국의 대표 DRAM 제조사인 창신메모리(CXMT)가 상하이에서 열린 제4회 집적칩·칩렛 컨퍼런스를 통해 차세대 4F² DRAM 아키텍처 기반 DDR5 RDIMM 서버 메모리를 2026년 말 이전에 출시하겠다는 파격적인 로드맵을 발표했습니다.
기존 6F² 구조에서 4F² 아키텍처로의 전환은 단순한 선폭 줄이기(Shrink)를 넘어, 셀 트랜지스터를 수직으로 세우는 3D 스케일링의 첫 단계입니다. 본 포스팅에서는 4F²의 물리적·공학적 메커니즘, 글로벌 DRAM 4사(삼성전자, SK하이닉스, 마이크론, CXMT)의 최신 로드맵, 시장 영향도 및 주가 파급력, 그리고 반도체 투자자를 위한 명확한 대응 전략을 전문적으로 분석합니다.
1. 4F² 셀 구조의 핵심 메커니즘과 공정 난제 심층 분석
① 6F²에서 4F²로의 불가피한 이동 (물리적 한계의 돌파)
현재 상용화된 2D 평면 DRAM 시장은 6F² 구조가 표준입니다. 여기서 F(Feature Size)는 반도체 Lithography 공정으로 그릴 수 있는 최소 선폭을 의미하며, 셀 하나가 차지하는 평면 면적은 가로 3Fx세로 2F = 6F²의 직사각형 구조를 가집니다.
10nm 이하 노드(Sub-10nm)의 한계: DRAM 선폭이 10나노미터 미만(1a, 1b, 1c, 0a 등)으로 축소됨에 따라, 눕혀진 형태의 채널을 사용하는 매립 채널 어레이 트랜지스터(BCAT, Buried Channel Array Transistor) 구조는 단채널 효과(Short-Channel Effect)에 직면했습니다. 채널 길이가 지나치게 짧아지면서 소스(Source)와 드레인(Drain) 간 누설 전류(Leakage Current)를 제어할 수 없는 물리학적 장벽에 부딪힌 것입니다.
4F² (2F × 2F)의 기하학적 이점: 4F²는 한 셀의 면적을 가로 2F x세로 2F = 4F² 정사각형 형태로 재설계합니다. 셀 면적이 약 33% 단축되어 이론상 동일한 웨이퍼 크기에서 비트 집적도(Bit Density)를 30~50% 향상시킬 수 있습니다. 평면 면적은 줄이면서도 채널을 수직(Vertical)으로 세우기 때문에, 수직 방향의 채널 길이를 충분히 확보하여 누설 전류를 억제할 수 있습니다.
② 수직 트랜지스터(VSG/VCT) 구현의 엔지니어링 4대 난제
이론적 유용성에도 불구하고 4F² 상용화가 10년 이상 지연된 이유는 공정 통합(Process Integration) 난이도가 극도로 높기 때문입니다.
구분
공정 난제
상세 내용 및 기술적 해결책
1
플로팅 바디 효과
(Floating Body Effect)
수직 트랜지스터 구조상 바디(Body)가 공중에 뜨는 형태가 되어 기판으로 전하가 빠져나가지 못합니다. 전하 누적 시 딥 슬럼프(Threshold Voltage 변동)나 데이터 손실이 발생하여 비활성 소자 설계가 필수적입니다.
2
채널 재료의 신혁신
(Silicon ->IGZO)
기존 실리콘(Si) 채널은 수직 게이트의 360도 전계 제어력에 한계가 있습니다. 삼성전자 등 선도사는 Off-state 전류가 거의 제로에 가까운 IGZO(인듐-갈륨-아연 산화물) 등 산화물 반도체 채널 도입을 연구 중입니다.
3
게이트 금속 저항 극복
(TiN -> Molybdenum)
셀 간격이 수 나노미터로 좁아짐에 따라 게이트 저항이 급증하여 신호 지연(RC Delay)을 초래합니다. 기존 질화티타늄(TiN)을 저항이 대폭 낮은 몰리브덴(Mo) 신소재로 대체하는 공정 전환이 요구됩니다.
4
HARC 식각 & 3D 배선
셀 하부에 주변 회로를 배치하는 PUC(Periphery Under Cell) 구조와 연계하여 깊고 좁은 구멍을 뚫는 HARC(High Aspect Ratio Contact) 식각 공정 난이도가 수직 상승합니다.
2. Global DRAM 4사 로드맵 및 기술 접근법 비교
4F² 및 차세대 3D DRAM을 향한 글로벌 4사의 기술 전략은 뚜렷한 차이점을 보이고 있습니다.
글로벌 4사 핵심 로드맵 세부 비교
회사명
핵심 기술명
목표 시점
핵심 전략 및 공정 특징
CXMT
(창신메모리)
VSG
(Vertical Surrounding Gate)
2026년 말
(DDR5 RDIMM)
독자 VSG 기술 공개. DUV 기반으로 노광 장비 제재를 우회하기 위한 구조적 스케일링 전략.
삼성전자
VCT
(Vertical Channel Transistor)
2026년 개발
2028년 양산
10a 공정 웨이퍼에서 동작 다이(Die) 확인 완료. 10a, 10b, 10c 노드에 VCT 적용 후 10d부터 3D DRAM 전환.
SK하이닉스
VG Platform
(Vertical Gate)
0a/0b 노드
(2028~2029년)
IEEE VLSI 심포지엄을 통해 로드맵 공개. 웨이퍼 본딩(Wafer Bonding) 기반 PUC 구조 결합으로 전기적 특성 극대화.
마이크론
3D DRAM 직행
2030년 전후
4F² 단계를 건너뛰고 128단 이상의 3D DRAM 구조로 직행하는 파격적 아키텍처 스킵 전략 추진.
CXMT의 “2026년 말 연내 공개” 선언에 대한 엔지니어링적 시각
CXMT의 발표는 기술적 신선함을 주지만, 반도체 제조 공학적 관점에서는 신중한 해석이 필요합니다.
개발 성공(Prototype)과 상용 양산(Mass Production)의 격차: 연구소 단계에서 동작하는 시제품을 확보한 것과, 70% 이상의 수율(Yield)로 매달 수만 장의 웨이퍼를 안정적으로 출하하는 것은 차원이 다른 문제입니다.
서버용 DDR5 RDIMM의 높은 인증 장벽: PC나 모바일용 메모리와 달리, 서버용 RDIMM은 인텔(Intel) 및 AMD의 데이터센터 플랫폼 인증과 델, HP 등 주요 OEM의 엄격한 RAS(Reliability, Availability, Serviceability) 테스트를 통과해야 합니다. 신뢰성이 입증되지 않은 4F² 칩은 서버 시장 진입이 불가능합니다.
3. 시장 영향 분석 및 향후 기술 전망
① CXMT의 무서운 점유율 추이와 원가 압박
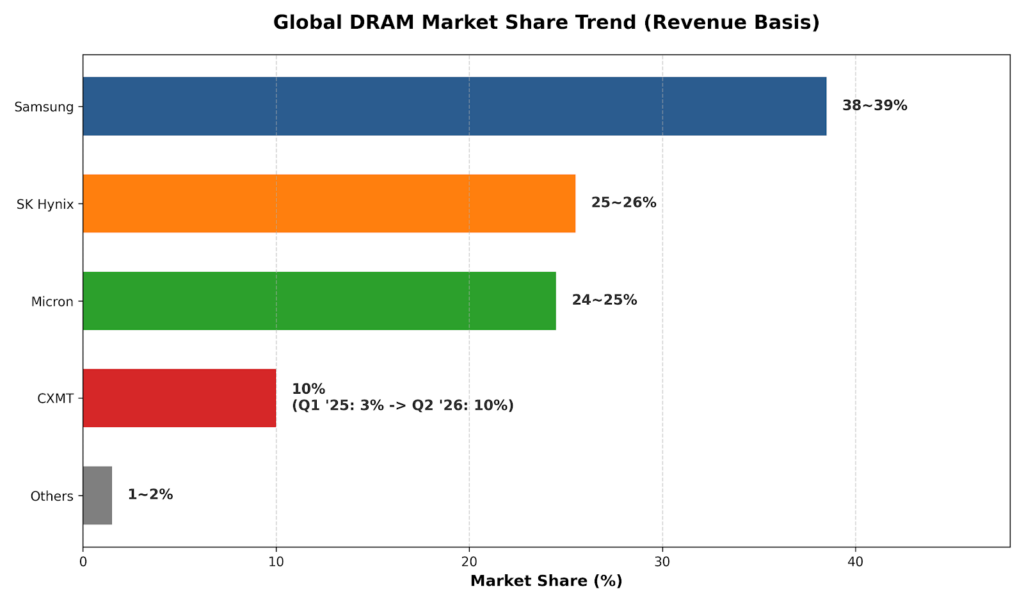
Counterpoint 및 업계 데이터에 따르면, CXMT의 글로벌 DRAM 시장 점유율(매출 기준)은 2025년 1분기 약 3%에서 2026년 2분기 10% 수준까지 급상승하며 글로벌 4위 공급사로 자리매김했습니다.
저가 공세의 고도화: CXMT는 이미 범용 DRAM(DDR4, LPDDR4X) 가격을 한국 3사 대비 20~30% 낮게 형성하며 시장을 잠식해 왔습니다. 여기에 4F² 적용으로 웨이퍼당 넷다이(Net Die) 수율이 늘어난다면 원가 경쟁력은 더욱 막강해집니다.
미국 반도체 제재의 우회 수단: EUV(극자외선) 노광 장비 수입이 봉쇄된 CXMT 입장에서, DUV 패터닝 한계를 극복하고 비트 성장을 이룰 수 있는 유일한 열쇠가 바로 ‘4F² 셀 구조 전환’입니다.
② 한국 메모리 양사(삼성전자·SK하이닉스)에 미치는 파급 효과
단기 영향 (주가 변동성 증대): CXMT 발표 직후 국내 양사 주가가 3% 이상 하락한 것은 중국 기술 추격에 대한 시장 심리적 위축(Overhang) 때문입니다.
중장기 영향 (프리미엄 시장과의 양극화): HBM(고대역폭 메모리) 기술에서 CXMT는 한국 기업에 최소 3~4세대 이상 격차를 보이고 있습니다. AI 서버용 HBM3e 및 HBM4, 고성능 DDR5 시장에서는 K-메모리의 기술적 도미넌스가 유지될 것입니다.
4. 엔지니어링 관점의 향후 전망 (Key Watch Points)
앞으로의 반도체 시장 주도권을 결정지을 3대 핵심 관전 포인트는 다음과 같습니다.
CXMT 실체 검증 (2026년 말 ~ 2027년 초)CXMT가 선보일 4F² DDR5 RDIMM의 상용 수율(70% 이상) 달성 여부와 실효 성능 스펙 확인.
삼성전자의 VCT 차별화 전략 (2026~2027년)삼성전자 10a 노드 기반 VCT 개발 완료 및 IGZO 채널·몰리브덴 게이트 공정의 완벽한 수율 정착 여부.
3D DRAM으로의 진화 속도 (2028년 이후)4F²가 평면 스케일링의 ‘마지막 교량(Bridge)’ 역할을 성공적으로 수행하고 128단 이상 3D DRAM으로 순탄하게 진입하는지 여부.
5. 금융 투자 관점: 단기·중장기 대응 전략
📉 단기적 관점 (6개월 ~ 1년): 센티먼트 악화에 따른 보수적 접근
투자 판단: 중립 (Neutral)
분석: CXMT의 점유율 확대 발표는 센티먼트를 약화시킬 수 있습니다. 다만 선도 기업들의 AI용 HBM 및 고성능 DDR5 타이트 현상이 지속되고 있어 실제 실적 훼손 폭은 제한적입니다. 단기 주가 조정을 저가 매수 기회로 포착하는 유연성이 필요합니다.
📈 중장기적 관점 (2년 ~ 5년): 선도업체 독주 및 포트폴리오 차별화
투자 판단: 매수 (BUY)
분석: EUV 보유 여부는 4F² 수율을 좌우하는 결정적 요소입니다. SAQP(4중 패터닝)로 우회해야 하는 CXMT는 공정 수 증가로 인한 원가 상승 한계에 직면할 것입니다. 반면 EUV 인프라를 확립한 삼성전자와 SK하이닉스는 2027~2028년 고수율 4F² 양산에 성공하여 프리미엄 메모리 시장을 완전히 지배할 것입니다.
[ 반도체 투자자 핵심 액션 플랜 ]

1. 범용 DRAM 비중 축소  --> HBM4 / 차세대 4F² 수혜주로 이동
2. 노광/식각 장비주 주목 --> 수직 채널 HARC 식각, 신소재(Mo/IGZO) 관련주 관심
3. 기술 변곡점 확인 후   --> 2026년 말 CXMT 실제 수율 및 삼성 10a Qual 결과 확인 후 추매
결론: 패러다임 전환이 가져올 메모리 반도체의 미래
CXMT의 4F² DRAM 기술 발표는 단순한 중국 반도체의 추격을 넘어, 전 세계 DRAM 아키텍처가 평면 6F² 시대를 종식하고 수직 4F² 및 3D DRAM 시대로 진입했음을 선언한 사건입니다.
기술적 난제와 수율 검증이라는 산이 남아있지만, 이번 발표는 글로벌 DRAM 메이커들의 기술 개발 경쟁을 가속화할 것입니다. 반도체 투자자들은 단기적인 시장 노이즈에 흔들리기보다, 기술 격차를 주도하는 고부가가치 HBM 및 차세대 VCT 기술을 선점한 선도 기업 중심으로 긴 호흡의 투자를 이어나가야 할 때입니다.
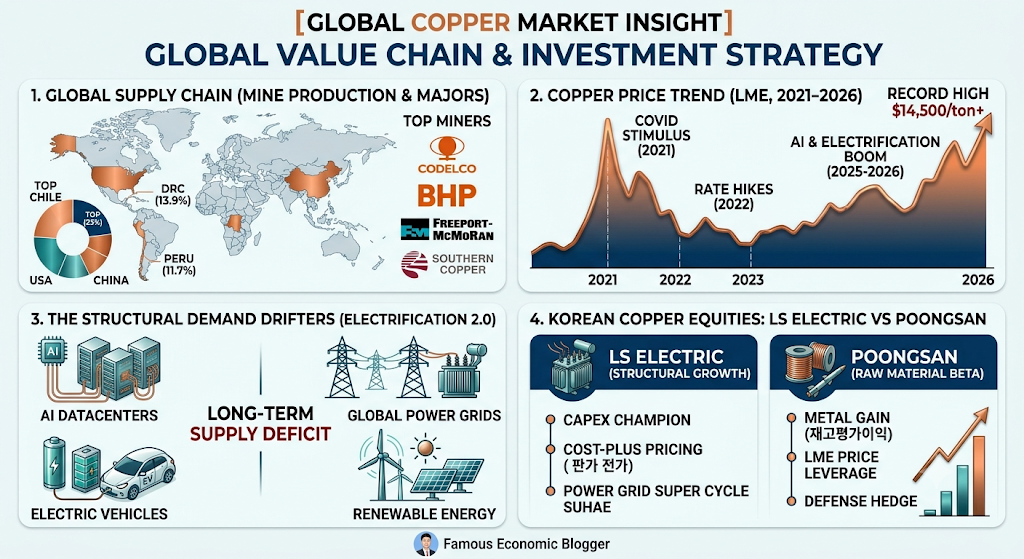
최근 원자재 시장의 가장 뜨거운 화두는 단연 ‘구리(Copper)’입니다. 2026년 현재, 런던금속거래소(LME) 구리 가격은 역사적 최고점 부근인 톤당 14,000달러를 상회하며 원자재 시장의 새 역사를 쓰고 있습니다. 과거 실물 경기의 가늠자 역할을 해서 ‘닥터 코퍼(Dr. Copper)’라 불리던 구리가, 이제는 경기를 넘어 ‘AI 데이터센터’, ‘전력망 전대응(Electrification 2.0)’, ‘신재생 에너지’라는 문명사적 대전환의 핵심 쌀로 부상했습니다.
오늘 포스팅에서는 글로벌 구리 시장의 공급망 체계(채굴국가 및 글로벌 메이저 기업)부터, 전방 산업 소비 구조, 시세 흐름, 그리고 개인 투자자가 반드시 알아야 할 국내외 밸류체인 및 핵심 기업의 손익 메커니즘 차이까지 정밀하게 파헤쳐 보겠습니다.
1. 글로벌 구리 공급망 정밀 분석: 채굴 국가와 메이저 기업
구리(Copper) 시장의 메커니즘을 이해하기 위해서는 지정학적 공급망과 글로벌 채굴 메이저의 현황을 먼저 파악해야 합니다. 구리는 석유처럼 생산 지형이 극도로 편중되어 있어 공급 차질에 매우 취약한 구조를 가집니다.
(1) 주요 구리 채굴 국가 현황 (2025~2026년 기준)
순위
국가
연간 생산량 및 세계 비중
공급망 특성 및 주요 변수
1
🇨🇱 칠레
약 530~550만 톤 (약 23%)
세계 1위 생산국이나, 노후 광산의 광석 품위 저하 및 용수 부족 문제로 9년 만의 최저 생산량을 기록하는 등 만성적 공급 차질 노출
2
🇨🇩 콩고민주공화국 (DRC)
약 300만 톤대 (약 13.9%)
최근 몇 년간 중국 자본의 대대적 투자로 급성장하여 페루를 제치고 2위 안착. 다만 정치적 불안정과 물류 인프라 취약성 상존
3
🇵🇪 페루
약 250~260만 톤 (약 11.7%)
풍부한 매장량을 보유했으나, 정권 교체 및 지역 주민들과의 광산 갈등 등 정치·사회적 불안정이 최대 공급 변수로 작용
4
🇨🇳 중국
약 180만 톤
자국 내 채굴량은 수요 대비 턱없이 부족함. 대신 세계 최대 제련 능력을 바탕으로 원광 수입 및 재활용(Scrap) 의존도가 극도로 높음
5
🇺🇸 미국
약 110만 톤
신규 광산 개발에 대한 엄격한 환경 규제 및 인허가 지연으로 인해 자국 내 생산 확장 한계. 해외 광산 지분 인수에 집중
💡 핵심 인사이트: 전 세계 구리 공급의 35% 이상을 칠레와 페루 단 두 국가가 담당하고 있습니다. 남미 지역의 지정학적 이슈, 노후화된 광산 구조, 이상 기후로 인한 용수 난항은 구리 공급의 상시적 병목을 유발합니다.
(2) 글로벌 구리 채굴 메이저 기업
글로벌 구리 채굴 시장은 소수의 대형 광산 기업들이 과점하고 있습니다. 원자재 시세 상승 시 가장 강력한 실적 레버리지를 일으키는 주체들입니다.
코델코(Codelco, 칠레 국영): 오랜 기간 전 세계 1위 채굴 기업 지위를 유지해 왔으나, 광산 노후화와 투진 지연으로 최근 BHP와 1위 자리를 두고 치열하게 다투고 있습니다. (비상장)
BHP 그룹 (호주): 세계 최대의 동광인 칠레 에스콘디다(Escondida) 광산의 대주주로, 강력한 자본력을 바탕으로 글로벌 1위 채굴 기업으로 입지를 다지고 있습니다.
프리포트-맥모란 (Freeport-McMoRan / FCX, 미국): 인도네시아의 세계적 대형 광산인 그래스버그(Grasberg) 등을 보유한 대표적인 순수 구리(Pure Copper) 채굴 기업입니다.
서던코퍼 / 그루포 멕시코 (Southern Copper / SCCO): 세계 최대 수준의 구리 매장량을 보유하고 있으며, 채굴 원가가 매우 낮아 업계 최고 수준의 영업이익률을 자랑합니다.
기타 메이저: 글렌코어(Glencore), 앵글로아메리칸(Anglo American), 리오틴토(Rio Tinto), 안토파가스타(Antofagasta), 퍼스트퀀텀(First Quantum) 등이 시장을 과점하고 있습니다.
2. 구리 수요 체계와 최근 5년 시세 흐름
(1) 구리(Copper)를 소비하는 핵심 전방 산업과 글로벌 기업
구리(Copper)는 전기 전도율과 열전도율이 은(Ag) 다음으로 뛰어나면서도 가격 경쟁력을 갖춘 유일한 금속입니다. 따라서 전기가 통하는 모든 산업 생태계의 필연적 필수재입니다.
(2) 최근 5년간 구리 시세 궤적 및 주요 동인 (2021~2026)
구리 가격은 거시 경제 환경과 구조적 수요 변화를 극명하게 반영하며 거친 파동을 그려왔습니다.
2021년 (급등기): 코로나19 팬데믹 이후 전 세계적인 경기 부양책과 글로벌 공급망 차질이 맞물려 톤당 10,700달러를 돌파, 당시 사상 최고치를 경신했습니다.
2022년 (급락기): 러시아·우크라이나 전쟁 발발과 미 연준(Fed)의 급격한 금리 인상에 따른 글로벌 경기 둔화 우려로 톤당 7,000달러 선까지 가파르게 조정받았습니다.
2023년 (박스권 탐색): 중국의 리오프닝 기대감과 부동산 경기 침체 우려가 팽팽하게 맞서며 톤당 8,000~9,000달러 선에서 지루한 박스권 흐름을 보였습니다.
2024년 (재상승기): 광산 공급 차질 이슈와 인공지능(AI) 데이터센터 전력 수요가 본격 부각되며 5월 톤당 11,000달러를 넘어서며 2차 상승 파동을 연출했습니다.
2025년 (슈퍼사이클 진입): 칠레 국영기업 코델코의 생산량이 9년 만에 최저치로 떨어지고, 글로벌 AI 데이터센터 건설과 전력망 개체 수요가 폭증하며 연말 톤당 12,960달러까지 치솟았습니다.
2026년 현재 (역사적 신고가 진입 후 숨고르기): 2026년 8월, 미 연준의 금리 인하 기조 전환, 미국의 정제구리 관세 부과 논의, 지정학적 리스크(호르무즈 해협 등)가 겹치며 파운드당 $6.83(톤당 약 14,500~15,000달러 부근)까지 폭등하여 사상 최고가를 경신했습니다. 단, 최근(9월 중순 기준)은 단기 급등에 따른 차익실현과 미 연준의 금리 스탠스 재확인, 관세 유예 소식이 전해지며 톤당 14,200달러 안팎에서 숨고르기를 진행 중입니다.
3. 한국 구리 산업의 아이러니: “매장량 0%의 국가가 지닌 제련·가공의 강점”
많은 개인 투자자분들이 오해하는 대목이 있습니다. 국내 구리 관련주에 투자할 때 “한국에 구리 광산이 있는가?”라는 질문입니다. 결론부터 말씀드리면, 대한민국은 광산 채굴 관점에서는 완벽한 구리 무풍지대이자 수입 의존도 99.9%의 국가입니다.
(1) 국내 구리 매장량의 실체
대한민국의 핵심광물 33종 중 구리의 해외 의존도는 사실상 99.9%입니다. 과거 경상남도 일대(경남동광화대)에 소규모 동광상이 존재했으나, 광석 내 구리 함량(품위)이 극도로 낮고 규모의 경제가 나오지 않아 1980년대 이후 완전히 폐광되었습니다. 간혹 주식시장에서 “국내 대규모 구리 광산 발견”이라는 테마성 뉴스가 떠돌지만, 이는 상업적 가치가 전무한 단순 해프닝 혹은 부풀리기 사건에 불과합니다.
(2) 세계 2위 제련소를 보유한 대반전 구조
원광 생산량이 ‘0’에 가까움에도 불구하고, 한국은 세계적 수준의 구리 제련 및 가공 강국입니다.
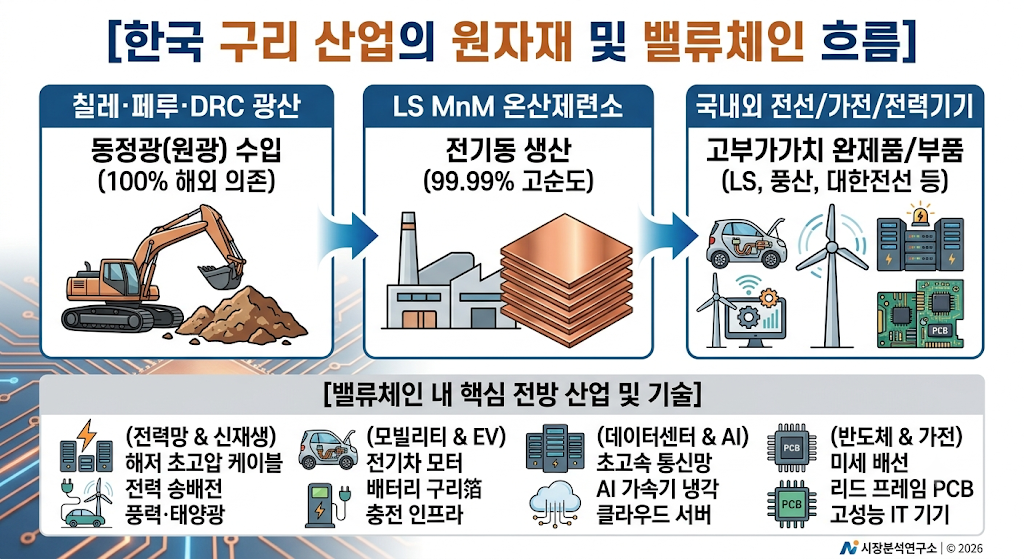
대표적으로 LS MnM(옛 LS니꼬동제련)의 온산제련소는 단일 제련소 기준 세계 2위 규모를 자랑합니다. 원유가 한 방울도 나지 않지만 뛰어난 정유 기술로 석유화학 제품을 수출하는 한국 정유 산업과 완전히 동일한 메커니즘입니다. 해외에서 동정광(원광)을 수입하여 99.99% 순도의 전기동(Copper Cathode)을 제련하고, 이를 풍산, LS전선, 대한전선 등 국내 가공·전선업체에 공급하거나 글로벌 시장으로 수출합니다.
4. LS ELECTRIC vs 풍산: 구리 상승기 손익 메커니즘의 결정적 차이
투자 관점에서 가장 중요한 대목입니다. 구리 가격이 상승할 때 국내 대표 수혜주인 LS ELECTRIC과 풍산은 주가 흐름과 이익 체계에서 완벽히 다른 양상을 보입니다. 이를 정밀하게 비교 분석해 드립니다.
(1) 손익 체계 및 메커니즘 비교
구분
LS ELECTRIC
풍산
주력 사업 구조
전력기기·초고압 변압기·배전반 등 전력 인프라 시스템
동판·동봉·소전 등 신동(구리 가공) 60~70% + 방산(탄약) 30~40%
원자재가 연동 방식
Cost-Plus (원가 연동 판가 전가 메커니즘)
LME 시세 실시간 직연동 + 재고평가손익 (Metal Gain/Loss)
핵심 손익 메커니즘
구리 가격 상승 시 제품 단가 즉시 인상 ➔ 수주 잔고 금액 팽창 ➔ 영업이익 절대액(Absolute Margin) 지속 확대
원광 매입과 판매 시차(Lagging)에 따른 재고평가이익(Metal Gain) 폭발 ➔ 구리 급등 시 영업이익 퀀텀점프
가격 변동 위험도
낮음 (하방 방어력 극대화)
전력망 초과 수요 상태로 구리 가격 조정 시에도 Q(물량)가 방어
높음 (시클리컬 변동성 노출)
구리 가격 하락 전환 시 재고평가손손실(Metal Loss) 발생 위험 상존
(2) 기업별 정밀 투자 분석
📌 LS ELECTRIC: “구리 가격 인상을 판가로 완벽 전가하는 전력망 인프라의 챔피언”
LS ELECTRIC은 제품 원가 중 구리 비중이 60% 이상을 차지합니다. 하지만 글로벌 전력망 공급 부족(Super Cycle)과 맞물려 강력한 가격 결정력(Pricing Power)을 보유하고 있습니다.
[LS ELECTRIC의 이익 선순환 메커니즘]

  구리(LME) 시세 급등
     ▼
  제품 판가(P) 즉시 인상 (Cost-Plus 방식 전가)
     ▼
  수주 잔고의 '금액적 팽창' 발생 (동일한 % 마진 적용 시 이익 절대액 증대)
     ▼
  AI 데이터센터 + 글로벌 전력망 교체에 따른 물량(Q) 폭증
     ▼
  구리 시세가 조정을 받더라도 흔들리지 않는 견고한 실적 우상향 유지
투자의견:Strong Buy (장기 우상향 체질)
투자 포인트: 단순한 구리 가격 상승의 수혜를 넘어 ‘AI 데이터센터 전력 공급 + 미국 및 유럽의 전력망 노후화 교체’라는 10년 주기의 메가트렌드 중심에 서 있습니다. 구리 가격 변동성에 관계없이 실적의 가시성과 안정성이 매우 뛰어납니다.
📌 풍산: “구리 시세에 실적이 직결되는 원자재 레버리지(Beta)의 종결자”
풍산은 구리를 가공하여 동판, 동봉 등을 만드는 신동 사업이 매출의 핵심입니다. 제품 판가가 LME 구리 시세에 직동됩니다.
[풍산의 재고평가이익(Metal Gain) 발생 원리]

  [T-2개월] 구리 원재료 저가 매입 (예: $8,000/ton)
     ▼ (2~3개월 가공 및 시세 상승: $14,000/ton)
  [T 시점]  현재 시세로 완제품 판매 ($14,000/ton 기준 판가 책정)
     ▼
  ★ 막대한 재고평가이익(Metal Gain) 발생 ➔ 분기 영업이익 급증!
투자의견:Buy / Volatile (스윙 및 트레이딩 최적화)
투자 포인트: 구리 시세가 사상 최고치를 경신하는 상승 파동에서는 재고평가이익이 극대화되며 시장 예상치를 뛰어넘는 ‘어닝 서프라이즈’를 연출합니다. 추가로 방산 부문(탄약 수출)이 고마진을 기록하며 구리 가격 하락 시 완충재(Hedge) 역할을 담당해 줍니다. 단, 구리 가격이 급락세로 돌아서면 재고평가손실(Metal Loss)이 발생할 수 있으므로 구리 시세 차트를 정밀하게 모니터링해야 합니다.
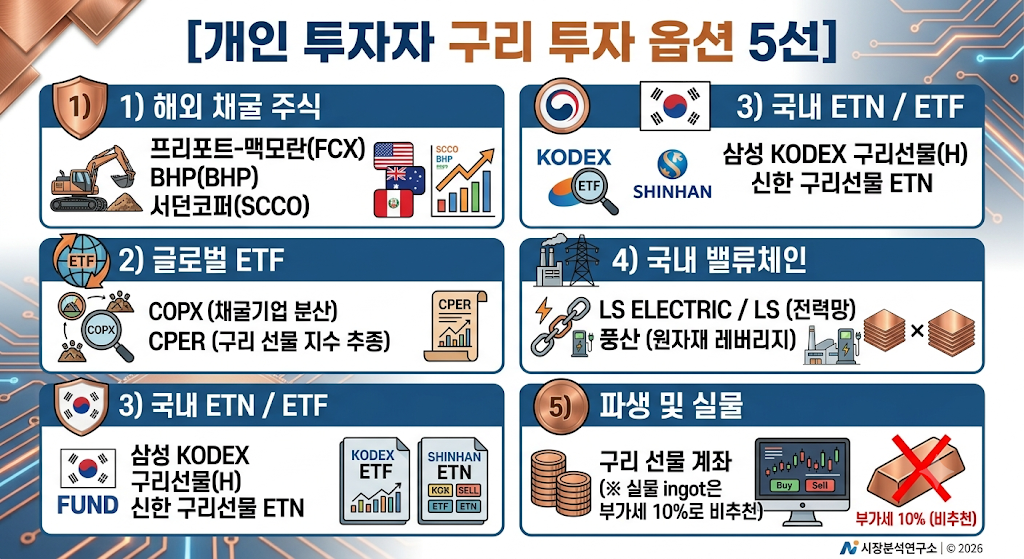
5. 개인 투자자를 위한 구리 투자 방식 5가지
구리 시장의 강세에 올라타기 위해 개인 투자자가 실행할 수 있는 투자 옵션은 크게 5가지로 나뉩니다. 본인의 위험 선호도와 투자 기간에 맞춰 전략을 수립해야 합니다.
(1) 투자 가이드 및 전략 권고사항
포트폴리오 비중 제언: 구리는 경기 변동과 거시 변수(금리, 환율)에 민감한 원자재입니다. 전체 주식 자산 포트폴리오의 5%~10% 수준으로 배분하는 것이 위험 관리 측면에서 바람직합니다.
투자 수단별 최적의 조합:
장기 적립식 구조적 투자: 글로벌 채굴 기업에 분산 투자하는 COPX ETF 또는 독보적 판가 전가력을 지닌 LS ELECTRIC 주식을 모아가는 전략.
원자재 급등 모멘텀 단기 대응:풍산 또는 KODEX 구리선물(H)을 활용한 눌림목 매수 전략.
반드시 모니터링해야 할 3대 지표:
LME (런던금속거래소) 구리 재고량: 재고 감소는 시세 상승의 강력한 신호입니다.
중국 정제구리 수입량 및 PMI 지수: 세계 최대 소비국의 실물 수요 온도를 체크해야 합니다.
미 달러화 지수 (DXY): 원자재는 달러로 결제되므로 달러 약세 시 구리 가격 상승 압력이 커집니다.
6. 결론: 구리 시장에 대한 최종 투자의견
단기 관점 (Neutral ~ Caution): LME 구리 가격이 톤당 14,000달러를 돌파하며 역사적 고점 영역에 진입한 만큼, 미 연준의 정책 잡음이나 관세 이슈에 따른 단기 차익실현 물량이 출회될 수 있습니다. 톤당 12,500~13,000달러 선까지의 눌림목 조정을 기다리는 유연한 자세가 필요합니다.
중장기 관점 (Strong Buy / Overweight): 광산 개발에 10~15년이 걸리는 광업의 본질적 한계(CapEx Bottleneck)와 AI 데이터센터, 글로벌 전력망 대개체라는 폭발적 수요가 만나는 ‘구조적 초과 수요의 시대’입니다. 2030년까지 구리의 구조적 강세장은 지속될 전망입니다.
구리는 더 이상 단순한 경기 순환형 원자재가 아닙니다. 미래 IT 기술 생태계의 뼈대이자 핵심 혈관입니다. 시장의 단기 변동성을 넘어서는 구조적 변화에 주목하시어 지혜로운 포트폴리오를 구축하시길 바랍니다.
(본 포스팅은 투자 참고용 자료이며, 최종 투자의 결정과 책임은 투자자 본인에게 있습니다.)
최근 반도체 시장의 뜨거운 화두는 단연 SK하이닉스의 1c D램 양산 속도 가속화와 4분기 점유율 역전 전망입니다. 시장 일각에서는 그동안 SK하이닉스의 1c 공정 전환 속도가 경쟁사 대비 느렸다는 점을 지적하며 우려를 나타내기도 했습니다. 하지만 속사정을 자세히 들여다보면, 이는 고마진 1b 기반 HBM3E 시장을 실리적으로 독점하면서 최선단 1c 공정의 수율을 완벽하게 가다듬은 ‘고도의 전략적 속도 조절’이었음을 알 수 있습니다.
이번 분석 글에서는 1c D램의 기술적 본질부터 시작하여 차세대 AI 메모리인 HBM4E, 그리고 2D 평면 D램의 한계를 극복할 3D DRAM으로의 패러다임 전환까지 깊이 있게 다뤄보겠습니다.
1. 1c D램이란 무엇인가? (기술적 개념과 위치)
D램 미세공정은 1x(1세대) → 1y(2세대) → 1z(3세대) → 1a(4세대) → 1b(5세대) → 1c(6세대) 순으로 발전해 왔습니다. 1c D램은 6세대 10나노급(11~12nm 추정) 공정으로, 현재 메모리 업계가 도달한 가장 최선단(Leading-edge) 미세화 기술입니다.
과거 파운드리 업계(CPU, GPU)가 7nm → 5nm → 3nm처럼 직관적인 수치를 공개했던 것과 달리, D램 제조사들은 2010년대 중반 10나노대에 진입한 이후 물리적 한계 대응 및 기술 보안을 이유로 알파벳 기호를 표기하기 시작했습니다.
반도체 회로 선폭이 미세해질수록 동일한 12인치 웨이퍼 한 장에서 잘라낼 수 있는 칩(Net Die) 수가 급격히 늘어납니다. 이는 곧 웨이퍼당 비트 생산성(Bit Density) 증대로 이어져, 단위당 원가 경쟁력을 극대화할 수 있는 핵심 요인이 됩니다.
2. 왜 지금 1c D램인가? — HBM4E의 핵심 기반 엔진
현재 시장에서 활발히 양산 중인 6세대 HBM4에는 시스템 안정성을 최우선으로 확보하기 위해 검증된 1b 공정이 주요 코어 다이(Core Die)에 탑재되고 있습니다.
그러나 2027년 양산을 목표로 하는 차세대 HBM4E부터는 사정이 완전히 달라집니다. HBM4E는 처음으로 최선단 1c 공정을 코어 다이에 전면 적용합니다.
[HBM 세대별 D램 공정 적용]
HBM3E / HBM4  ───► 1b D램 공정 중심 (안정성 및 높은 양산 수율 확보)
HBM4E (2027~) ───► 1c D램 공정 적용 (핀당 16Gbps 전송속도 + 전력효율 20% 개선)
1c 공정이 HBM4E의 핵심 엔진인 이유는 다음과 같습니다.
초고속 데이터 전송: 핀당 16Gbps 이상의 전송 속도를 구현하여 AI 데이터센터의 병목 현상을 해결합니다.
전력 효율 개선: 이전 세대(1b) 대비 전력 효율을 20% 이상 향상시킵니다. HBM이 12단, 16단으로 높게 적층될수록 발열과 전력 소비가 비례하여 치솟는데, 1c D램의 저전력 특성은 발열을 통제할 최고의 무기가 됩니다.
단당 용량 증대: 칩의 집적도가 높아짐에 따라 동일한 두께 한도 내에서 24Gb, 32Gb 등 고용량 모듈을 훨씬 수월하게 구현할 수 있습니다.
SK하이닉스는 12단 적층 HBM4E 샘플을 주요 고객사에 이미 성공적으로 출하하며 1c 기반 차세대 AI 메모리 시장에서도 선점 효과를 증명했습니다. 결국 1c 공정 전환 속도가 곧 HBM4E의 양산 경쟁력 및 수익성과 직결되는 구조입니다.
3. 생산 비중 확대 추이: 후발주자에서 반격으로
업계 추정에 따른 주요 D램 공정 비중 변화를 살펴보면 시장 흐름을 한눈에 파악할 수 있습니다.
시점
1c D램 비중 (SK하이닉스)
핵심 시장 현황 및 특징
2026년 1분기
약 10%
1b D램 중심의 HBM3E 고수익 극대화 구간
2026년 2분기
약 13%
실적 발표를 통해 공식 출하 및 램프업 확인
2026년 3분기 (전망)
약 24%
1c 공정 라인 전환 본격 가속화
2026년 4분기 (전망)
약 34%
경쟁사(삼성전자 약 31% 전망) 역전 달성
2027년 1분기 (전망)
약 35%
1b 공정을 제치고 주력(Mainstream) 공정 등극
2026년 2분기 기준 D램 공정 비중을 살펴보면 마이크론(약 19%), 삼성전자(약 16%), SK하이닉스(약 13%) 순으로 SK하이닉스가 수치상 다소 뒤처져 있었습니다. 이는 1b 공정 비중이 2분기 약 43%로 정점을 찍으며 HBM3E 물량을 대량 소화했기 때문입니다.
그러나 하반기 들어 SK하이닉스가 1c 공정으로의 전환 속도를 비약적으로 끌어올리면서, 4분기에는 SK하이닉스가 34%의 비중을 확보하며 삼성전자(31%)를 역전할 것으로 전망됩니다.
시장이 이 뉴스에 뜨겁게 반응하는 이유는 단순한 기술 진척을 넘어, 경쟁사 대비 느렸던 최선단 공정에서 빠르게 역전에 성공했으며, 이것이 CGS(매출원가) 절감 및 HBM4E 시장 독점적 주도권으로 직결되기 때문입니다.
4. 세대별 기술 특징 및 수치 비교 (1x부터 1c까지)
D램 미세화 과정에서 발생한 핵심 변곡점과 세대별 기술적 특징을 아래 표로 종합 정리했습니다.
세대
선폭 범위 (추정)
양산 시점
핵심 기술 변곡점 및 공학적 특징
1x (1세대)
18 ~ 19nm
2016년
ArFi(불화아르곤 수경) 노광 기반, 쿼드러플 패터닝(QSA) 등 다중 패터닝 한계 진입
1y (2세대)
16 ~ 17nm
2017년
회로 물리적 한계 대응, HKMG(High-K Metal Gate) 소재 일부 도입으로 누설 전류 차단 시작
1z (3세대)
14 ~ 15nm
2019년
ArFi 기술의 극한. D램 내부 셀 캐패시터 높이를 올리는 3D 구조(High Aspect Ratio) 본격화
1a (4세대)
13 ~ 14nm
2021년
EUV(극자외선) 노광 공정 최초 도입. 삼성전자·SK하이닉스가 레이어 1~5개에 EUV 적용
1b (5세대)
12 ~ 13nm
2023년
High-K 신소재 적용 확대 및 HKMG 트랜지스터 적용. HBM3E의 핵심 주력 공정
1c (6세대)
11 ~ 12nm
2024년~
EUV 레이어 수 대폭 확대. 1b 대비 비트 생산성 30% 이상 향상, HBM4E 표준 공정
5. 현장 엔지니어 관점에서 본 3가지 핵심 차이점
엔지니어링 관점에서 1x~1z 세대와 1a~1c 세대를 가르는 명확한 기술적 차이는 다음 3가지로 압축됩니다.
[엔지니어링 3대 핵심 차이점]
1. 노광 장비: ArFi (멀티패터닝) ➔ EUV (싱글/단순 패터닝으로 공정 단축)
2. 물리적 한계: HAR 캐패시터 높이 증가 + HKMG 신소재로 누설 전류(Leakage) 차단
3. 생산성/효율: 웨이퍼당 Net Die 30% 증가 + 전력 소비 20% 저감
① 노광 장비의 세대교체 (ArFi vs EUV)
1x ~ 1z 세대 (ArFi 시대): 빛의 파장이 193nm인 불화아르곤 수경(ArF Immersion) 장비를 사용했습니다. 회로 회선이 빛의 파장보다 훨씬 얇다 보니 회로를 3~4번 나뉘어 그리는 ‘멀티 패터닝’ 방식을 써야 했고, 이는 마스크 수의 폭증과 공정 복잡도 상승을 유발했습니다.
1a ~ 1c 세대 (EUV 시대): 파장이 13.5nm에 불과한 극자외선(EUV) 장비가 투입되었습니다. 멀티 패터닝으로 여러 번 그릴 회로를 단 한 번의 EUV 노광으로 정밀하게 인쇄할 수 있게 되었습니다. 1c 공정으로 갈수록 EUV 레이어 적용 개수가 획기적으로 늘어납니다.
② 물리적 한계 극복 (Capacitor & Leakage Current)
D램은 1개의 트랜지스터(T) + 1개의 캐패시터(C)로 구성됩니다. 미세화가 진행될수록 두 가지 물리 법칙의 한계가 찾아옵니다.
캐패시터 용량 부족: 칩이 작아지면 전하를 담는 캐패시터의 바닥 면적이 줄어들어 데이터가 유실됩니다. 이를 막기 위해 캐패시터를 마천루처럼 위로 높게 올리는 기술(High Aspect Ratio)이 적용되었습니다.
누설 전류(Leakage Current): 회로 간격이 좁아지며 전자가 인접 회로로 넘어가 버리는 현상이 발생합니다. 이를 통제하기 위해 1y/1b 세대부터 기존 절연체 대신 HKMG(High-K Metal Gate) 신소재를 게이트에 도입했습니다.
③ 웨이퍼당 비트 생산성(Bit Density)과 전력 효율
칩 크기(Die Size) 감소: 동일한 12인치 웨이퍼에서 추출 가능한 칩 개수가 약 20~30% 증가합니다.
전력 소비 저감: 동작 전압(VDD)을 낮출 수 있어 전력 효율이 15~20% 개선됩니다.
고속 데이터 전송: 1c 공정에서는 핀당 16Gbps 이상의 고속 동작 시에도 신호 간섭(Noise)이 적습니다.
6. 개발 완료 후 지금까지 생산 확대를 미뤘던 전략적 배경
1c 공정 기술은 이미 2024년에 개발이 완료되었음에도 불구하고, SK하이닉스가 2026년 상반기까지 보수적인 생산 기조를 유지했던 이유는 다음과 같습니다.
① 1b D램의 강력한 ‘캐시카우’ 및 수율 안정성
2024년부터 2026년 상반기까지 SK하이닉스의 주력 실적원은 1b D램 기반 HBM3E였습니다. 1b 공정은 이미 양산 수율이 80~90% 이상 확보되어 압도적인 고마진을 내고 있었습니다. 반면, 최선단 1c 공정은 초기 라인 구축 및 수율 확보에 막대한 비용이 듭니다. 1b로 시장을 독점하는 상황에서 굳이 무리하게 1c로 전환하여 수율 위험(Yield Risk)을 감수할 이유가 없었습니다.
② HBM4 전략의 ‘안정성 최우선’ 기조
HBM4 시장 진입 당시 경쟁사는 초기 1c 공정을 무리하게 조기 도입하려다 초기 수율 확보 지연을 겪은 반면, SK하이닉스는 코어 다이에 이미 검증된 1b 공정과 Advanced MR-MUF 패키징 기법을 고수하여 시장 리더십을 공고히 했습니다.
③ CapEx 효율화 및 수율 안정화
1c 공정은 EUV 멀티패터닝 및 미세 패턴의 누설 전류 제어가 극도로 어렵습니다. 파일럿 라인의 샘플 완성 단계와 월 수만 장 규모의 상업적 양산 사이에는 수율 곡선(Ramp-up Curve)을 안정적으로 올리는 가다듬기의 시간이 필수적이었습니다.
7. 1c D램 이후의 한계(1d, 0a)와 3D DRAM으로의 패러다임 전환
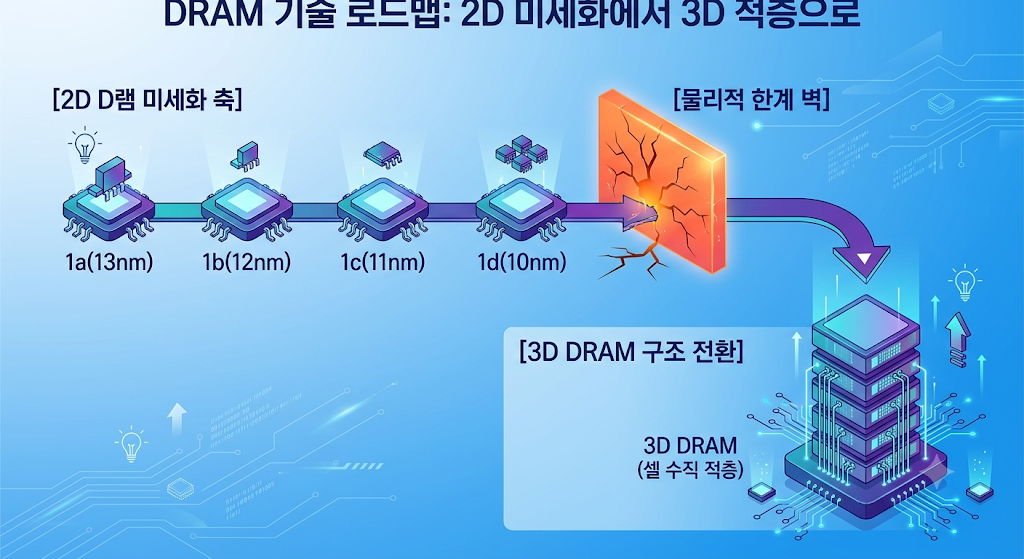
현재 D램은 2D 평면상에서 회로 선폭을 줄이는 미세화를 지속해 왔으나, 1c(11~12nm)를 지나 1d(10nm 극반) 및 0a(9nm 진입) 세대에 다다르면 2D D램 구조는 완전한 물리적·경제적 한계 벽에 부딪히게 됩니다.
1d(10nm) 공정이 마주한 3대 물리적 장벽
캐패시터 종면비(Aspect Ratio) 한계: 1b/1c 공정의 캐패시터 종면비(높이 대 가로 비율)는 이미 100:1에 달합니다. 1d 공정에 다다르면 종면비가 120:1~130:1까지 치솟아, 제조 도중 기둥이 쓰러지거나 붙어 버리는 구조적 붕괴(Pillar Leaning)가 발생합니다.
누설 전류와 터널링 현상: 회로 간격이 수 나노미터 수준으로 좁아지면 전자가 옆 셀로 넘어가 버리는 양자 터널링(Quantum Tunneling) 현상이 심화되며 신호대잡음비(SNR)가 급격히 악화됩니다.
스케일링 에로스(Scaling Eros): EUV 다중 패터닝 도입으로 비싼 노광 장비 사용 횟수가 늘어나, “공정을 미세화해도 칩당 생산 단가가 떨어지지 않는” 경제적 한계선에 도달합니다.
3D DRAM이란 무엇인가?
NAND 플래시가 평면 구조의 한계를 극복하기 위해 3D V-NAND로 전환했던 것처럼, D램 역시 평면에 놓여 있던 트랜지스터와 캐패시터를 수직으로 90도 세우는 구조 변혁을 준비하고 있습니다.
Vertical Channel Transistor (VCT): 평면 위에 눕혀져 있던 트랜지스터 게이트를 수직으로 세워 채널 길이를 확보함으로써 누설 전류를 억제합니다.
Oxide Semiconductor (IGZO): 실리콘(Si) 채널 대신 누설 전류가 수만 분의 일 수준으로 적은 인듐-갈륨-아연 산화물(IGZO) 신소재를 적용합니다.
[3D DRAM 기술 전환 예상 로드맵]
2026 ~ 2027년 : 2D 평면 D램의 마지막 세대(1d 공정) 양산 및 VCT 부분 검증
2027 ~ 2028년 : 최초의 3D DRAM 구조 파일럿 샘플 공개 (10~20단 적층)
2029 ~ 2030년 : 메인스트림 상용화 (서버용 D램 및 차세대 HBM5 이상에 전면 적용)
8. 투자 가이던스: 단기 및 중장기 매매 전략
30년 차 애널리스트의 관점에서 이번 1c D램의 성공적인 램프업과 역전 스토리가 반도체 포트폴리오에 주는 시사점을 정리해 드립니다.
[투자 전략 핵심 요약]
* 단기 관점 (6개월~1년): 4Q 1c 비중 역전(34%) ➔ Blended ASP 상승 & 마진 개선 ➔ 주가 Re-rating
* 중장기 관점 (2년~5년): HBM4E 시장 주도권 ➔ 3D DRAM 패러다임 선점 ➔ AI 구조적 성장주 평가
1) 단기 관점 (6개월 ~ 1년)
Valuation Re-rating 트리거: 시장의 우려와 달리 2026년 4분기 1c 비중 34% 확대를 통한 경쟁사 역전이 가시화되면, 디스카운트 요소가 해소되며 강력한 주가 재평가가 전개될 것입니다.
영업이익률(OPM) 상향: 1c 공정은 1b 대비 비트 생산성이 30% 이상 높습니다. 동일한 CapEx 내에서 출하량이 크게 늘어 단위당 CGS가 절감되므로 하반기 실적 컨센서스가 상향 조정됩니다.
HBM4E 시장 독점적 위치: 2027년 HBM4E부터는 1c 공정이 필수 스펙입니다. 2026년 하반기에 1c 양산을 안착시킨 SK하이닉스가 HBM4E 시장의 주도권을 움켜쥐게 됩니다.
3D DRAM 시대의 진입장벽: 1c 공정에서 축적한 비트 밀도 효율화 능력과 수율 컨트롤 역량은 2028년 이후 펼쳐질 3D DRAM 시대에서도 막강한 경쟁력이 됩니다.
Action: 메모리 반도체를 단순 경기 순환주가 아닌 ‘AI 구조적 성장주’로 재인식하고, HBM4E 양산 초입인 2027년까지 긴 호흡으로 보유할 가치가 충분합니다.
9. 밸류체인(소부장) 수혜주 상세 분석
1c D램 공정 전환(EUV 레이어 확대)과 3D DRAM 시대로의 이행 과정에서 직간접적 수혜를 입을 핵심 소부장 기업 분석입니다.
① EUV & 노광 공정 생태계
SNS텍: 1c 공정부터 EUV 레이어 적용 수가 폭증하면서 웨이퍼 오염을 막는 EUV 펠리클 소모량이 비례하여 증가합니다. 투과율 90% 이상 고출력 펠리클 공급에 따른 강력한 모멘텀을 보유하고 있습니다.
파크시스템스: 회로 선폭이 11~12nm 수준으로 줄어들면 기존 광학 장비로는 3D 패턴 결함을 검출하기 어렵습니다. 원자력 현미경(AFM) 글로벌 1위 기업으로 수율 잡기의 필수 수혜주입니다.
동진쎄미켐: EUV 및 ArFi용 포토레지스트(PR)를 국내 메모리 양사에 모두 공급하고 있어, 1c 출하량 증가에 가장 정직하게 실적이 연동되는 소재 기업입니다.
② ALD 증착 & High-K 신소재
주성엔지니어링: D램 캐패시터 유전체 및 게이트용 High-K ALD(원자층증착) 장비의 글로벌 리더로, 1c 공정 고종면비 구조 구현의 핵심 파트너입니다.
유진테크: SK하이닉스 D램 메인 라인의 증착 장비 과점 공급사로, 4분기 1c 비중 확대(34%)에 따른 장비 입고 수혜가 매우 직관적으로 나타날 기업입니다.
솔브레인 / 덕산테코피아: 미세화에 따른 누설 전류 차단용 High-K 전구체(Precursor) 및 초고순도 식각액을 공급하여 안정적인 고마진을 유지합니다.
③ 초고난도 식각 및 3D 전환 관련
케이씨텍: D램 미세화 및 적층 구조 가공 시 필수적인 CMP(화학기계적 연마) 장비와 슬러리 소재를 동시 공급합니다.
티씨케이 / 하나머티리얼즈: High Aspect Ratio 식각 공정의 플라즈마 고에너지 환경에서 견디는 SiC(실리콘 카바이드) 링 소모품 교체 수요가 지속적으로 확대됩니다.
10. 결론 및 포트폴리오 운용 제언
SK하이닉스의 1c D램 양산 속도 조절은 “기술이 부족해서 느렸던 것”이 아니라, “1b 공정으로 고수익을 극대화하는 동시에 1c 양산 수율을 완전하게 가다듬은 실리적 승리”였습니다.
2026년 하반기부터 펼쳐질 1c 생산 비중의 급격한 상승(13% → 34%)은, 1c 공정이 완벽히 검증된 양산 기술로 전환되었음을 의미합니다. 이는 HBM4E 시장의 절대적 주도권 확보와 범용 D램에서의 원가 절감이라는 두 마리 토끼를 모두 잡는 계기가 될 것입니다.
포트폴리오 구성 가이던스
메모리 섹터 구성: SK하이닉스(60%) : 핵심 EUV/증착 소부장(30%) : 삼성전자(10%)
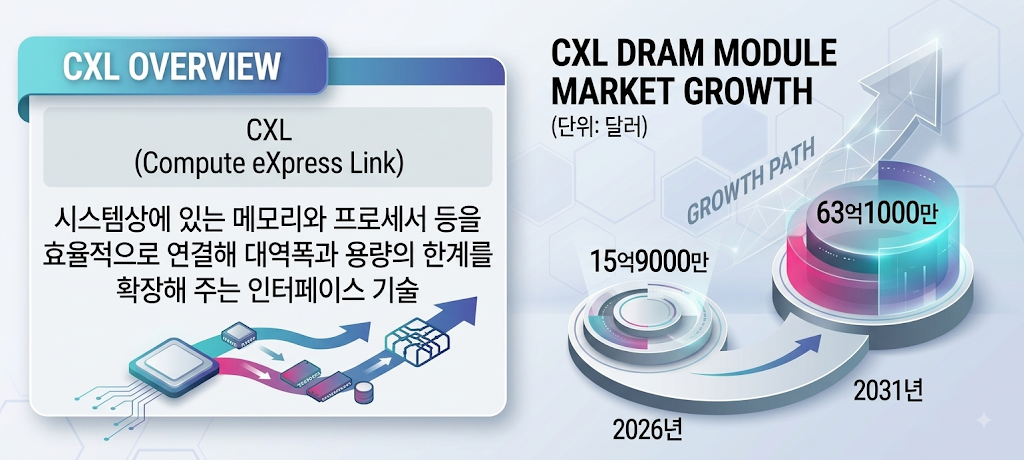
AI 추론 시대의 메모리 구원투수 Compute Express Link(CXL): 기술적 본질, 3대 병목, 그리고 투자 전략 보고서
그동안 AI 반도체 시장의 주연은 HBM(고대역폭메모리)이었지만, AI 서비스의 축이 ‘학습(Training)’에서 ‘추론(Inference)’으로 이동함에 따라 메모리 용량과 운용 비용(TCO)의 병목이 심화되고 있습니다. 이러한 상황에서 CXL은 HBM의 물리적·경제적 한계를 완벽히 보완할 핵심 솔루션으로 손꼽히고 있습니다.
📑 목차 (Table of Contents)
서론: 왜 지금 CXL인가? (AI 추론 시대의 메모리 대전환)
개념과 작동 원리: 직관적 이해부터 하드웨어 구조까지
표준 발전사
HBM vs CXL: 대립 관계인가, 상호보완적 동반자인가?
상용화를 가로막는 3대 핵심 병목 (Bottlenecks)
글로벌 밸류체인 및 생태계 기업 지도 (Ecosystem Map)
투자자를 위한 단기 vs 중장기 프레임워크 & 포트폴리오 전략
결론 및 최종 요약
1. 서론: 왜 지금 Compute Express Link인가?
생성형 AI 패러다임이 급격히 진화하면서 빅테크 및 데이터센터들의 인프라 구축 우선순위가 크게 바뀌고 있습니다. 초기에는 ChatGPT, Claude 등 대규모 언어모델(LLM)을 빠르게 연산·학습시키기 위해 초고속 대역폭을 가진 HBM(High Bandwidth Memory) 중심의 GPU 인프라 확충이 사활을 걸었던 과제였습니다.
그러나 GPT-4o, Gemini, Claude 3.5 등 초거대 멀티모달 모델들이 대중적인 서비스로 정착하면서, 데이터센터의 핵심 지표는 단순한 연산 파워에서 ‘추론 비용 절감 및 대용량 맥락 처리’로 이동했습니다.
💡 추론형 AI의 핵심 병목: KV 캐시(Key-Value Cache)의 폭발적 증가
추론형 AI 서비스의 가장 큰 특징은 수많은 사용자가 동시에 길고 복잡한 대화를 주고받는다는 점입니다. 이때 AI 모델이 이전 대화의 문맥(Context)을 기억하고 유기적인 답변을 생성하기 위해 필연적으로 생성·저장하는 데이터가 바로 ‘KV 캐시(Key-Value Cache)’입니다.
HBM의 한계: GPU 바로 옆에 붙어 있는 HBM은 연산 속도는 극도로 빠르지만, 가격이 매우 비싸고 GPU 당 장착할 수 있는 물리적 용량(VRAM)에 엄격한 한계가 존재합니다.
해결책의 등장: 비싸고 용량이 작은 HBM에 대용량 KV 캐시를 모두 담을 수 없게 되면서, ‘HBM에는 당장 연산할 Hot Data만 두고, 대용량 KV 캐시는 CXL 메모리로 이관한다’는 새로운 메모리 계층화 전략이 성립하게 되었습니다.
삼성전자, SK하이닉스, 마이크론 등 메모리 3사가 최근 미국 FMS(Future Memory and Storage) 2026 등 글로벌 반도체 학회에서 CXL 기술을 전면에 내세우는 이유가 바로 여기에 있습니다.
2. 기본 개념과 작동 원리: 직관적 이해부터 하드웨어 구조까지
2.1 직관적 개념: “메모리를 유연하게 나눠 쓰는 고속 고속도로”
기존 컴퓨팅 메인보드 구조에서는 CPU나 GPU에 D램 슬롯이 물리적으로 직접 결합되어 있었습니다. 마더보드 슬롯 수가 제한되어 있어 서버 1대가 쓸 수 있는 메모리 최대 용량도 고정되었습니다.
이로 인해 전통적인 데이터센터에는 ‘유휴 메모리(Stranded Memory)’ 문제가 발생했습니다:
기존 구조: A 서버는 메모리가 70% 남아돌고, B 서버는 메모리가 부족해 시스템이 버벅거립니다. 하지만 각자 자기 슬롯에 꽂힌 메모리만 쓸 수 있어 A 서버의 남는 메모리를 B 서버에 나눠줄 방법이 없습니다.
CXL 구조: PCIe(그래픽카드를 꽂는 고속 슬롯 규격)를 기반으로 고성능 인터커넥트망을 구축합니다. Compute Express Link 스위치에 여러 서버와 메모리를 연결하여 하나의 ‘공용 저수지(Memory Pool)’로 묶습니다. 필요한 서버가 필요한 순간에 필요한 만큼 메모리를 동적으로 가져다 쓰고 반납하는 구조입니다.
2.2 Compute Express Link 의 3가지 핵심 프로토콜 구조
Compute Express Link 규격은 PCIe 물리 계층(PHY) 위에서 세 가지 상위 프로토콜을 결합하여 가동됩니다:
CXL.io: 기존 PCIe 5.0/6.0 규격과 완전히 동일한 입출력(I/O) 프로토콜로, 장치 검색, 초기화, 오류 보고 등을 담당합니다. (모든 CXL 장치의 필수 기본층)
CXL.cache: GPU, NPU 등 가속기 장치가 호스트 CPU의 메인 메모리를 극도로 낮은 지연시간(Latency)으로 직접 캐시 일관성(Cache Coherency)을 유지하며 읽고 쓸 수 있게 지원합니다.
CXL.mem: 호스트 CPU나 GPU가 로드/스토어(Load/Store) 명령어를 사용해 외부 CXL 메모리 모듈에 직접 접근할 수 있도록 하는 핵심 프로토콜입니다.
3. Compute Express Link 표준 발전사
Compute Express Link 컨소시엄은 2019년 출범 이래 가파른 속도로 표준 고도화를 추진해 왔습니다.
규격 구분
CXL 1.0 / 1.1 (2019)
CXL 2.0 (2020)
CXL 3.0 / 3.1 / 3.2 (2022~2026)
핵심 연결 방식
Point-to-Point (1:1 직접 연결)
Switch 기반 (1:N 메모리 풀링)
Fabric 기반 (N:M 대규모 메모리 공유)
주요 기능
CPU-메모리간 직접 물리적 용량 확장
서버간 유휴 메모리 동적 할당 지원
P2P 직통 통신, Multi-head 장치, 랙(Rack) 단위 풀링
기반 PCIe
PCIe 5.0 (32 GT/s)
PCIe 5.0 (32 GT/s)
PCIe 6.0 / 7.0 (64 ~ 128 GT/s)
상용화 현황
PoC 완료 및 가이던스 정립
서버 CPU(Intel Xeon, AMD EPYC) 지원
메모리 3사 샘플링 완료, 하이퍼스케일러 테스트 진입
현재 위치(2026년 기준): CXL 2.0/3.2 기반 메모리 모듈(CMM-D 등) 샘플 검증(PoC)이 마무리 단계에 있으며, 글로벌 하이퍼스케일러(MS Azure, Meta, Google, AWS) 환경에서 초기 파일럿 배포 및 양산 조율이 진행되는 ‘초기 상용화의 분기점’입니다.
4. HBM vs CXL: 대립 관계인가, 상호보완적 동반자인가?
투자 시장에서 가장 빈번하게 발생하는 오해는 “CXL이 HBM을 대체하여 HBM 시장이 위축되는 것 아닌가?”라는 질문입니다. 결론부터 명확히 밝히면 CXL과 HBM은 대체재가 아닌 완벽한 역할 분담 관계(보완재)입니다.
실제로 삼성전자의 최근 논문 발표에 따르면, 긴 대화 맥락 환경에서 KV 캐시를 CXL D램으로 이관했을 때 GPU VRAM만 단독 사용한 환경 대비 추론 처리량이 최대 9배 향상되었고, 첫 토큰 생성 시간(Time-to-First-Token)이 최대 16분의 1로 단축되는 성과를 보였습니다.
5. 상용화를 가로막는 3대 핵심 병목 (Bottlenecks)
Compute Express Link 의 장점에도 불구하고, 데이터센터 현장에서의 대규모 확산을 가로막는 엔지니어링 및 생태계 차원의 병목은 크게 3가지로 나뉩니다.
상용화의 3대 병목 (Bottlenecks)

1. Hardware & Latency       로컬 DDR 대비 2~3배 긴 지연시간
2. Software & Orchestration OS/커널 레벨 Hot/Cold 페이지 이동
3. Ecosystem & Dynamic    NVLink 독점 및 메모리사 수익성
① 하드웨어 & 지연시간(Latency) 오버헤드
물리적 차이: CPU 컨트롤러에 직결된 메인 D램 지연시간이 약 60~80ns인 반면, CXL 메모리는 PCIe PHY + CXL 컨트롤러 + CXL 스위치 패브릭을 거치기 때문에 지연시간이 약 150~250ns로 2~3배 깁니다.
대응책: 1나노초의 연산 주기가 중요한 GPU 핵심 계산 루프 데이터(Hot Data)를 CXL에 두면 전체 연산 속도가 떨어지므로, 오직 캐시용 데이터(Warm/Cold Data)로 철저히 분리 제어해야 합니다.
② 소프트웨어 스택 & OS 오케스트레이션
NUMA 노드 인식과 Page Tiering: 리눅스 커널 등 OS 레벨에서 CXL 메모리는 로컬 메모리가 아닌 별도의 NUMA(Non-Uniform Memory Access) 노드로 인식됩니다.
소프트웨어 최적화: 자주 쓰는 메모리 페이지를 메인 D램으로 올리고, 덜 쓰는 페이지를 CXL로 넘기는 ‘Page Tiering’ 알고리즘이 실시간으로 오류 없이 작동해야 하나, 현재 SW 스택은 고도화 과정에 있습니다.
③ 생태계 역학: 엔비디아 NVLink 독점 & 메모리 3사의 자기잠식(Cannibalization) 딜레마
엔비디아 NVLink의 지배력: 엔비디아는 GPU 간 대용량 통신망으로 자사 독점 규격인 NVLink(6세대 기준 초당 3.6TB 대역폭)를 우선시합니다. 엔비디아 입장에서 CXL은 GPU 내부 통신망이 아닌 “외부 대용량 캐시 확장용” 정도로만 역할이 한정되길 바랍니다.
메모리 IDM의 자기잠식 우려: CXL 풀링이 완벽해지면 서버 1대당 필요한 expensive 메인보드 전용 DIMM D램의 개수가 줄어들 수 있습니다. 이 때문에 삼성전자, SK하이닉스, 마이크론 등은 범용 D램 수요를 스스로 갉아먹는 자기잠식(Cannibalization) 효과를 경계하며 시장 속도를 조절하고 있습니다.
6. Compute Express Link 글로벌 밸류체인 및 생태계 기업 지도 (Ecosystem Map)
Compute Express Link 생태계는 메모리 IDM, 컨트롤러/스위치 팹리스, 반도체 IP 기업, 데이터센터 CPU 제조사, 그리고 검사장비/소부장 기업으로 세분화됩니다.
구분
핵심 참여 기업
핵심 역할 및 주요 제품
메모리 IDM
삼성전자, SK하이닉스, 마이크론
• 삼성: CMM-D(MD220, MD310), CXL 3.2 양산 조율 • SK하이닉스: CXL 3.2 샘플, CMM-Ax(근전동 연산형) 개발 • 마이크론: FMS 2026 CXL 메모리 솔루션 전면 공개
컨트롤러 & 스위치 (팹리스)
Astera Labs, Marvell, Montage, XConn
• Astera Labs (ALAB): CXL 리타이머 및 스위치(Scorpio) 독점적 지위 • Marvell: Tanzanite 인수 후 Structera A 플랫폼 고도화 • Montage / XConn: CXL 3.0/4.0 스위치 실리콘 제작
IP & 인터페이스
Rambus, Synopsys, Cadence
• CXL 3.0/4.0 패브릭용 PHY, 컨트롤러 핵심 반도체 IP 라이선스 공급
CPU & 플랫폼
Intel, AMD
• Intel Xeon, AMD EPYC 서버 CPU 내 CXL 2.0/3.0 컨트롤러 표준 내장
국내 소부장 / 검사장비
네오셈, 엑시콘, 큐알티
• 네오셈: 세계 최초 CXL 검사장비 상용화, CXL 테마 대장주 • 엑시콘: CXL 1.1/2.0 테스터 및 차세대 테스터 공급 • 큐알티: CXL 신뢰성 평가 및 품질 검사 서비스
국내 IP / 팹리스
오픈엣지테크놀로지, 퀄리타스반도체
• 오픈엣지: CXL 컨트롤러 개발용 메모리 컨트롤러 IP 보유 • 퀄리타스: CXL용 고속 인터페이스 PHY IP 제공
7. 투자자를 위한 단기 vs 중장기 프레임워크 & 포트폴리오 전략
투자자의 시각에서 HBM이 ‘초고속 연산(High Speed)’을 담당하는 주연이라면, Compute Express Link는 ‘대용량 확장(High Capacity)’을 담당하는 최고 효율의 조연입니다.
7.1 타임라인별 투자 프레임워크
단기 관점 (~1년): “수주 모멘텀과 검사장비”
삼성전자와 SK하이닉스의 CXL 3.2 양산 스케줄 및 글로벌 하이퍼스케일러 테스트 소식에 따라 국내 소부장(네오셈, 엑시콘)과 IP 기업들의 주가 탄력성이 높게 나타납니다.
뉴스 모멘텀에 따른 기술적 눌림목 매수 전략이 유효합니다.
중장기 관점 (2~5년): “패브릭 대개막과 실적 중심 리레이팅”
2027년 이후 3.0/3.2 스위치를 통한 랙(Rack) 단위 메모리 풀링이 본격 구동됩니다.
컨트롤러 독점 기업(Astera Labs) 및 메모리 대형주의 펀더멘털 실적이 본격 반영되며 PER 중심의 정석적인 상승 장세가 연출될 것입니다.
7.2 포트폴리오 비중 전략 가이드
맞춤형 포트폴리오 자산 배분
 ■ 안정형 (60%): 삼성전자 / SK하이닉스
 - HBM 업황 수혜 기본 탑재 + CXL 시장 개막 시 멀티플 상향

 ■ 성장형 (30%): Astera Labs (ALAB)
 - 리타이머/스위치 글로벌 시장 독점력 보유 핵심 고성장주

 ■ 공격형 (10%): 네오셈 / 엑시콘 / 오픈엣지테크놀로지
 - 검사장비 수주 및 IP 모멘텀 기반 높은 시세 탄력성
8. 결론 및 최종 요약
Compute Express Link 은 일시적인 단기 테마가 아닙니다. AI 데이터센터가 추론 비용 절감(TCO 혁신)이라는 거대한 벽을 넘기 위해 반드시 도입해야만 하는 메모리 패러다임의 근본적 대전환입니다.
기술적 본질: CXL은 HBM을 대체하는 것이 아니라, HBM이 담지 못하는 대용량 KV 캐시와 유휴 메모리를 효율적으로 제어하는 ‘계층형 메모리 구조의 핵심 축’입니다.
상용화 시점: 2026년 현재 PoC 검증을 끝내고 CXL 3.2 기반 초기 양산 단계에 진입 중이며, 2027년 하이퍼스케일러 데이터센터 본격 채택이 분기점이 될 것입니다.
투자 방향: 단기적으로는 검사장비 및 IP 종목의 모멘텀을 활용하되, 중장기적으로는 글로벌 Compute Express Link 패브릭 시장을 독점하는 컨트롤러 팹리스 및 메모리 대형주 중심으로 포트폴리오를 구성하는 지혜가 필요합니다.
요약 요약: 삼성전자가 세미콘 코리아 2026과 FMS 2026을 통해 공식화한 차세대 반도체 카드 ‘zHBM(z-HBM)’. 기존 2.5D 패키징의 한계를 허물고 GPU 위에 메모리를 수직(Z축)으로 3D 적층하는 이 파격적인 기술은, HBM 시장 점유율 열세를 단숨에 뒤집기 위한 삼성전자의 게임체인저 전략입니다. 본 포스팅에서는 zHBM의 공학적 실체부터 W2W 하이브리드 본딩 공정, 발열 및 수율 한계, 그리고 AI 시스템 패러다임 변화까지 깊이 있게 분석합니다.
1. 들어가며: 왜 시장은 다시 ‘메모리 구조’에 주목하는가?
현재 AI 반도체 산업이 맞닥뜨린 가장 거대한 벽은 GPU 연산 속도가 아닙니다. 바로 ‘데이터 이동 병목 현상(Memory Wall)’입니다. 아무리 강력한 계산 코어를 가진 GPU/NPU라 할지라도, 데이터를 제때 공급받지 못하면 놀 수밖에 없습니다.
지금까지 반도체 업계는 이를 극복하기 위해 HBM(High Bandwidth Memory)을 개발하고, GPU 옆에 메모리를 수평으로 나란히 배치하는 2.5D 패키징(예: TSMC CoWoS) 방식을 적극 채택해 왔습니다.
하지만 AI 모델이 거대화되고 추론(Inference) 시장이 급팽창함에 따라 2.5D 패키징 구조마저 물리적·열역학적 한계점에 도달하고 있습니다.
이 시점에서 삼성전자가 2026년 2월 ‘세미콘 코리아 2026’ 기조연설과 8월 ‘FMS(Future of Memory and Storage) 2026’을 통해 던진 출사표가 바로 zHBM(z-HBM)입니다. 로직(GPU)과 메모리의 경계를 물리적으로 완전히 무너뜨리겠다는 이 파격적인 선언의 실체는 무엇일까요? IT 전문 엔지니어이자 투자자의 시각으로 그 깊은 이면을 하나씩 파헤쳐 보겠습니다.
2. zHBM 개요: 2.5D 수평 배치를 넘어 3D Z축 수직 통합으로
zHBM의 정의와 공개 배경
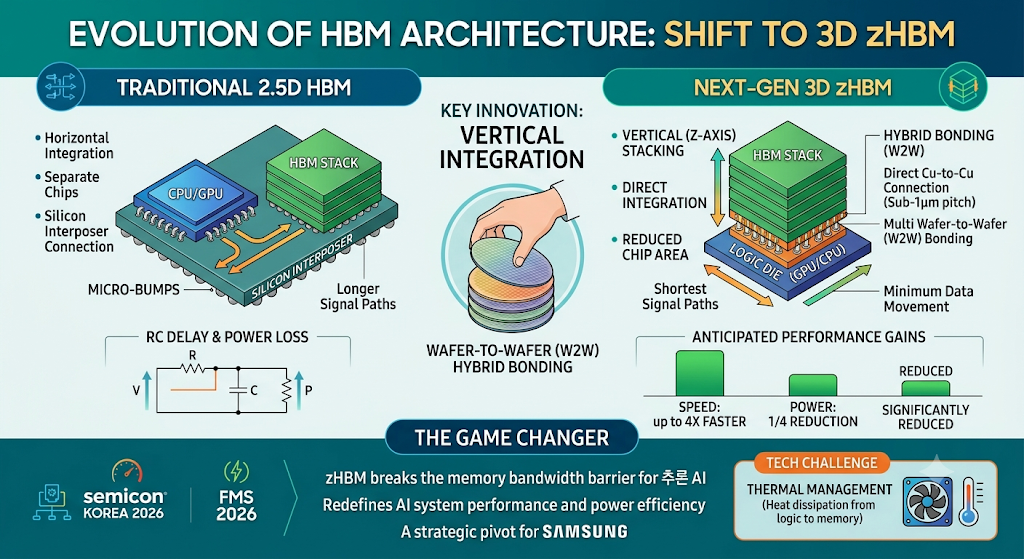
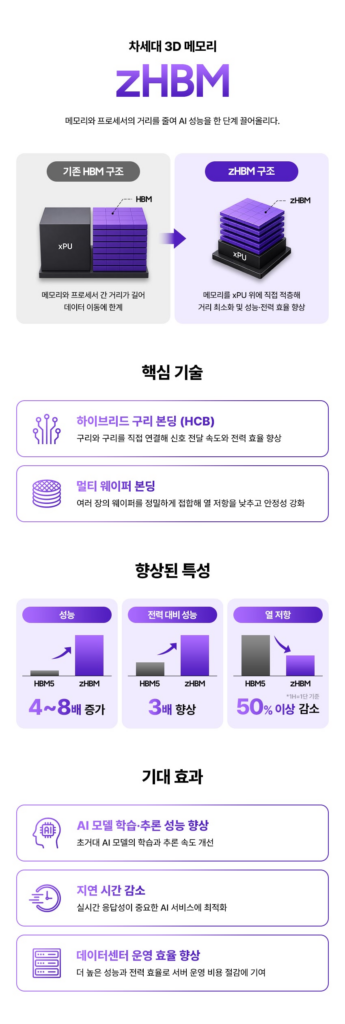
zHBM은 로직 칩(GPU/NPU/TPU)과 HBM 메모리 다이를 수평이 아닌 Z축(수직)으로 직접 3D 적층하는 차세대 초고밀도 통합 기술입니다.
2026년 2월 11일 (세미콘 코리아 2026): 삼성전자 DS부문 송재혁 CTO(사장)가 기조연설을 통해 “zHBM이라는 HBM 자체를 Z축으로 3D로 올리는 기술을 준비하고 있다”고 처음 공식 언급했습니다.
2026년 8월 4~6일 (FMS 2026): 미국 산타클라라에서 개최된 FMS 2026에서 삼성전자는 ‘AI를 위한 3D 아키텍처 시대’를 주제로 zHBM과 z-낸드(z-NAND) 라인업을 연계하며, 차세대 3D 메모리 로드맵을 다시 한번 재조명했습니다.
구분
기존 2.5D HBM 패키징
차세대 3D zHBM 패키징
배치 구조
실리콘 인터포저 위 수평(X-Y축) 병렬 배치
로직 칩(GPU) 위에 메모리를 수직(Z축) 3D 적층
연결 방식
Micro-bump 및 실리콘 인터포저 배선
Cu-Cu Direct Bonding (W2W 하이브리드 본딩)
배선 길이
수 mm (Millimeter) 단위
수 $\mu\text{m}$ (Micrometer) 이하
주요 목적
고대역폭 확보
대역폭 극대화 + 전력 소모 비약적 절감 + 면적 축소
삼성 ‘커스텀 HBM’ 흐름 속의 zHBM
zHBM은 단순한 독자 기술이라기보다 ‘커스텀 HBM(Custom HBM)’ 패러다임의 최상위 진화 형태입니다. HBM4 세대부터는 베이스 다이(Base Die)를 메모리 공정이 아닌 파운드리 첨단 공정으로 제작하여 로직 기능 일부를 흡수하는 커스텀화가 진행 중입니다.
zHBM은 여기서 한 발 더 나아가, “로직과 메모리를 분리된 별개 칩으로 보지 않고, 단일 3D IC 시스템으로 수직 통합하겠다”는 가장 급진적인 접근법입니다.
3. 하드웨어 구조적 한계와 zHBM의 물리적 돌파구
공학적으로 볼 때 기존 2.5D 패키징이 안고 있던 한계와, zHBM이 이를 어떻게 물리적으로 해결하는지 이해하는 것이 핵심입니다.
기존 2.5D 패키징(CoWoS 등)의 물리적 한계
RC 지연 및 전력 손실 (RC Delay & Power Loss):2.5D 구조에서는 신호가 실리콘 인터포저 내의 미세 배선(Metal Trace)을 수 mm 이상 통과해야 합니다. 이 과정에서 발생하는 배선 저항(R)과 기생 용량(C)으로 인해 신호 지연이 커지며, I/O를 구동하기 위한 전력 소모가 급증합니다.Power = f*C \ V^2전력 소모 공식에 따라 I/O 정전용량(C)이 커질수록 고주파(f) 구동 시 기하급수적인 전력 낭비가 발생합니다.
레티클 한계(Reticle Limit)와 면적 폭증:GPU 주위에 4개, 8개, 12개의 HBM을 병렬로 둘러싸게 되면 실리콘 인터포저의 크기가 거대해집니다. 인터포저 면적이 노광 장비의 레티클 한계를 초과하면 수율이 급락하고, 패키징 비용이 천문학적으로 치솟습니다.
zHBM의 3D Z축 직렬 통합 메커니즘
배선 길이의 극적인 단축 (mm-> um):GPU/NPU 로직 바로 위에 HBM 메모리 코어 다이를 수직으로 올리기 때문에 신호 이동 거리가 수 mm에서 수십 um 이하로 줄어듭니다.
I/O 밀도의 기하급수적 증가:기존 마이크로 범프(Micro-bump) 피치가 25 ~35um 수준이었다면, zHBM에 적용되는 구리-구리(Cu-Cu) 하이브리드 본딩 피치는 1um 이하까지 좁혀집니다. 단위 면적당 신호선(TSV) 밀도를 수십 배 이상 끌어올릴 수 있음을 의미합니다.
[ 3D zHBM 수직 구조 ]
+-------------------+
|    HBM Stack      |
+-------------------+  <-- Cu-Cu 직접 접합 (배선 < 10µm)
|    GPU / NPU      |      기생 용량 및 저항 최소화
+-------------------+
업계 요약 자료에 따르면 zHBM 도입 시 속도 4배 향상, 전력 1/4 감소, 칩 면적 단축이라는 비약적인 성과가 기대된다고 알려진 배경이 바로 이러한 물리적 거리의 극단적 축소에 있습니다.
4. 공정 기술의 핵: W2W 하이브리드 본딩과 수율의 역설
zHBM을 실제로 구현해 내기 위해 가장 핵심이 되는 공정 기술은 W2W(Wafer-to-Wafer) 하이브리드 본딩입니다.
C2W vs W2W 공정 비교
구분
기존 C2W (Chip-to-Wafer)
zHBM용 W2W (Wafer-to-Wafer)
연결 방식
마이크로 범프 (Solder Bump)
옥사이드/금속 직접 접합 (Cu-Cu Direct Bonding)
I/O 피치
25 ~ 35um
Sub-1 um ~4um
공정 환경 및 단가
상대적 저렴, 일반 클린룸
극도로 높음 (클린룸 Class 1 수준 필수)
수율 영향
KGD(Known Good Die) 선별 후 접합 가능
미검증 웨이퍼 통째 접합 (수율 관리 극난이도)
W2W 수율의 치명적 리스크: KGD 문제
C2W(Chip-to-Wafer) 방식은 웨이퍼 단계에서 테스트를 거쳐 정상 작동이 확인된 칩(KGD)만 골라내어 웨이퍼에 붙일 수 있습니다. 반면 W2W는 로직 웨이퍼와 D램 웨이퍼를 통째로 위치를 맞추어 접합한 뒤 다이싱(Dicing)합니다.
이때 ‘수율의 곱셈 법칙’이 작용합니다.
만약 로직 웨이퍼 수율이 80%이고, D램 웨이퍼 수율이 90%라면, 단 1층만 수직 적층하더라도 단순 합성 수율은 72%로 떨어집니다. 적층 레이어(Layer) 수가 늘어날수록 종합 수율은 가파르게 하락합니다.
따라서 삼성전자가 zHBM을 상용화하기 위해서는 파운드리 로직 공정과 초고밀도 D램 공정 모두에서 극상의 개별 수율을 확보해야만 하는 공학적 난제에 봉착하게 됩니다.
5. 열역학적 과제: 발열과 열팽창(CTE) 미스매치
zHBM 상용화를 가로막는 가장 거대한 하드웨어적 장벽은 바로 열 관리(Thermal Management)입니다.
1) 열 고립 현상 (Thermal Trapping)
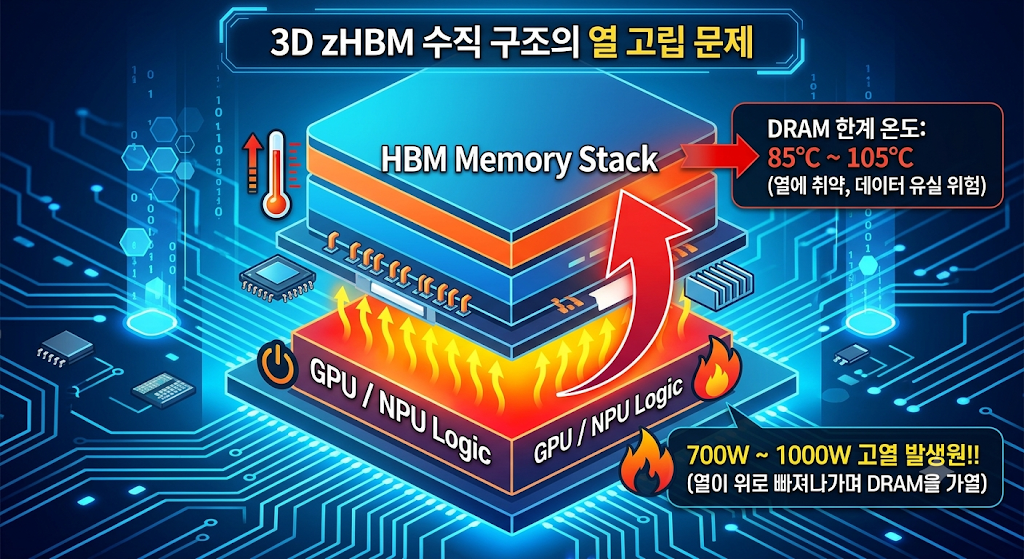
밑에 놓인 최첨단 GPU/NPU 로직 다이는 작동 시 700W~1000W 이상의 엄청난 열을 뿜어냅니다.
문제는 그 위에 D램 메모리를 직접 올려버리면, 로직 칩에서 발생한 고열이 D램을 통과해서 방열판으로 빠져나가야 한다는 점입니다. D램은 열에 매우 취약합니다. 칩 온도가 85 ~105C 이상으로 올라가면 전하 누설이 심해져 리프레시(Refresh) 주기를 단축해야 하고, 이는 대역폭 저하 및 데이터 유실로 이어집니다.
2) 열팽창계수(CTE) 불일치와 워피지(Warpage)
실리콘(Si), 구리 배선(Cu), 절연체(SiO_2/SiCN)는 각각 열에 따라 늘어나는 비율(열팽창계수)이 다릅니다. 고열이 가해지면 칩 전체가 비틀리는 워피지(Warpage) 현상이나, 층간 접합면이 떨어져 나가는 박리(Delamination) 현상이 발생합니다.
해결을 위한 기술적 모색
삼성전자는 이를 극복하기 위해 다음과 같은 고난도 방열 솔루션을 연구 개발 중입니다.
HPB (Heat Path Block): 로직 칩의 열을 외곽 테두리로 우회시켜 상부 방열판으로 빠져나가게 하는 별도 열전도 경로 설계
SiCN 절연막 적용: 방열 특성 및 접합력이 뛰어난 신소재 절연막 도입
액체 냉각 (Microfluidic Cooling): 칩 내부나 인터페이스 층 사이에 미세 미소채널을 뚫어 냉각수를 직접 순환시키는 차세대 쿨링 기술
6. 소프트웨어 및 시스템 아키텍처 관점의 파급력
zHBM은 단순한 “빠른 메모리 부품”의 추가가 아닙니다. 컴퓨팅 시스템 구조와 소프트웨어 생태계 전체를 바꾸는 일대 사건입니다.
① LLM KV-Cache 병목 완화
현재 대규모 언어 모델(LLM) 추론 시 성능을 저하시키는 핵심 요인은 KV-Cache(Key-Value Cache) 관리입니다. Context Window(문맥 길이)가 길어질수록 메모리 대역폭 한계 때문에 GPU 연산기(ALU)가 계산을 멈추고 대기하는 ‘Memory-Bound’ 현상이 심화됩니다.
zHBM을 통해 초고대역폭이 확보되면, GPU 연산 코어 가동률(Compute Utilization)이 기존 30~40%수준에서 80%이상으로 끌어올려질 수 있습니다. 이는 동일한 GPU로 수 배 많은 사용자 요청을 동시에 처리할 수 있음을 의미합니다.
② PIM(Processing-In-Memory)과의 완벽한 융합
로직과 메모리가 sub-1 um 피치로 직렬 연결되면, “어디까지가 메모리이고 어디까지가 로직인가?”의 경계가 모호해집니다.
GPU의 L3/L4 캐시 메모리처럼 HBM을 초고속으로 직렬 매핑 가능
PyTorch, CUDA 등 소프트웨어 프레임워크 단에서 메모리-연산 장치 간 데이터 이동 명령어를 대폭 절감하는 새로운 컴파일러 최적화가 필수화됨
7. 경쟁 구도 분석: 삼성전자 zHBM vs SK하이닉스 HBF
FMS 2026 등 주요 글로벌 학회에서 나타난 한국 반도체 두 거인의 전략은 “같은 문제(AI 메모리 병목), 전혀 다른 해법”으로 요약됩니다.
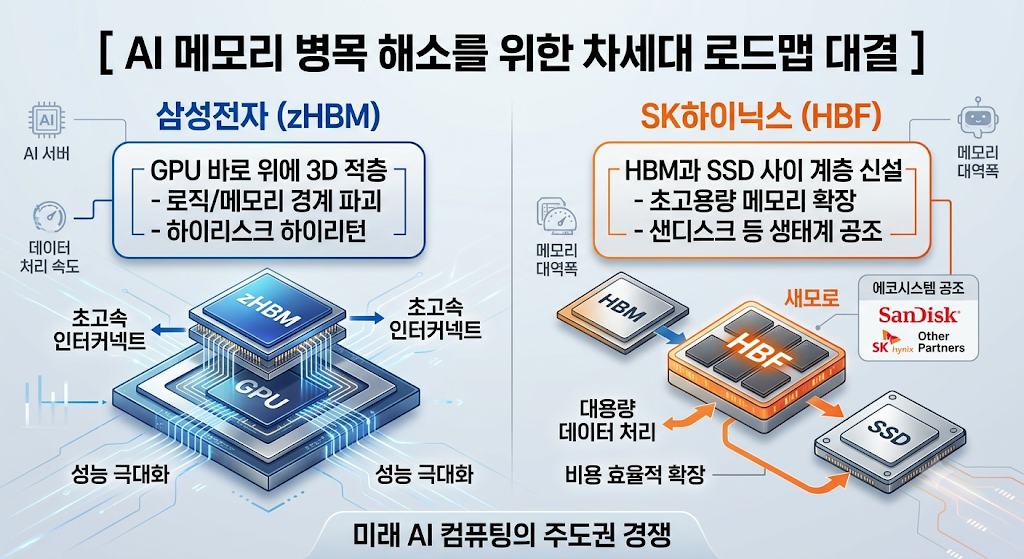
삼성전자 (zHBM): 로직과 메모리를 Z축으로 직접 3D 통합하여 극단적인 속도와 전력 효율을 추구합니다.
SK하이닉스 (HBF – High Bandwidth Flash): 샌디스크 등과 협력하여 HBM과 SSD 사이에 위치하는 새로운 메모리 계층(HBF) 표준 규격을 공개했습니다. HBM의 부족한 ‘용량’ 한계를 플래시 기술로 보완하는 접근입니다.
두 공룡 모두 “메모리를 컴퓨팅에 더 가깝고 입체적으로 붙여야 한다”는 대전제에는 동의하고 있으나, 삼성전자는 ‘패키징 패러다임 전면 혁신’, SK하이닉스는 ‘메모리 계층화 및 표준 생태계 확산’에 무게를 두고 있습니다.
8. 투자자 관점의 평가: “판 뒤집기 카드”인가, “위험한 베팅”인가?
유명 경제 블로거이자 IT 분석가로서, 이 기술을 바라보는 냉철한 투자적 시각을 정리해 드립니다.
파급력이 클 수 있다고 보는 이유 (Bull Case)
문제의 본질(데이터 이동)을 정확히 타격: 단순한 미세 공정 전환이 아닌 패키징 아키텍처의 근본적 혁신입니다. 성공할 경우 반도체 산업의 설계 표준 자체가 바뀝니다.
삼성전자의 독보적 IDM 역량 결합: 삼성전자는 메모리 + 파운드리 + 고급 패키징(AVP)을 모두 한 회사 내에 보유한 전 세계 유일무이한 종합반도체 기업(IDM)입니다. zHBM처럼 로직과 메모리를 유기적으로 설계·제조해야 하는 기술은 팹리스와 외주 파운드리/OSAT에 의존하는 경쟁사들이 단기간에 따라오기 힘든 구조적 강점을 가집니다.
시장 점유율 판도를 바꿀 판 뒤집기 카드: 2025년 기준 HBM 시장 점유율에서 삼성전자(약 18%)는 SK하이닉스(약 61%)에 밀려 힘겨운 싸움을 이어왔습니다. 점진적인 HBM4/HBM5 스펙 싸움으로는 역전이 어렵기에, 한 세대를 건너뛰는 zHBM은 삼성에 최고의 ‘게임체인저’ 카드가 될 수 있습니다.
신중해야 할 이유 (Bear Case)
여전히 ‘컨셉 및 로드맵’ 단계: 2026년 발표된 내용들은 방향 제시 수준입니다. 양산 시점이나 데이터시트 기반의 공식 스펙이 아직 확정되지 않았습니다.
극악의 공정 기술 난이도: 앞서 언급한 W2W 수율의 역설, 1000W에 육박하는 로직 열 제어 문제는 엔지니어링 측면에서 통과하기 매우 까다로운 관문입니다.
빅테크 생태계(엔비디아 등)의 동의 필요: zHBM은 범용 메모리가 아닙니다. 엔비디아, AMD, 구글, 메타 같은 팹리스 공룡들이 자사 GPU/TPU 아키텍처 자체를 zHBM 구조에 맞춰 재설계해주어야만 판매가 가능합니다.
9. 결론 및 3대 핵심 관전 포인트
삼성전자의 zHBM은 기존 2.5D 패키징의 한계를 깨뜨리기 위한 가장 진보적이고 명확한 방향성의 기술입니다. 하지만 하이리턴 뒤에는 언제나 하이리스크가 따릅니다.
투자자와 엔지니어 입장에서 zHBM의 성공 여부를 가늠할 3대 핵심 관전 포인트는 다음과 같습니다.
1. 공정 / 수율  : W2W 하이브리드 본딩 시 다이 파손 및 이물질을 제어하고 경제적 수율을 확보하는가?
2. 열 제어 기술 : 700W+ 로직 칩 위에서 DRAM 동작 온도를 85°C 이하로 유지할 방열 모듈을 상용화하는가?
3. 고객사 생태계: 엔비디아, AMD 등 Big Tech가 자사 차세대 칩 아키텍처로 zHBM 수직 구조를 채택하는가?
zHBM이 단순한 비전에 그칠지, 아니면 HBM 시장의 주도권을 일시에 가져올 ‘신의 한 수’가 될지는 위 세 가지 질문에 삼성전자가 어떤 실물 칩과 데이터로 답하느냐에 달려 있습니다. 지속적인 모니터링이 필요한 시점입니다.
반도체 투자의 역설… 최근 글로벌 자본시장은 그야말로 ‘해석의 붕괴’를 경험하고 있습니다. 인공지능(AI) 혁명의 최전선에 서 있는 반도체 기업들이 사상 최대 수준의 실적을 연이어 발표하고 있음에도 불구하고, 주가는 마치 거대한 침체 국면에 진입한 것처럼 곤두박질치고 있기 때문입니다.
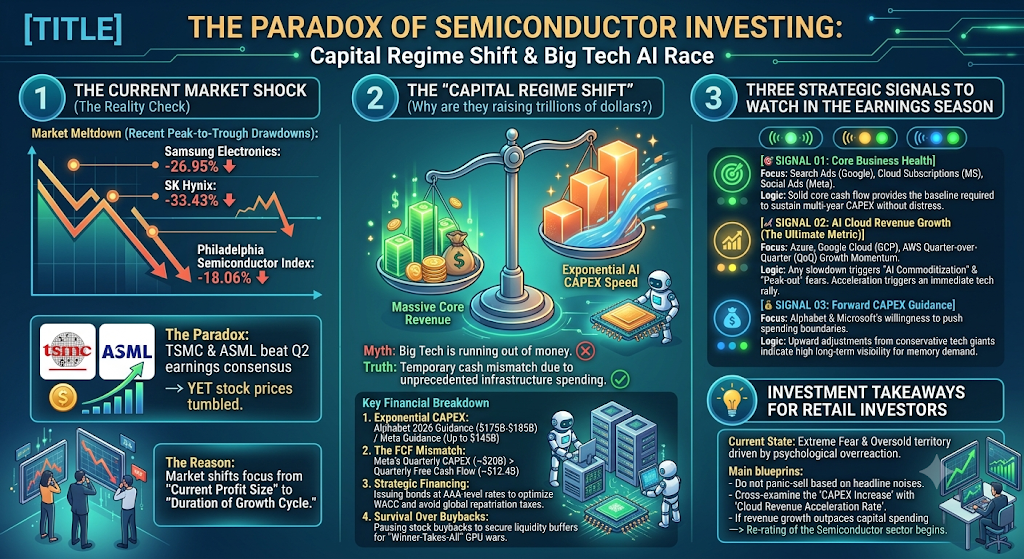
국내 증시를 지탱하는 두 거두, 삼성전자와 SK하이닉스의 주가는 최근 고점 대비 각각 26.95%, 33.43% 급락하며 개인 투자자들의 비명 소리를 키우고 있습니다. 글로벌 반도체 공급망의 핵심인 대만의 TSMC가 올해 2분기 시장 예측치를 아늑하게 뛰어넘는 사상 최대 순이익을 기록하고, 네덜란드의 글로벌 노광장비 독점 기업 ASML이 놀라운 어닝 서프라이즈를 달성했음에도 주가는 냉혹하게 꺾였습니다.
이러한 현상은 전통적인 경제학 지식이나 단순한 실적 분석만으로는 설명하기 어렵습니다. 시장을 지배하고 있는 핵심 논리는 ‘현재의 완벽함’이 아니라 ‘미래의 지속 가능성’에 대한 의구심입니다.
자본시장은 언제나 후행 지표인 현재의 실적보다 선행 지표인 미래의 확신에 움직입니다. 현재 반도체와 AI 업종은 단순한 실적 장세에서 밸류에이션(Valuation)의 구조적 성격이 변하는 과도기에 직면해 있습니다. 본 포스팅에서는 IT 기술 전문성과 거시경제적 투자 안목을 결합하여, 현재 반도체 투자 심리가 이토록 차갑게 얼어붙은 본질적인 원인을 해부하고, 이달 말 예정된 미국 대형 하이퍼스케일러(Hyperscaler)들의 실적 발표가 어떻게 반등의 트리거가 될 수 있는지 심층 분석합니다.
2. 반도체 투심이 얼어붙은 3가지 본질적 이유: ‘크기’에서 ‘지속 기간’으로의 패러다임 전환
현재 반도체 공급망이나 단기 펀더멘털(Fundamental) 자체에는 아무런 문제가 없습니다. 고대역폭 메모리(HBM)와 첨단 파운드리의 캐파(CAPA)는 여전히 공급이 수요를 따라가지 못하는 병목 현상이 지속되고 있습니다. 그런데도 투자 심리가 이토록 망가진 원인은 시장이 요구하는 질문의 차원이 달라졌기 때문입니다.
[과거의 질문] "AI 시장이 얼마나 빠르게 성장할 것인가? (성장의 속도와 모멘텀)"
   ▼
[현재의 질문] "이 성장이 이후에도 지속될 근거는 무엇인가? (성장의 지속 기간과 효율성)"
① 성장 가속도(Momentum)의 한계와 후행 지표의 함정
주식시장에서 가장 위험한 순간은 ‘실적이 나쁠 때’가 아니라 ‘실적이 이보다 더 좋을 수 없을 때’입니다. 이를 흔히 ‘피크아웃(Peak-out, 정점 통과)’ 공포라고 부릅니다.
TSMC와 ASML이 깜짝 실적을 냈음에도 주가가 하락한 것은, 투자자들이 향후 성장 가속도가 현재보다 더 빨라지기는 구조적으로 어렵다고 판단했기 때문입니다. 시장은 절대적인 이익의 수치(Absolute Number)보다 성장률의 가속 여부에 프리미엄을 부여합니다. 분기 성장률이 50%에서 60%로 올라갈 때는 주가가 폭등하지만, 60%라는 경이적인 성장을 유지하더라도 다음 분기 전망이 55%로 둔화되는 조짐이 보이면 시장은 이를 매도 신호로 받아들입니다.
② 투자 회수율(ROI) 및 자본 효율성(ROIC)에 대한 의구심
지난 1~2년간 빅테크 기업들은 엔비디아의 GPU를 비롯하여 삼성전자와 SK하이닉스의 HBM 메모리를 천문학적인 액수로 사들였습니다. 인프라를 먼저 구축하지 않으면 AI 경쟁에서 영원히 도태될 수 있다는 포모(FOMO, 소외 불안 증후군)가 작동했기 때문입니다.
그러나 이제 냉정한 정산의 시간이 다가오고 있습니다. 월가와 글로벌 투자자들은 하이퍼스케일러들을 향해 “천문학적인 인프라 투자(CAPEX)를 단행했는데, 도대체 이걸로 언제, 어떻게 본전을 뽑고 유의미한 영업이익을 창출할 것인가?”에 대한 구체적인 증명을 요구하기 시작했습니다. AI 서비스의 실제 수익화 속도가 인프라 투자 속도를 따라가지 못한다는 불확실성이 반도체 전방 산업의 할인율을 높이고 있습니다.
③ 중국발 AI 모델 범용화(Commoditization)와 리턴 함수의 균열
최근 AI 인프라 투자의 본질적인 리턴 함수(Return Function)를 흔드는 가장 무서운 변수는 중국계 AI 기업들의 거센 추격과 ‘오픈웨이트(Open-weight) 모델’의 확산입니다. 중국의 문샷AI(Moonshot AI)가 최근 공개한 소스코드 공개형 모델 ‘키미 K3(Kimi K3)’를 비롯해 알리바바, 텐센트 등 중국의 테크 자이언트들이 앞다투어 고성능 초거대 AI 모델을 쏟아내고 있습니다.
AI 모델이 오픈소스 및 범용화 과정을 거치면 기술적 독점력이 약화되고, 시장 전반의 토큰당 비용(Cost per Token)이 급격하게 하락합니다. 이는 사용자 입장에서는 축복이지만, 천문학적인 자본을 투입해 독점적 생태계를 구축하려던 미국 빅테크 기업들에는 비즈니스 모델의 마진 압박을 의미합니다. 토큰당 비용이 하락하고 알고리즘이 효율화되면, 동일한 서비스 가치를 창출하는 데 필요한 GPU와 고성능 메모리의 절대적인 수요량이 구조적으로 감축될 수 있다는 공포가 메모리 반도체 산업의 장기 가시성을 흐리는 요인으로 작용하고 있습니다.
3. 매크로 역학 관계: 금리 상승과 빅테크 CAPEX의 상반 관계 해부
현재 시장의 또 다른 거대한 의문점은 고금리 기조의 장기화 및 금리 변동성 속에서도 미국 빅테크 기업들의 설비투자(CAPEX) 규모는 왜 꺾이지 않고 오히려 사상 최고치를 경신하는가 하는 점입니다. 겉보기에는 명백한 모순처럼 보이는 이 현상은 재무적 주체(자금 조달 구조)와 요구수익률(Hurdle Rate)이라는 두 가지 트랙으로 분리해서 보면 매우 명쾌하게 이해할 수 있습니다.
구분
전통적인 제조 기업 (Old Economy)
대형 하이퍼스케일러 (Big Tech)
자금 조달 방식
은행 대출, 회사채 발행 등 외부 부채(Debt) 의존도 높음
막대한 영업현금흐름(FCF) 및 내부 유보자금 활용
금리 상승의 영향
이자 비용이 즉각적으로 증가하여 설비투자(CAPEX) 축소
자금 조달의 압박이 적어 절대적 투자 규모 유지 가능
시장의 평가 기준
당기순이익 및 부채비율 등의 재무 건전성
투자 자본 대비 수익화 속도 및 매출 성장률 모멘텀
① 빅테크는 ‘남의 돈’으로 투자하지 않는다: 양적 측면의 건전성
일반적인 기업들은 금리가 인상되면 이자 비용 부담이 눈덩이처럼 불어나기 때문에 공장 증설이나 설비투자를 전면 중단하거나 축소합니다. 그러나 알파벳(구글), 마이크로소프트, 아마존, 메타와 같은 하이퍼스케일러들은 매 분기 수십조 원 단위의 막대한 현금흐름(Free Cash Flow)을 자체적으로 창출해 냅니다.
즉, 이들은 고금리 환경 속에서도 타인자본(부채)에 의존하지 않고 내부의 잉여현금만으로 AI 데이터센터 인프라 투자를 감당할 수 있는 독보적인 재무 구조를 가지고 있습니다. 이것이 고금리 장기화 국면 속에서도 글로벌 빅테크의 합산 CAPEX 가이던스가 꺾이지 않고 우상향할 수 있는 근본적인 배경입니다.
② 고금리는 투자의 ‘질(Quality)’을 심판한다: 질적 측면의 압박
자금 조달 능력에는 문제가 없을지라도, 고금리는 주식시장이 이 투자를 바라보는 눈높이와 평가 기준을 완전히 바꾸어 놓습니다. 금융공학적으로 금리가 상승한다는 것은 미래에 벌어들일 현금흐름을 오늘날의 가치로 환산하는 할인율(Discount Rate)의 상승을 의미합니다.
저금리 시대의 문법: 자본비용이 낮기 때문에 “지금 당장 돈을 못 벌어도 5년, 10년 뒤에 인공지능 생태계를 독점하여 엄청난 현금을 벌어들이면 된다”는 원대한 서사(Narrative)와 미래 비전이 쉽게 통용되었습니다.
고금리 시대의 문법: 가만히 있어도 채권이나 안전자산에서 높은 수익률을 기대할 수 있으므로, 자본비용(WACC)의 기준선이 급격히 높아집니다. 따라서 시장은 빅테크 기업들을 향해 “일단 지르고 보는 투자는 끝났다. 지금 당장(Now) 그 투자가 정당한 이익률로 돌아오고 있는지 숫자로 증명하라”고 서슬 퍼런 칼날을 들이댑니다.
결국 금리 상승과 빅테크 CAPEX의 증가는 서로 충돌하는 것이 아니라, “돈이 많으니 투자는 중단 없이 계속하되(CAPEX 절대액 유지), 고금리 환경인 만큼 그 투자가 유효함을 입증해야 하는 허들(요구수익률 및 매출 성장률)은 과거보다 훨씬 높아졌다”는 강력한 이중 압박 구조를 형성하고 있는 것입니다.
4. 천문학적 자금 조달의 진실: 현금 결핍인가, 자본의 대전환인가?
최근 알파벳이 850억 달러 규모의 대규모 증자와 320억 달러의 본드(Bond) 발행을 단행하고, 메타가 250억 달러 규모의 회사채 발행 및 추가 증자를 검토한다는 소식이 시장에 전해지며 투자자들 사이에서 일종의 의구심이 피어오르고 있습니다. “매 분기 엄청난 돈을 쓸어 담는 빅테크들이 왜 갑자기 주주 지분을 희석해가면서까지 천문학적인 실탄을 밖에서 조달하는가? 혹시 현금흐름에 경고등이 켜진 것인가?”라는 질문입니다.
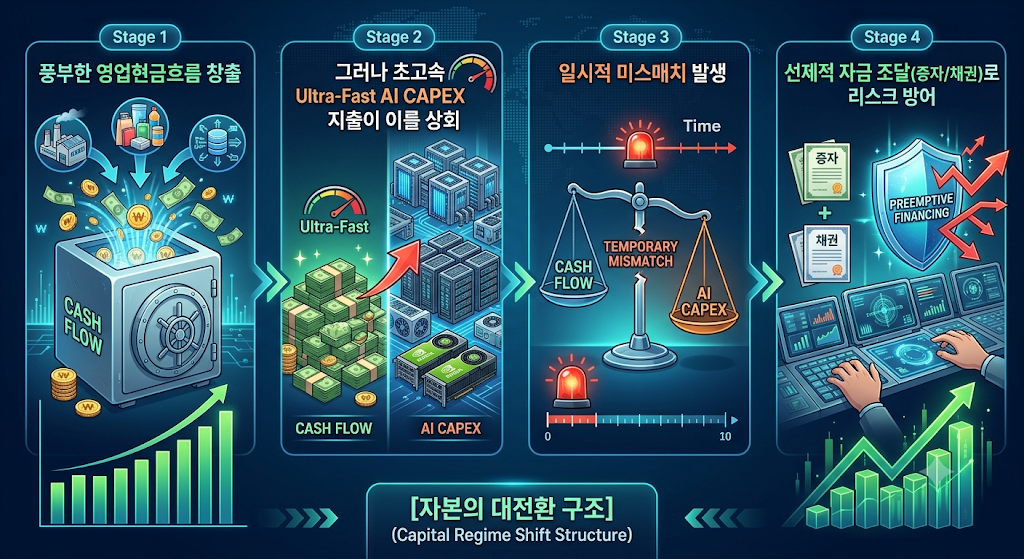
결론부터 짚어드리면, 이는 기업의 도산이나 유동성 위기를 뜻하는 현금 결핍(Distress)이 절대 아닙니다. 본질은 “현재 본업으로 벌어들이는 현금의 속도보다, AI 인프라 장악을 위해 쏟아부어야 하는 CAPEX의 요구 규모가 무시무시할 정도로 압도적인 데서 오는 일시적 미스매치”이자, 이른바 ‘자본의 대전환(Capital Regime Shift)’ 과정에서 발생하는 현상입니다.
① ‘풍부한 현금’과 ‘폭발적인 CAPEX’ 사이의 거대한 미스매치
빅테크의 영업현금흐름이 사상 최고 수준인 것은 분명하지만, 지금 전개되는 AI 데이터센터 및 전력망 인프라 경쟁은 과거 스마트폰 혁명이나 초창기 클라우드 전환기와는 체급 자체가 다릅니다.
CAPEX 예측치의 천장 없는 상향: 알파벳의 연간 가이던스는 무려 1,750억~1,850억 달러(약 240조~250조 원)에 달하는 궤도에 진입했으며, 메타 역시 최대 1,450억 달러까지 지출을 확대하고 있습니다. 이는 불과 1년 전 시장이 예상했던 컨센서스의 두 배에 육박하는 폭발적인 수치입니다.
FCF(잉여현금흐름)를 추월하는 지출 속도: 메타의 재무제표를 뜯어보면 이러한 미스매치가 극명히 드러납니다. 최근 분기 메타의 설비투자액(약 200억 달러)은 해당 분기에 벌어들인 잉여현금흐름(FCF, 약 124억 달러)을 가볍게 상회했습니다. 아무리 본업에서 돈을 빗자루로 쓸어 담아도, 엔비디아의 차세대 칩을 선점하고 하이퍼스케일 데이터센터 부지를 확보하는 속도가 더 빠르다 보니 장부상 ‘일시적인 현금 부족 구간’이 발생하는 것입니다.
② 왜 자사주 매입(Buyback)을 멈추고 지분 희석(증자)을 감수하는가?
전통적으로 미국 빅테크들은 넘쳐나는 현금을 주체하지 못해 자사주를 매입해 불태우며 주주가치를 극대화하던 주가 관리의 명수들이었습니다. 그러나 최근 기류는 정반대로 흐르고 있습니다. 메타는 자사주 매입 프로그램을 일시 중단하는 결단을 내렸고, 알파벳은 지분 희석(Dilution) 우려로 인한 주주들의 반발을 감수하고 대규모 증자를 감행했습니다.
이유는 단 하나, “지금은 한가하게 주가 관리를 할 때가 아니라, 생존이 걸린 AI 인프라 영토를 확보하는 것이 100배 더 급하다”는 경영진의 절박한 판단 때문입니다. AI 싸움은 철저한 승자독식(Winner-takes-all) 시장입니다. 초기 인프라 레이스에서 밀려 수백만 대의 GPU 칩과 컴퓨팅 파워를 제때 확보하지 못하면 미래 테크 생태계 전체를 잃어버릴 수 있다는 극단적인 위기감이 깔려 있습니다. 기업 내부의 현금만 믿고 투자를 집행하다가 자칫 비상금(유동성 버퍼)이 바닥나는 리스크를 피하기 위해, 단기적인 주가 조정을 감내하고서라도 미리 시장에서 거액의 실탄을 조달해 두는 전략입니다.
③ 고금리 환경 속 회사채 발행에 숨겨진 ‘재무적 고도의 전략’
자본비용이 비싸진 고금리 시대에 굳이 채권을 발행하는 배경에는 빅테크만의 독보적인 재무적 특권과 절세 전략이 결합해 있습니다.
초우량 신용등급(AA~AA+)의 레버리지: 알파벳이나 마이크로소프트 같은 테크 자이언트들은 웬만한 선진국 정부 수준의 신용도를 자랑합니다. 실제로 알파벳이 발행한 초장기 채권은 시장의 매크로 우려를 비웃듯 굉장히 유리한 저리로 흥행에 성공했습니다.
세금 방어(Tax Shield)와 WACC 최적화: 재무학의 관점에서 100% 자기자본(자사 현금)으로만 투자하는 구조보다, 저리로 부채(타인자본)를 일정 비율 섞어서 투자하는 것이 이자 비용의 비용 처리를 통한 법인세 절세 효과를 누릴 수 있어 기업의 가중평균자본비용(WACC)을 낮추는 데 훨씬 유리합니다.
글로벌 송환세(Repatriation Tax) 회피: 미국 빅테크들이 해외(유럽 등) 법인에 쌓아둔 막대한 현금을 미국 본사로 송환하려면 엄청난 세금을 감수해야 합니다. 따라서 굳이 해외 현금을 들여오기보다, 차라리 유럽 현지 금융시장에서 유로나 스위스 프랑화 채권을 낮은 금리로 발행해 투자 자금을 조달하는 방식을 취합니다. 현금이 없어서 빚을 지는 게 아니라, 자본을 전 세계에서 가장 싸고 효율적으로 굴리기 위한 재무적 잔머리이자 고도의 전략인 셈입니다.
5. 반등의 방아쇠: 미국 하이퍼스케일러 실적 발표에서 주목해야 할 3가지 핵심 신호
국내 반도체 투톱인 삼성전자와 SK하이닉스가 코스피 시장에서 차지하는 시가총액 비중은 절대적입니다. 이들의 주가가 침체의 터널을 벗어나 강력한 반등의 트리거를 당기기 위해서는 결국 전방 산업이자 최대 고객사인 미국 하이퍼스케일러들의 실적 성적표에서 시장이 납득할 만한 단서가 나와야 합니다. 오픈AI나 앤트로픽 같은 프론티어 AI 기업들이 대부분 비상장 상태이기 때문에, AI 수요의 실체와 미래 인프라 투자 지속 여부는 오직 이들의 실적 발표를 통해서만 확인 가능합니다.
이달 말로 예정된 알파벳, 메타, 마이크로소프트, 아마존의 실적 발표에서 우리가 반드시 확인해야 할 3가지 핵심 변수는 다음과 같습니다.
① 본업의 이익과 현금흐름 (Core Business Health)
AI 투자를 지속하기 위한 가장 중요한 전제 조건은 본진이 무너지지 않는 것입니다. 알파벳의 구글 검색 광고, 메타의 SNS 광고 매출, 마이크로소프트의 오피스 및 윈도우 라이선스 매출, 아마존의 리테일 커머스 등 기존 본업에서 강력한 이익과 현금흐름이 든든하게 받쳐주어야 합니다.
만약 경기 둔화나 경쟁 심화로 인해 본업의 수익성이 악화되거나 마진율이 하락하는 신호가 포착된다면, 시장은 빅테크 경영진들이 주주가치 제고와 비용 통제를 위해 AI CAPEX 규모를 강제로 축소할 수밖에 없을 것이라는 공포에 휩싸이게 됩니다. 본업의 탄탄한 마진 유지는 AI 투자의 지속 기간을 보장하는 기초 체력입니다.
② AI 클라우드 부문 매출 성장률 (AI Cloud Revenue Growth)
시장은 현재 성장의 절대적인 크기보다 성장률의 방향성(모멘텀의 가속 또는 둔화)에 극도로 예민하게 반응하고 있습니다. 마이크로소프트의 애저(Azure), 알파벳의 구글 클라우드(GCP), 아마존의 AWS 매출 증가율이 전 분기 대비 가속화되는지, 아니면 꺾이는지가 초미의 관심사입니다.
이미 AI 클라우드 부문의 매출액 증가율 확대가 본격화되며 기대감을 높여놓았기 때문에, 만약 이번 실적 시즌에서 매출액 증가율이 전 분기 대비 단 1%포인트라도 낮아지거나 정체되는 모습을 보인다면 시장은 이를 심각한 피크아웃 신호로 해석하며 발작적인 매도세를 보일 수 있습니다. 반대로 성장률이 예상을 깨고 우상향한다면 AI 범용화 우려를 잠재우고 강한 투자 랠리를 촉발할 것입니다.
③ CAPEX 가이던스의 적극적 상향 여부 (Forward CAPEX Guidance)
특히 이번 실적 시즌에서는 알파벳과 마이크로소프트의 미래 설비투자 가이던스 방향성에 주목해야 합니다. 두 기업은 글로벌 AI 전쟁의 중심에 서 있지만, 영업현금흐름 대비 CAPEX가 차지하는 비중을 살펴보면 오라클, 아마존, 메타 등 경쟁사들에 비해 상대적으로 보수적이고신중한 기조를 유지해 왔습니다.
시장에서 AI 인프라 투자 사이클의 지속성에 대한 의구심이 팽배한 현재 상황에서, 상대적으로 신중했던 알파벳과 마이크로소프트가 향후 CAPEX 전망치를 상향 조정하거나 더욱 공격적인 인프라 투자 계획을 공식화한다면, 이는 전 세계 반도체 공급망에 “AI 수요의 실체와 장기 가시성이 확실하다”는 가장 강력한 보증수표를 발행하는 것과 같습니다. 이들의 가이던스 상향은 얼어붙은 반도체 투자 심리를 일시에 녹일 수 있는 최고의 트리거입니다.
6. 빅테크별 실적 변수와 국내 반도체(삼성전자·SK하이닉스) 주가 변동의 비대칭적 상관관계
미국 빅테크 기업들의 어닝 서프라이즈 혹은 쇼크 여부는 국내 반도체 투톱의 주가 향방을 결정짓는 절대적인 지표입니다. 과거 자본시장 데이터와 증권가의 분석을 종합해 보면, 빅테크 기업들의 특정 재무 지표가 국내 증시에 미치는 영향은 고도의 비대칭적 상관관계를 나타내고 있습니다.
빅테크 주요 기업별 핵심 관전 포인트와 시장 영향력
알파벳(구글)의 압도적인 선행성: 통계 분석에 따르면, 역사적으로 알파벳이 분기 실적 발표에서 매출액 기준 어닝 서프라이즈를 기록했을 때, 이후 1개월간 삼성전자와 SK하이닉스의 평균 주가 수익률은 각각 11%, 17%라는 높은 수치를 기록했습니다. 반면 알파벳이 어닝 쇼크를 기록했을 때의 1개월 평균 수익률은 각각 2%, -3%로 처참한 수준에 그쳤습니다. 즉, 실적 시즌의 포문을 여는 알파벳의 성적표는 국내 반도체 주가의 단기 방향성을 결정짓는 가장 신뢰도 높은 이정표 역할을 합니다.
마이크로소프트의 CAPEX 허들: 마이크로소프트는 오픈AI의 최대 투자자이자 AI 생태계의 대장주이기 때문에 이들이 제시하는 CAPEX 예상치 초과 여부는 전 세계 고성능 메모리(HBM) 및 파운드리 기업들의 주가 멀티플에 직접적인 영향을 미칩니다. 가이던스가 시장의 컨센서스를 상회하느냐 미달하느냐에 따라 주가 변동성이 극대화될 것입니다.
메타와 아마존의 이익 증명: 메타와 아마존은 주당순이익(EPS) 예상치 초과 달성 여부와 함께, 광고 및 리테일이라는 견고한 캐시카우가 대규모 AI 투자 속에서도 마진율을 훼손하지 않았음을 증명해야 합니다. 이들의 실적 성공은 반도체 섹터 전반의 공포 심리를 안도감으로 돌려놓는 방어벽이 됩니다.
7. 결론 및 투자자를 위한 지혜로운 대응 방향: 공포의 정점에서 숫자를 확인하라
빅테크들의 대규모 증자와 채권 발행 현상을 기존 시장의 우려와 연결하면 마침내 얼어붙은 투심의 ‘마지막 퍼즐’이 완성됩니다. 시장은 지금 빅테크들이 “본업으로 엄청난 돈을 버는데도 모자라 주주들의 지분 희석까지 감수하며 돈을 쏟아붓고 있는데, 만약 AI 클라우드 성장률이 조금이라도 정체되면 이 무시무시한 조달 비용과 감가상각비를 도대체 어떻게 감당하려는가?”라는 근원적인 비용 공포증에 사로잡힌 것입니다. 즉, 빅테크의 공격적인 자금 조달 행위 자체가 시장에는 오히려 “AI 투자 비용 부담이 통제 불가능할 정도로 커지고 있구나”라는 역설적인 공포 신호로 전도된 상황입니다.
따라서 이번 실적 발표를 마주하는 투자자의 필승 전략은 명확합니다. 단순히 ‘CAPEX 규모가 얼마나 더 늘어났는가’에 집착할 것이 아니라, ‘그렇게 주주 눈치 안 보고 조달한 돈을 투입해 클라우드 매출 성장 속도를 얼마나 가속화시켰는가(수익화 속도의 증명)’를 반드시 대조해 보아야 합니다.
매출 성장률 미달 시: 늘어난 조달 비용과 인프라 지출 마진을 상회하는 매출 가속화가 증명되지 못한다면, 반도체 및 빅테크 섹터는 밸류에이션 멀티플의 추가적인 고통스러운 조정을 겪을 가능성이 큽니다.
매출 가속화 증명 시: 시장의 우려를 비웃는 압도적인 클라우드 매출 성장과 AI 비즈니스의 숫자가 확인된다면, 시장은 즉각 태세를 전환하여 “역시 돈을 빌려서라도, 주주 지분을 쪼개서라도 지금 인프라를 무조건 깔아두는 게 백번 맞았다!”라며 환호성과 함께 강력한 보상 랠리(Short-covering)를 펼칠 것입니다.
현재 삼성전자(-26%)와 SK하이닉스(-33%)의 주가 수준은 심리적 과장과 거시적 공포가 뒤섞여 본질 가치 대비 과도하게 짓눌린 과매도 구간입니다. 지금의 자금 조달 붐은 빅테크의 부실을 뜻하는 나쁜 신호가 아니라, 문명이 통째로 뒤바뀌는 패러다임 전환기에 필연적으로 발생하는 ‘극단적인 자본 확충 경쟁’입니다. 감정에 휘둘려 투매에 동참하기보다, 거시적인 안목을 유지한 채 빅테크가 내놓을 진짜 ‘수익성 성적표’를 확인하고 움직여도 결코 늦지 않습니다. 냉정하게 숫자를 확인하는 자가 결국 승자가 될 것입니다.
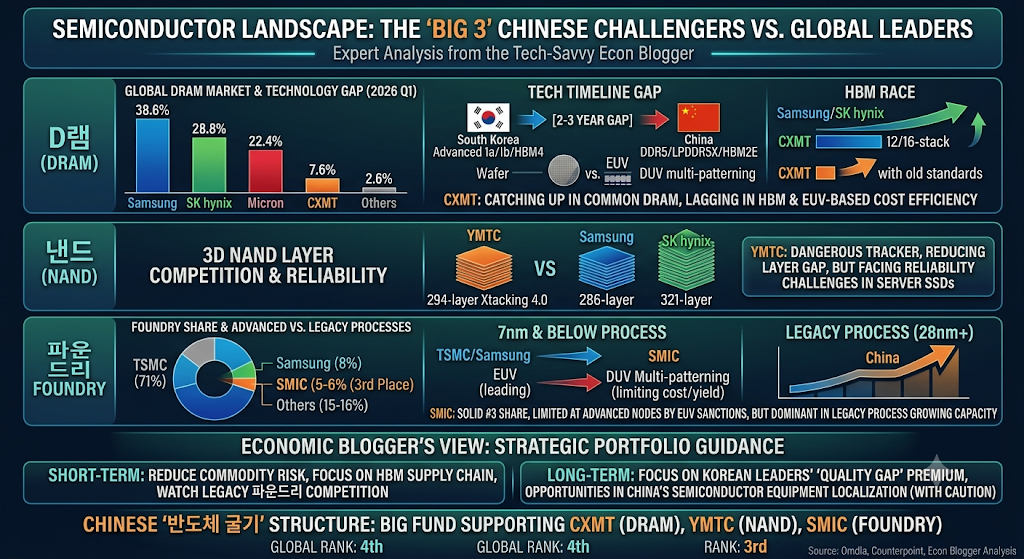
최근 반도체 시장을 뜨겁게 달구고 있는 가장 거대한 사건은 단연 중국 D램의 자존심인 창신메모리(CXMT)의 역사적인 상하이 증권거래소 IPO일 것입니다. 신규 발행 주식만 66억 주, 조달 금액은 무려 295억 위안(약 6조 5,000억 원)에서 시장 상황에 따라 최대 666억 위안(약 14조 7,000억 원)에 달하는 천문학적인 실탄입니다. 상장 후 예상 기업가치는 최고 3조 위안(약 663조 원)까지 거론되며 시장을 뒤흔들고 있습니다.
이러한 수치적 화려함 뒤에는 시장의 극단적인 두 가지 시선이 교차합니다. 한쪽에서는 “중국 반도체 굴기가 결국 한국의 숨통을 죌 것”이라는 공포 섞인 ‘중국 위협론’을 제기하고, 다른 한쪽에서는 “미국의 강력한 장비 제재 속에서 껍데기만 요란한 성장”이라는 ‘중국 한계론’을 펼칩니다.
우리가 투자의 대가로서, 그리고 기술의 본질을 이해하는 스마트한 투자자로서 살아남기 위해서는 감정적 대응이나 막연한 낙관론을 철저히 배제해야 합니다. 기술의 물리적 법칙과 엔지니어링의 현실, 그리고 글로벌 공급망의 역학 관계 속에서 이 세 기업(CXMT, YMTC, SMIC)의 정확한 위상과 숨겨진 ‘아킬레스건’을 낱낱이 파헤쳐 드리겠습니다.
1. CXMT (창신메모리) 분석: ‘EUV 미보유’가 가져온 원가와 수율의 아킬레스건
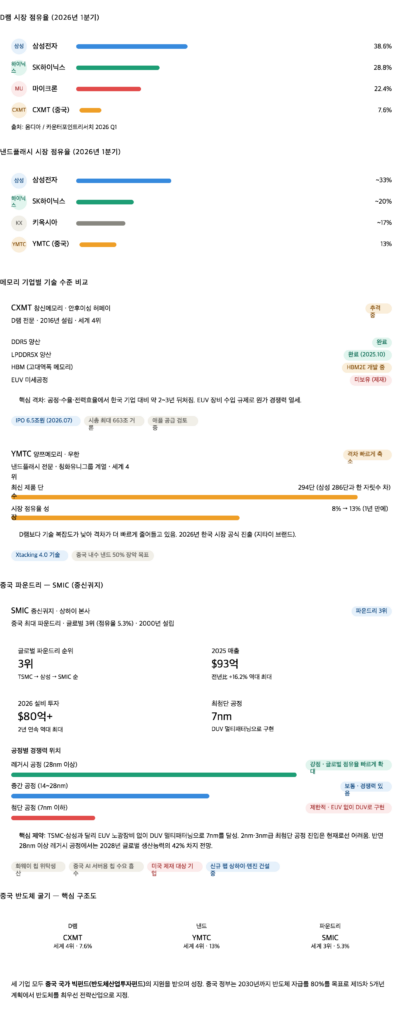
2016년 설립 이후 단 10년 만에 글로벌 D램 점유율 4위(2026년 1분기 기준 약 7.6%)로 도약한 CXMT의 성장은 눈부십니다. CXMT 스스로도 투자설명서에서 삼성전자, SK하이닉스, 마이크론을 경쟁사로 지목할 정도로 자신감을 표출하고 있죠.
그러나 엔지니어링실에서 들려오는 진실은 사뭇 다릅니다. 이들이 서버용 DDR5와 모바일용 LPDDR5X를 양산 중이라고 하지만, 내부의 질적 격차는 생각보다 깊고 고통스럽습니다.
① 극단적인 멀티패터닝(Multi-Patterning)의 저주
D램 미세 공정의 핵심은 “얼마나 좁은 선폭을 촘촘하고 균일하게 그려내는가”입니다. 삼성전자, SK하이닉스, 마이크론 등 글로벌 메모리 3사는 10나노급 4세대(1a), 5세대(1b) 공정부터 EUV(극자외선) 노광 장비를 필수로 도입해 회로를 한 번에 정밀하게 그립니다.
반면, 미국의 제재 장벽에 막혀 ASML의 EUV 장비를 단 한 대도 들여오지 못한 CXMT는 기존의 DUV(심자외선) 액침(Immersion) 노광 장비를 활용해 회로를 여러 번 겹쳐 그리는 멀티패터닝(Double/Triple/Quadruple Patterning) 공정에 매달리고 있습니다.
이 방식은 치명적인 물리적 한계를 수반합니다.
공정 단계의 폭발적 증가: 회로를 3번, 4번 겹쳐 그릴수록 웨이퍼가 거쳐야 하는 노광, 식각(Etching), 증착(Deposition) 단계가 기하급수적으로 늘어납니다. 이는 곧 생산 라인의 리드 타임(Lead Time) 증가와 공정 장비의 극심한 마모를 의미합니다.
수율(Yield)의 불확실성: 공정 단계가 늘어날 때마다 미세한 먼지나 물리적 오정렬(Overlay) 오류가 발생할 확률이 제곱으로 상승합니다. 업계 분석에 따르면 CXMT의 최신 DDR5 공정 수율은 한국 선두 기업들의 수율 대비 극히 불안정한 수준으로 파악됩니다.
웨이퍼당 생산 비용(Cost) 폭등: 더 많은 장비를 오래 돌리고 수율마저 낮으니, 웨이퍼 한 장에서 건질 수 있는 양질의 칩 개수가 적습니다. 즉, CXMT의 DDR5는 “만들 수는 있으나, 팔수록 손해를 보거나 정부 보조금 없이는 단가를 맞출 수 없는” 구조적 한계에 봉착해 있습니다.
② AI 시대의 고부가가치 관문: HBM에서의 무력감
인공지능(AI) 혁명의 심장인 고대역폭 메모리(HBM) 시장에서 CXMT의 위상은 더욱 초라합니다. HBM은 고난도의 TSV(관통전극) 패키징 기술과 미세화된 D램 다이(Die)가 유기적으로 결합되어야 합니다.
한국 기업들이 이미 12단, 16단 기반의 HBM3E를 넘어 차세대 HBM4 규격과 패키징 혁신(MR-MUF, 어드밴스드 큐브 등)을 양산 및 표준화하고 있는 반면, CXMT는 이제 겨우 구세대 규격인 HBM2E 개발 단계를 만지작거리는 수준입니다. 기술적 시차는 최소 3년에서 4년 이상 벌어져 있으며, 이 격차는 선단 노광 장비 제재가 유지되는 한 좁혀지기 어렵습니다.
2. YMTC (양쯔메모리): 낸드플래시 시장에서 가장 매서운 추격자
우리가 정말 경계해야 할 대상은 어쩌면 D램보다 낸드(NAND) 분야의 YMTC일지도 모릅니다. 낸드는 D램에 비해 회로를 수평으로 미세화하는 압박이 덜하고, 위로 쌓아 올리는 적층(Stacking) 기술이 핵심이기 때문에 장비 제재의 영향력을 상대적으로 덜 받습니다.
① 294단의 경고와 Xtacking 4.0의 실체
YMTC는 컴퓨텍스 2026에서 294단 3D 낸드 제품을 공개하며 업계를 긴장시켰습니다. 당시 SK하이닉스가 321단 제품을 가시화하고 삼성전자가 9세대 V낸드(286단)를 양산 중인 시점에서, 삼성과의 단순 적층 단수 격차를 한 자릿수로 좁힌 것입니다.
이러한 고속 성장의 배경에는 YMTC 독자의 Xtacking(엑스타킹) 기술이 있습니다.
Xtacking 구조의 메커니즘: 주변부 회로(Peripheral)와 셀(Cell) 어레이를 서로 다른 웨이퍼에서 각각 생산한 뒤, 두 웨이퍼를 구리(Cu) 패드로 정밀하게 접합(Bonding)하는 방식입니다.
장점: 셀 위에 회로를 올리거나 아래에 구겨 넣을 필요가 없어 셀 밀도를 극대화할 수 있고, 개발 기간을 대폭 단축할 수 있습니다.
단점: 두 장의 웨이퍼를 완벽하게 정렬하여 붙여야 하므로 초기 장비 투자 비용이 크고, 접합부의 열팽창 계수 차이 등으로 인한 물리적 신뢰성 이슈가 잔존합니다.
② 엔터프라이즈(Enterprise) 서버용 시장의 높은 장벽
단수를 높여 소비자용(B2C) 저가형 SSD 시장이나 중국 내수 공급망을 장악하는 데는 성공했으나, 부가가치가 가장 높은 서버 및 엔터프라이즈용 고신뢰성 SSD 시장의 문턱은 여전히 높습니다.
데이터센터향 제품은 24시간 가동 시의 고온 신뢰성, 쓰기/지우기 수명(P/E Cycle), 전력 소모 성능(W/GB) 등에서 타협 없는 스펙을 요구합니다. YMTC의 제품은 극한 상황에서의 데이터 보존(Retention) 능력이 완벽히 검증되지 않았으며, 글로벌 빅테크 기업들의 보수적인 검증 체계를 통과하기에는 트랙 레코드(Track Record)가 부족합니다. 하지만 중저가 시장에서의 점유율 잠식 속도는 무시할 수 없는 수준입니다.
3. SMIC (중신궈지): ‘DUV 영혼 가출 공정’의 파운드리와 레거시의 지배자
“중국에 제대로 된 파운드리(위탁생산) 생태계가 있는가?”라는 질문에 대한 대답은 명확히 “예”입니다. SMIC는 글로벌 순수 파운드리 시장에서 점유율 5~6%대를 견고히 다지며 대만의 TSMC와 한국의 삼성전자에 이어 글로벌 3위 자리를 굳히고 있습니다.
① SMIC의 7나노 구현: 기술적 한계와 보조금의 그림자
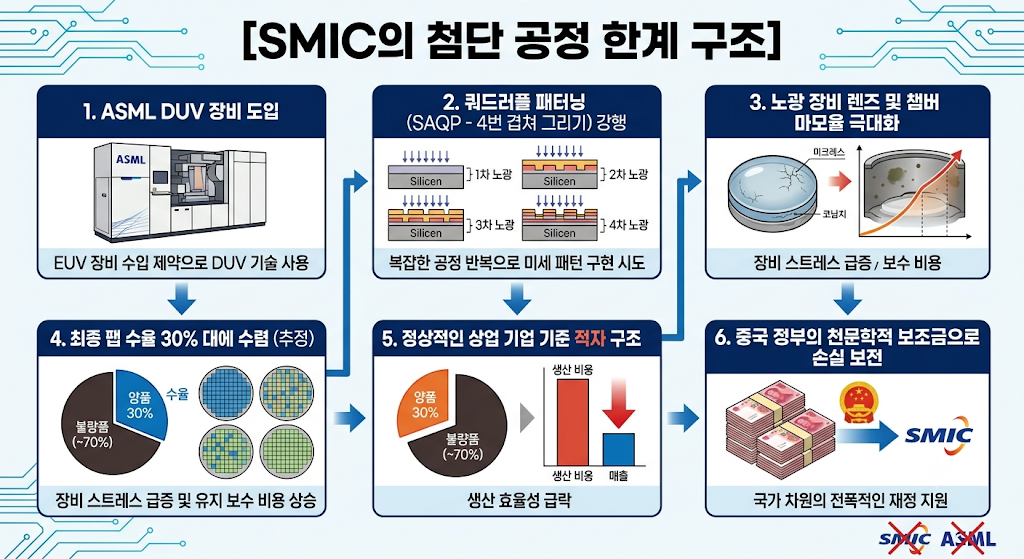
SMIC가 화웨이의 최신 스마트폰에 탑재되는 7나노(nm) 프로세서(기린 칩셋)를 공급했다는 소식은 전 세계를 놀라게 했습니다. EUV 없이 7나노를 뽑아낸 것은 엔지니어링 관점에서 경이로운 일이지만, 그 이면은 지독하게 비효율적입니다.
이 공정은 상업적 관점에서는 완전히 낙제점입니다. 수율이 30~40% 수준에 머무른다면 웨이퍼 한 장을 가공할 때 버려지는 칩이 더 많다는 뜻이며, 일반적인 자유시장 경제 체제였다면 진작에 파산했을 모델입니다. 오직 ‘반도체 자급률 80%’라는 국가적 목표 아래 집행되는 무제한에 가까운 정부 보조금이 생명 유지 장치 역할을 하고 있을 뿐입니다. TSMC와 삼성전자가 3나노, 2나노 GAA(Gate-All-Around) 공정으로 진입하는 시점에서 질적인 격차는 사실상 좁혀지기 힘든 물리적 평행선입니다.
② 진짜 위협: 레거시(성숙) 공정의 대량 잠식
오히려 시장에서 더욱 파괴력을 갖는 것은 SMIC와 화홍반도체(Hua Hong)가 주도하는 28나노 이상 성숙(Legacy) 공정의 물량 공세입니다.
최첨단 스마트폰 AP나 AI GPU를 제외한 전력관리반도체(PMIC), 차량용 MCU, 이미지센서(CIS), 구동칩(DDI) 등은 굳이 미세 공정이 필요하지 않습니다. 중국은 자국 내에 수많은 성숙 공정 팹을 증설하며 압도적인 원가 경쟁력을 무기로 글로벌 레거시 칩 시장을 빠르게 잠식하고 있습니다. 업계에서는 2028년 중국이 글로벌 성숙 공정 생산능력의 42%를 차지할 것으로 보고 있습니다. 이는 범용 아날로그 반도체를 생산하는 국내외 중소형 파운드리와 팹리스 기업들의 숨통을 조이는 직접적인 위협 요인입니다.
4. 투자자를 위한 실전 포트폴리오 가이던스: 단기 vs 중장기 액션 플랜
중국 반도체 3사의 명과 암을 확인했으니, 이제 이를 바탕으로 자산을 배분하고 방어망을 구축하는 구체적인 투자 전략을 수립해야 합니다.
① 단기 전략 (12~18개월): 범용 비중 축소와 ‘독점적 소부장’ 압축
CXMT가 상장으로 수십 조 원의 자금을 손에 쥐게 되면서 가장 먼저 단행할 조치는 범용 D램 라인(DDR5, LPDDR5X)의 폭발적인 증설입니다.
범용 메모리 노출 최소화: PC 및 모바일용 범용 D램 및 일반 낸드 플래시의 가격은 단기적으로 중국의 물량 밀어내기 공세에 밀려 마진 압박을 크게 받을 수 있습니다. 범용 비중이 높은 후발 메모리 제조업체에 대한 단기 투자는 철저히 보수적으로 접근해야 합니다.
독점적 AI 메모리 공급망 집중: HBM3E 및 HBM4 시장의 지배력은 여전히 한국 대장주들과 그 수혜를 직접적으로 입는 소부장(소재·부품·장비) 벨트에 묶여 있습니다. 독점적 기술을 보유한 세정, 계측, 첨단 패키징 장비 및 핵심 소재 공급사로 포트폴리오를 압축하는 전략이 단기 시장 노이즈를 이기는 지름길입니다.
② 중장기 전략 (3~5년): ‘기술 장벽’ 프리미엄과 중국 국산화 헤지(Hedge)
시간이 흐를수록 EUV 장비 부재라는 구조적 천장은 중국 기업들의 발목을 강하게 잡을 것입니다.
선단 공정 리더의 가치 재평가: 3나노 이하 선단 파운드리 공정과 차세대 고부가가치 엔터프라이즈 메모리 솔루션을 안정적으로 생산할 수 있는 한국과 대만의 선두 기업들은 서버 시장의 폭발적인 성장에 힘입어 독점적 지위를 유지할 것입니다. 단기적인 중국 저가 공세 노이즈로 주가가 과도하게 조정될 때는 이를 중장기 매수 기회로 포착해야 합니다.
중국 장비 국산화 수혜주의 스마트한 활용: 만약 글로벌 자산 배분이 가능한 투자자라면, 미국의 제재 속에서 중국 정부가 강제로 키울 수밖에 없는 ‘중국 현지 탑티어 국산 반도체 장비/소재 기업’들을 포트폴리오의 일부로 편입하여 지정학적 리스크를 역으로 헤징하는 전략도 매우 유연한 대안이 될 수 있습니다.
5. 결론: 기술적 본질에 답이 있다
결국 반도체 산업은 물리 법칙의 한계를 극복하는 고도의 과학 기술이자, 극도의 효율성을 추구하는 정밀 제조 공학입니다. 아무리 돈이 많아도 미세 공정의 열쇠인 EUV 노광 장비라는 도구가 없다면 일정 수준 이상의 장벽을 넘는 것은 불가능합니다.
시장의 막연한 공포심이 만들어낸 주가 조정은 준비된 투자자에게 언제나 축복이었습니다. 중국의 물량 공세라는 단기 파고를 넘어서는 초격차 영역의 진짜 수혜주를 선별해내는 혜안이 그 어느 때보다 필요한 시점입니다.
[세줄 요약 Action Plan]
단기 리스크 관리: CXMT 상장 실탄으로 범용 D램 공급 과잉 우려가 있으니 범용 비중이 높은 기업은 비중 축소.
초격차 집중: 중국이 진입할 수 없는 영역인 HBM 핵심 밸류체인 및 패키징 선도 기업으로 포트폴리오 압축.
위기를 기회로: 지정학적 노이즈로 인한 선단 공정 대장주의 주가 하락 시, 중장기 관점에서 비중 확대로 대응.
삼성 파운드리와 TSMC 이들의 글로벌 반도체 전선은 그 어느 때보다 뜨겁습니다. 인공지능(AI)이라는 거대한 패러다임 쉬프트 속에서, 미세 공정의 한계를 극복하려는 파운드리 기업들의 총성 없는 전쟁이 벌어지고 있기 때문입니다. 특히 시장의 이목은 삼성전자 파운드리 사업부의 2nm(나노미터) 공정과 그 성공 여부에 쏠려 있습니다.
“삼성 파운드리는 끝났다”, “TSMC와의 격차가 너무 벌어져 회생 불가능하다”는 비관론이 시장을 지배할 때가 있습니다. 하지만 기술의 본질과 에코시스템의 역학 관계를 뜯어보면, 지금이야말로 삼성전자의 진짜 가치와 다가올 반전의 시그널을 읽어내야 하는 결정적 타이밍입니다.
오늘은 삼성 파운드리의 현재 기술적 위치, TSMC·SMIC·인텔 등과의 냉혹한 경쟁 구도, 그리고 삼성이 쥔 반격의 카드인 ‘턴키(Turnkey) 솔루션’의 실체를 파헤쳐 보겠습니다. 나아가 이를 바탕으로 투자자들이 포트폴리오 관점에서 취해야 할 단기·중기·장기적 행동 지침까지 아주 명쾌하게 정리해 드립니다.
1. 핵심 분석 요약: 생존과 반전의 갈림길에 선 삼성 파운드리
구분
핵심 내용
현재의 위기
2nm 초기 수율 격차(삼성 55% vs TSMC 80~90%) 및 글로벌 점유율 양극화
기술적 기회
3nm부터 선제 도입한 GAA(Gate-All-Around) 공정 노하우의 축적 및 성숙
차별화 무기
메모리(HBM4) + 로직 파운드리 + 첨단 패키징을 원스톱으로 제공하는 ‘턴키(Turnkey)’ 전략
투자 모멘텀
2026년 3분기 파운드리 사업부 흑자 전환 전망 및 미국 테일러 팹의 가동 본격화
2. 현재 기술적 위치: 삼성이 먼저 깐 ‘GAA’와 ‘수율’의 진짜 함수 관계
많은 언론과 시장 분석가들이 “삼성의 2나노 수율은 55% 수준이라 TSMC에 게임이 안 된다”고 말합니다. 틀린 말은 아닙니다. 하지만 엔지니어링 관점에서 이 숫자를 평면적으로만 해석하면 시장의 숨은 기회를 놓치게 됩니다.
GAA(Gate-All-Around) 선제 도입의 스노우볼 효과
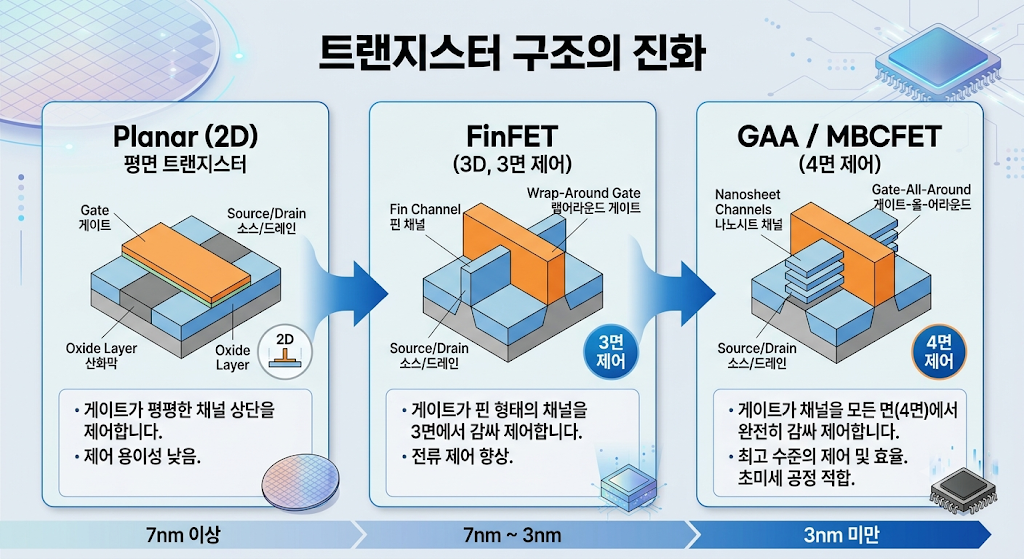
반도체 미세 공정이 3nm 이하로 내려가면서 기존의 FinFET(물고기 등지느러미 모양의 3면 제어 구조)은 물리적 한계에 봉착했습니다. 누설 전류를 제어하기가 불가능해진 것이죠. 이에 대안으로 등장한 것이 게이트가 채널의 4면을 모두 감싸 전류 흐름을 미세하게 조정하는 GAA(Gate-All-Around) 구조입니다.
여기서 삼성과 TSMC의 전략적 로드맵이 갈렸습니다.
삼성전자: 리스크를 감수하고 3nm(SF3E, SF3) 공정부터 GAA(삼성 독자 기술명인 MBCFET) 구조를 선제적으로 도입했습니다.
TSMC: 안전제일주의를 택하며 3nm까지는 기존 FinFET 구조를 극한으로 우려먹었고, 2nm(N2)에 이르러서야 처음으로 GAA 구조를 도입합니다.
삼성은 3나노 양산 과정에서 나노시트(Nanosheet)를 균일하게 깎아내는 에칭(Etching) 기술과 게이트 누설 전류를 제어하는 DFM(설계 기반 제조) 데이터를 엄청나게 쌓았습니다. 비록 초기 수율 저하로 뼈아픈 고통을 겪었지만, 이 과정에서 축적된 엔지니어링 노하우는 2nm(SF2) 공정으로 전환할 때 막강한 ‘선점자 우위(First Mover Advantage)’로 작용하게 됩니다. TSMC가 이제 막 마주해야 할 ‘GAA 공정 전환의 성장통’을 삼성은 이미 매를 먼저 맞으며 극복해 낸 셈입니다.
‘수율 55%’라는 숫자의 착시와 칩 면적(Die Size)의 법칙
우리가 뉴스에서 접하는 “삼성의 2nm 수율이 50~60%대에 머물러 있다”는 보도는 반은 맞고 반은 틀립니다. 반도체 수율은 아래의 수학적 비례 관계를 따릅니다.
수율 =1/칩의 면적 (Die Size)
구조가 복잡하고 크기가 거대한 고성능 CPU나 AI GPU(대형 로직 칩)의 경우 결함 밀도(Defect Density) 제어가 극도로 어려워 수율이 낮게 나옵니다.
하지만 암호화폐 채굴용 칩(ASIC)이나 모바일용 소형 칩처럼 구조가 비교적 단순하고 다이 사이즈가 작은 영역에서는 이미 삼성의 2나노 수율이 60~70% 이상 안정 궤도에 진입했다는 것이 현장의 목소리입니다. 공정 자체의 원천적인 결함이라기보다는 대면적 칩을 찍어낼 때의 결함 제어 능력을 다듬는 단계로 이해하는 것이 타당합니다.
3. 글로벌 파운드리 경쟁 구도: 냉혹한 숫자가 말하는 현실
현재 글로벌 파운드리 시장은 TSMC의 독주 체제 속에서 삼성이 추격을 고심하고, 그 뒤를 중국의 SMIC와 미국의 인텔이 무서운 기세로 쫓아오는 양상입니다.
[2025년 글로벌 파운드리 시장 점유율 (총 $169.5B 규모)]
──────────────────────────────────────────────────
TSMC: 69.9%

 삼성: 7.2%   SMIC: 5.3%    기타: 17.6%
──────────────────────────────────────────────────
TSMC의 독주와 철옹성 같은 생태계
TSMC는 3nm와 2nm 선단 공정은 물론, 고성능 AI 반도체의 필수 관문인 CoWoS(Chip-on-Wafer-on-Substrate) 첨단 패키징 라인업을 장악하며 시장 점유율을 69.9%까지 끌어올렸습니다. 애플, 엔비디아, AMD 등 빅테크 기업들이 TSMC를 고집하는 이유는 단순히 웨이퍼를 잘 깎아서가 아닙니다. “고객과 경쟁하지 않는다”는 순수 파운드리(Pure Play) 철학이 주는 강력한 보안 신뢰와 완벽에 가까운 IP(설계 자산) 생태계 덕분입니다.
복병 인텔(Intel)과 교란종 SMIC의 위협
인텔 (18A / 14A): 인텔은 1.8nm급인 ’18A’ 공정에서 GAA(RibbonFET)와 후면 전력 공급 기술(PowerVia)을 동시에 도입하는 무리수를 던졌습니다. 초기 우려와 달리 최근 기술적 안정성을 갖춰가며 미국 정부의 보조금(CHIPS Act) 지원에 힘입어 미국계 빅테크들의 공급망 다변화 대안으로 급부상하고 있습니다. 삼성에게는 TSMC만큼이나 뼈아픈 경쟁자입니다.
SMIC (중국): 미·중 갈등으로 EUV(극자외선) 노광 장비 수입이 막힌 SMIC는 심자외선(DUV) 장비를 활용한 다중 노광(Multi-Patterning)이라는 극한의 비효율적 방식으로 7~5nm급 칩을 뽑아내고 있습니다. 수율과 단가 측면에서는 최악이지만, 중국 정부의 전폭적인 보조금과 거대한 내수 시장을 무기로 삼성의 중저가(Legacy) 공정 매출을 무섭게 잠식하고 있습니다. 2025년 4분기 기준 점유율을 5.3%까지 끌어올리며 삼성의 2위 자리를 턱밑까지 추격했습니다.
2nm급 핵심 미세 공정 경쟁사 비교
파운드리 기업
핵심 트랜지스터 구조
후면 전력 공급 기술 (BSPDN)
특징 및 엔지니어 관점 요약
TSMC (N2 / A16)
2nm부터 GAA(Nanosheet) 적용
A16 공정(2026~2027)부터 적용 예정
돌다리도 두들겨 보고 건너는 안정 지향형. 압도적인 수율(80~90%)과 방대한 IP 생태계가 무기.
삼성전자 (SF2 / SF2Z)
3nm부터 GAA(MBCFET) 숙련 완료
SF2Z(2027 예정)부터 적용
기술적 모험가. GAA 숙련도는 앞서 있으나 대형 고객사용 대면적 수율 안정화가 최대 과제.
인텔 (18A / 14A)
RibbonFET (GAA 구조)
PowerVia (18A부터 선제 적용)
미국 안보 자산(CHIPS Act)의 수혜자. 기술 복잡도가 높아 수율 안정화 속도가 변수.
SMIC (중국)
FinFET 구조 고수 (DUV 멀티패터닝)
없음
기술 한계로 2nm 진입 불가. 단, 중국 내수용 저가 물량 밀어내기로 하부 라인업 교란.
4. 삼성의 반격 카드: ‘턴키(Turnkey) 솔루션’의 냉혹한 역학 관계
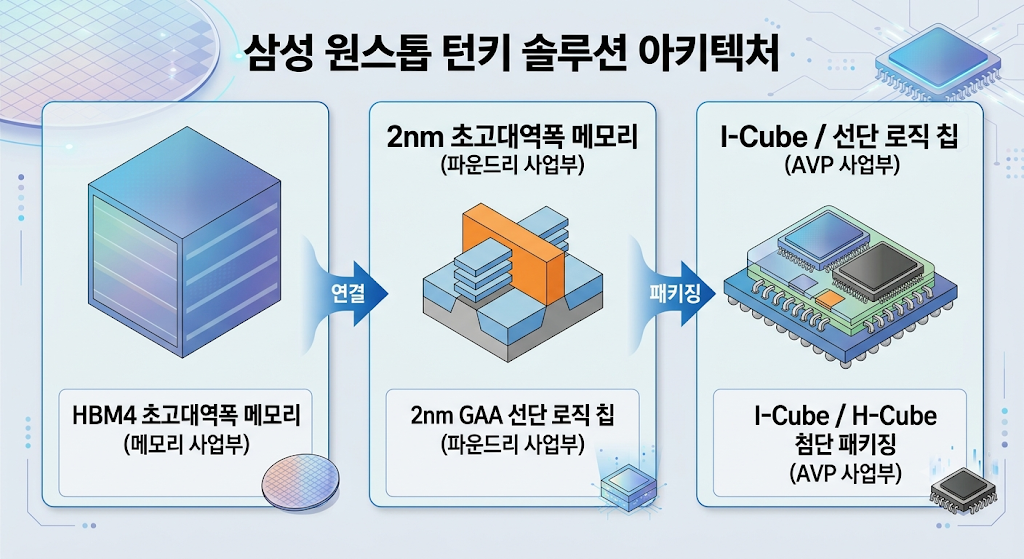
삼성이 TSMC의 독점에 맞서 내세우는 가장 날카로운 무기는 바로 “우리는 메모리부터 파운드리, 패키징까지 한 집에서 다 만든다”는 턴키(Turnkey) 솔루션입니다.
AI 칩 시대의 게임의 룰은 완전히 바뀌었습니다. 단순히 로직 반도체만 미세하게 깎는다고 끝나는 것이 아닙니다. GPU 바로 옆에 초고속 메모리인 HBM(High Bandwidth Memory)을 얼마나 정밀하게 배치하고 연결하느냐, 즉 첨단 패키징(Advanced Packaging) 기술이 성능의 절반을 결정합니다.
TSMC의 한계: TSMC는 메모리를 직접 만들지 않습니다. 따라서 엔비디아가 TSMC에서 칩을 만들려면 SK하이닉스나 마이크론의 HBM을 가져와 TSMC의 CoWoS 공정에서 조립해야 합니다. 이 과정에서 공급망 조율이 매우 복잡하고 병목 현상이 자주 발생합니다.
삼성의 기회: AMD, Groq, 테슬라처럼 엔비디아의 독주를 깨고 싶어 하는 ‘2등 그룹’ 혹은 자체 AI 칩을 내재화하려는 빅테크 기업들 입장에서 삼성의 턴키 솔루션은 매력적입니다. 삼성 한 곳과만 계약하면 HBM4 수급부터 2nm 로직 칩 생산, 첨단 패키징(I-Cube)까지 원스톱으로 해결되기 때문입니다. 비용을 대폭 아끼고 출시 기간(Time-to-Market)을 획기적으로 줄일 수 있습니다. 테슬라가 차세대 자율주행 칩인 ‘AI5’의 생산 파트너로 삼성의 미국 테일러 팹을 유력하게 검토하는 배경에는 바로 이러한 지정학적 이점과 턴키 전략의 시너지가 맞물려 있습니다.
5. 포트폴리오 전략: 투자자를 위한 단기·중기·장기 행동 지침
시장의 소음(Noise)에 흔들리지 않고 돈이 되는 의사결정을 내리기 위해, 삼성전자의 파운드리 모멘텀을 주가와 연계하여 시기별로 정밀 분석해 드립니다.
① 단기 관점 (2026년 하반기 ~ 2027년 상반기)
“바닥은 확인했다, 실적 턴어라운드 초입 단계”
투자 모멘텀: 시장의 비관론과 달리 삼성 파운드리 라인의 가동률은 이미 80% 선을 돌파하며 완연한 회복세에 접어들었습니다. 업계에서는 파운드리 사업부의 흑자 전환 시점이 기존 전망(2026년 말)보다 앞당겨진 2026년 3분기 전후가 될 것이란 분석을 내놓고 있습니다.
수율 착시의 극복: “2나노 대형 칩 수율이 낮다”는 우려 때문에 주가가 과도하게 눌려 있을 때가 역발상 매수의 기회입니다. 모바일 및 중소형 ASIC 영역에서 쌓이는 현금 흐름과 테슬라, AMD 등으로부터 흘러나오는 초기 2나노 수주 낭보가 단기 주가의 강력한 촉매제 역할을 할 것입니다.
행동 지침 (Action Plan):분할 매수(Accumulate) 진입. 적자 폭이 줄어들고 가동률이 상승하는 실적 턴어라운드 지표를 확인하며 낙폭 과대 시점마다 지분을 모아가는 전략이 유효합니다.
② 중기 관점 (2027년 ~ 2028년)
“TSMC의 GAA 성장통과 미국 테일러 팹의 시너지”
TSMC의 시행착오 가능성: TSMC가 2nm(N2) 공정에서 생전 처음으로 GAA 구조를 도입하는 시기입니다. 공정 아키텍처가 완전히 바뀔 때는 글로벌 1위 기업이라도 수율 안정화 단계에서 예상치 못한 병목과 납기 지연을 겪을 확률이 높습니다.
낙수 효과의 극대화: TSMC의 생산 캐파(Capa)는 이미 애플과 엔비디아의 예약 물량만으로도 포화 상태입니다. TSMC의 공급 부족에 지친 빅테크(AMD, 엔트로픽 등)의 대체 수요를 삼성이 턴키 솔루션으로 흡수해야 합니다. 2026년 말 시운전을 거쳐 2027년 본격 양산에 들어가는 미국 테일러 팹(Taylor Fab)이 그 전초기지가 될 것입니다.
주의할 리스크: 이 시기 가장 큰 복병은 인텔입니다. 미 정부의 전폭적 지지를 받는 인텔 18A 공정이 안정화되어 미국 빅테크의 물량을 빼앗아 간다면 삼성의 중기 주가 상단이 제한될 수 있습니다.
행동 지침 (Action Plan):포트폴리오 비중 유지 및 추적 관찰(Hold & Watch). 테일러 팹에서 양산되는 고객사 칩의 ‘대면적 수율이 70% 선을 돌파하는가’를 분기별로 추적하며 보유 비중을 유동적으로 조율해야 합니다.
③ 장기 관점 (2029년 이후)
“종합 반도체 기업(IDM)의 근본적 한계 극복 여부”
“고객은 경쟁자와 비밀을 공유하지 않는다”: 삼성이 아무리 기술적으로 훌륭해도 스마트폰(MX사업부)과 자체 AP(엑시노스)를 만드는 종합 반도체 기업(IDM)이라는 태생적 한계는 존재합니다. 애플이나 구글 같은 빅테크들이 자신들의 핵심 설계 자산(IP)을 삼성 파운드리에 온전히 맡기기에는 심리적·구조적 거부감이 따릅니다.
구조적 변화의 필요성: 삼성이 장기적으로 TSMC와 대등한 위치에 서려면, 파운드리 사업부의 완벽한 물리적 방화벽(Firewall) 구축을 넘어 장기적인 인적 분할(Spin-off)이나 독립 법인화 같은 지배구조 개편 카드가 나와야 합니다.
행동 지침 (Action Plan):보수적 장기 투자(Long-term Core). 삼성전자를 순수 파운드리 관점으로만 접근하여 장기 장기 투자하기에는 리스크가 큽니다. 파운드리에 들어가는 천문학적인 설비투자(CAPEX)를 뒷받침해 주는 메모리 사업부의 현금 창출력(HBM 시장 지배력)을 동시에 고려하면서, 전체 포트폴리오의 안전판 역할로만 가져가는 것이 현명합니다.
6. 결론: 숫자가 증명할 일만 남았다
기술적 판은 삼성이 먼저 깔았고 (3nm GAA 선제 적용)
시장의 판은 TSMC의 공급 부족이 깔아주고 있습니다.

이제 남은 것은 테일러 팹에서
'대형 칩 수율 70%'라는 성적표를 증명하는 것뿐입니다.
삼성 파운드리는 현재 생존을 넘어선 위대한 반전의 서막 앞에 서 있습니다. 3나노 GAA 공정에서 겪은 수많은 시행착오는 결코 헛된 삽질이 아니었습니다. 다가오는 TSMC의 GAA 전환기와 미세 공정 공급 부족 사태는 삼성에게 엄청난 낙수 효과의 기회를 선사할 것입니다.
언론의 극단적인 수율 비관론에 흔들려 매도 버튼을 누르기 전에, 가동률 회복 추이와 턴키 솔루션이 만들어낼 빅테크 기업들과의 동맹 관계를 차분히 주목해 보십시오. 시장에 실질적인 숫자가 찍히기 시작하는 순간, 주가는 영리하게 이를 선반영하여 위를 향해 달려갈 것입니다.
글로벌 반도체 시장이 또 한 번 거대한 패러다임 시프트(Paradigm Shift)를 맞이하고 있습니다. 우리는 지난 몇 년간 인공지능(AI) 열풍 속에서 고대역폭 메모리, 즉 HBM(High Bandwidth Memory)이 가져온 전례 없는 초호황기를 목도했습니다. 엔비디아의 GPU 옆에 단단히 자리 잡은 HBM은 학습용 AI 시장의 절대적인 왕좌였습니다.
그러나 영원한 왕좌는 없습니다. 현재 AI 시장의 무게중심은 막대한 데이터를 집어넣고 학습시키는 ‘학습(Training)’ 단계에서, 전 세계 수억 명의 사용자가 시도 때도 없이 던지는 질문에 실시간으로 답을 내놓는 ‘추론(Inference)’ 단계로 급격히 이동하고 있습니다.
여기서 치명적인 병목 현상이 발생합니다. 바로 ‘전력 소모와 발열’입니다. HBM은 엄청나게 빠르지만 그만큼 막대한 전기를 잡아먹는 ‘헤비 드링커(Heavy Drinker)’입니다. 전 세계 데이터센터가 전기 고갈과 발열 문제로 비명을 지르기 시작하면서, 글로벌 테크 giants들과 반도체 제조사들은 차세대 첨단 저전력 메모리 개발에 사활을 걸었습니다.
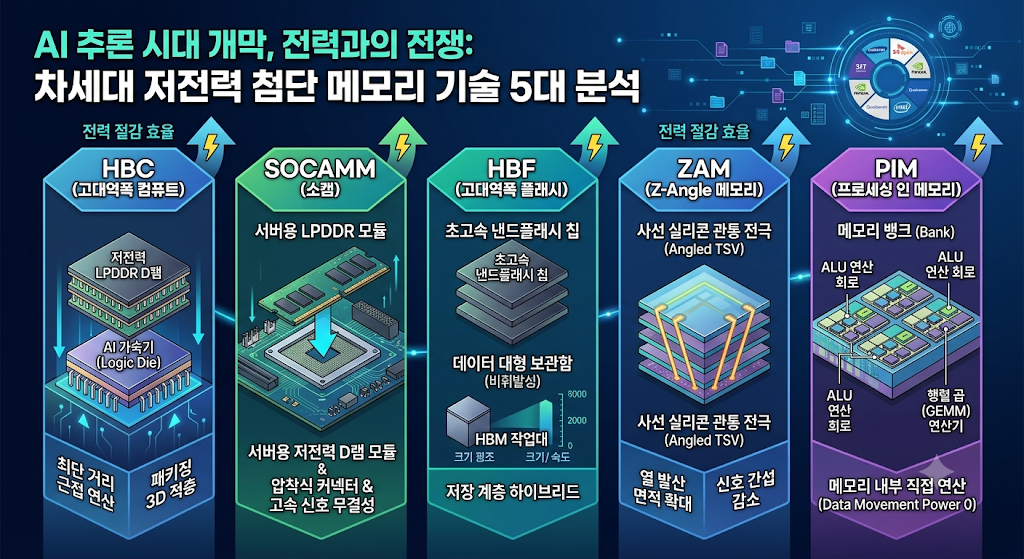
오늘은 포스트 HBM 시대를 지배하기 위해 등장한 5가지 핵심 차세대 메모리 기술(HBC, SOCAMM, HBF, ZAM, PIM)을 엔지니어링 관점에서 낱낱이 해부하고, 어떤 기업이 제2의 HBM 신화를 재현하며 투자자들에게 도움이 될 포괄적인 투자 가이던스를 전해드립니다.
1. 배경: AI 패러다임의 변화와 폰 노이만 병목 현상
컴퓨터 아키텍처 역사를 돌이켜보면 PC 시대에는 ‘CPU 속도’가, 모바일 시대에는 ‘저전력 D램’이 시장을 지배했습니다. AI 초기 시장 역시 엄청난 매개변수(Parameter)를 가진 거대언어모델(LLM)을 한시라도 빨리 학습시켜야 했기에, 가격과 전력은 후순위였고 오직 대역폭(Bandwidth)만을 극대화한 HBM이 시장을 독식했습니다.
하지만 ‘추론’의 시대는 게임의 법칙이 완전히 다릅니다.
학습(Training): 대형 데이터 플러그를 꽂아두고 한 번에 몰아서 무거운 연산을 수행합니다.
추론(Inference): 수억 명의 전 세계 유저가 24시간 내내 모바일과 PC로 AI 서비스를 호출합니다. 데이터의 이동이 극도로 잦고 반복적입니다.
문제는 데이터가 메모리 저장소와 연산 장치(CPU/GPU) 사이를 오가는 과정에서 발생하는 전력 소모(Data Movement Power)가 전체 시스템 전력의 60~80%를 차지한다는 점입니다. 프로세서의 계산 속도는 광속으로 발전했지만, 메모리에서 데이터를 주고받는 버스(Bus)의 대역폭과 전력 효율이 이를 따라가지 못하는 ‘폰 노이만 병목 현상(Von Neumann Bottleneck)’이 한계에 다다른 것입니다.
결국 미래 AI 반도체 경쟁의 핵심 철학은 명확합니다. “누가 더 빠른가”가 아니라, “누가 데이터 이동을 최소화하여 전력을 아끼는가”의 싸움입니다. 이제 그 대안으로 떠오른 5가지 독자적인 생태계를 하나씩 뜯어보겠습니다.
2. 포스트 HBM을 노리는 5대 차세대 기술 심층 분석
① HBC (High Bandwidth Compute) : 퀄컴의 근접 연산과 3D 적층
기존 HBM 구조는 GPU ‘옆’에 인터포저(Interposer)라는 중간 기판을 두고 수평으로 데이터 통로를 연결합니다. 눈에 보이지 않을 만큼 미세하지만 물리적인 선로의 길이가 존재하며, 여기서 신호 손실과 전력 소모가 발생합니다.
모바일 AP 설계의 최강자인 미국 퀄컴이 제시한 HBC(고대역폭 컴퓨트)는 이 구조를 완전히 뒤집습니다.
엔지니어링 핵심: 근접 연산(Near-Memory Computing) 및 3D 로직-메모리 적층
구조적 특징: AI 연산을 담당하는 가속기(Logic Die) 바로 위에 저전력 D램(LPDDR)을 수직으로 다이렉트 적층(3D Stacking)합니다. 데이터가 이동하는 거리가 마이크로미터(㎛) 단위로 좁혀집니다.
성능 강점: 모든 데이터를 가속기 중심부로 보내지 않고, 메모리와 맞닿은 최단 거리에서 먼저 일부 계산을 처리한 뒤 꼭 필요한 결과만 상부로 전달합니다. 퀄컴은 이 방식을 통해 HBM 대비 와트당 대역폭(전력 효율성)을 무려 6배나 끌어올릴 수 있다고 발표했습니다. 모바일에서 갈고닦은 저전력 DNA를 서버 시장에 이식하겠다는 야심찬 구상입니다.
② SOCAMM (Small Outline Compression Attached Memory Module) : 엔비디아의 모듈 표준 파괴
스마트폰에 탑재되는 LPDDR(저전력 D램)은 전력 효율면에서 최상의 퍼포먼스를 보여줍니다. 하지만 치명적인 약점이 있었습니다. 메인보드에 직접 납땜(On-board)해야만 고속 신호의 무결성(Signal Integrity)이 유지된다는 점입니다. 이 때문에 서버 환경처럼 필요에 따라 슬롯에 꼈다 뺐다 하며 용량을 확장해야 하는 데이터센터에는 사용이 불가능했습니다.
이 한계를 깨부순 것이 바로 엔비디아가 주도하는 SOCAMM(소캠) 규격입니다.
엔지니어링 핵심: 소켓 압착 방식을 통한 LPDDR의 서버화
구조적 특징: 보드에 납땜하는 대신, 기판에 매우 얇은 소켓 형태로 메모리 모듈을 ‘압착’하여 연결합니다. 커넥터의 물리적 길이를 극한으로 줄여 LPDDR의 초저전력 특성을 고스란히 유지하면서도, 서버가 요구하는 고용량 확장성과 교체 편의성을 확보했습니다.
실제 적용: 엔비디아의 차세대 로드맵을 보면 매우 흥미로운 전략이 보입니다. 최고 속도가 필요한 GPU(루빈 등)에는 최첨단 HBM4를 탑재하지만, 대용량 데이터 제어와 효율성이 중요한 CPU(베라)에는 SOCAMM2를 채택했습니다. 비용과 전력을 모두 잡겠다는 계산입니다. 현재 국내 메모리 거두인 삼성전자와 SK하이닉스가 이 SOCAMM2 모듈을 개발하여 엔비디아 공급망에 진입해 있습니다.
③ HBF (High Bandwidth Flash) : 낸드플래시 기반 대형 보관함의 등장
컴퓨터 구조론에서 ‘레지스터-캐시-D램-저장장치(SSD)’로 이어지는 단단한 계층 구조(Memory Hierarchy)는 수십 년간 변하지 않는 진리였습니다. 하지만 LLM 추론 모델이 커지면서 수천억 개의 매개변수 데이터를 전부 비싼 D램(HBM)에 상주시키는 것은 가성비 측면에서 재앙에 가깝습니다. 여기서 등장한 파괴적 혁신이 HBF(고대역폭 플래시)입니다.
엔지니어링 핵심: 비휘발성 초고속 낸드 적층 및 하이브리드 계층화
구조적 특징: 전원이 꺼져도 데이터가 지워지지 않고, D램보다 동일 면적당 저장 용량이 수 배 이상 크며 가격은 저렴한 ‘낸드플래시’를 HBM처럼 수직으로 쌓아 올린 형태입니다.
비유와 협업: HBM이 AI 프로세서 바로 옆에서 데이터를 실시간으로 빠르게 주고받는 ‘작업대’라면, HBF는 그 바로 뒤에 위치한 ‘초대형 고속 보관함’입니다. 실시간 연산에 필요한 핵심 가중치는 HBM에 올려두고, 자주 꺼내 쓰지만 매 순간 대기할 필요는 없는 거대한 데이터 베이스는 HBF에 저장해 둡니다. 가상 메모리 스왑 속도를 극대화한 이 기술은 미국 샌디스크(웨스턴디지털)가 표준화를 이끌고 있으며, SK하이닉스가 연합군으로 참여해 생태계를 키우고 있습니다.
④ ZAM (Z-Angle Memory) : 인텔의 물리적 공정 우회 전략
HBM의 가장 큰 기술적 장벽이자 아킬레스건은 D램 칩 수천 개에 미세한 구멍을 뚫어 수직으로 연결하는 TSV(실리콘 관통 전극) 공정입니다. 수직으로 곧게 뚫린 통로를 통해 엄청난 양의 전류가 흐르다 보니, 칩 내부의 열이 밖으로 빠져나가지 못하고 상층부에 고여 칩이 오작동하는 ‘열 축적(Thermal Throttling)’ 문제가 끊임없이 발생합니다.
인텔과 소프트뱅크의 자회사 사이메모리가 공동 개발 중인 ZAM(Z-앵글 메모리)은 물리적 접근법을 바꿨습니다.
엔지니어링 핵심: 사선 실리콘 관통 전극 (Angled TSV)
구조적 특징: 건물의 엘리베이터처럼 수직으로만 통로를 뚫는 것이 아니라, 에스컬레이터처럼 비스듬한 사선 각도(Z-Angle)로 데이터 통로를 배치합니다.
기대 효과: 신호가 오가는 경로의 면적이 넓어지면서 자연스럽게 칩 내부의 열 발산 면적이 확대됩니다. 또한, 신호선끼리 수직으로 마주 볼 때 발생하는 전기적 간섭(Crosstalk)을 줄여 전력 효율을 개선할 수 있습니다. 다만, 딱딱한 실리콘을 사선으로 정밀하게 식각(Etching)하는 공정 난이도가 극악에 가깝기 때문에 양산성 검증이 향후 상용화의 가늠쇠가 될 것입니다.
⑤ PIM (Processing In Memory) : 폰 노이만 구조의 완벽한 종말
앞서 언급한 네 가지 기술이 메모리와 프로세서 간의 ‘거리’를 좁히거나 ‘통로’를 개선하는 방식이라면, PIM(프로세싱 인 메모리)은 컴퓨터의 패러다임 자체를 부정하는 가장 궁극적이고 혁신적인 개념입니다.
엔지니어링 핵심: 메모리 뱅크(Bank) 내 독립 연산기(ALU) 내장
구조적 특징: 기존 메모리는 오직 ‘저장’만 하고 계산은 CPU나 GPU가 도맡았습니다. PIM은 데이터가 저장되는 메모리 셀 내부 영역에 아주 단순한 계산이 가능한 연산 장치들을 곳곳에 심어 놓았습니다.
비유와 장점: 물건이 들어올 때마다 멀리 있는 본사 직원이 와서 분류하는 게 아니라, 창고(메모리) 안에 상주하는 직원이 그 자리에서 직접 물건을 분류(연산)해 결과만 보고하는 시스템입니다. AI 연산의 대부분을 차지하는 단순 반복 행렬 계산(GEMM)을 메모리가 직접 수행하므로, 데이터를 외부 버스로 전송할 필요가 전혀 없습니다. 데이터 이동 에너지가 ‘제로(0)’에 수렴하기 때문에 전력 효율면에서는 이론상 완벽한 종착지입니다. 현재 삼성전자와 SK하이닉스가 LPDDR 기반의 PIM 제품을 고도화하며 상용화를 앞당기고 있습니다.
3. 차세대 메모리 기술 한눈에 비교하기
기술 규격
핵심 구조 및 아이디어
주도 기업 / 진영
전력 절감 메커니즘
성숙도 및 상용화 시점
HBC
가속기 로직 다이 위에 LPDDR을 3D 수직 적층
퀄컴
패키징 다이렉트 연결로 이동 거리 최소화
프로토타입 공개 단계
SOCAMM
LPDDR 모듈을 소켓 압착 방식으로 서버 기판에 연결
엔비디아, 삼성전자, SK하이닉스
저전력 모바일 D램의 서버 확장
상용화 돌입 (베라 CPU 탑재)
HBF
초고속 낸드플래시를 수직 적층하여 서버 근접 배치
샌디스크, SK하이닉스
대용량 데이터의 계층 최적화 (가성비)
규격 표준화 진행 중
ZAM
D램 관통 전극(TSV)을 사선(Diagonal)으로 배치
인텔, 사이메모리
사선 배치를 통한 열 발산 및 간섭 저감
연구 개발 및 공정 검증 단계
PIM
메모리 내부 뱅크에 단순 연산 장치(ALU) 내장
삼성전자, SK하이닉스
데이터 이동 자체를 삭제 (버스 전력 0)
실증 테스트 및 생태계 확장 중
4. 투자 가이던스 (Investment Guidance)
기술의 우수성을 아는 것과 돈이 되는 기업을 고르는 것은 별개의 영역입니다. 주식 시장에서는 ‘가장 완벽한 기술’보다 ‘당장 대량 양산되어 밸류체인의 숫자로 찍히는 기술’이 먼저 가치를 인정받습니다. 시장의 자금 흐름과 기술 성숙도를 고려해 단기(1~2년)와 중장기(3~5년) 투트랙(Two-Track) 전략을 제시합니다.
💡 단기 관점 (1~2년): 매출 가시성이 확보된 ‘SOCAMM’ 공급망에 집중
현재 엔비디아의 서버 아키텍처에 채택이 확정되어 당장 올해와 내년 실적 턴어라운드를 이끌 영역은 단연 SOCAMM입니다. 데이터센터 전력지난은 당장 발등에 떨어진 불이기 때문에, 검증된 LPDDR 모듈 채택 속도는 상상을 초월할 것입니다.
최선호주 (Top Picks):SK하이닉스 & 삼성전자
서버용 고성능 LPDDR5X 및 LPDDR6 시장의 글로벌 점유율을 사실상 독점하고 있는 구조입니다. SOCAMM 모듈 공급이 본격화되면 레거시 D램 대비 압도적인 마진율 개선이 이루어집니다.
장비 및 부품 수혜주:첨단 후공정(OSAT) 및 패키지 기판사
커넥터 길이를 줄이고 미세 압착 기법을 적용해야 하는 고난도 모듈 가공 기술 특성상, 플 flip-chip 계열의 고부가 패키지 기판을 공급할 수 있는 삼성전기, 대덕전자 같은 기판 대형주와 후공정 검사 및 레이저 장비 공급사의 가치 재평가(Re-rating)가 강하게 나올 것입니다.
💡 중장기 관점 (3~5년): 판도를 바꿀 게임 체인저 ‘HBF’와 ‘PIM’ 선점
AI 추론 시장이 완전히 성숙하여 전체 AI 서버 수요의 80%를 넘어가는 시점이 오면, 단순히 D램을 튜닝하는 수준을 넘어 아키텍처 전반을 바꾸는 기업이 수조 원의 가치를 흡수합니다.
낸드(NAND)의 화려한 부활과 HBF 주도권:SK하이닉스 (솔리다임)
그동안 HBM에 밀려 적자를 면치 못했던 낸드플래시 사업부가 HBF 시장의 개화로 강력한 현금 창출원(Cash Cow)으로 변모할 것입니다. 특히 자회사 솔리다임을 통해 기업용 고용량 QLC SSD 시장을 선점한 SK하이닉스는 HBF 표준화 연합의 중심축으로서 장기 우상향 모멘텀을 확보했습니다.
폰 노이만 구조의 붕괴와 지식재산권(IP)의 가치:디자인하우스 및 반도체 IP 기업
PIM 구조로 가기 위해서는 메모리 내부에 연산 회로를 정밀하게 설계해야 합니다. 이는 메모리 제조사 단독으로 불가능하며, 팹리스 및 디자인하우스와의 긴밀한 생태계 협력이 필수적입니다. 국내 시장에서는 메모리 인터페이스 IP 원천 기술을 가진 오픈엣지테크놀로지나 삼성전자 파운드리의 핵심 디자인하우스인 가온칩스 같은 다크호스들이 중장기 텐배거(10배 주식) 후보군이 될 수 있습니다.
5. 결론: “데이터를 옮기는 시대는 끝났다”
“HBM이 AI 확산의 제1막(학습)을 화려하게 지배했다면, 제2막(추론)은 전력을 지배하는 자가 승리합니다.”
과거의 반도체 치킨게임이 ‘누가 더 셀(Cell)을 미세하게 깎아 대량 생산하는가’였다면, 앞으로의 AI 시대는 ‘소프트웨어의 특성을 이해하고 시스템 구조와 패키징으로 전력을 얼마나 아끼는가’의 아키텍처 전쟁입니다.
단기적으로는 엔비디아 공급망 내에서 확실한 숫자를 찍어줄 SOCAMM 및 첨단 후공정 밸류체인으로 포트폴리오의 하방을 단단히 지지하십시오. 그리고 중장기적으로는 낸드 업황의 패러다임을 바꿀 HBF와 궁극의 반도체라 불리는 PIM 관련 핵심 기술주들을 적립식으로 모아가는 전략을 추천합니다. 판이 바뀔 때 과감히 베팅하는 투자자만이 다가올 거대한 자산 증식의 기회를 잡을 수 있습니다.
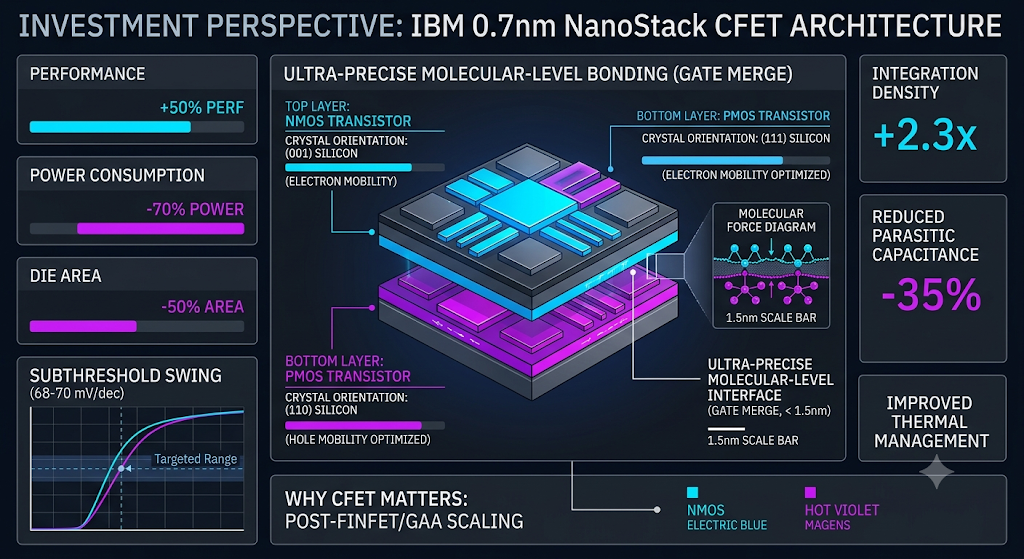
글로벌 반도체 업계와 자본 시장이 다시 한번 요동치고 있습니다. 2026년 6월 25일(현지시간), 뉴욕 올버니 나노테크 컴플렉스에 위치한 IBM 연구소는 세계 최초로 1나노미터(nm)의 벽을 깨뜨린 미세공정 로드맵, 즉 ‘0.7나노미터(7옹스트롬, Å)’ 노드의 혁신적인 트랜지스터 아키텍처를 전격 공개했습니다.
과거 2021년, 세계 최초로 2나노급 GAA(Gate-All-Around) 트랜지스터 실리콘 웨이퍼를 시연하며 TSMC, 삼성전자, 인텔의 미세공정 로드맵을 2년 이상 앞당겼던 IBM이 또다시 업계의 기술적 임계점을 한 단계 끌어올린 것입니다. 이 발표가 나온 직후 IBM의 주가는 장 전 거래에서 6% 이상 급등하며 시장의 뜨거운 관심을 증명했습니다.
기술의 공식 명칭은 ‘NanoStack(나노스택)’입니다. 이는 IBM이 2017년 최초로 제안했던 나노시트(Nanosheet) 기반 GAA 설계를 3차원 수직 공간으로 진화시킨 차세대 아키텍처입니다.
명칭의 본질과 타임라인의 냉정한 인식
우선 전문 투자자와 엔지니어 관점에서 한 가지 명확히 짚고 넘어가야 할 팩트가 있습니다. IBM 스스로도 인정했듯이, 이번 ‘0.7nm’라는 명칭은 트랜지스터의 물리적 게이트 길이(Gate Length)나 시트 폭이 0.7나노미터라는 뜻이 아닙니다. 반도체 산업에서 관행적으로 사용하는 ‘제조 기술 세대(Marketing Node Name)’를 지칭하는 지표일 뿐입니다.
또한, 이는 당장 공장에서 찍어낼 수 있는 양산 제품이 아니라, 연구실 단계에서 기술적 타당성을 검증한 ‘개념 증명(Proof-of-Concept, PoC)’ 단계의 발표입니다. 반도체 소자 물리학적 거동이 실제로 구현 가능하다는 것을 보여준 기념비적 사건이지만, 실제 라인에서 대량 생산(Mass Production) 체제에 진입하기까지는 최소 5년의 시간(2031년경 상용화 전망)이 소요될 것으로 보입니다.
그럼에도 불구하고 이 발표에 전 세계 반도체 진영이 주목하는 이유는 명확합니다. 무어의 법칙(Moore’s Law)이 물리적 변형과 양자 터널링 효과(Quantum Tunneling)로 인해 사망 선언을 눈앞에 둔 시점에서, 실리콘 기반 소자가 1나노 이하 영역에서도 시스템 성능을 지속적으로 스케일링(Scaling)할 수 있는 구체적인 돌파구를 제시했기 때문입니다.
본 포스팅에서는 IT 기술 전문성이 결합된 거시적 관점에서 IBM NanoStack 기술의 물리적 실체와 재료공학적 혁신을 해부하고, 이로 인해 파생될 글로벌 파운드리 생태계 및 국내외 소부장(소재·부품·장비) 밸류체인의 투자 기회를 30년 차 애널리스트의 시각으로 냉철하게 분석합니다.
2. 기술 분석: 평면에서 ‘NanoStack’까지, 트랜지스터 진화의 역사
반도체 집적도를 높이기 위한 트랜지스터의 진화 과정을 이해하는 것은 향후 전개될 3차원 적층 경쟁의 본질을 파악하는 핵심 열쇠입니다. 트랜지스터는 전류의 흐름을 제어하는 스위치 역할을 하며, 소스(Source)와 드레인(Drain) 사이의 채널(Channel)을 게이트(Gate)가 얼마나 효과적으로 통제하느냐가 성능과 누설 전류 차단의 성패를 가릅니다.
트랜지스터 구조 진화 흐름도
평면형 트랜지스터 (Planar FET): 20나노 이전 세대까지 사용되던 구조로, 실리콘 기판 표면에 2차원 평면 형태로 채널과 게이트가 맞닿아 있었습니다. 공정이 미세화될수록 게이트가 채널을 통제하는 힘이 약해져 전류가 꺼진 상태에서도 흘러버리는 ‘단채널 효과(Short Channel Effect)’의 한계에 봉착했습니다.
지느러미형 트랜지스터 (FinFET): 채널을 3차원 지느러미(Fin) 모양으로 세워 게이트가 채널의 3면을 감싸도록 만든 구조입니다. 삼성전자가 14나노, TSMC가 16나노 공정부터 도입하여 3나노 세대까지 반도체 산업의 황금기를 이끌었습니다. 그러나 2나노 이하로 진입하면서 지느러미 폭을 더 줄이기 어려워졌고, 접촉 면적의 한계로 구동 전류를 높이는 데 제약이 생겼습니다.
나노시트형 트랜지스터 (GAA FET): 지느러미 구조를 눕혀 여러 개의 나노시트(Nanosheet) 형태로 만들고, 게이트가 채널의 4면 전체를 완전히 둘러싸는(Gate-All-Around) 구조입니다. 삼성전자가 SF3(3나노) 공정에서 세계 최초로 양산에 성공했으며, TSMC(N2)와 인텔(18A, 리본펫) 역시 도입을 선언하며 현재 최선단 공정의 표준으로 자리 잡았습니다.
GAA 이후의 종착지: CFET(상보형 FET)의 등장
GAA 구조 역시 1.4나노~1나노 영역에 도달하면 나노시트를 수평으로 배치하는 공간적 한계에 부딪힙니다. 소자가 차지하는 평면 면적(Footprint)을 줄이지 못하면 칩의 크기를 줄일 수 없습니다. 이 때문에 세계적인 반도체 연구소인 imec을 비롯한 업계 전문가들은 GAA의 다음 단계로 CFET(Complementary FET, 상보형 FET) 구조를 지목해 왔습니다.
기존의 모든 트랜지스터 구조는 N형 트랜지스터(NMOS)와 P형 트랜지스터(PMOS)를 한 평면 위에 좌우로 나란히 배치했습니다. 반면 CFET은 이 두 소자를 수직으로 높게 쌓아 올리는(Stacking) 방식입니다. 동일한 평면 면적에 NMOS 위에 PMOS를, 혹은 그 반대로 얹어 버리기 때문에 소자가 차지하는 면적을 이론적으로 즉시 50% 줄일 수 있으며, 트랜지스터 집적 밀도를 2배로 끌어올릴 수 있는 혁신적인 구조입니다.
3. IBM NanoStack의 혁신적 아키텍처와 물리적 실체
CFET 구조가 가진 잠재력은 막대하지만, 이를 실제 실리콘 웨이퍼 위에 구현하는 것은 완전히 다른 차원의 공정 지옥을 의미합니다. IBM이 발표한 0.7나노급 NanoStack은 기존 학계와 연구소들이 제안하던 표준 CFET의 치명적인 병목 현상을 해결하기 위해 ‘엇갈린(Staggered) 구조’라는 독창적인 재료공학적 해법을 도입했습니다.
1) 엇갈린(Staggered) CFET 구조 vs 일렬 정렬(Aligned) 구조
일반적인 연구 단계의 CFET는 상부의 NMOS와 하부의 PMOS 채널(시트)을 수직 축선상에 정확히 일렬로 정렬(Aligned)시키는 형태를 취합니다. 이 방식은 레이아웃 디자인이 단순하다는 장점이 있지만, 실제 공정에서는 ‘VIA(수직 배선)의 지옥’을 만들어냅니다.
상부 레이어가 하부 레이어를 완전히 지붕처럼 가리고 있기 때문에, 하부 소자의 소스/드레인 영역에 전력을 공급하거나 신호를 추출하기 위해 수직 콘택트 배선을 꽂으려면 상부 소자의 물리적 공간을 깎아내거나 우회해야만 합니다. 이 과정에서 배선 간 거리가 극도로 가까워져 기생 정전용량($C_{parasitic}$)이 폭발적으로 증가하고, 배선 마진을 확보하기 위해 트랜지스터의 핵심인 실리콘 채널 폭($W_{Si}$) 자체를 강제로 줄여야 하는 모순이 발생합니다.
IBM은 이 문제를 해결하기 위해 위층과 아래층을 지그재그 형태로 비틀어 배치하는 ‘엇갈린(Staggered) 아키텍처’를 세계 최초로 고안했습니다.
위에서 내려다보았을 때 상부 트랜지스터 층에 가려지지 않고 하부 트랜지스터의 소스/드레인 영역이 하늘을 향해 노출되는 미세한 공간이 확보됩니다. 엔지니어들은 상부 층의 간섭을 전혀 받지 않고 이 노출된 공간으로 직접 수직 콘택트(Direct Vertical Contact)를 일직선으로 꽂아 넣을 수 있게 됩니다.
이 혁신을 통해 배선 저항(R)과 기생 커패시턴스(C)를 동시에 낮추어 신호 전달 속도를 저하시키는 RC 지연(RC Delay) 현상을 극적으로 개선했습니다. 결과적으로 초미세 회로 단위인 4-트랙 셀 내에서 실리콘 시트의 유효 폭을 정렬형 대비 최대 65%나 넓히는 데 성공했으며, 이는 트랜지스터의 전류 구동 능력(Ion)의 압도적인 향상으로 연결됩니다.
2) 결정 격자 방향(Crystal Orientation)과 ‘순차적 접합(Sequential)’의 신의 한 수
반도체 소자 물리학에서 전하를 운반하는 캐리어의 이동도(Carrier Mobility)는 실리콘 단결정의 격자 구조와 방향에 절대적인 지배를 받습니다. 여기에 실리콘 재료가 가진 태생적 비밀이 숨어 있습니다.
전자(Electron)의 특성: NMOS의 주 캐리어인 전자는 실리콘 결정면 중 $(100)$ 또는 $(001)$ 방향에서 가장 저항을 적게 받으며 최고의 속도로 달립니다.
정공(Hole)의 특성: PMOS의 주 캐리어인 정공은 이와 달리 (110)결정면에서 이동 속도가 최소 2.5배 이상 빨라집니다.
과거 FinFET이나 기존 GAA 공정은 단 한 장의 (100) 결정 웨이퍼 위에서 전체 회로를 구성해야 했기 때문에, NMOS에 최적화된 환경을 선택하고 PMOS의 성능 손해를 감수할 수밖에 없었습니다. 이를 보완하기 위해 PMOS 채널 부위에 실리콘-게르마늄(SiGe) 이종 에피택시 층을 성장시켜 물리적인 압축 응력(Compressive Stress)을 가하는 변편을 써왔으나, 공정이 미세화될수록 재료의 결함 제어가 불가능한 한계에 도달했습니다.
IBM NanoStack은 이를 해결하기 위해 CFET의 두 가지 접근법 중 순차적 접합(Sequential CFET) 방식을 극단으로 밀어붙였습니다.
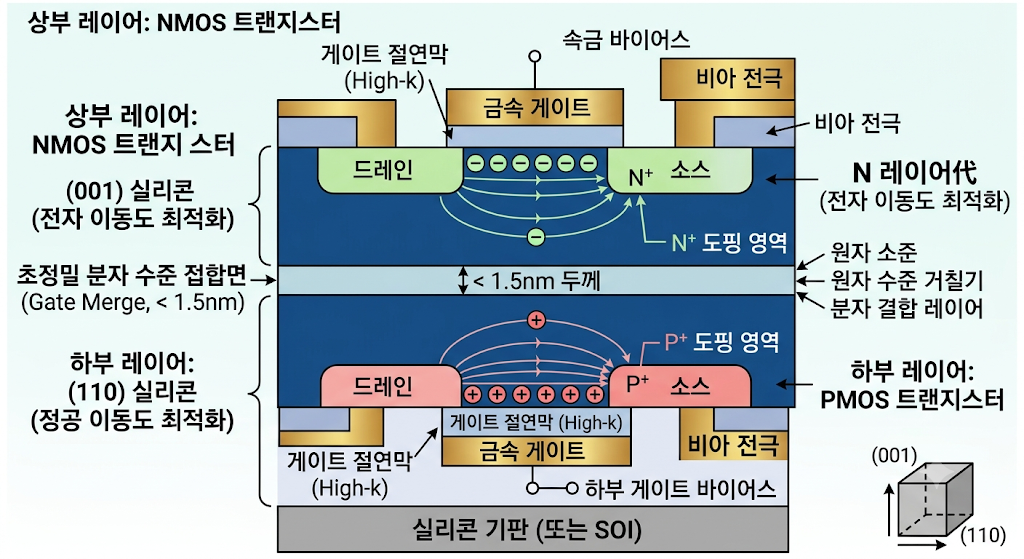
하부 PMOS는 정공 이동도가 극대화된 (110) 캐리어 웨이퍼 위에 완벽하게 형성하고, 그 위에 전자의 이동도가 최적화된 (001) 방향의 NMOS 웨이퍼를 별도로 제조하여 뒤집어 붙이는(Layer Transfer) 방식을 채택한 것입니다. NMOS와 PMOS 모두가 재료역학적으로 가장 완벽한 홈그라운드에서 100%의 성능을 발휘할 수 있는 환경을 물리적으로 조성해 낸 셈입니다.
3) 재료공학적 난제 극복: Thermal Budget(열 관리)의 돌파구
이 순차적 접합 방식의 가장 치명적인 약점은 ‘열 처리 제약(Thermal Budget)’이었습니다. 상부 웨이퍼를 하부 구조 위에 접합한 후 상부 NMOS 트랜지스터의 소스/드레인 영역을 형성하려면, 주입된 이온을 활성화하기 위해 필수적으로 1000도 이상의 고온 어닐링(Annealing) 공정을 거쳐야 합니다.
이때 발생하는 엄청난 열이 하부 레이어로 전달되면, 이미 정밀하게 만들어진 하부 PMOS의 p-n 접합면(Junction)의 도펀트들이 의도치 않게 확산되어 버리고 고유한 HKMG(High-K Metal Gate, 고유전율 금속 게이트) 산화막 구조를 열적으로 파괴하는 현상이 일어납니다. 사실상 먼저 지은 아래층 인프라가 위층 공사할 때의 열기로 무너지는 꼴입니다.
IBM은 이 난제를 해결하기 위해 2010년대 업계 표준을 이끌었던 ‘게이트퍼스트(Gate-First) HKMG’ 기술의 헤리티지에서 해답을 찾았습니다. 고온 공정 환경에서도 격자 변형과 원자 이동이 일어나지 않는 열적 안정성이 극대화된 특수 금속 게이트 조성 및 유전체 배합 노하우를 부활시킨 것입니다.
그 결과, 상부 층 형성을 위한 900도 이상의 가혹한 후속 열처리 공정 속에서도 하부 PMOS 소자의 임계 전압(V_t) 변화를 방어해 냈으며, 게이트 누설 전류의 증가를 기존 적층 방식 대비 획기적인 수준으로 억제하는 데 성공했습니다. 외형적 구조 혁신 이면에 숨겨진, IBM의 뿌리 깊은 재료공학적 내공이 빛을 발한 순간입니다.
4. ‘게이트 머지(Gate Merge)’ 본딩 vs 3D 패키징(TSV)의 격차
반도체 시장을 분석하는 다수의 자본 시장 분석가들이 화웨이 등 중화권 진역이 미국의 규제를 우회하기 위해 사용하는 구형 칩 적층 기술과 이번 IBM의 NanoStack을 완벽하게 선을 그어 차별화하는 핵심 요인이 바로 이 ‘본딩(Bonding)의 차원’에 있습니다.
현재 메모리 반도체(HBM)나 로직 칩 적층에 흔히 쓰이는 TSV(구리 관통 전극) 및 마이크로 범프 기반의 하이브리드 본딩은 후공정, 즉 백엔드(BEOL, Back-End of Line) 영역에 속합니다. 이는 이미 완벽하게 독립적으로 제조가 완료된 두 개의 다이(Die) 또는 칩을 구리 패드(Cu-Cu) 간의 물리적 접촉을 통해 이어 붙이는 방식입니다. 이 방식은 아무리 초정밀 장비를 사용하더라도 상하부 패드 간의 정렬 오차(Misalignment)가 수백 나노미터에서 수 마이크로미터 단위로 발생할 수밖에 없는 구조적 한계가 존재합니다.
반면, IBM이 선보인 NanoStack의 본딩은 패키징 단계가 아닌 트랜지스터 소자 자체를 형성하는 전공정의 핵심인 프런트엔드(FEOL, Front-End of Line) 단계에서 이루어집니다.
IBM은 이를 ‘게이트 머지(Gate Merge)’ 설계라 명명했습니다. 두 웨이퍼를 물리적으로 결합할 때, 원자와 원자 사이의 끌어당기는 힘인 반데르발스 힘(Van der Waals force)을 이용하는 직접 접합(Direct/Fusion Bonding) 기술을 극한으로 끌어올렸습니다. 실제로 IBM은 300mm 대형 웨이퍼 전체 영역에서 본딩 유전체 층의 두께 균일도 오차를 1.5나노미터 이내라는 경이적인 정밀도로 통제해 냈음을 발표했습니다.
이 분자 수준의 초정밀 접합이 가능해지면서 하부 PMOS의 게이트와 상부 NMOS의 게이트가 단 몇 나노미터의 오차도 없이 수직으로 완벽하게 일직선 정렬을 이룰 수 있게 되었습니다. 결과적으로 상하부 게이트가 완전히 물리적으로 일체화되어 하나의 공동 게이트(Common Gate)로 기능하게 되며, 전자가 통과하는 통로 사이의 공간 낭비나 면적 손실이 ‘0’에 수렴하게 됩니다. 수천 개의 거대한 TSV 구멍을 뚫어 칩을 누더기처럼 연결하는 기존 후공정 적층 기술과는 차원이 다른, 진정한 의미의 ‘단일 소자 레벨의 3D 적층’인 것입니다.
5. 데이터 검증 및 성능 지표 해독
IBM이 제시한 0.7나노 NanoStack의 성능 데이터는 소자 및 반도체 공학 관점에서 단순한 마케팅 수치를 넘어선 압도적인 물리적 완성도를 보여줍니다. 발표된 핵심 지표의 행간을 냉철하게 분석해 보겠습니다.
주요 성능 향상 지표 요약
평가 항목
기존 2나노 GAA 공정 대비 개선 수준
로직 회로 면적 (Logic Area)
50% 축소 (동일 기능 구현 시 필요한 면적 절반 감소)
SRAM 셀 높이 (Cell Height)
40% 축소 (캐시메모리 집적도 극대화 가능)
동일 전력 기준 성능 (Performance)
50% 향상 (동일 에너지 소모 시 연산 속도 가속)
동일 성능 기준 소비전력 (Efficiency)
70% 절감 (모바일 및 데이터센터 전력 제어 혁신)
트랜지스터 밀도 (Density)
손가락 손톱 크기(약 150mm^2) 칩에 약 1,000억 개 집적
서브쓰레숄드 스윙($SS$)의 소자물리학적 가치
발표 데이터 중 반도체 엔지니어들을 가장 놀라게 한 숫자는 바로 $68\sim70\text{mV/decade}$로 기록된 서브쓰레숄드 스윙(Subthreshold Swing, SS) 값입니다.
서브쓰레숄드 스윙은 트랜지스터가 꺼진 상태(Off)에서 켜진 상태(On)로 전환될 때, 드레인 전류를 10배(1 decade) 증가시키기 위해 게이트에 가해야 하는 전압의 양을 의미하는 지표입니다. 수식으로는 다음과 같이 표현됩니다.
SS = ln(10) *(k_B* T/q) *(1 + C_dep/C_ox)
여기서 k_B는 볼츠만 상수, T는 절대온도, q는 전하량이며, C_dep는 공핍층 커패시턴스, C_ox는 게이트 산화막 커패시턴스입니다. 상온(300K) 조건에서 소자가 가질 수 있는 물리적 이론 한계치(Ideal Limit)는 약 60mV/decade입니다. 이 숫자가 낮을수록 스위칭 반응 속도가 빠르고, 문턱 전압 이하에서 흘러버리는 누설 전류를 완벽하게 차단할 수 있음을 뜻합니다.
과거 평면 트랜지스터의 SS 값은 80~100mV/decade 수준이었고, FinFET에 이르러서야 65~85mV/decade범주로 들어왔습니다.
IBM이 두 장의 웨이퍼를 분자 단위로 찢고 붙이는 극도로 복잡하고 가혹한 순차적 CFET 공정을 수행했음에도 불구하고 68~70mV/decade를 기록했다는 것은 무엇을 의미할까요? 채널의 4면을 감싸는 게이트의 전계 지배력(C_ox)이 적층 과정에서도 열화 없이 완벽하게 유지되고 있으며, 이종 결정 격자가 접합된 계면(Interface)에 전하를 트랩하여 성능을 갉아먹는 결함 밀도(Interface Trap Density)를 극단적으로 낮추었다는 방증입니다. 한마디로 “3차원으로 쌓았지만, 누설 전류 제어 능력은 단일 GAA 소자보다 우수하다”는 것을 완벽히 입증한 것입니다.
트랜지스터 밀도(Density)의 착시와 실체
IBM은 이번 기술을 통해 1제곱밀리미터(mm^2)당 6억 6,600만 개(666MTr/mm^2)의 트랜지스터를 집적할 수 있다고 정량적 수치를 제시했습니다. 그러나 업계 분석가들의 정밀 계산에 따르면, 이 숫자는 소자의 단순 물리적 공간 규격을 단순 나눗셈 방식으로 환산한 이론적 수치에 가깝습니다.
실제 칩 설계 단계에서 표준 로직 셀 레벨과 배선 라우팅 마진, 절연 영역을 고려한 실제 면적당 유효 트랜지스터 밀도는 약 380~550MTr/mm^2 수준이 될 가능성이 높습니다. 비록 발표 수치보다는 다소 낮아지더라도, 이는 2021년 IBM이 발표했던 2나노 GAA 밀도의 정확히 2배에 달하는 수치로, 무어의 법칙의 명맥을 잇기에 충분한 밀도 혁명입니다.
6. 상용화의 가시적 걸림돌: 5년의 시간 동안 통과해야 할 ‘3대 지옥’
IBM이 기술적 가능성의 문을 열어젖혔지만, TSMC, 삼성전자, 인텔 같은 파운드리 업체들이 이를 넘겨받아 5년 내에 실적을 내는 상업 양산 라인(2031년 경)으로 전환하기 위해서는 소위 공정 소부장 생태계가 다음의 세 가지 거대한 병목 현상을 반드시 해결해야만 합니다.
1) EDA(설계 자동화) 툴의 아키텍처적 부재
시놉시스(Synopsys)나 케이던스(Cadence) 같은 글로벌 EDA 기업들의 설계 소프트웨어는 기본적으로 2차원 평면 기반 위에 멀티 레이어 배선을 올리는 방식에 최적화되어 있습니다. GAA까지는 이 방식으로 대응이 가능했으나, 상하부 트랜지스터가 미세하게 어긋나 배치되는 IBM의 ‘엇갈린(Staggered) CFET’ 구조에서는 완전히 무용지물이 됩니다.
위층과 아래층 소자 간에 발생하는 미세한 기생 성분(R, C)의 상호 간섭을 정확히 시뮬레이션하고, 수나노미터 단위의 오차 내에서 수직 배선을 배치하는 자동 라우팅 알고리즘을 구현하려면 EDA 툴의 소스코드 자체를 완전히 새로 짜야 하는 대변혁이 필요합니다. 툴의 지원 없이는 애플이나 엔비디아 같은 팹리스 고객사들이 단 한 줄의 회로도 그릴 수 없기 때문에, EDA 생태계의 발전 속도가 상용화 타이밍의 최대 변수가 될 것입니다.
2) 3D 구조 내에서의 열 방출(Thermal Dissipation) 난제
트랜지스터가 단층 단독주택에서 복층 빌딩 구조로 변모하면서 칩 내부의 열 방출 문제는 임계점에 도달하게 됩니다. 특히 고성능 연산을 수행할 때 내부 깊숙이 위치한 NMOS와 PMOS 채널에서 발생하는 고열이 사방을 둘러싼 게이트 유전막과 금속 배선에 가로막혀 외부로 빠져나가지 못하고 갇히는 현상이 발생합니다.
이 열이 축적되면 소자의 전하 이동도가 급감하는 것은 물론, 특정 임계점을 넘을 경우 소자가 스스로 파괴되는 열 폭주(Thermal Runaway) 현상이 일어납니다. 이를 해결하기 위해 상하부 레이어 사이에 전기적 절연 성능을 유지하면서도 열전도율이 극단적으로 높은 차세대 특수 유전체(Dielectric) 신소재 개발이 필수적으로 요구됩니다.
3) High-NA EUV 노광 장비의 수율 및 오버레이 마진
IBM NanoStack 공정에서 웨이퍼 직접 접합의 정밀도를 300mm 웨이퍼 전체에서 $1.5\text{nm}$ 이하로 통제하고 지그재그 패턴을 형성하기 위해서는 노광 공정의 해상력이 극단적으로 높아져야 합니다. ASML의 차세대 노광 장비인 High-NA EUV(렌즈 개구수 0.55) 장비 도입이 필수적인 이유입니다.
High-NA EUV 장비 자체를 확보하는 것을 넘어, 매 초당 수십 장의 웨이퍼를 나노미터 이하의 정렬 정밀도로 찍어내는 대량 생산 라인에서의 오버레이(Overlay) 마진 수율을 확보하는 것은 파운드리 업체들에게 엄청난 자본적, 기술적 압박으로 다가올 것입니다. IBM은 이미 해당 장비를 구매해 자사 올버니 연구소에 설치 중이라고 밝히며 선제적 대응에 나섰습니다.
7. 글로벌 반도체 밸류체인 투자 전략 (해외 섹터)
30년 차 자본 시장 애널리스트 관점에서, 이번 IBM의 발표는 미세공정 주도권을 잡기 위한 파운드리 간의 불꽃 튀는 레이스에 기름을 부은 격입니다. 향후 5년간 거대한 패러다임 변화 속에서 구조적 성장을 구가하며 막대한 투자 수익을 창출할 글로벌 수혜주들을 세부 섹터별로 해부합니다.
글로벌 밸류체인 핵심 기업 요약
1) 최전방 파운드리 및 IDM 진영
IBM은 원천 기술을 개발하는 연구소의 포지션이며, 결국 상용화 단계에서 막대한 상업적 이익을 거두는 주체는 양산 능력을 보유한 거대 파운드리 기업들입니다.
TSMC (TSM): 명실상부한 글로벌 1위 파운드리로서 차세대 공정에서도 절대적 우위를 점할 가능성이 높습니다. TSMC는 이미 A16(1.6나노) 공정부터 독자적인 후면 전력 공급(Backside Power Delivery Network) 기술인 ‘슈퍼파워(SuperPower)’를 도입할 예정입니다. 이는 IBM NanoStack이 요구하는 복잡한 수직 하부 배선 노하우를 세계에서 가장 먼저 양산 수준으로 축적함을 의미합니다. 초기 높은 감가상각비 리스크가 있겠지만, 애플 및 엔비디아 등 막대한 자금력을 가진 빅테크 고객사들을 독점하고 있어 비용을 가격에 전가할 수 있는 독점적 가격 결정력(Pricing Power)을 발휘할 것입니다.
인텔 (INTC): 단기적 기술 리더십 내러티브의 최대 수혜주입니다. 인텔은 최선단 18A 공정에서 GAA 구조인 ‘RibbonFET’과 후면 전력 공급 기술인 ‘PowerVia’를 동시 적용하며 3차원 소자 구조 도입에 가장 공격적인 행보를 보여왔습니다. 특히 IBM의 올버니 연구소 인근에 대규모 파운드리 인프라를 보유하고 있고, 역사적으로 IBM과 긴밀한 공동 연구 협력 관계를 유지해 온 만큼 기술 라이선스 확보 및 공동 개발 측면에서 가장 유리한 고지를 선점하여 주가 모멘텀을 강하게 받을 수 있습니다.
2) 전공정 장비(Equipment) 섹터: 패러다임 변화의 진짜 주인공
CFET 공정의 본질이 ‘웨이퍼 두 장을 전공정 단계에서 분자 단위로 접합하는 것’인 만큼, 장비 섹터 내 부가가치의 중심축이 기존 노광(EUV) 단독 체제에서 접합(Bonding), 식각(Etching), 증착(Deposition) 장비 진역으로 급격히 이동하게 됩니다.
도쿄일렉트론 (TEL, 8035 JP) & EV Group (비상장): 웨이퍼 본딩의 지배자들입니다. IBM 기술의 핵심인 300mm 웨이퍼 전체에서의 1.5nm 이하 두께 균일도를 가지는 직접 접합(Fusion Bonding)을 구현할 수 있는 독보적인 전공정 본딩 장비사는 오스트리아의 EVG와 일본의 TEL뿐입니다. 과거 후공정(HBM)의 전유물로 여겨지던 본딩 기술이 전공정(FEOL)의 메인스트림 장비로 격상됨에 따라, TEL의 초정밀 화학적 기계 연마(CMP) 및 본딩 통합 공정 솔루션 매출은 구조적 우상향 궤도에 진입할 것입니다.
어플라이드 머티어리얼즈 (AMAT) & 램리서치 (LRCX): 엇갈린 구조에서 하부 소자를 손상시키지 않고 상부에서 최하단까지 정밀하게 깊은 구멍을 뚫고 들어가는 공정은 극단적인 고종횡비(High Aspect Ratio) 식각 기술을 요구하며, 이는 램리서치의 독무대가 될 것입니다. 또한 서로 다른 격자 방향인 (001)과 (110) 위에서 실리콘 채널을 결함 없이 성장시키는 원자층 증착(ALD) 및 에피택시(Epitaxy) 장비 수요의 폭발로 증착 진역의 최강자 AMAT 역시 강력한 ‘Q(수량)의 증가’ 수혜를 입게 됩니다.
3) EDA(설계 자동화) 섹터: 가장 안전하고 확실한 통행세 비즈니스
공정 수율의 불확실성이라는 리스크에서 완전히 자유로우면서도, 기술이 도입되기 위해 반드시 거쳐야 하는 길목에서 ‘통행세’를 받는 가장 매력적인 투자처입니다.
시놉시스 (SNPS) & 케이던스 (CDNS): 앞서 언급한 ‘엇갈린 구조’ 전용 3차원 라우팅 및 기생 성분 시뮬레이션 알고리즘을 제공할 수 있는 유일한 대안들입니다. 파운드리 업체들이 수율 지옥에서 고전하며 적자를 보더라도, 빅테크 팹리스들은 제품 설계를 위해 공정 도입 수년 전부터 이들의 차세대 EDA 툴 라이선스를 고가에 구매해야만 합니다. 경기 변동과 공정 리스크를 방어할 수 있는 가장 확실한 포트폴리오입니다.
8. 국내 반도체 생태계(소부장) 투자 전략 (국내 섹터)
해외의 거대 공룡 기업들이 판을 짜고 있지만, 대한민국 반도체 공급망(Value Chain) 역시 만만치 않은 저력을 보여주고 있습니다. 특히 최근 삼성전자가 국제 반도체 학술대회(VLSI 심포지엄)에서 TSMC보다도 미세화된 세계 최소 크기의 CFET 연구 성과를 공식 발표하면서 국내 소부장 생태계의 기술적 대응도 가속화되고 있습니다. IBM NanoStack 패러다임 속에서 글로벌 파운드리 진영으로 장비를 공급할 국내 핵심 수혜주들을 엄선했습니다.
국내 소부장 핵심 수혜주
기업명
핵심 기술/장비
기술적 연계 및 투자 포인트
HPSP
고압 수소 어닐링 (독점)
$450^\circ\text{C}$ 이하 저온 공정으로 하부 PMOS 열화 방지 및 계면 결함 치료 필수재
파크시스템스
원자현미경 (AFM)
3차원 엇갈린 구조 내부의 깊은 트렌치 및 표면 결함을 파괴 없이 계측하는 독보적 기술
인텍플러스
3D 비파괴 검사 장비
웨이퍼 접합면의 미세 기포(Void) 및 정렬 오차를 실시간 전수 검사하는 핵심 파트너
케이씨텍
국산 초정밀 CMP 장비
분자 수준 접합을 위한 웨이퍼 표면 초정밀 평탄화 공정 및 소모성 슬러리 매출 급증
1) HPSP (440110) — 전 세계 대체 불가능한 ‘Thermal Budget’의 구원투수
IBM 순차적 CFET의 최대 아킬레스건이 상부 소자 형성 시의 고온이 하부 소자를 망가뜨리는 ‘열 제어’ 문제라고 강조했습니다. HPSP가 전 세계 시장을 독점하고 있는 ‘고압 수소 어닐링(High-Pressure Hydrogen Annealing)’ 장비는 이 한계를 극복할 핵심 열쇠입니다.
이 장비는 기존 열처리 장비와 달리 100%에 가까운 고농도 수소 환경을 구축하여, 비교적 매우 낮은 온도인 $450^\circ\text{C}$ 이하의 환경에서도 트랜지스터 계면의 미세 결함들을 완벽하게 치유(Curing)해 줍니다. 하부 PMOS 소자의 열적 손상을 원천 차단하면서도, $SS$ 값을 낮추는 데 기여한 계면 결함 밀도 관리를 가능케 하므로, CFET 공정이 고도화될수록 HPSP 장비의 채택률은 글로벌 파운드리 전체에서 필수 불가결한 요소로 자리 잡을 것입니다. 단기와 중장기 모두를 만족하는 최고의 픽입니다.
2) 파크시스템스 (140860) — 3차원 나노 빌딩을 들여다보는 유일한 눈
트랜지스터가 3차원 복층 구조로 복잡하게 얽히고 지그재그로 어긋나기 시작하면, 기존 파운드리가 수율 검사에 사용하던 기존 방식의 전자현미경(CD-SEM)이나 광학 검사 장비로는 구조 내부 깊숙한 곳의 치수 오류나 결함을 측정하는 것이 물리학적으로 불가능해집니다.
파크시스템스의 원자현미경(AFM, Atomic Force Microscope)은 나노미터 이하 단위에서 원자 단차의 물리적 표면 형상과 극단적으로 깊고 좁은 구멍(High Aspect Ratio)의 내부 구조를 칩을 파괴하지 않고 3D 형태로 정밀 계측할 수 있는 전 세계 독보적인 기술력을 보유하고 있습니다. CFET 초기 연구 개발 단계부터 향후 파운드리 업체들의 수율 잡기 양산 단계까지, 파크시스템스의 원자현미경은 선택이 아닌 필수 계측 인프라로 등극할 것입니다.
3) 인텍플러스 (064290) — 분자 본딩의 성패를 가르는 비파괴 검사의 강자
300mm 대형 웨이퍼 전체를 분자 단위로 직접 접합하는 공정에서는 육안이나 일반 스캔으로 식별할 수 없는 미세한 기포(Void)나 소수 나노미터 수준의 정렬 오차(Misalignment)가 발생하기 쉽습니다. 이를 걸러내지 못하고 후속 공정을 진행하면 수천억 원의 웨이퍼 라인 전체가 폐기되는 재앙이 발생합니다.
인텍플러스는 독보적인 3D 기하학적 외관 검사 및 비파괴 광학 검사 기술을 보유하고 있습니다. 최근 국내 대형 제조사와 차세대 적층 공정용 전공정 비파괴 검사 장비의 공동 개발 및 샘플 테스트를 긴밀하게 진행 중인 것으로 파악되며, 웨이퍼 접합 전후의 완벽한 품질을 보증하는 핵심 검사 파트너로서 단기 모멘텀과 중장기 실적 성장을 동시에 견인할 대표적인 가치주입니다.
9. 결론: 결코 머지않은 미래, 투자자가 취해야 할 행동 양식
IBM이 쏘아 올린 0.7나노 ‘NanoStack’ 아키텍처는 단순한 연구소의 기술 과시가 아닙니다. 이는 반도체 미세화 공정의 축이 기존의 수평적 패턴 새기기(Lithography) 중심에서 전공정 단계의 3차원 적층(FEOL 3D Integration) 및 재료공학적 융합 패러다임으로 완전히 전환되었음을 선언한 역사적 이정표입니다.
투자자들은 다음의 투 트랙 시나리오에 기반하여 포트폴리오를 재편해야 합니다.
단기 관점 (1~2년, 내러티브 및 모멘텀 구간): IBM의 발표를 시작으로 인텔, 삼성전자, TSMC 간의 ‘CFET 로드맵 및 장비 선점 경쟁’ 언론 플레이가 격화될 것입니다. 이때는 공정 변화의 무조건적인 수혜를 입으며 글로벌 전역으로 장비를 공급하는 HPSP, 파크시스템스, ASML, 시놉시스 같은 글로벌 독점력을 가진 기업들이 주가 탄력성을 강하게 받을 것입니다.
중장기 관점 (3~5년, 실적 가시화 및 양산 투자 구간): 실제 파운드리 사들의 공장 증설 공시와 설비 투자(CAPEX) 집행이 이루어지는 시점입니다. 이때는 분자 수준의 평탄화를 책임지는 도쿄일렉트론(TEL)과 국내 삼성/SK 공급망 내부에서 실질적인 퀀텀 점프를 이뤄낼 인텍플러스, 케이씨텍의 실적 턴어라운드와 본격적인 매출 성장에 집중해야 합니다.
우리 국내 소부장 기업들은 메모리 반도체(NAND)를 200층, 300층씩 세계 최초로 수직으로 쌓아 올리며 ‘3차원 고종횡비 수직 구조’에 대한 가혹한 공정 예방주사를 전 세계에서 가장 먼저 맞은 든든한 기술적 뼈대가 있습니다. 메모리에서 축적된 대한민국 소부장의 적층 헤리티지는 시스템 반도체의 대격변기인 CFET 시대에도 글로벌 시장을 뒤흔들 강력한 무기가 될 것입니다. 이 거대한 기술 대전환의 길목에서 독점적 기술력을 가진 기업을 선점하는 자만이 향후 5년 뒤 반도체 시장이 창출할 거대한 부를 소유하게 될 것입니다.