[작성자:] 가츠

  • [2026.09.01] 3차 리튬 슈퍼사이클의 도래와 K-배터리 밸류체인 재편 전략

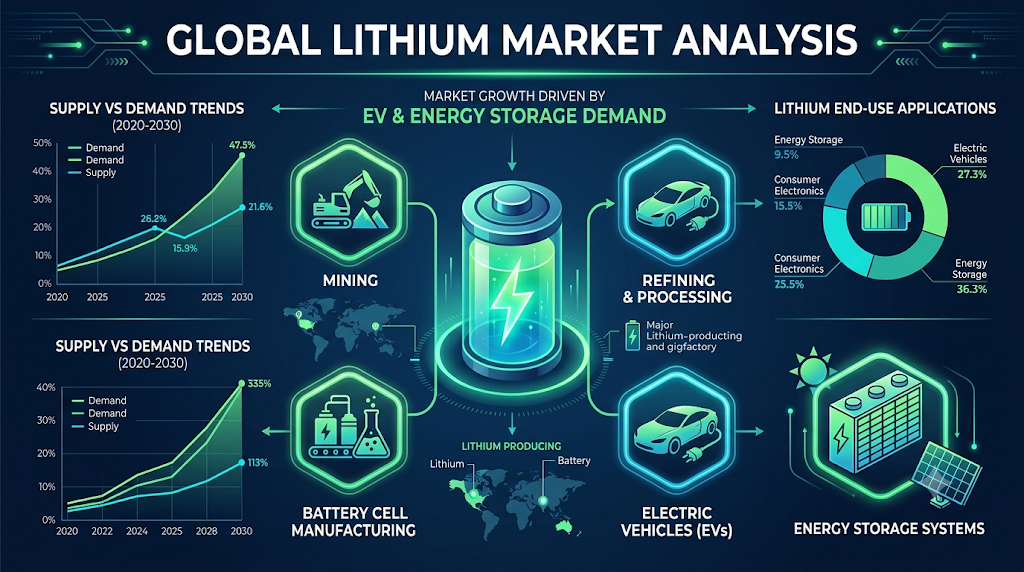
    글로벌 배터리 원료 리튬 시장 분석(Global Lithium Market Analysis)을 다룬 다크 모드 스타일의 영문 인포그래픽. 상단에는 2020년부터 2030년까지의 리튬 공급과 수요 추이를 나타내는 데이터 차트(Supply vs Demand Trends)가 위치해 있으며, 중앙의 대형 3D 리튬 배터리 그래픽을 중심으로 리튬 채굴(Mining), 배터리 셀 제조(Battery Cell Manufacturing), 가공 및 정제(Refining & Processing), 전기차(EVs) 및 에너지 저장 시스템(ESS)으로 연결되는 글로벌 밸류체인 단계가 시각화되어 있다

    Executive Summary: 핵심 요약

    2022년 호황기 전기차 배터리 시장을 지나고 2023년부터 2025년까지의 혹독한 가격 침체기(Down-cycle)를 지나 2026년 리튬 시장은 구조적 반등 초입(Early Up-cycle)에 진입했습니다. 전기차(EV) 중심이었던 리튬 수요축이 AI 데이터센터 백업전력(BBU) 및 대규모 에너지저장장치(ESS)로 다변화되고, DLE(직접리튬추출) 공법이라는 기술적 혁신이 접목되면서 리튬 시장은 제3차 슈퍼사이클을 맞이하고 있습니다.

    목차 (Table of Contents)

    1. 서론: 혹독한 겨울을 지나 대전환의 길목에 선 글로벌 리튬 시장
    2. 포스코홀딩스의 아르헨티나 옴브레 무에르토 프로젝트 심층 분석
      • 2.1 수직계열화 및 탈중국 공급망의 전략적 의의
      • 2.2 염호 매장량, 리튬 농도, 흑자 전환 및 재무 여력 평가
    3. LG에너지솔루션 & 스맥오버 리튬 장기 계약: 구매자(Off-taker)의 모범 답안
      • 3.1 15억 달러 규모 장기 구매계약의 핵심 구조
      • 3.2 북미 현지 공급망 구축과 IRA(인플레이션 감축법) 대응 효과
    4. 기술의 패러다임 전환: DLE(Direct Lithium Extraction, 직접리튬추출)의 부상
      • 4.1 전통 증발법 vs DLE 공법 메커니즘 비교
      • 4.2 ESG, 회수율, 속도 관점에서의 DLE 경제성 분석
    5. 10년 리튬 가격 역사적 궤적 및 3차 슈퍼사이클 전망 (2026~2030)
      • 5.1 10년간의 탄산리튬 가격 흐름 (2016~2026)
      • 5.2 글로벌 기관별 수급 및 가격 전망 (Canaccord, Ganfeng, J.P. Morgan, Bernstein)
    6. [Investment Guidance] K-배터리 밸류체인 투자 가이던스
      • 6.1 단기 관점 (6~18개월): 가격 반등 초기 구간의 레버리지 활용
      • 6.2 중장기 관점 (3~10년): K-배터리 톱픽 분석 및 포트폴리오 전략
    7. 결론: 자원 안보 시대, K-배터리가 나아가야 할 길

    1. 서론: 혹독한 겨울을 지나 대전환의 길목에 선 글로벌 리튬 시장

    IT 기술과 친환경 에너지의 결합이 가속화되는 현 시점에서, 하이테크 산업의 ‘하얀 석유(White Petroleum)’라 불리는 리튬(Lithium)은 단순한 원자재를 넘어 국가 산업 경쟁력을 좌우하는 핵심 전략 자원으로 자리 잡았습니다.

    지난 2023년부터 2025년까지의 기간은 배터리 및 소재 업계 전체에 지옥과도 같은 가격 대붕괴의 시기였습니다. 전기차 수요 성장세 둔화(Chasm)와 중국발 유휴 설비의 공급 과잉이 맞물리면서, 2022년 11월 톤당 약 60만 위안(약 8만 달러)에 달했던 탄산리튬 현물 가격은 2025년 초 톤당 8,000달러 선까지 궤멸적인 폭락을 겪었습니다.

    그러나 2026년 들어 리튬 시장에는 거대한 구조적 기류 변화가 감지되고 있습니다. 2026년 4월 기준 중국 탄산리튬 현물가가 연초 대비 40% 이상 급등하여 16만 위안선을 회복했으며, 9월 현재 톤당 $20,000~$23,000 선을 단단히 지지하고 있습니다.

    이러한 반등은 단순히 전기차 판매량의 회복에만 의존하는 것이 아닙니다. AI 데이터센터 확충에 따른 비상전원장치(BBU/UPS) 수요 폭발과 미국·유럽 grid 급 ESS(에너지저장장치) 시장의 급팽창이 새로운 강력한 수요 축으로 작용하고 있기 때문입니다. 캐나코드 제뉴이티(Canaccord Genuity), UBS, JP모건 등 주요 투자은행들이 “제3차 리튬 슈퍼사이클”의 개막을 선언한 이유가 바로여기에 있습니다.

    2. 포스코홀딩스의 아르헨티나 옴브레 무에르토 프로젝트 심층 분석

    2.1 수직계열화 및 탈중국 공급망의 전략적 의의

    포스코홀딩스(POSCO Holdings)는 국내에서 유일하게 광산·염호 등 자원 확보부터 리튬 추출·정제, 양극재 소재 생산까지 그룹 내에서 완결하는 전 과정 수직계열화(Vertical Integration)를 구축한 유일무이한 기업입니다.
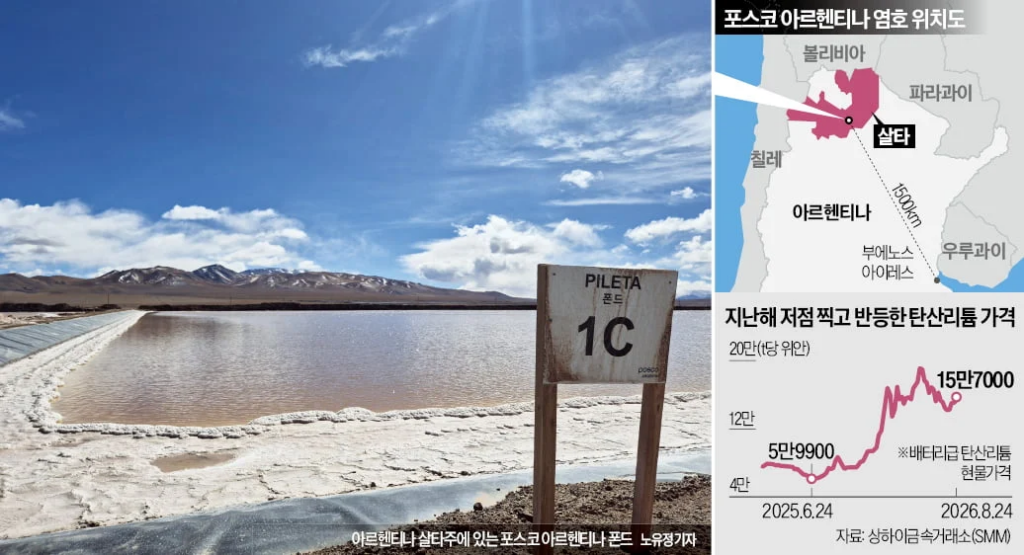
    중국이 글로벌 리튬 정제·가공 능력의 60~70% 이상을 독점하고 있는 상황에서, 한국·미국·일본 등 주요국의 배터리 산업은 심각한 지정학적 리스크에 노출되어 있습니다. 포스코의 아르헨티나 염호 독자 확보 및 개발은 단순한 소재 확보가 아니라 국가 차원의 “자원 안보(Resource Security)”를 지켜내는 핵심 전략적 포석입니다. 자체 자원 확보는 원가 마진 보호는 물론, 향후 원자재 가격 급등락 시 가격 변동성 위협을 흡수하는 강력한 쿠션 역할을 합니다.

    2.2 염호 매장량, 리튬 농도, 흑자 전환 및 재무 여력 평가

    포스코가 보유한 아르헨티나 옴브레 무에르토(Hombre Muerto) 염호는 세계 최고 수준의 품질을 자랑합니다.

    • 매장량 규모: 염수리튬 기준 총 1,500만 톤 확보 (수율 감안 시 최소 300만 톤 이상 생산 가능 = 전기차 약 7,000만 대분)
    • 리튬 농도: ℓ당 평균 921mg (통상 ℓ당 300~400mg만 되어도 우수한 사업성을 가진 것으로 평가받는 점을 고려하면 압도적 품질)
    [염호 리튬 농도 비교 (mg/L)]
    일반적인 상업성 기준:  [■■■] 300~400 mg/L
    포스코 옴브레 무에르토: [■■■■■■■■■] 921 mg/L (2.5배 우수)

    수익성 및 재무 상태:

    1. 분기 첫 흑자 달성: 2026년 3월 상업생산을 개시한 포스코아르헨티나는 가격 침체기의 적자를 버텨내고 2026년 2분기 사상 첫 분기 흑자 전환에 성공했습니다.
    2. 1조 원 규모 유동성 확보: 미주개발은행그룹(IDB Group)으로부터 미화 7억 달러 한도의 단기 차입 승인을 획득하여 후속 2, 3단계 증설 투자를 위한 차입 재원을 원활하게 확충했습니다.
    3. 레버리지 효과 기대: 생산량 확대(Q)와 리튬 단가 상승(P)이 동시에 작용하는 상승 초입 국면에서 포스코의 영업이익 레버리지 효과는 극대화될 전망입니다.

    3. LG에너지솔루션 & 스맥오버 리튬 장기 계약: 구매자(Off-taker)의 모범 답안

    3.1 15억 달러 규모 장기 구매계약의 핵심 구조

    2026년 8월 31일, LG에너지솔루션은 스탠다드 리튬(Standard Lithium)과 노르웨이 국영 에너지기업 에퀴노르(Equinor)의 합작법인인 ‘스맥오버 리튬(Smackover Lithium)’과 구속력 있는(Binding) 대규모 장기 공급계약을 공식 발표했습니다.

    • 계약 상대방: 스맥오버 리튬 (Standard Lithium + Equinor JV)
    • 공급 물량: 연간 8,000톤의 배터리급 탄산리튬 (2029년부터 10년간 총 8만 톤)
    • 계약 가치: 10년 총계약 추정치 약 15억 달러 (약 2조 원)
    • 원산지: 미국 아칸소주 남서부 ‘스맥오버 지층(Smackover Formation)’ 염수 리스 (약 3만 에이커)
    • 적용 기술: DLE(Direct Lithium Extraction, 직접리튬추출) 공법

    3.2 북미 현지 공급망 구축과 IRA(인플레이션 감축법) 대응 효과

    LG에너지솔루션은 아칸소 현지에서 채굴부터 정제까지 완결되는 리튬을 확보함으로써 완전한 미국 현지 공급망(Integrated US Supply Chain)을 완성했습니다.

    [LG에너지솔루션의 북미 밸류체인 시너지]
    스맥오버 리튬 (아칸소 DLE 채굴·정제)
           │
           ▼ (미국산 핵심 광물 요건 100% 충족)
    LGES 북미 셀 공장 (미시간 / 테네시 Ultium Cells / 오하이오 Honda JV)
           │
           ▼
    IRA 세액공제(AMPC/소비자 보조금) 완전 수혜 & 관세 무력화

    이 계약은 LG에너지솔루션이 직접 채굴에 자본을 투자(CAPEX)하는 것이 아니라 원료 구매자(Off-taker)로서 안정적 조달권을 선점한 구조입니다. 공급 개시 시점이 2029년인 만큼, 리튬 가격 반등이 가속화되기 전에 향후 10년 치 장기 원가를 선제적으로 안착시켜 비용 변동성 리스크를 완벽히 헤지(Hedge)했습니다.

    4. 기술의 패러다임 전환: DLE(Direct Lithium Extraction)의 부상

    4.1 전통 증발법 vs DLE 공법 메커니즘 비교

    리튬 추출 공정은 기존의 자연 증발법(Evaporation Pond)에서 차세대 DLE(직접리튬추출) 기술로 급격히 이동하고 있습니다.

    구분전통적 자연 증발법 (Evaporation)DLE (Direct Lithium Extraction, 직접리튬추출)
    작동 원리지하 염수를 거대 연못에 펼쳐 햇빛·바람으로 1~1.5년 증발흡착제/이온교환수지를 이용해 리튬만 물리·화학적으로 즉시 분리
    추출 시간수개월 ~ 1.5년 (매우 느림)수 시간 ~ 며칠 (혁신적 단축)
    리튬 회수율30% ~ 50% 수준70% ~ 90%+ (높은 효율)
    환경 영향대규모 부지 훼손, 증발로 인한 수자원 depletion 리스크부지 최소화, 추출 후 남은 염수를 지하 재주입 (친환경)
    적용 지역건조하고 햇빛이 강한 고지대 (아르헨티나, 칠레 등)습윤 지역 및 지하 깊은 염수층 (미국 아칸소 등 확장 가능)

    4.2 ESG, 회수율, 속도 관점에서의 DLE 경제성 분석

    DLE 공법은 기존 증발법이 가지는 환경적 불확실성(물 사용량, 부지 파괴)을 대폭 개선할 뿐만 아니라, 리튬 가공 시설 건설 후 정상 가동까지 걸리는 시간을 획기적으로 줄여줍니다.

    스맥오버 프로젝트처럼 미국 본토의 지하 염수층에서 리튬을 빠르게 추출할 수 있는 것도 DLE 기술 덕분입니다. 포스코 그룹 역시 전통 증발법에 DLE 기술 실증 및 병행 도입을 적극적으로 추진하고 있으며, DLE는 향후 글로벌 리튬 생산 효율성을 극대화할 핵심 기술로 평가받고 있습니다.

    5. 10년 리튬 가격 역사적 궤적 및 3차 슈퍼사이클 전망

    5.1 10년간의 탄산리튬 가격 흐름 (2016~2026)

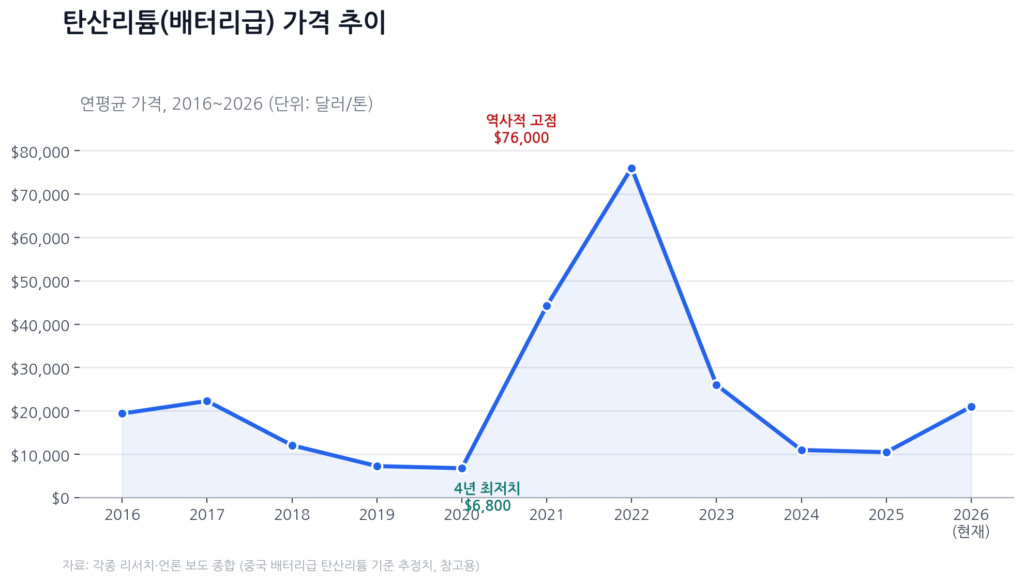
    지난 10년간 리튬 가격은 극심한 변동성을 보였습니다.

    1. 1차 사이클 (2016~2018년): 초기 전기차 붐 형성. 톤당 $19,000~$22,000 도달 후 공급 증가로 폭락.
    2. 바닥기 (2019~2020년): 글로벌 공급 과잉. 톤당 $7,000~$8,000선 형성.
    3. 2차 슈퍼사이클 (2021~2022년): EV 수요 폭발. 2022년 11월 역사적 고점인 톤당 ~60만 위안 (약 $79,637) 치솟음.
    4. 대붕괴기 (2023~2025년): LFP 배터리 침투 및 전기차 성장 둔화. 2025년 초 톤당 $8,000 수준까지 붕괴.
    5. 3차 슈퍼사이클 반등 초입 (2026년 현재): AI 데이터센터 백업전력 및 ESS 수요가 결합하며 톤당 $20,000~$23,000으로 급반등.
    5.2 글로벌 기관별 수급 및 가격 전망 (2027~2030)

    주요 투자기관들은 리튬 수요가 2024년 94만 톤에서 2026년 129만 톤, 2030년 218만 톤으로 가파르게 성장할 것으로 예측하고 있습니다.

    • Canaccord Genuity: 2026년 본격 공급부족 진입, 슈퍼사이클이 2035년까지 장기 지속될 가능성 제시.
    • Ganfeng Lithium: 2026년 수요 30~40% 급증 시 톤당 $21,000~$28,000 구간 안착 전망.
    • J.P. Morgan: AI 산업 및 전력 인프라 투자 가속화로 2027년까지 현재 대비 60% 이상 추가 상승 가능성 언급.
    • Bernstein: 2026년 수요 성장률(29%)이 공급 성장률(17%)을 크게 상회하면서 광산 가동률 대폭 상승 예측.

    6. [Investment Guidance] K-배터리 밸류체인 투자 가이던스

    6.1 단기 관점 (6~18개월): 가격 반등 초기 구간의 레버리지 활용

    • 재고평가손실 충당금 환입 모멘텀: 리튬 현물가 하락기에 발생했던 양극재 및 셀 업체들의 고가 재고평가손실 충당금이 리튬 가격 반등에 따라 영업이익으로 환입됩니다. 이는 강력한 실적 턴어라운드 동력이 됩니다.
    • Q(수량)와 P(가격)의 동시 상승: 포스코아르헨티나의 상업생산 물량 증대($Q$)와 리튬 현물 단가 반등($P$)이 마주치는 현시점이 밸류에이션 리레이팅(Re-rating)의 최적기입니다.
    • 단기 체크포인트: 중국 유휴 생산 능력(약 19만 톤 LCE)의 재가동 속도 및 탄산리튬 현물가의 톤당 18~20만 위안선 안착 여부.

    6.2 중장기 관점 (3~10년): K-배터리 톱픽 분석 및 포트폴리오 전략

    📊 포스코홀딩스 (POSCO Holdings) — [비중확대 / Overweight]

    [포스코홀딩스 투자 요약]
    - 목표: 2033년까지 연 17.3만 톤 체제 구축 -> 글로벌 Top 5 리튬 기업 진입
    - 강점: 광산/염호 직접 보유로 업스트림 광전 마진 독점 (내년 리튬 마진율 40% 육박 전망)
    - 전략: 리튬 가격 반등 초입 구간에서 분할 매수 적기. 10월 준공 예정인 리튬 2공장 모멘텀 주목.
    

    📊 LG에너지솔루션 (LG Energy Solution) — [매수 / Buy]

    [LG에너지솔루션 투자 요약]
    - 목표: 스맥오버 DLE 리튬 등 북미 공급망 완전 체계화로 원가율 안정화
    - 강점: IRA 세액공제(AMPC) 요건 완벽 충족 + AI 데이터센터 BBU 및 ESS향 고마진 제품 비중 확대
    - 전략: 단기 업황 변동성보다는 4~5년 뒤 북미 독점적 공급망 프리미엄을 반영한 긴 호흡의 투자 유효.
    

    7. 결론: 자원 안보 시대, K-배터리가 나아가야 할 길

    포스코홀딩스와 LG에너지솔루션이 보여준 행보는 단순한 원자재 조달을 뛰어넘는 미래 에너지 패권 전쟁에서의 생존 전략입니다.

    포스코는 “자원 개발자(Developer)”로서 상류(Upstream) 밸류체인을 직접 장악하여 광전 마진을 극대화하는 길을 가고 있으며, LG에너지솔루션은 “원료 구매자(Off-taker)”로서 북미 현지 DLE 자원과 10년 장기 계약을 맺어 IRA 세액공제 확보 및 원가 리스크 헤지를 완벽히 달성하고 있습니다.

    3차 리튬 슈퍼사이클의 초입인 지금, 탈중국 수직계열화와 친환경 DLE 기술을 선제적으로 확보한 K-배터리 기업들에 장기적인 관점에서 적극적이고 지속적인 관심이 필요한 시점입니다.

    관련 기사:

    https://n.news.naver.com/mnews/article/001/0016281291

    https://n.news.naver.com/mnews/hotissue/article/366/0001188951?cid=1087841
  • [2026.08.28] 글로벌 빅파마의 선택을 받은 K-바이오의 핵심 승부처와 섹터별 투자 지도

    💻 프롤로그: IT 밸류에이션 프레임워크로 바라본 K-바이오의 구조적 대전환

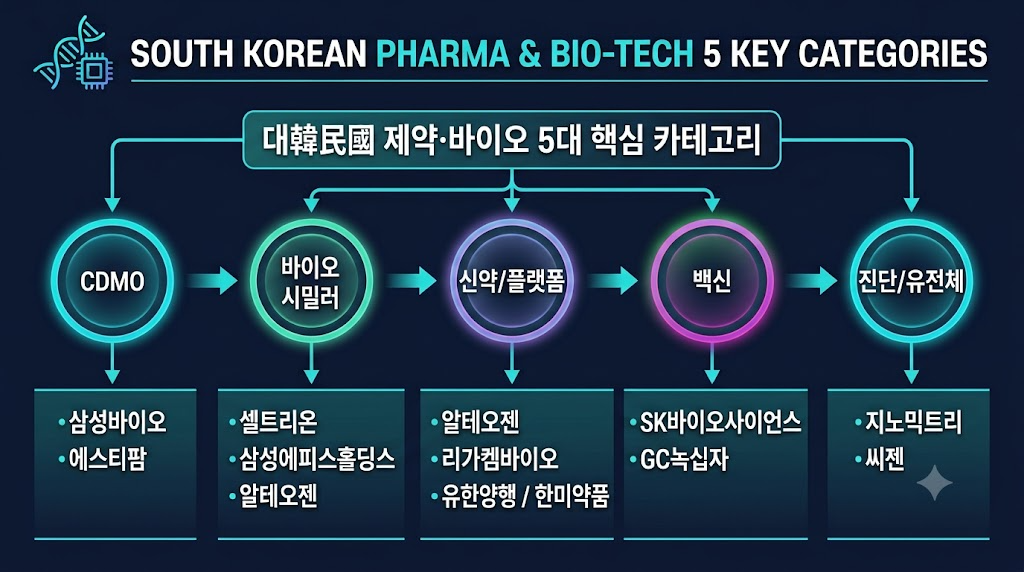
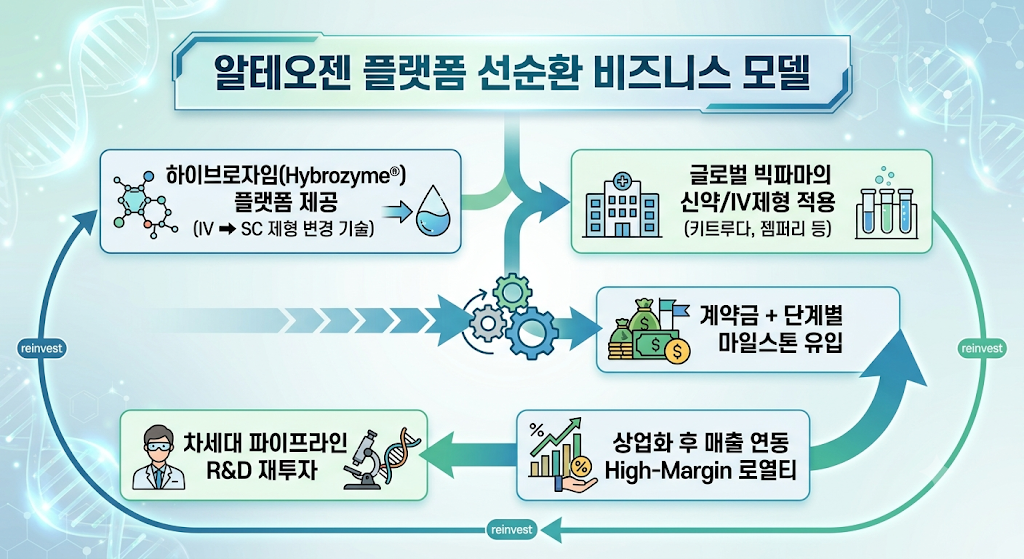
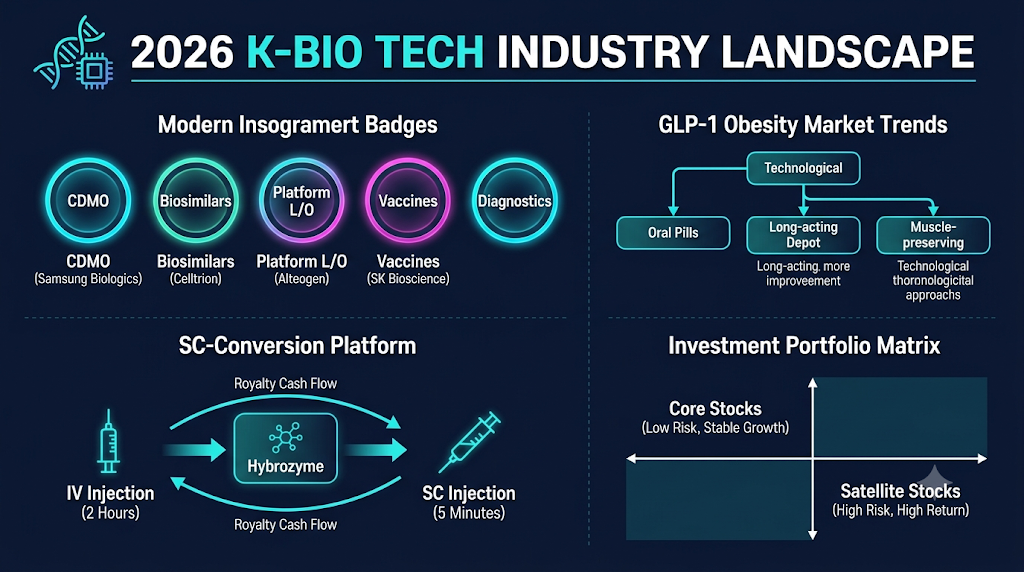
    2026 K-바이오 Tech Industry Landscape 인포그래픽 이미지

다크 네이비 배경에 네온 시안, 틸, 마젠타 컬러 아이콘과 타이포그래피가 적용된 기술·투자 인포그래픽입니다.

상단 헤더: DNA 이중나선 및 마이크로칩 아이콘과 함께 "2026 K-BIO TECH INDUSTRY LANDSCAPE" 제목 표시

좌측 상단 (5대 핵심 축): CDMO(삼성바이오로직스), Biosimilars(셀트리온), Platform L/O(알테오젠), Vaccines(SK바이오사이언스), Diagnostics 5개 원형 발광 배지 배치

우측 상단 (GLP-1 비만치료제 트렌드): "Technological" 하위 항목으로 "Oral Pills", "Long-acting Depot", "Muscle-preserving" 3가지 기술적 접근 방식을 연결한 순서도

좌측 하단 (SC 전환 플랫폼): "IV Injection (2 Hours)"이 Hybrozyme 플랫폼 및 로열티 현금 흐름 화살표를 거쳐 "SC Injection (5 Minutes)"으로 전환되는 다이어그램

우측 하단 (투자 포트폴리오 매트릭스): "Core Stocks (Low Risk, Stable Growth)"와 "Satellite Stocks (High Risk, High Return)" 영역으로 구분된 2x2 매트릭스 그래프

    2026년 현재, 우리가 가장 주목해야 할 뜨거운 기술 혁신의 전장은 뜻밖에도 K-바이오 ‘대한민국 제약·바이오(Bio-Tech)’ 섹터입니다.

    과거 바이오 산업은 막연한 ‘꿈’과 ‘단순 기대감’만으로 주가가 폭등한 뒤, 임상 실패 공시 하나에 거품처럼 꺼져버리는 대표적인 고위험 테마주 영역이었습니다. 그러나 지금의 K-바이오 생태계는 완전히 달라졌습니다. IT 산업이 Simple Software 개발을 넘어 SaaS(Software as a Service), PaaS(Platform as a Service), 원가 절감형 팹리스(Fabless) 및 파운드리(Foundry) 모델로 고도화된 것처럼, 국내 제약·바이오 기업들 역시 ‘플랫폼 기술 라이선싱’, ‘글로벌 초격차 CDMO(위탁개발생산)’, ‘차세대 바이오시밀러 및 독점적 신약 파이프라인’을 무기로 실질적인 글로벌 현금흐름(Cash Flow)을 창출해내고 있습니다.

    2026년 상반기 동안 제약·바이오 업종은 고금리 기조의 잔상과 글로벌 투자심리 위축으로 다소 시장에서 외면받는 흐름을 보였습니다. 그러나 하반기에 들어서며 글로벌 기술이전(L/O), CDMO의 압도적 실적 신기록, ADC(항체-약물 접합체) 및 비만치료제(GLP-1) 플랫폼의 잇따른 글로벌 빅파마 인수·계약 체결 등을 바탕으로 본격적인 가치 재평가(Re-rating) 구간에 진입하고 있습니다.

    대한민국 제약·바이오 산업의 핵심 카테고리별 생태계, 2026년 최신 시장 트렌드, 그리고 핵심 대표 종목들의 펀더멘털과 중단기/장기 투자 전략을 직관적이고 밀도 있게 파헤쳐 보겠습니다.

    1. 대한민국 K-바이오 산업의 5대 핵심 카테고리 분석

    국내 제약·바이오 시장은 사업 모델과 수익 구조에 따라 매우 뚜렷하게 구분됩니다. 각 카테고리의 펀더멘털을 이해하는 것이 바이오 투자의 첫 걸음입니다.

    ① CDMO (위탁개발생산: Contract Development & Manufacturing Organization)

    바이오의약품의 개발부터 임상 시약 생산, 상업화 대량 생산까지 전 과정을 대행하는 사업 구조입니다. IT 반도체 산업의 ‘파운드리(TSMC 등)’와 매우 유사합니다.

    • 삼성바이오로직스: 글로벌 최고 수준의 생산 캡파(Capacity)를 바탕으로 고성장을 지속하고 있으며, 연간 영업이익 1조 원, 매출 4조 원을 돌파하며 대한민국 CDMO의 독보적 지위를 확립했습니다.
    • 에스티팜: RNA 치료제(siRNA, mRNA 등)의 핵심 원료인 올리고뉴클레오타이드(Oligo) CDMO 분야에서 글로벌 독점적 경쟁력을 확보하고 있는 강자입니다.

    ② 바이오시밀러 (Bio-similar: 바이오의약품 복제약)

    오리지널 바이오의약품의 특허 만료 시점에 맞춰 동등한 효능과 안전성을 입증하여 개발·판매하는 사업입니다.

    • 셀트리온: 바이오시밀러의 글로벌 선구자로, 유럽(맙테라, 허셉틴, 아바스틴, 휴미라 등)과 미국(인플렉트라, 트룩시마, 허쥬마 등)에서 잇따라 승인을 받으며 글로벌 직판망을 구축했습니다. 최근 매출 3조 5,573억 원(전년 대비 63.5% 증가)이라는 역대 최대 실적을 달성했습니다.
    • 삼성에피스홀딩스: 삼성바이오로직스 자회사로 시작해 자가면역질환 및 항암제 바이오시밀러 라인업을 세계 시장에 적극 공급하고 있습니다.
    • 알테오젠: 바이오시밀러 자체 파이프라인과 함께 피하주사(SC) 제형 변경 플랫폼을 결합하여 차별화된 가치를 창출합니다.

    ③ 신약 개발 및 플랫폼 기술 (합성 / 항암 / ADC / SC 전환)

    자체 파이프라인을 통한 혁신 신약 개발 및 독자적인 플랫폼 기술을 글로벌 빅파마에 기술이전(L/O)하는 R&D 중심 바이오텍입니다.

    • 알테오젠: 정맥주사(IV)를 피하주사(SC)로 바꾸는 하이브로자임(Hybrozyme®) 플랫폼으로 글로벌 시장을 석권하고 있습니다.
    • 리가켐바이오: 항체-약물 접합체(ADC) 분야에서 독보적인 플랫폼 기술을 보유하며 수조 원대 기술수출 성과를 이어가고 있습니다.
    • 유한양행: 비소세포폐암 치료제 ‘렉라자(레이저티닙)’의 글로벌 임상 성공과 상업화를 이끌어낸 한국형 오픈 이노베이션의 대표 모델입니다.

    ④ 백신 (Vaccine)

    전염성 질환 예방 및 치료를 위한 백신 R&D 및 위탁생산입니다.

    • SK바이오사이언스: 자체 독감, 대상포진 백신 및 코로나19 백신 개발 노하우를 바탕으로 글로벌 백신 허브로 거듭나고 있습니다.
    • GC녹십자: 전통의 혈액제제 및 백신 강자로, 최근 북미 시장 혈액제제 진출 등을 통해 체질 개선을 도모하고 있습니다.

    ⑤ 진단 및 유전체 분석 (Diagnostics)

    분자 진단, 액체 생검, 정밀 의료 데이터 분석을 수행합니다.

    • 지노믹트리: 액체생검 기반 암 조기진단 기술 전문 기업입니다.
    • 씨젠: 독자적인 시약 개발 기술과 자동화 검사 장비를 바탕으로 한 분자진단 글로벌 기업입니다.

    💡 전통 제약사의 바이오 사업 확장 트렌드

    과거 한미약품, GC녹십자, 유한양행, 종근당 등 전통 제약사들은 케미컬(합성) 의약품 중심이었으나, 최근 자체 R&D 투자와 바이오텍과의 오픈 이노베이션을 통해 신약 파이프라인을 바이오 영역으로 급격히 확장하고 있습니다. 대형 바이오 전문 기업들의 기록적인 실적 성장에 발맞추어 기존 전통 제약사 역시 체질 개선 없이는 미래 경쟁력을 담보할 수 없음을 인지했기 때문입니다.

    2. K-바이오 시장을 관통하는 2대 핵심 트렌드

    [트렌드 A] 비만치료제(GLP-1) ‘7파전’과 기술 다변화 전쟁

    2026년 글로벌 바이오 시장에서 가장 뜨거운 화두는 단연 GLP-1(글루카곤 유사 펩타이드-1) 계열 비만치료제입니다. 글로벌 비만치료제 시장 규모는 지난해 약 128억 달러(약 18조 원) 수준에서 연평균 22% 이상 고성장하여 2030년에는 1,000억 달러(약 130조 원)라는 폭발적인 규모로 확대될 전망입니다.

    세계보건기구(WHO)가 성인 장기 비만 치료에 GLP-1 사용을 권고하는 첫 글로벌 가이드라인을 발표함에 따라, 국내 제약·바이오 업계 역시 최근 JW중외제약의 가세로 ‘7파전’의 치열한 경쟁 구도가 구축되었습니다.

    1) 경구용(먹는 약) 전환 기술 — 디앤디파마텍, 일동제약

    주사제의 번거로움을 극복하기 위한 경구제형 개발이 최대 승부처로 떠올랐습니다.

    • 디앤디파마텍: 독자적인 ORALINK(경구화 플랫폼) 기술을 보유하고 있습니다. 펩타이드 약물의 낮은 체내 흡수율을 획기적으로 개선하여, 전임상에서 노보노디스크의 경구제(리벨서스) 대비 월등한 흡수율을 입증했습니다.
      • 파이프라인: DD01(GLP-1/GCG 이중작용제, MASH 치료제로 미국 임상 2상 진행 중), DD02S(경구용 비만약), DD03(삼중작용제).
      • 글로벌 M&A 성과: 미국 멧세라(Metsera)와 1조 2,000억 원 규모의 기술수출 계약을 체결하였고, 이후 멧세라가 글로벌 빅파마 화이자(Pfizer)에 인수되면서 디앤디파마텍의 기술 가치가 세계적 주목을 받게 되었습니다.
    • 일동제약 / 유노비아: 저분자 경구용 GLP-1 후보물질 ‘ID110521156’의 임상 1상에서 4주 투여 기준 명확한 체중 감량 효과를 확인하였으며, 글로벌 파트너십 강화를 추진 중입니다.

    2) 장기 지속형 주사제(Depot) & RNA 기술 — 펩트론, 올릭스

    투여 주기를 주 1회에서 월 1회, 분기 1회로 늘려 환자 편의성을 극대화하는 전략입니다.

    • 펩트론: 약물 지속형 ‘Smart Depot’ 플랫폼 기술을 바탕으로 글로벌 빅파마들과 독점적 제휴 및 라이선스 협의를 진행하고 있습니다.
    • 올릭스: 펩타이드 방식이 아닌 세포 내 유전자 발현을 직접 억제하는 siRNA(RNA 간섭) 기술을 기반으로 차세대 장기 지속형 비만 치료제를 개발 중입니다.

    3) 근육 보존형 차세대 기전 — 한미약품

    기존 GLP-1 계열 약물의 치명적 단점인 ‘근육량 감소(Muscle Loss)’를 방지하는 차별화 신약입니다.

    • 한미약품: 미국당뇨병학회(ADA 2026)에서 근육량은 유지·증가시키면서 지방만 선택적으로 감량하는 혁신 신약 후보물질 ‘HM17321’ 및 ‘HM500197’ 등 총 8건의 연구 데이터를 공개하여 뜨거운 반응을 얻었습니다.

    4) 틈새 진단 및 모니터링 — 엔젠바이오

    • 엔젠바이오: 비만약 자체 개발이 아닌, GLP-1 투약 전후 환자의 치료 반응성 및 부작용 위험성을 평가하는 유전자·혈액 진단 솔루션과 ‘한국인 GLP-1 코호트’ 데이터를 구축하며 간접 수혜 생태계를 확장하고 있습니다.

    📢 ADA 2026 학회 시사점 및 투자 주의사항

    2026년 글로벌 비만 학회의 핵심 축은 “누가 더 많이 빼는가”에서 “어떤 안전한 방식으로, 근육을 보존하며, 복약 편의성(경구제/장기 지속형)을 제공하는가”로 이동했습니다. 전문가들은 “모든 비만 관련주가 수혜를 보는 단계는 끝났으며, 독보적인 플랫폼 기술을 지닌 실질적 리더 기업과 단순 테마성을 엄격히 가려내는 옥석 가리기가 필수적”이라고 조언합니다.

    [트렌드 B] 플랫폼 기술 라이선스 아웃(L/O) 시장의 대호황

    신약 개발의 낮은 성공 확률(10% 미만)을 극복하는 바이오 비즈니스 모델이 바로 ‘플랫폼 기술 라이선싱’입니다. 대표적으로 정맥주사(IV) 제형을 피하주사(SC)로 전환하는 기술은 글로벌 빅파마들의 ‘특허 장벽 연장(Patent Cliff 방어)’과 ‘환자 편의성 증대’라는 절박한 니즈와 완벽히 부합합니다.

    기업명핵심 플랫폼기술의 본질 및 메커니즘글로벌 파트너사 및 주요 성과
    알테오젠Hybrozyme® (ALT-B4)IV 제형을 5분 이내의 SC 제형으로 전환하는 인간 히알루로니다제 효소 기술MSD(키트루다 SC), GSK(젬퍼리 SC), 바이오젠 등. 누적 L/O 12조 원 돌파
    리가켐바이오ConjuAll®항체와 약물을 정밀하게 결합시키는 차세대 ADC(항체-약물 접합체) 플랫폼얀센, 얀센 바이오텍 등과 다수의 수조 원대 글로벌 기술수출 체결
    에이비엘바이오Grabody-B뇌혈관 장벽(BBB)을 효율적으로 통과시키는 이중항체 셔틀 플랫폼사노피(Sanofi) 파킨슨병 치료제 기술수출 및 글로벌 임상 진행

    3. 심층 분석: K-바이오 대표 종목 6선 펀더멘털 분석

    1) 알테오젠 (196170): ‘플랫폼 기술 수출’의 글로벌 챔피언

    ① 기업 개요 및 비즈니스 모델

    알테오젠은 직접 위험을 안고 완제 신약을 임상 3상까지 끌고 가기보다, 글로벌 빅파마의 기존 블록버스터 의약품에 적용되는 플랫폼 기술(Hybrozyme™, NexP™, NexMab™)을 라이선스 아웃(L/O)하여 안정적인 마일스톤과 로열티를 확보하는 사업 구조를 가집니다.

    ② 핵심 기술: 하이브로자임(Hybrozyme® / ALT-B4)

    • 기술적 메커니즘: 정맥주사(IV)로 2~3시간 동안 맞아야 하는 항암제를 환자가 집이나 병원에서 5분 이내에 피하주사(SC)로 스스로 투여할 수 있게 만듭니다.
    • 킬러 애플리케이션: 세계 매출 1위 면역항암제인 MSD ‘키트루다(Keytruda)’의 SC 제형(Keytruda Qlex™)에 알테오젠 기술이 적용되었습니다. 키트루다 전체 매출 내 SC 제형 비중은 1분기 1.6%에서 2분기 5.5%로 가파르게 상승하며 시장 정착 가능성을 증명했습니다.

    ③ 2026년 기술수출 및 실적 현황

    • 2026년 주요 신규 계약:
      • 1월: GSK 자회사 테사로와 면역항암제 ‘젬퍼리’ SC 제형 개발 계약 (2억 8,500만 달러)
      • 3월: 바이오젠과 2개 품목 SC 개발 계약 (5억 7,900만 달러)
      • 상반기 추가 5,200억 원 규모 계약 달성으로 누적 기술수출 총액 12조 원 돌파
    • 2026년 1분기 실적: 매출액 716억 원, 영업이익 393억 원(영업이익률 54.9%), 순이익 713억 원 기록. (마일스톤 수령 시점 차이로 전년 동기 대비 실적 수치는 다소 감소했으나 기술 라이선스 특유의 일시적 변동성에 해당함).

    ④ SWOT 분석

    • Strength (강점): 키트루다 SC를 통해 글로벌 시장에서 완벽히 검증된 기술력, 50%를 상회하는 압도적 영업이익률.
    • Weakness (약점): 파트너사의 임상 일정 및 공시 타이밍에 따른 분기별 실적 변동성.
    • Opportunity (기회): 항암제를 넘어 면역질환, 이중항체, ADC 제형으로의 플랫폼 확장성.
    • Threat (위협): 특정 대형 파트너사(MSD) 판매 실적에 대한 초기 높은 의존도.

    2) 삼성바이오로직스 (207940): 글로벌 CDMO ‘압도적 초격차 생산력’

    ① 주요 사업 및 핵심 경쟁력

    세계 최대 규모의 바이오의약품 위탁개발생산(CDMO) 기업으로, 자회사 삼성바이오에피스를 통해 바이오시밀러 개발·판매를 병행하고 있습니다.

    • 단기 관점: 5공장의 본격 가동 및 기존 1~4공장의 가동률 최댓값 유지로 연간 매출 4조 원, 영업이익 1조 원 상회 기조를 견고하게 유지 중입니다.
    • 중장기 관점: 인구 고령화에 따른 글로벌 바이오의약품 수요 증가와 함께 대규모 캡파(Capacity)에 기반한 ‘규모의 경제’를 구현합니다. ADC 전용 생산 시설 확충 등으로 미래 먹거리를 조기 선점했습니다.

    3) 셀트리온 (068270): 바이오시밀러의 거인에서 ‘통합 헬스케어 신약사’로

    ① 주요 사업 및 핵심 경쟁력

    자가면역질환 및 항암 치료제 바이오시밀러(램시마, 트룩시마, 허쥬마, 유플라이마 등)의 세계적 강자입니다.

    • 단기 관점: 셀트리온헬스케어 합병에 따른 재고자산 평가 및 통합 법인 안정화 단계를 거쳐 영업이익률이 본격적인 정상화 궤도에 진입하고 있습니다.
    • 중장기 관점: 미국 시장 내 직접 판매(Direct Sales) 망 안정화와 피하주사 제형 자가면역질환 신약인 ‘짐펜트라(RAMSIMA SC)’의 미국 점유율 확대가 핵심 승부처입니다. 향후 면역항암제 바이오시밀러 및 ADC 신약 파이프라인 결실 시 가치 재평가가 기대됩니다.

    4) 유한양행 / 한미약품: ‘오픈 이노베이션’과 ‘R&D’ 전통 제약 강자

    ① 유한양행 (000100)

    • 핵심 성장 동력: 비소세포폐암 신약 ‘렉라자(레이저티닙)’가 존슨앤드존슨(J&J)의 리브리반트와 병용요법으로 글로벌 허가를 받아 상업화됨에 따라 지속적인 로열티 수입이 유입되고 있습니다.
    • 투자 포인트: 수령한 로열티 현금을 바탕으로 제2, 제3의 바이오텍 오픈 이노베이션 투자를 이어나가는 선순환 구조를 확립했습니다.

    ② 한미약품 (128940)

    • 핵심 성장 동력: 자체 개량·복합신약의 탄탄한 내수 매출을 기반으로, 비만·대사질환 치료제 파이프라인에서 글로벌 경쟁력을 갖추고 있습니다.
    • 투자 포인트: MSD에 기술이전한 MASH 치료제(에피노페그듀타이드)의 글로벌 임상 가속화 및 ADA 2026에서 공개된 ‘근육 보존형 비만 신약(HM17321)’ 연구 성과가 중장기 핵심 모멘텀입니다.

    5) 에이비엘바이오 (298380): ‘뇌혈관 장벽(BBB) 통과’ 이중항체 독보적 바이오텍

    ① 주요 사업 및 핵심 경쟁력

    체내 약물 전달의 최대 장벽인 BBB(Blood-Brain Barrier)를 효과적으로 통과하는 플랫폼 기술 ‘Grabody-B’를 보유한 이중항체 전문 바이오텍입니다.

    • 단기/중장기 관점: 글로벌 빅파마 사노피(Sanofi)와의 파킨슨병 치료제 글로벌 임상진척에 따른 마일스톤 유입과 함께, 알츠하이머 등 퇴행성 뇌질환 시장 성장에 따라 이중항체 플랫폼의 가치가 지속적으로 상승하고 있습니다.

    4. 총평 및 성향별 투자 전략

    [금융 관점 요약]

    관점핵심 요약 및 시장 대응 전략
    단기 관점 (6개월~1년)금리 환경 및 글로벌 M&A 기조에 민감하게 반응합니다. 실적 기반이 갖춰진 삼성바이오로직스·셀트리온이 하방 안정성을 지지하는 가운데, 확실한 기술이전(L/O) 및 임상 발표 모멘텀을 보유한 알테오젠, 디앤디파마텍 중심의 이벤트 드리븐 장세가 연출될 것입니다.
    중장기 관점 (3년 이상)바이오 산업은 ‘확률 게임’입니다. 단일 파이프라인 임상 성공에만 목을 매는 기업보다는 반복 재현이 가능한 ‘플랫폼 기술 보유 기업’과 자체 상업화 및 대량 생산 인프라를 입증한 대형주 위주로 포트폴리오를 구성해야 위험 대비 수익률을 극대화할 수 있습니다.

    🎯 투자 성향별 맞춤 포트폴리오 가이드

    1) 안정성 및 복리 성장 중시형 🛡️

    • 추천 종목: 삼성바이오로직스, 셀트리온
    • 전략: CDMO 생산 능력 및 바이오시밀러 글로벌 직판망을 통한 확실한 매출/영업이익 창출. 폭발적인 단기 급등보다는 잔파도에 흔들리지 않는 포트폴리오의 탄탄한 ‘안전판(Core)’ 역할을 수행합니다.

    2) 검증된 기술력 + 고마진 로열티 선호형 ⚖️

    • 추천 종목: 알테오젠
    • 전략: 키트루다 SC 승인 및 상업화로 이미 기술적 검증이 끝난 상태입니다. 지속적인 추가 기술수출 공시 흐름이 단기 모멘텀을 제공함과 동시에, 상업화에 따른 로열티 유입으로 고마진 실적이 뒷받침되는 가장 균형 잡힌 선택지입니다.

    3) 고위험 고수익(High Risk, High Return) 모멘텀 추구형 🚀

    • 추천 종목: 디앤디파마텍, 한미약품, 펩트론, 올릭스
    • 전략: 2030년 130조 원 규모로 폭성장하는 GLP-1 비만치료제 시장의 핵심 수혜주입니다.
      • 디앤디파마텍: 경구용 비만약 플랫폼(ORALINK) 및 화이자/멧세라 파트너십이라는 강력한 스토리가 있으나, 임상 데이터 공개 및 공시 일정에 따라 주가 변동성이 극심하므로 임상 학회 일정(EASL, ADA 등)을 사전에 점검하는 캘린더 매매 전략이 유효합니다.

    💡 실전 매매 전 반드시 점검해야 할 체크리스트

    1. 캐탈리스트(Catalyst) 캘린더 작성: 학회 발표일(EASL, ADA, ESMO 등), FDA 승인 예정일, 마일스톤 수령 시점 등 호재/악재가 될 수 있는 이벤트 날짜를 사전 확인하세요.
    2. 현금 소진율(Burn Rate) 및 지분 희석 리스크: 순수 바이오텍 기업의 경우 R&D 자금 조달을 위한 추가 전환사채(CB) 발행이나 유상증자 가능성이 있는지 재무제표를 필히 체크하세요.
    3. 체크리스트 기반 분산 투자: ‘대형 실적주(코어) 60% + 플랫폼/비만 모멘텀주(위성) 40%’와 같이 비중을 배분하여 특정 단일 파이프라인 임상 실패에 따른 리스크를 방어하세요.

    ⚠️ 책임 한계 고지 (Disclaimer)

    본 포스팅은 IT 및 경제 분석 블로거로서 시장 현황과 공개된 기업 데이터를 바탕으로 작성한 참고용 정보이며, 특정 종목에 대한 투자 권유나 추천이 아닙니다. 바이오 주식은 임상 결과 및 정책 변화에 따라 극심한 변동성을 동반하므로, 모든 투자의 최종 판단과 책임은 투자자 본인에게 있습니다.

    관련 기사:

    https://economist.co.kr/article/view/ecn202608260047

  • [2026.08.26] 2026년 대한민국 로봇 산업 지형 분석

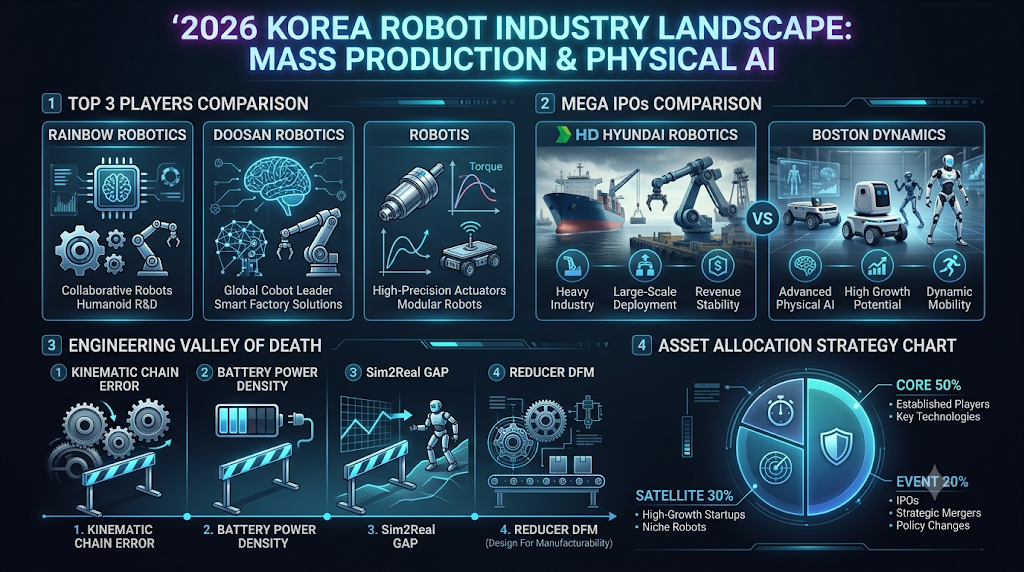
    로봇 산업 이미지
상단 타이틀 (Header Banner)Title: 2026 KOREA ROBOT INDUSTRY LANDSCAPE: MASS PRODUCTION & PHYSICAL AISubtitle: From Lab Prototype to Mass Production (10,000+ Units) & Physical AIKey Stats: 대기업(삼성, 현대, LG) 시너지 및 메가 IPO 기업가치(최대 30조 원) 강조SECTION 1: TOP 3 대장주 기술 비교 (Key Technology Vectors)Rainbow Robotics (277810.KQ): 부품/액추에이터 100% 내재화, 삼성전자 반도체/공장 무인화 라인 실증Doosan Robotics (454910.KS): 엔비디아 Isaac 기반 Physical AI & 대화형 모션 제어, 북미 OnExia 인수 B2B 확장ROBOTIS (108490.KQ): Dynamixel 액추에이터 수직계열화(매출 98%), 테슬라/구글 등 글로벌 공급망 확보SECTION 2: 메가 IPO 비교 (Mega IPOs Comparison)HD Hyundai Robotics (HD현대그룹): KRX 상장 추진, 기업가치 ~1.8조 원, 산업용 로봇 대량양산Boston Dynamics (현대차그룹): NASDAQ 상장 목표, 기업가치 ~30조 원, All-Electric Atlas 및 지배구조 개편 수혜SECTION 3: 양산 4대 엔지니어링 장벽 (Engineering Valley of Death)Kinematic Chain Error ($\theta = 0.01^\circ$): 관절 유격 누적에 따른 오차 ➔ Auto-calibrationBattery Density & Power Limit ($P_{peak} > 1\text{kW}$): 전력 소모 한계 ➔ 초고속 배터리 스왑Sim2Real Gap: 시뮬레이션-실제 현장 마찰/진동 차이 ➔ 비선형 운동량 보정 알고리즘Reducer Yield & DFM: 감속기 열처리 및 백래시 최소화 수율 확보SECTION 4: 자산 배분 전략 (Asset Allocation Strategy)Core (50%): Rainbow Robotics, ROBOTIS (부품 내재화를 통한 높은 GPM)Satellite (30%): Doosan Robotics, Neuromeka (AI 모션 제어 및 RaaS 스케일링)Event-Driven (20%): Boston Dynamics, HD Hyundai Robotics (대규모 Captive Market 보유)

    1. 2026년 대한민국 로봇 산업, 피지컬 AI와 양산(Mass Production)의 시대로

    2026년 8월 현재, 글로벌 및 국내 로봇 산업은 단순한 단순 반복 작업용 협동로봇이나 데모용 시제품 개발 단계를 지나, ‘피지컬 AI(Physical AI)’와 ‘10,000대 단위 공장 대량생산(Mass Production)’이라는 본격적인 산업화 국면에 진입했습니다.

    정부는 ‘AI 자율 제조 선도 프로젝트’를 통해 26개 주요 제조 대기업에 3.7조 원의 자금을 투입하여 무인화 실증을 가속화하고 있으며, 2030 지능형로봇 기본계획에 따른 민관 투자 정책 모멘텀도 공고합니다. 그러나 투자자의 관점에서는 “과연 어떤 기업이 단순 뉴스 모멘텀을 넘어 실제 납품 공시와 흑자 대량생산 라인을 구축할 수 있을인가?”를 냉철하게 판가름해야 할 시점입니다.

    본 포스팅에서는 국내 주식시장을 이끄는 3대 대장주와 부품주, 그리고 IPO 시장의 최대 대어인 HD현대로보틱스와 보스턴 다이내믹스의 기술 축을 깊이 있게 비교 분석하고, 양산 장벽과 포트폴리오 가이던스를 제시합니다.

    2. 국내 로봇 3대 대장주 심층 분석 및 기술적 축 비교

    ① 레인보우로보틱스 (277810, 코스닥)

    • 기업 역사 및 정통성: KAIST 휴보랩 출신 연구진이 2011년 설립하였으며, 대한민국 최초 이족보행 휴머노이드 ‘휴보(HUBO)’의 원천 기술 계보를 잇고 있습니다.
    • 핵심 강점 (구동부 100% 내재화): 완제품 제조업체가 모터, 감속기, 제어기(FOC 드라이버), 엔코더, FT센서를 직접 자체 설계·제조합니다. 외부 구동계 구매 대비 원가를 40~50% 이상 절감할 수 있는 파괴적인 원가경쟁력을 보유하고 있습니다. 양팔 이동형 로봇인 RB-Y1은 연구용 9,000만 원, 상업용 1.3억 원 수준에 판매 중이며, 쿠팡 물류센터 시범 투입 등 실증 단계에 진입했습니다.
    • 삼성전자 자회사 편입 및 시너지: 삼성전자는 2023년 초 868억 원(14.7%) 투자를 시작으로, 2024년 말 콜옵션을 행사해 지분 35%를 확보하여 최대주주 및 연결 자회사로 편입시켰습니다. 삼성의 거대 자본력, 반도체·전자제품 제조 공장의 무인화 테스트베드, 그리고 삼성 AI 알고리즘과의 결합이 주가 프리미엄의 핵심 동인입니다.
    • 리스크 요인: 삼성전자의 지분 인수 과정에서 발생한 미공개 정보 이용 주식 거래 의혹으로 검찰 압수수색 조사가 진행 중인 점은 단기 수급 변동성을 키우는 리스크 요소입니다.

    ② 두산로보틱스 (454910, 유가증권시장)

    • 글로벌 입지 및 기술 전환: 글로벌 협동로봇 시장 3위권의 입지를 바탕으로 기존 협동로봇에서 ‘산업용 휴머노이드’로의 사업 대전환을 추진 중입니다.
    • AI 소프트웨어 & 피지컬 AI: 엔비디아(NVIDIA) Isaac 플랫폼 기반 차세대 모션제어 기술을 개발하고 있으며, 센서 전문기업 에이딘로보틱스와 피지컬 AI 구현 MOU를 체결했습니다. CES 2026에서는 AI 하역 솔루션으로 AI 분야 최고 혁신상을 수상했습니다. 자연어 지시(Natural Language Prompt)만으로 이틀 만에 자동화 구축이 가능해, 기존 상자 크기·위치 변경 시마다 일일이 재코딩해야 했던 산업용 로봇의 고질적 한계를 극복했습니다.
    • 북미 시장 확장 & 재무 리스크: 최근 미국 자동화 기업 ‘원엑시아(OnExia)’를 356억 원에 인수하며 북미 거점을 확대 중입니다. 다만 주가수익스왑(PRS) 잔여 물량 소진 문제와 높은 판관비로 인한 영업적자 구조가 상단을 제한하고 있습니다.

    ③ 로보티즈 (108490, 코스닥)

    • 액추에이터 수직계열화: 매출의 98% 이상이 로봇 관절용 액추에이터 브랜드인 ‘다이나믹셀(Dynamixel)’에서 발생하는 부품 수직계열화의 선두주자입니다. 테슬라(Optimus), 구글, 유니트리 등 글로벌 탑티어 로봇 개발사들에 액추에이터를 공급 중입니다. LG전자가 2대 주주로 협력하고 있으며, 로보티즈의 로봇 손 부품이 LG 클로이(CLOi) 플랫폼에 탑재됩니다.
    • 2026 풀스택 쇼케이스: 2026 세계로봇대회에서 휴머노이드 ‘AI 사피엔스’, 세미 휴머노이드 ‘AI 워커’, 로봇 핸드, 신규 액추에이터 ‘다이나믹셀-Q’를 선보인 국내 유일의 참가 기업이었습니다. 2025년 액추에이터 판매량 22만 개에서 2026년 40~50만 개, 2027년 100만 개 이상으로 가파른 양산 스케일업을 증명하고 있습니다.

    3. 중소형 협동로봇 및 핵심 부품/RaaS 생태계 밸류체인

    3대 대장주 외에도 국내 로봇 산업은 탄탄한 부품 및 서비스 밸류체인을 형성하고 있습니다.

    • 뉴로메카 (348340): 협동로봇 ‘Indy’, 자율이동로봇(AMR) ‘Moby’를 보유하고 있으며, 현대로보틱스에 협동로봇을 OEM/ODM 공급합니다. 구독형 리스·월정액 방식의 RaaS(Robot as a Service) 자동화 모델을 가동하여 중소 제조업체의 초기 자동화 도입 장벽을 크게 낮췄습니다.
    • 유일로보틱스 & 티로보틱스: 산업용 취출 로봇 및 물류 자동화 반송 시스템(AGV/AMR) 분야에서 대기업 제조 라인 투입을 늘려가고 있습니다.
    • 에스비비테크 & 삼익THK: 로봇 관절의 필수 부품인 정밀 감속기(하모닉 드라이브 국산화) 및 LM가이드 분야에서 국산화율을 높이며 핵심 원가 절감의 열쇠를 쥐고 있습니다.

    4. 로봇 시장 최대 변수: HD현대로보틱스 vs 보스턴 다이내믹스 IPO

    2026~2027년 시장의 전체 수급을 흡수할 최대 대어급 비상장 기업은 HD현대로보틱스와 보스턴 다이내믹스입니다. 투자 시 두 기업의 소속과 성격을 정확히 정정하고 이해해야 합니다.

    ⚠️ [오해 정정] 보스턴 다이내믹스 ≠ HD현대 계열

    많은 투자자들이 ‘현대’라는 이름 때문에 두 기업을 혼동하지만, 두 곳은 2002년 계열 분리된 완전히 다른 기업집단입니다.

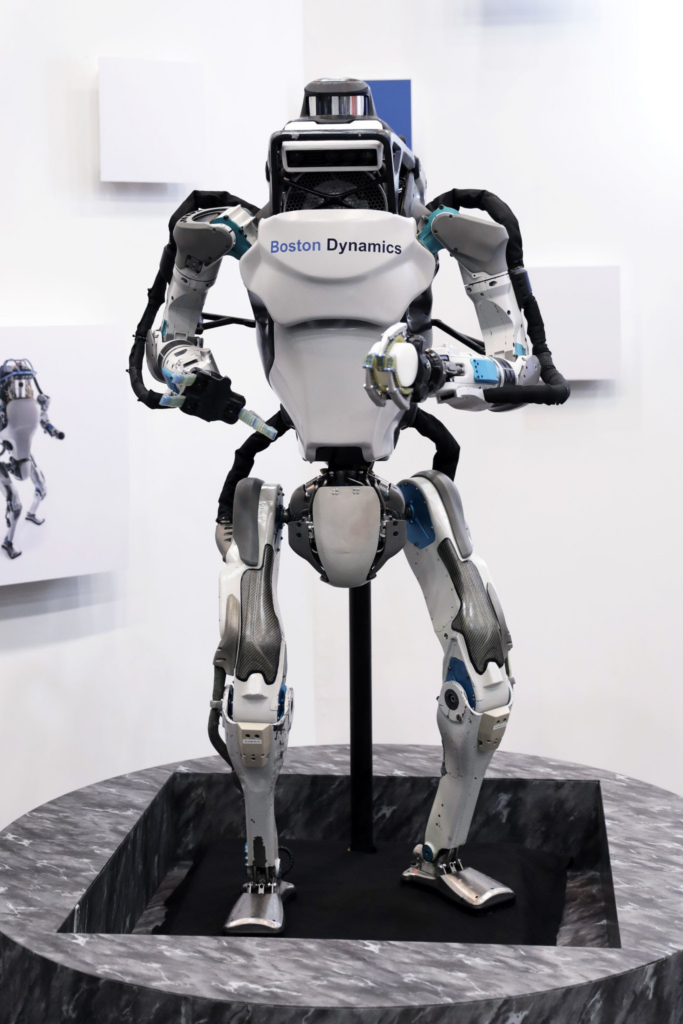
    • 현대자동차그룹 (정의선 회장): 보스턴 다이내믹스(Boston Dynamics) 보유. 대표작: 전동식 휴머노이드 ‘올 뉴 아틀라스(Atlas)’, 4족 보행 ‘스팟(Spot)’.
    • HD현대 (옛 현대중공업그룹): HD현대로보틱스 보유. 국내 1위 산업용 로봇 제조업체.

    ① HD현대로보틱스 IPO: 중복상장 이슈 돌파와 산업용 거함의 출범

    • 기업가치 및 투자 유치: 2025년 10월 KDB산업은행 등으로부터 1,800억 원 규모의 프리IPO를 유치하며 기업가치 약 1.8조 원을 인정받았습니다.
    • 중복상장 논란과 속도조절: 지주사인 HD현대가 이미 상장된 상태에서 알짜 자회사를 상장할 경우 지주사 주주가치가 훼손된다는 ‘중복상장 논란’으로 주관사단이 일시 철수하기도 했습니다. 그러나 2026년 7월 정부의 중복상장 가이드라인 발표 후 새 기준으로 예비심사를 통과하는 사례들이 속출하면서 상장 재추진 동력이 회복되었습니다. 상장 성사 시 국내 최대 산업용 로봇 양산 자금을 확보하게 됩니다.

    ② 보스턴 다이내믹스 IPO: 30조 원 밸류에이션, 전동식 전환, 지배구조 개편

    • 지분 구조 및 IPO 압박: 2021년 현대차그룹이 소프트뱅크로부터 지분 80%를 약 6,600억 원에 인수했습니다 (그룹 계열사 60%, 정의선 회장 사재 2,490억 원 투입으로 개인 지분 20% 보유). 소프트뱅크와의 상장 약속 기한 및 2026년 6월 풋옵션 만료 시점(소프트뱅크의 9.5% 지분 매각 권리)에 따라, 현대차그룹은 2026년 하반기~2027년 초 나스닥 상장을 목표로 서두르고 있습니다.
    • 30조 원 기업가치와 지배구조 함의: 증권가 추정 기업가치는 약 29.7조~30조 원입니다. 현대차그룹의 순환출자 구조(현대차→기아→모비스→현대차) 해소를 위해 정몽구 명예회장(7.38%)과 기아(17.9%)의 현대모비스 지분을 정의선 회장(0.33%)이 매입해야 하는데, 보스턴 다이내믹스 나스닥 상장을 통해 확보되는 정 회장의 현금이 이 지배구조 개편의 핵심 실탄으로 사용될 전망입니다.
    • 기술적 진화 (전동식 아틀라스): 과거 유압식(Hydraulic) 아틀라스의 누수와 전력 소모 한계를 극복하고, 순수 전동식 모터 기반의 ‘올 뉴 아틀라스(All-Electric Atlas)’를 완성했습니다. 관절마다 360도 연속 회전이 가능한 회전식 액추에이터를 적용하여 인간의 가동 범위를 뛰어넘었습니다. 테슬라 옵티머스 개발 주도자인 밀란 코박을 영입하여 VLA(Vision-Language-Action) AI 모델 결합을 속도감 있게 추진 중입니다.
    • 경영진 이탈 리스크: 상장을 앞두고 CEO를 포함한 핵심 수석 연구진의 연쇄 퇴사가 발생했습니다. 이는 연구소 중심 문화에서 현대차 완성차 생산 라인 스타일의 DFM(양산 단가 절감 및 공정 자동화) 체제로 전환하는 과정에서 발생한 진통으로 풀이됩니다.

    📊 대장주 및 IPO 대어 종합 기술/지배구조 비교표

    기업명소속 그룹시장 (상장 여부)추정 몸값핵심 기술 축주요 사업 방향 및 리스크
    레인보우로보틱스삼성전자코스닥 (旣상장)약 9.7조 원구동부 100% 내재화, 전신 동역학삼성 반도체/물류 공장 무인화 실증, 미공개정보 수사 리스크
    두산로보틱스두산그룹유가증권 (旣상장)약 4~5조 원고정밀 토크제어, AI 모션제어협동로봇→산업용 휴머노이드, 북미 인수(원엑시아), PRS 오버행
    로보티즈LG전자(2대주주)코스닥 (旣상장)약 1.5~2조 원액추에이터(다이나믹셀) 모듈화B2B 부품 글로벌 표준화 + 완제 휴머노이드 수직계열화
    HD현대로보틱스HD현대유가증권 (예심 준비)약 1.8조 원산업용 로봇 대량 양산 기술조선/건설기계 무인화, 중복상장 논란 해소 국면
    보스턴 다이내믹스현대차그룹미국 나스닥 (예정)약 30조 원전동식 관절, 초고속 동적 균형 제어현대차 공장 무인화 투입, 정의선 회장 모비스 지분 매입 재원

    5. 양산으로 넘어갈 때 부딪히는 4대 핵심 기술 장벽

    연구실에서 숙련된 엔지니어가 1~2대의 로봇을 맞춰서 구동시키는 퍼포먼스 쇼케이스와, 공장 양산 라인에서 동일한 품질의 로봇 10,000대를 생산하는 것은 전혀 다른 영역입니다.

    [로봇 양산 진입 장벽 4대 요소]
      ├─ 1. 부품 공정 오차의 누적 (Kinematic Chain Error)
      ├─ 2. 배터리 에너지 밀도 및 전력 관리(1kW peak소모&배터리 스왑)
      ├─ 3. Sim2Real Gap (가상 시뮬레이션과 실제 환경의 마찰력 격차)
      └─ 4. 감속기 소재 열처리 및 DFM 수율

    ① 부품 공정 오차의 누적 (Kinematic Chain Error)

    로봇 관절은 12자유도에서 30자유도 이상이 직렬/병렬 키네마틱 체인(Kinematic Chain)으로 이어집니다. 단일 관절 축에서 발생한 $\theta = 0.01^\circ$의 미세한 공정 유격이나 백래시는 손끝(End-effector)이나 발끝에 도달하면 수 mm의 치명적 오차로 누적됩니다. 시제품은 사람이 일일이 교정(Calibration)하지만, 양산품은 소프트웨어 기반의 Auto-calibration(자동 교정) 시스템이 작동하지 않으면 불량률이 폭증합니다.

    ② 배터리 밀도 및 전력 관리 한계

    70~80kg 중량의 이족보행 휴머노이드가 발을 디디고 무게중심을 잡는 데만 순간 전력 소모가 $P_{peak} > 1\text{kW}$를 초과합니다. 현존 리튬이온 배터리 밀도로는 2~3시간 연속 작동이 한계입니다. 공장 3교대 무인 라인을 가동하려면 하드웨어에 초고속 자동 배터리 스왑(Swapping) 메커니즘과 초고효율 FOC 드라이버 파워트레인이 내재화되어야만 상업성이 확보됩니다.

    ③ Sim2Real Gap (가상 환경과 실제 물리 환경의 격차)

    엔비디아 Isaac Sim이나 MuJoCo 같은 가상 물리 시뮬레이터에서 수억 번의 강화학습을 수행한 비전 AI 모델도, 실제 공장 바닥의 기름때, 불규칙한 바닥 유격, 외부 진동을 만나면 충격을 회피하지 못하고 밸런스를 잃고 무너집니다. 가상과 현실 간의 physics 파라미터 격차인 Sim2Real Gap을 완벽히 메우는 비선형 모멘텀 보상 알고리즘이 양산의 성패를 가릅니다.

    ④ 감속기 소재 열처리 및 DFM 수율

    로봇 관절의 핵심 부품인 정밀 감속기(하모닉/사이클로이드)는 특수강 표면 열처리 기술과 나노 미터급 가공이 결합되어야 합니다. 연속 운용 시 발생하는 마모와 열변형을 견뎌내며, 10만 회 이상 동작 후에도 치수 안정성을 유지하는 양산 수율을 확보하는 것이 국산화 단가 절감(DFM)의 마지막 관문입니다.

    6. 증권가 애널리스트 관점: 단기 및 중장기 투자가이던스 & 포트폴리오 비중

    📉 단기 관점 (1~2년): “실적 공백기 속 이벤트 드라이븐 대응”

    단기적으로 로봇 기업들은 여전히 당장의 본업 영업이익이 미미하거나 적자 상태인 경우가 많습니다. 따라서 실적 수치보다는 대기업 자금 투입, 납품 공시, 대형 IPO 이벤트에 반응하는 주가 흐름을 보입니다.

    • 레인보우로보틱스: 삼성향 정식 양산 공시가 주가 상승의 핵심 촉매이나, 고평가 구간이므로 사법 리스크에 따른 조정 시 분할 매수 대응이 유효합니다.
    • 두산로보틱스: 오버행(PRS) 물량 소진 및 영업적자 축소 전환 여부를 확인하며 보수적으로 접근합니다.
    • 로보티즈: 테슬라·구글·유니트리 등 글로벌 탑티어향 액추에이터 판매량이 늘어나며 가장 먼저 부품 실적이 숫자로 증명될 실적 수혜주입니다.

    📈 중장기 관점 (3~5년+): “DFM과 수직계열화를 이뤄낸 승자독식”

    3년 이상의 긴 호흡에서는 기술 쇼케이스 기업은 도태되고, ‘자체 부품 내재화를 통한 마진율(GPM) 보장 기업’과 ‘자체 공장 테스트베드(Captive Market)를 가진 기업’만이 살아남아 시장을 독식할 것입니다.

    [중장기 로봇 승자 결정 메커니즘]
    기술 연구 및 시제품 성공 (현재)
      └── 10,000대 단위 양산 및 DFM(단가 절감) 성공 여부
            ├── 실패: 천문학적 적자로 도태 (연구소형 기업)
            └── 성공: B2B 공급망 락인(Lock-in) 및 흑자 대량생산

    💼 추천 포트폴리오 구성안

    구분추천 비중해당 기업핵심 투자 포인트
    코어 (Core) 자산50%레인보우로보틱스, 로보티즈구동부 100% 내재화 및 B2B 부품 표준화 선점. 양산 국면에서 압도적인 마진율(GPM) 유지 가능.
    위성 (Satellite) 자산30%두산로보틱스, 뉴로메카AI 소프트웨어 모션 제어(NVIDIA 협력) 및 RaaS 구독형 자동화 모델의 높은 확장성 기대.
    이벤트 / 대형주20%보스턴 다이내믹스, HD현대로보틱스현대차 및 HD현대 그룹이라는 대규모 자체 공장(Captive Market) 보유. 상장 시 섹터 재평가 주도.

    7. 결론 및 요약

    2026년 대한민국 로봇 산업은 1990년대 PC 보급기, 2000년대 스마트폰 초기 도입기와 매우 유사한 패러다임 전환을 겪고 있습니다.

    단기적으로는 뉴스나 정책 테마에 따른 널뛰기 장세가 연출될 수 있지만, 본질은 명확합니다. 투자자는 시제품의 일시적인 퍼포먼스에 현혹되기보다 “자체 부품 수율을 잡아 원가를 낮추고(DFM), 공장에서 만 단위로 안정적으로 찍어낼 수 있는 생산 기술과 실증 현장을 가진 기업”을 장기적으로 모아가는 전략이 결국 가장 높은 수익률로 보상받게 될 것입니다.

    관련 기사

    https://n.news.naver.com/mnews/article/422/0000899190

  • [2026.08.25] 엔비디아 그록3(Groq3) LPX 랙 양산과 AI 반도체 패러다임의 대전환: SRAM vs HBM 구조 분석 및 밸류체인 투자 전략

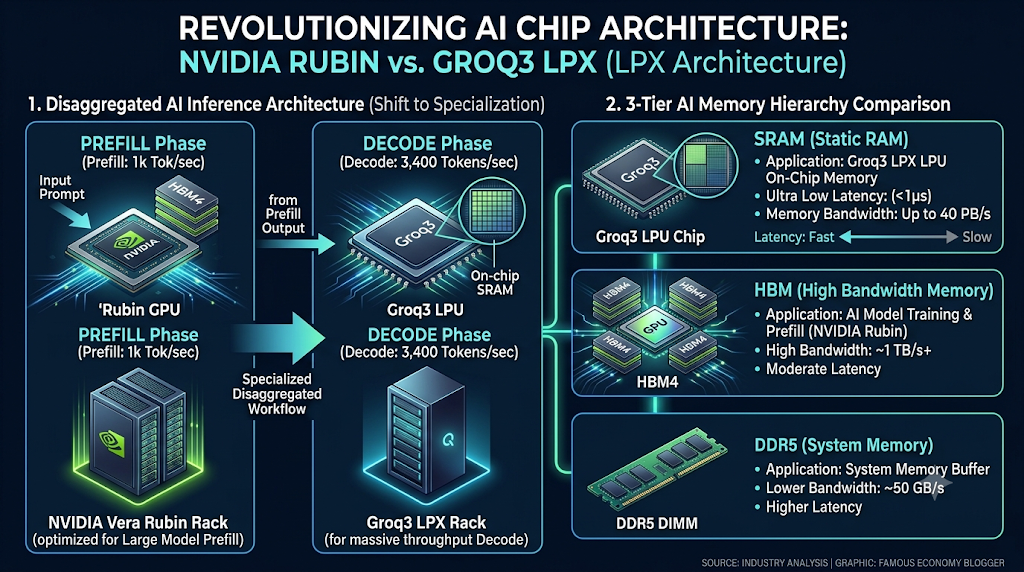
    엔비디아 그록랙 구조
디스어그리게이티드 추론 구조 (Disaggregated AI Inference Architecture)

Rubin GPU (HBM4): 입력 데이터 분석 및 문맥 파악을 전담하는 Prefill 단계

Groq3 LPU (On-chip SRAM): 초당 3,400 토큰 생성을 전담하는 초저지연 Decode 단계

3단계 메모리 계층 구조 비교 (3-Tier Memory Hierarchy)

SRAM: Ultra Low Latency / 40 PB/s Bandwidth (실시간 순차 토큰 생성)

HBM: High Bandwidth / Large Capacity (학습 및 병렬 연산)

DDR5: System Memory Buffer (대용량 KV 캐시 및 백업)

디자인 톤앤매너: 글로벌 테크 및 금융 분야에 어울리는 다크 네이비 & 네온 블루/그린 아키텍처 비주얼로 완성되었습니다.

    📌 엔비디아 그록3 LPX Executive Summary

    1. 역대 최대 라이선스 계약의 상용화: 엔비디아가 200억 달러(약 27조 원) 규모의 라이선스 계약으로 확보한 그록(Groq) 기술 기반 ‘그록3 LPX’ 랙 양산에 돌입했습니다. 네오클라우드 네비우스(Nebius) 데이터센터에 베라 CPU, 루빈 GPU와 함께 첫 배치되며 올해 말 가동됩니다.
    2. 추론 시장의 게임 체인저 (Disaggregated Architecture): 프롬프트 입력(Prefill)은 고성능 GPU(루빈)가, 실시간 응답 토큰 생성(Decode)은 초저지연 SRAM 기반 LPU(그록3)가 분담하는 ‘디스어그리게이티드(분산) 추론’이 본격 적용됩니다.
    3. 압도적인 초저지연 성능: Gemma 4 31B 모델(10만 토큰 컨텍스트) 기준 초당 3,400 토큰을 처리하며, 경쟁사 대비 최대 4배 빠른 반응성을 확보하여 실시간 AI 코딩 및 에이전트 서비스의 핵심으로 부상했습니다.
    4. 투자의 패러다임 변화: ‘GPU + HBM’ 단일 공식에서 벗어나 SRAM, 비메모리 OSAT/테스트, 대면적 FC-BGA 기판, CPO(광반도체), 데이터센터 전력 인프라 중심으로 수혜주 밸류체인이 이동합니다.

    1. 서론: AI 데이터센터 시장의 미세 균열과 대변혁의 시작

    AI 반도체 시장을 수년간 지배해 온 패러다임은 명확했습니다. “더 커다란 GPU에 더 넓은 대역폭의 HBM(고대역폭 메모리)을 부착하여 거대한 단일 클러스터로 묶는다.” 이 공식은 거대언어모델(LLM)의 사전 학습(Training) 및 대규모 컨텍스트 입력 처리에는 최적의 성능을 발휘해 왔습니다.

    하지만 AI 시장의 중심축이 단순 모델 개발과 학습을 넘어 실질적인 상용 서비스, 즉 ‘AI 에이전트(AI Agent)’, ‘실시간 자율 코딩’, ‘초저지연 대화형 AI’ 형태의 추론(Inference) 단계로 빠르게 이동함에 따라 기존 GPU 단일 구조의 치명적인 한계가 드러나기 시작했습니다.

    가장 큰 문제는 바로 ‘디코드(Decode) 단계에서의 메모리 병목 현상’입니다. AI 모델이 응답 토큰을 하나씩 순차적으로 생성할 때, GPU 내부 연산기(ALU)는 일거리가 부족해 노놀 정도로 놀고 있는 반면, 외부 메모리에서 파라미터 가중치를 지속적으로 읽어오는 과정에서 거대한 연산 지연(Latency)이 발생합니다. 이는 곧 서비스 운영 비용의 증가와 사용자 경험의 저하로 직결됩니다.

    이러한 상황에서 글로벌 AI 반도체 대장주인 엔비디아(NVIDIA)가 마침내 파격적인 카드를 꺼내 들었습니다. 지난해 12월 사상 최대 규모인 200억 달러(약 27조 원)를 들여 인수한 초저지연 추론 칩 스타트업 ‘그록(Groq)’의 기술을 마침내 자사의 차세대 데이터센터 플래그십 아키텍처인 ‘베라 루빈(Vera Rubin)’ 플랫폼의 전용 추론 가속 랙인 ‘그록3 LPX(Groq3 LPX)’ 형태로 상용화 및 본격 양산에 들어갔다고 공식 발표했습니다.

    2. 엔비디아의 결단: 200억 달러 거래의 결실, 그록3 LPX 양산 본격화

    엔비디아는 네오클라우드(Neo Cloud) 주요 공급업체인 네비우스(Nebius)의 데이터센터를 시작으로 그록3 LPX 랙 배치를 개시했다고 밝혔습니다. 이번 배치는 엔비디아의 차세대 CPU인 ‘베라(Vera)’ 및 차세대 flagship GPU인 ‘루빈(Rubin)’과 함께 병렬 결합 형태로 이루어지며, 올해 말 본격적인 가동을 앞두고 있습니다.

    엔비디아 최고경영자(CEO) 젠슨 황(Jensen Huang)은 지난 3월 베라루빈 및 그록3 LPX 공개 행사에서 다음과 같이 선언한 바 있습니다.

    “코딩 및 초저지연 애플리케이션을 위해 마련된 데이터센터 공간의 최소 4분의 1(25%)을 그록 랙에 할당하고, 나머지 75%는 100% 베라루빈 NVL72 GPU 시스템으로 채울 것입니다.”

    이는 단순한 단일 칩 세일즈가 아니라 데이터센터 전체 공간과 전력 배분을 철저히 워크로드 성격에 맞춰 재구성하겠다는 의지입니다.

    💡 엔지니어링 인사이트: 왜 네오클라우드 네비우스인가?

    네비우스와 같은 네오클라우드 업체들은 기존 빅테크(Hyperscaler)와 달리 최신 AI 추론 워크로드를 유연하게 수용하고, 토큰당 최고 단가를 매길 수 있는 프리미엄 API 서비스(Token Factory)를 서비스화하는 데 집중합니다. 디온 해리스 엔비디아 AI 인프라 책임자가 언급했듯, 초저지연 토큰 생성 능력은 코딩 에이전트, 실시간 음성 통화 API 등에서 사용자에게 고가의 프리미엄 서비스 요금을 부과할 수 있는 핵심 차별화 요소가 됩니다.

    3. 그록3 LPX 랙의 기술 스펙 및 하드웨어 구성 심층 분석

    엔비디아가 공개한 그록3 LPX 랙의 실제 하드웨어 스펙은 반도체 엔지니어링 관점에서 대단히 파격적인 수치들로 가득 차 있습니다. 정밀 검증된 칩 단위 및 랙 단위의 세부 하드웨어 명세는 다음과 같습니다.

    3.1. LPU 칩 단위 vs LPX 랙 단위 하드웨어 스펙 비교

    그록의 핵심 가속기인 LPU(Language Processing Unit)는 고속 연산 장치와 온칩 SRAM이 1:1로 밀접하게 결합된 특수 목적용 반도체(ASIC)입니다. 1개의 LPU 칩에는 500메가바이트(MB)의 SRAM이 고밀도로 적층되어 있으며, 칩 내부 대역폭은 초당 150테라바이트(TB/s)에 달합니다. 엔비디아는 이 LPU 칩 256개를 단일 LPX 랙 안에 상호 초연결망으로 집적시켰습니다.

    구분 항목칩(LPU) 1개 단위랙(LPX) 전체 (256개 LPU)기술적 의의 및 비고
    SRAM 용량 (On-chip)500 MB128 GB외부 DRAM 경유 없이 칩 내에서 초고속 처리
    SRAM 내부 대역폭150 TB/s40 PB/s (40,000 TB/s)지연시간(Latency)을 피코초(ps) 수준으로 축소
    스케일업(Scale-up) 대역폭2.5 TB/s640 TB/s256개 칩을 단일 논리 메모리로 묶는 상호연결망
    DDR5 보조 시스템 메모리–12 TB대규모 컨텍스트 및 KV 캐시 오프로드 백업용

    ※ 기사에 언급된 “5억 MB SRAM”은 오기이며, 실제 스펙은 칩당 500MB, 랙 전체(256개 칩) 기준 128GB SRAM이 정확한 수치입니다.

    128GB라는 용량이 숫자로만 보면 HBM(수 TB 단위) 대비 작아 보일 수 있으나, 초당 40페타바이트(PB/s)라는 압도적인 대역폭이 조합됨으로써 순차 토큰 생성 속도에서 비교 불가능한 성능을 발휘하게 됩니다.

    3.2. 벤치마크 성능: Gemma 4 31B 및 실시간 작업에서의 성능 혁신

    독립 AI 벤치마크 평가 기관인 아티피셜 애널리시스(Artificial Analysis)의 최신 테스트 결과에 따르면, 그록3 LPX 랙 시스템에서 Gemma 4 31B 모델을 100,000(10만) 토큰의 컨텍스트 환경에서 실행했을 때, 초당 3,400 출력 토큰(Tokens/sec)이라는 처리 속도를 기록했습니다.

    이는 현재 시장에 존재하는 어떠한 동일 규모 GPU 클러스터 랙과 비교해도 최대 4배 이상 빠른 응답성(Responsiveness)입니다. 인간이 1초에 읽을 수 있는 글자 수가 대략 10~20 토큰 수준임을 감안할 때, 초당 3,400 토큰은 인간의 인지 속도를 완전히 초월한 수치이며, 대규모 소스 코드를 실시간으로 분석하고 수정안을 즉시 반환해야 하는 ‘에이전틱 AI 코딩 워크로드’에서 절대적인 위력을 발휘합니다.

    4. 데이터센터 아키텍처의 격변: 디스어그리게이티드(Disaggregated) 추론의 등장

    4.1. 베라 루빈(Vera Rubin) 모듈식 랙 생태계에서의 위치

    그록3 LPX 랙은 독립 제품이 아니라 엔비디아가 새롭게 제시하는 베라 루빈(Vera Rubin) 랙 스케일 토탈 인프라를 구성하는 5가지 핵심 목적별 랙 중 하나로 완벽히 통합 배치됩니다.

    • 베라루빈 NVL72 GPU 랙: 대규모 연산 및 모델 학습, 입력 프리필(Prefill) 전담
    • 베라 CPU 랙: 데이터센터 전체 관리, 오케스트레이션 및 파이프라인 스케줄링
    • 그록3 LPX 추론 가속 랙: 초저지연 디코드(Decode) 및 순차 토큰 생성 전담
    • 블루필드-4 STX 스토리지 랙: 데이터 초고속 I/O 및 보안 오프로드
    • 스펙트럼-6 SPX 이더넷 랙: 랙 간 초고속 데이터 통신 네트워크 제어

    이 시스템을 구동하기 위해 엔비디아는 베라 CPU, 루빈 GPU, NVLink 6 스위치, ConnectX-9 SuperNIC, BlueField-4 DPU, Groq3 LPU, 그리고 실리콘 포토닉스 기반 Spectrum-X CPO 스위치 등 총 7종의 신규 반도체 칩을 동시 양산 체제로 전환시켰습니다.

    4.2. 기존 동종 GPU 클러스터 vs 신규 디스어그리게이티드 구조 비교

    기존 AI 데이터센터는 동일한 동종(Homogeneous) GPU를 촘촘히 배열하고, 이 GPU 클러스터가 입력 데이터 처리(Prefill)와 출력 토큰 생성(Decode)을 순차적으로 모두 수행하는 방식이었습니다.

    🔄 워크로드 분리(Disaggregation)의 핵심 메커니즘

    LLM 추론 워크로드는 크게 두 단계로 나뉩니다.

    1. Prefill (프리필) 단계: 수천~수십만 자의 프롬프트를 한 번에 읽고 컴퓨팅하는 단계. 대규모 병렬 연산력과 고용량 메모리(HBM)가 필수적이므로 루빈 GPU가 전담합니다.
    2. Decode (디코드) 단계: 앞선 문맥을 바탕으로 단어를 한 개씩 순차적으로 생성해 나가는 단계. 연산량 자체는 적지만 매 토큰 생성마다 메모리 가중치를 읽어와야 하므로 초저지연 메모리 대역폭(SRAM)이 핵심입니다. 이를 그록 LPU가 전담합니다.

    기존에는 비싼 HBM과 수천 개의 Tensor core를 갖춘 GPU가 디코드 단계에 묶여 있으면서 메모리 병목 때문에 연산 자원을 90% 이상 놀리는 극심한 비효율이 발생했습니다. 엔비디아는 프리필과 디코드를 물리적인 랙 수준에서 분리하여, “각 작업 특성에 가장 완벽히 부합하는 프로세서와 메모리를 배치하는 분산 아키텍처”로 변혁을 완료했습니다.

    5. 메모리 반도체 3대 매체(SRAM vs HBM vs DDR5)의 역할 및 특성 비교

    AI 가속기에 사용되는 대표적인 3가지 메모리 반도체 매체의 물리적·구조적 차이점을 이해해야 향후 반도체 주식 투자의 방향성을 잡을 수 있습니다.

    구분 항목SRAM (Static RAM)HBM (High Bandwidth Memory)DDR5 (System DRAM)
    시스템 내 주요 역할LPU 온칩 초저지연 캐시/메모리GPU 대규모 병렬 연산 메인 메모리랙 단위 대용량 KV 캐시 보조 버퍼
    적용 시스템 예시그록3 LPX (칩당 500MB / 랙당 128GB)루빈, 블랙웰 NVL72 GPU 등그록3 LPX 랙 (랙당 12TB)
    대역폭 (Bandwidth)극상 (랙당 40 PB/s)상 (초당 수 TB/s 수준)중 (초당 수백 GB/s 수준)
    지연시간 (Latency)최저 (수 피코~나노초 이하)보통 (DRAM 특성상 SRAM보다 느림)높음 (버스 통신 지연 존재)
    비용 및 단가극도로 비쌈 (트랜지스터 6개/Bit)고가 (TSV 적층 및 첨단 패키징)상대적 저렴 (면적 대비 용량 큼)
    집적도 및 용량 한계매우 낮음 (칩당 MB 단위 제한)높음 (수십~수백 GB 단위)극대 (TB~PB 단위 확장 용이)

    5.1. SRAM: 그록 LPU의 초저지연을 가능케 하는 무기

    SRAM은 1비트의 데이터를 저장하는 데 6개의 트랜지스터(6T)를 사용합니다. 전원이 공급되는 동안 커패시터 재충전(Refresh) 동작이 필요 없으므로 반응 속도가 비약적으로 빠릅니다. 그록 LPU는 외부 메모리 인터페이스를 거치지 않고, 칩 내부(On-chip) 연산기 바로 옆에 SRAM을 배치하여 데이터 전송 지연시간을 제로에 가깝게 줄였습니다.

    단점은 셀 면적이 너무 커서 칩 하나의 실리콘 다이에 탑재할 수 있는 용량이 500MB 수준에 불과하다는 점입니다. 엔비디아와 그록은 이 한계를 256개의 칩을 640TB/s 초고속 초연결 망(Scale-up Interconnect)으로 묶어 랙 전체를 하나의 128GB 대형 논리 SRAM 풀로 구현함으로써 극복했습니다.

    5.2. HBM: 여전한 학습 및 대규모 데이터의 왕좌

    HBM은 DRAM 다이를 수직으로 8층, 12층, 16층 쌓아 올린 후 TSV(관통실리콘비아)로 연결한 초고속 메모리입니다. 대용량 파라미터를 한 번에 올려놓고 병렬 연산을 퍼부을 수 있어 학습(Training)과 대규모 프롬프트 입력(Prefill)에는 대체 불가능한 핵심 매체입니다. 그러나 DRAM의 근본적인 한계인 억세스 레이턴시(Latency)가 존재하므로, 토큰을 1개씩 만들어내는 순차 디코드 과정에서는 대역폭 소모 대비 효율이 급격히 떨어지는 현상이 발생합니다.

    5.3. DDR5: 대용량 백업 스토리지 및 파라미터 오프로드

    그록3 LPX 랙에 설치된 12TB의 DDR5는 실시간 토큰 생성에 직접 참전하기보다는, 128GB SRAM 범위를 넘어서는 대규모 모듈 가중치나 이전 대화 문맥(KV Cache) 데이터를 임시 보존하고 필요시 SRAM으로 고속 교체(Swapping)해 주는 백업 창고 역할을 담당합니다.

    6. 빅테크 진영 간 랙 단위(Rack-Scale) 아키텍처 대격돌: 엔비디아 vs AMD

    AI 반도체 전쟁은 단품 칩 판매에서 데이터센터 전체를 랙 단위로 패키징하여 공급하는 ‘랙 스케일 시스템 경쟁’으로 격화되었습니다. 특히 AMD 역시 반도체 스타트업 세레브라스(Cerebras)와 손을 잡고 이에 강력히 맞서고 있습니다.

    비교 항목엔비디아 연합 (Vera Rubin NVL72 + Groq3 LPX)AMD + 세레브라스 연합 (Helios + CS-4 랙)
    핵심 칩 구성Rubin GPU 72개 + Vera CPU 36개 + Groq3 LPU 256개MI300X/MI350X GPU 랙 + Cerebras CS-4 (WSE-3T) 3개
    온칩 SRAM 용량128 GB (Groq LPX 랙 기준)132 GB (CS-4 랙 기준)
    SRAM 대역폭40 PB/s (초당 40,000 TB)129.6 PB/s (초당 129,600 TB)
    HBM 총 용량 및 대역폭20.7 TB (HBM4) / 1,580 TB/s13.8 TB ~ 20.7 TB (HBM3e/4) / 380~580 TB/s
    DDR5 확장성12 TB (랙 내부 버퍼)최대 1.2 PB (MemoryX 단일 주소 매핑)
    상용화 실사례 및 속도네비우스 (초당 3,400 토큰 / Gemma 4 31B)오픈AI 울트라패스트 모드 (초당 750 토큰)

    6.1. SRAM 대역폭 관점에서의 분석

    AMD와 세레브라스 연합은 거대한 단일 실리콘 웨이퍼 전체를 하나의 칩으로 만드는 ‘웨이퍼 스케일 엔진(WSE-3T)’을 사용합니다. 수치상 SRAM 대역폭이 129.6 PB/s에 달해 엔비디아+그록(40 PB/s)을 앞섭니다. 하지만 세레브라스 방식은 단일 웨이퍼 수율 문제와 수리성, 열관리 난이도가 극도로 높습니다. 반면 엔비디아+그록 조합은 모듈식 디스어그리게이션 구조를 채택하여 생산 수율과 인프라 확장성, NVLink 수평 생태계와의 통합 운용성에서 훨씬 뛰어난 고객 편의성을 제공합니다.

    6.2. HBM 대역폭 관점에서의 분석

    학습 및 대규모 가중치 처리의 핵심인 HBM 대역폭에서는 차세대 HBM4를 선제 적용한 엔비디아 베라 루빈(1,580 TB/s)이 AMD 헬리오스 랙을 큰 폭으로 앞서고 있습니다. 결국 두 공룡 모두 “HBM(대용량) + SRAM(초저지연) + DDR5(백업)”라는 3단계 하이브리드 메모리 아키텍처로 수렴하고 있음을 확인할 수 있습니다.

    7. 파운드리 및 공급망(Supply Chain)의 구조적 재편

    엔비디아의 그록3 LPX 랙 상용화는 반도체 파운드리 생태계에도 거대한 지각변동을 일으키고 있습니다. 바로 파운드리 이원화(Dual Sourcing)입니다.

    🌐 공급망 리스크 분산 전략

    기존 엔비디아의 주력 GPU(블랙웰, 루빈)는 전량 대만 TSMC의 첨단 공정과 CoWoS 패키징에 의존하고 있습니다. 그러나 그록3 LPU 칩은 삼성전자 파운드리(평택/테일러 4nm 공정)가 전량 생산을 맡고 있습니다. 엔비디아는 M&A 및 기술 라이선스 방식을 통해 포트폴리오를 다변화하는 동시에, TSMC에 몰려 있던 첨단 공정 병목 리스크를 삼성전자 파운드리로 분산시키는 고도의 전략을 펼치고 있습니다.

    이는 삼성전자 파운드리 사업부에 단비와 같은 가동률 상승 및 기술 검증의 기회를 제공하며, 대만 외 지정학적 리스크에 대비하려는 글로벌 빅테크들에게 매우 중요한 이원화 이정표가 될 것입니다.

    8. 유명 경제 블로거의 투자 가이드: 수혜주 심층 분석 및 포트폴리오 전략

    주식 투자 관점에서 엔비디아의 그록3 LPX 양산 소식은 명확한 시그널을 던지고 있습니다. 기존 “AI 반도체 = 무조건 HBM 관련주”라는 단순한 투자의 공식이 깨지고 있다는 점입니다.

    8.1. 단기적 관점 (6개월 ~ 1년): 확실한 밸류체인 직수혜주 모멘텀

    단기적으로는 모멘텀이 확실한 파운드리 디자인하우스, 고다층 PCB, FC-BGA 기판, 비메모리 OSAT 및 전력 인프라 기업으로의 수급 쏠림이 가시화될 것입니다.

    ① 삼성전자 파운드리 생태계 (DSP / 디자인하우스)

    • 삼성전자 (005930): 그록3 LPU 4나노 위탁생산을 전담하며 파운드리 가동률 상승 및 턴어라운드 계기 마련. 초기 그록 지분 투자자로서 투자 자산 가치 재평가 유효.
    • 가온칩스 / AD테크놀로지 / 세미파이브: 삼성 파운드리 핵심 DSP 라인업으로, 글로벌 빅테크들의 추론용 ASIC 및 LPU 개발 주문 증가에 따른 직접적 실적 수혜.

    ② 고다층 PCB 및 고부가가치 패키지 기판 (FC-BGA)

    • 이수페타시스 (007660): 랙 단위 초고속 통신(Spectrum-6, NVLink) 가동에 따라 초고다층 MLB(Multi-Layer Board) PCB 수요 폭발.
    • 삼성전기 (009150): SRAM 기반의 초고밀도 다이가 256개 탑재되는 LPX 랙 및 베라루빈 랙용 대면적, 고층수 FC-BGA 공급 확대로 강력한 리레이팅 기대.

    ③ 비메모리 OSAT 및 특화 테스트 소켓

    • ISC (095070) / 리노공업 (058470) / 두산테스나 (131970): 기존 HBM 단순 메모리 검사 장비와 달리, 고주파·저지연 LPU/ASIC 칩을 검사하기 위한 초고속 테스트 소켓 및 외주 테스트(OSAT) 수요 급증.

    ④ 데이터센터 전력 및 신호 인프라

    • HD현대일렉트릭 (267260) / LS ELECTRIC (010120): 랙당 전력 소모량이 수십~수백 kW 단위로 폭증함에 따라, 반도체 아키텍처 변혁과 무관하게 강력한 단기 및 중기 실적 모멘텀 유지.

    8.2. 중장기적 관점 (1년 ~ 3년): AI 시장 재편에 따른 전략적 엑시트 & 재배치

    구분주요 대상 종목 / 분야중장기 영향 및 대응 투자 전략
    기존 HBM 독점 밸류체인SK하이닉스, 한미반도체 등[리스크 관리] HBM 수요가 당장 줄지는 않으나, “HBM 없이는 AI가 불가능하다”는 고평가 프리미엄 약화. 반등 시 비중 축소 전략 유효.
    첨단 패키징 & CPO (광반도체)에스티아이, 이오테크닉스, 제너셈 등[비중 확대] 랙당 640TB/s ~ 129.6PB/s 대역폭 감당을 위한 실리콘 포토닉스(CPO) 및 2.5D/3D 패키징 장비 필수화.
    ASIC 파운드리 & IP삼성전자 파운드리 및 가온칩스[비중 확대] 빅테크들의 자체 ASIC 및 추론용 LPU 채택 확대에 따른 TSMC 대안으로서의 가치 상승.

    8.3. 모델 포트폴리오 가이던스 (Portfolio Allocation)

    📊 추천 포트폴리오 비중 배분

    • 단기 트레이딩 섹터 (비중 30~40%): 삼성전기, 이수페타시스, ISC, 가온칩스 중심 구성. 엔비디아 및 AMD의 랙 양산 가동 실적 및 네비우스 데이터센터 매출이 가시화되는 시점까지 주가 모멘텀 극대화 전략.
    • 중장기 롱(Long) 섹터 (비중 40~50%): 삼성전자(메모리 단점 상쇄 및 파운드리 대반격 수혜), HD현대일렉트릭/LS ELECTRIC(전력망 독점력).
    • HBM 편중 종목 리스크 헤지 (비중 10~20% 축소 유도): HBM 단일 모멘텀으로 PBR 멀티플이 과도하게 상승한 고평가 장비주는 실적 발표 시점마다 이익 실현 후 비메모리/ASIC 테스터 및 CPO 수혜주로의 교체 매매 권장.

    9. 결론: AI 반도체 2.0 시대, 투자자가 가져야 할 자세

    엔비디아의 그록3 LPX 랙 본격 양산 선언은 단순한 신제품 출시 뉴스에 그치지 않습니다. 이는 AI 반도체 시장이 ‘GPU 단일 독주 시대(AI 1.0)’에서 ‘이종 가속기 결합 및 디스어그리게이티드 추론 시대(AI 2.0)’로 완벽히 진화했음을 알리는 거대한 분수령입니다.

    입력 데이터 처리(Prefill)와 출력 토큰 생성(Decode)이 분리되고, HBM과 SRAM, DDR5가 각자의 위치에서 최적의 연산 효율을 극대화하는 시대입니다.

    투자자 여러분 역시 과거의 성공 방정식이었던 “HBM 일변도” 관성에서 벗어나, 초저지연 SRAM 생태계, 대면적 FC-BGA 기판, 비메모리 특화 테스트 소켓, 그리고 CPO 및 전력 인프라라는 차세대 밸류체인으로 유연하게 시선을 넓혀야 할 때입니다.

    변화의 흐름을 가장 먼저 읽고 하드웨어 구조의 본질을 파악하는 자만이 거친 기술주의 파도 속에서 지속 가능한 압도적 수익률을 쟁취할 수 있을 것입니다.

    관련 기사:

    https://n.news.naver.com/mnews/article/293/0000089490

  • [2026.08.24] 카카오, 인적분할 전격 선언: ‘카카오AI’와 ‘카카오X’의 분리, 쪼개지는 거대 플랫폼의 운명과 주주 실익 정밀 진단

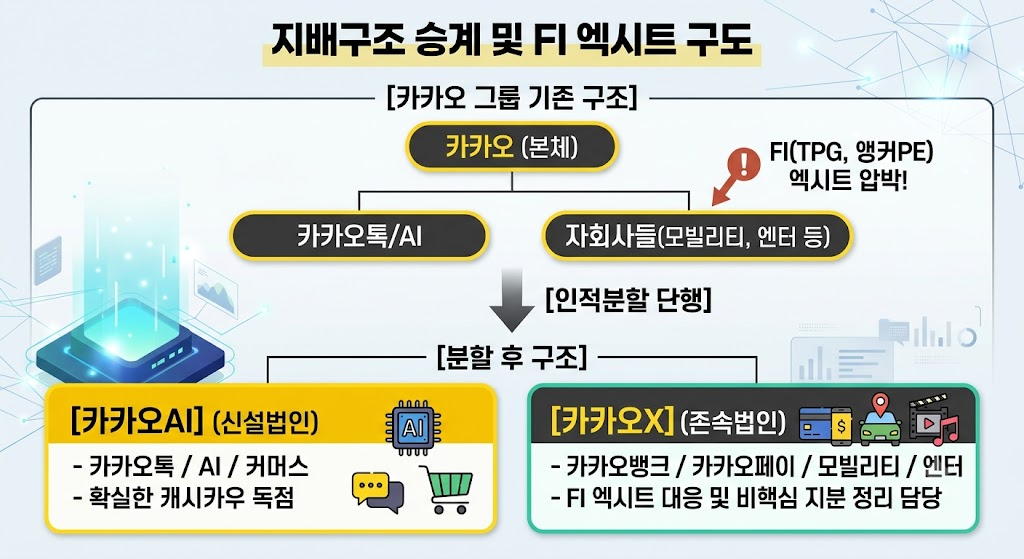
    카카오 인적 분할
상단 타이틀: "KAKAO: UNLOCKING VALUE THROUGH INTRINSIC SPIN-OFF" (카카오: 인적 분할을 통한 가치 제고)로 거시적 목적을 명시했습니다.

핵심 비교 (중앙): 'NEW ENTITY (신설법인)'인 Kakao AI와 'EXISTING ENTITY (존속법인)'인 Kakao X를 대치시켜 직관적인 비교가 가능하도록 구성했습니다.

Kakao AI (왼쪽): "CORE TECH & CASH COW" (핵심 기술 및 캐시카우)로 정의하고, KakaoTalk, AI, Advertising, Commerce 등의 핵심 영업 자산과 'Profit Growth', 'Future Growth Engine', 'Revaluation Potential' 등의 기대 효과를 배치했습니다.

Kakao X (오른쪽): "INVESTMENT & VERTICALS" (투자 및 버티컬 사업)로 정의하고, Fintech, Content, Mobility 등의 자회사 지분 가치와 'Capital Allocation Efficiency', 'Dealing with FI Exit Concerns', 'Dividend Policy' 등 존속 법인의 역할을 설명했습니다.

하단 자본 재배치 프레임워크: "BETTER CAPITAL ALLOCATION FRAMEWORK" (더 나은 자본 배분 프레임워크)를 통해 양 사가 독립적으로 효율적인 자본을 운영하고 최종적으로 "SUM-OF-THE-PARTS RE-RATING" (SOTP 리레이팅) 및 "SHAREHOLDER RETURNS" (주주 환원)을 달성하는 그림을 시각화했습니다.

전체적인 분위기: IT와 금융이 결합된 전문적인 블로그 이미지로, 복잡한 지배구조 개편 내용을 한눈에 이해할 수 있도록 디자인했습니다.

    대한민국 국민 대부분의 일상을 지배해 온 거대 플랫폼 기업 카카오가 이번 인적 분할로 카카오톡 기반의 인공지능(AI)·광고·커머스 사업을 별도로 떼어내 ‘카카오AI(가칭)’라는 신설법인을 만들고, 기존 법인은 ‘카카오X(가칭)’라는 이름으로 금융·콘텐츠·모빌리티 등 버티컬 자회사를 거느리는 투자형 존속법인으로 개편하는 인적분할을 공식 발표한 것입니다.

    발표 직후 시장의 반응은 지극히 차가웠습니다. 카카오의 주가는 전 거래일 대비 7.49% 하락한 3만 5,800원에 장을 마감했고, 장중 한때 13%가 넘는 급락세를 보였습니다. 시장은 왜 한국 대표 IT 기업의 이 같은 결단에 찬물을 끼얹었을까요? 그리고 카카오가 주장하는 ‘복합기업 디스카운트 해소’는 과연 주주들에게 단비가 될 수 있을까요?

    이번 포스팅에서는 엔지니어로서의 기술적 맥락과 30년 베테랑 시장 분석가의 투자적 안목을 결합하여, 이번 카카오 인적분할의 본질과 숨겨진 의도, 그리고 투자자가 반드시 파악해야 할 핵심 체크포인트를 정밀하게 분석해 드리겠습니다.

    1. 카카오 인적분할의 핵심 구조와 스케줄

    먼저 카카오가 공식 공시한 인적분할의 구체적인 틀과 사업 배치 구조를 명확히 이해할 필요가 있습니다.

    (1) 분할 개요 및 법인별 사업 영역

    • 카카오AI (신설법인 / 대표 정신아): 카카오톡 플랫폼, AI 서비스(Kanana 등), 비즈보드 및 디스플레이 광고, 커머스(선물하기 등) 사업을 관장합니다. 그룹 내 가장 강력한 현금창출원(Cash Cow)과 차세대 기술 동력을 한데 모은 ‘영업 중심 본체’입니다.
    • 카카오X (존속법인 / 대표 김도영): 카카오뱅크, 카카오페이, 카카오모빌리티, 카카오엔터테인먼트 등 금융, 콘텐츠, 모빌리티 분야의 버티컬 자회사 지분을 관리하고 신규 사업 투자를 담당하는 ‘투자·지주형 법인’입니다.

    (2) 분할 비율 및 주주 배정 방식

    • 분할비율: 순자산 장부가액을 기준으로 카카오AI 0.36 : 카카오X 0.64로 결정되었습니다.
    • 배정 방식: 이번 분할은 ‘인적분할’입니다. 기존 카카오 주주는 분할 기준일 당시 지분율에 비례하여 신설되는 ‘카카오AI’ 주식 36%와 존속되는 ‘카카오X’ 주식 64%를 각각 배정받게 됩니다.

    (3) 주요 추진 일정

    • 12월 17일: 임시주주총회 개최 및 분할 안건 표결
    • 내년 1월 1일: 분할 기일 (법적 분할 완료)
    • 내년 1월 27일: 카카오AI 신규 상장 및 카카오X 변경 상장

    2. 왜 지금 분할인가? 경영진의 명분 vs 시장의 냉정한 시선

    카카오 경영진이 밝힌 분할의 일차적 명분은 ‘복합기업 디스카운트(Conglomerate Discount)’의 해소입니다.

    (1) 카카오가 주장하는 저평가의 실체

    국내외 주요 증권사 리서치센터가 평가한 카카오의 각 사업부문별 잠재가치(Sum of the Parts, SOTP) 합계는 약 34조 2,000억 원 수준에 이릅니다. 하지만 최근 시장에서 거래되는 카카오의 시가총액은 약 16조 8,000억 원(3개월 평균 기준)에 불과합니다.

    카카오 측은 성격이 서로 다른 사업군(IT 플랫폼, 금융, 모빌리티, 엔터테인먼트 등)이 한 지붕 아래 묶여 있다 보니 시장에서 각 사업의 개별 가치를 제대로 정당하게 평가받지 못하고 ‘반값’에 거래되고 있다고 주장합니다. 사업 정체성을 명확히 분리함으로써 두 법인의 합산 가치를 34조 원 수준으로 끌어올리겠다는 구상입니다.

    (2) 시장은 왜 즉각적으로 급락 반응을 보였는가?

    발표 직후 주가가 급락한 근본적인 이유는 존속법인 ‘카카오X’의 성장성과 수익성 불확실성 때문입니다.

    최근 1년간 카카오그룹 연결 실적을 뜯어보면, 카카오AI로 이관되는 카카오 본사 법인의 영업이익은 그룹 전체 영업이익의 45~58%를 차지했습니다. 즉, 그룹을 떠받치던 든든한 ‘캐시카우’가 카카오AI로 독립해 나가면서, 카카오X는 든든한 뒷배를 잃게 되는 셈입니다.

    과거 카카오 본사가 벌어들인 풍부한 현금흐름은 자회사들의 적자를 메우거나 신규 투자 실탄으로 활용되었습니다. 이제 카카오X는 홀로서기를 통해 독자적인 수익 모델과 성장 동력을 증명해야 하는 무거운 과제를 안게 되었습니다.

    3. ‘인적분할’과 ‘중복상장’ 논란의 정밀 구분

    많은 개인 투자자분들께서 “또 쪼개기 상장(물적분할)으로 기존 주주들 뒤통수치는 것 아니냐”는 우려를 표하고 계십니다. 투자자의 직관에서 느껴지는 우려와 법적·구조적 실체는 엄연히 구분해서 바라봐야 합니다.

    구분인적분할 (금번 카카오 건)물적분할 후 자회사 상장 (기존 논란 사례)
    주식 배정기존 주주가 신설법인 주식을 지분율대로 직접 배정받음모회사가 신설 자회사 지분 100%를 소유 (기존 주주 배정 없음)
    지분 희석기존 주주의 지권 가치 희석 없음 (주식 2개 보유)신설 자회사 상장 시 외부 자금 유입으로 모회사 주주 지분 간접 희석
    법적 성격기업 지배구조 개편 및 사업부문 분리핵심 알짜 사업의 쪼개기 상장

    법적으로 이번 조치는 기존 주주에게 두 회사의 주식을 모두 나누어주는 인적분할이므로, 과거 시장에 큰 충격을 주었던 ‘알짜 자회사 물적분할 후 상장’과는 성격이 완전히 다릅니다.

    그렇다면 왜 주주들은 ‘중복상장’의 피로감을 느낄까요?

    우려의 진짜 원인은 인적분할 자체보다 카카오X 산하로 편입될 자회사들(카카오모빌리티, 카카오엔터 등)이 추진 중인 별도 상장 및 FI(재무적 투자자) 엑시트 이슈 때문입니다.

    4. 숨은 핵심 이슈: 카카오모빌리티 ADR 상장과 FI 엑시트 압박

    이번 지배구조 개편의 이면에는 외국계 사모펀드(PEF)들의 자금 회수 압박이라는 거대한 수수께끼가 숨어 있습니다.

    (1) TPG의 카카오모빌리티 미 증권거래위원회(SEC) 비공개 등록

    카카오모빌리티의 2대 주주인 미국계 사모펀드 텍사스퍼시픽그룹(TPG) 컨소시엄은 2017년과 2021년 두 차례에 걸쳐 약 6,400억 원을 투자해 29%의 지분을 확보했습니다. PEF의 만기가 통상 10년 안팎인 점을 감안할 때, 투자 9년 차에 접어든 TPG의 엑시트(투자금 회수) 시계는 매우 급박하게 돌아가고 있습니다.

    한국 금융당국의 강한 중복상장 규제 기조로 국내 증시 상장이 막히자, TPG는 보유 중인 구주(기존 주식)를 기초로 미국 SEC에 주식예탁증서(ADR) 상장 공모 관련 등록신청서(Form F-1)를 비공개 제출했습니다.

    (2) 중복상장 가이드라인과 카카오의 셈법

    금융당국의 중복상장 가이드라인에 따르면, 모회사가 상장된 상태에서 실질적으로 지배 중인 비상장 자회사를 상장시킬 경우(해외 상장 포함) 모회사는 다음과 같은 5대 의무를 이행해야 합니다.

    1. 주주 영향평가 실시
    2. 주주보호 방안 마련
    3. 주주소통 및 동의 확인
    4. 이사회 결의 및 통지
    5. 상세 정보 공시

    중요한 점은 이번 TPG의 ADR 상장이 회사로 신규 자금이 들어오는 ‘신주 발행’이 아닌, FI가 보유 지분을 파는 ‘구주 매출’ 중심이라는 것입니다. 따라서 회사 자체의 성장을 위한 상장이 아니라 단순 FI 엑시트용이라는 비판을 피하기 어렵습니다.

    업계에서는 이번 인적분할이 “카카오AI라는 알짜 본체를 자회사들의 중복상장 및 FI 엑시트 잡음으로부터 격리(Decoupling)시키고, 카카오X를 통해 비핵심 계열사 지분 매각 및 정리를 진행하려는 포석”이라는 분석이 지배적입니다.

    5. 카카오X의 미래: Bull Case vs Bear Case

    투자자 입장에서 향후 카카오X 주가를 바라보는 두 가지 상반된 시각을 정밀하게 대조해 보겠습니다.

    📈 Bull Case: 재평가와 강력한 주주환원

    • 저평가 자산의 명확화: 34조 원 잠재가치의 상당 부분은 카카오뱅크, 카카오페이, 카카오모빌리티 등 개별 자산의 가치입니다. 분할 후 별도 재무제표로 드러나면서 자산 재평가가 이루어질 수 있습니다.
    • 명확한 주주환원책: 카카오X는 자회사 배당 수익의 30%를 주주에게 배당하고, 특별 투자수익 발생 시 특별배당을 실시할 계획을 밝혔습니다.
    • 풍부한 실탄: 보유 자산 유동화를 통해 마련할 약 2.3조 원과 자회사 보유 투자재원 4.1조 원 등 총 6조 원이 넘는 실탄으로 미래 신사업을 발굴한다는 구상입니다.
    • 지배력 강화: TPG의 ADR 상장이나 지분 매각이 원만히 마무리되면, 카카오X는 경영권을 유지하면서 FI와의 이해관계 충돌을 해소하는 이점을 얻습니다.

    📉 Bear Case: 투자회사 특유의 구조적 할인

    • ‘확실한 메인 자산’의 부재: SK스퀘어의 SK하이닉스처럼 순자산가치(NAV)의 절대 다수를 차지하면서 명확한 시세를 가진 대표 자산이 카카오X에는 없습니다. 금융, 콘텐츠, 모빌리티 등으로 파편화되어 있습니다.
    • 지주사 할인(Holding Co. Discount) 심화: 투자회사는 보유 자산 가치가 크더라도 이중상장 및 자본배분 불확실성 때문에 시장에서 보통 30~50% 이상의 할인율을 적용받습니다.
    • 문어발식 확장 재발 우려: 확보된 6조 원대 재원으로 또다시 과거와 같은 방만한 비핵심 계열사 확장을 반복할 수 있다는 시장의 불신이 존재합니다.

    6. 전문가 시각 및 주가 향방 전망

    (1) 증권가 애널리스트의 객관적 진단

    DB증권 신은정 연구원은 보고서를 통해 “그동안 카카오톡 본업의 현금 흐름이 주로 자회사들의 투자 및 의사결정으로 쏠렸던 점을 고려하면 카카오AI의 기업 재평가 측면에서는 매우 효율적인 방법을 택한 것“이라고 평가했습니다. 다만 “분할 후 카카오X가 주가 우상향을 이루기 위해서는 기업 가치를 끌어올릴 만한 신규 핵심 사업 발굴이 필수적”이라고 지적했습니다.

    한화투자증권 김소혜 연구원 역시 “카카오X는 카카오AI와 달리 지주사 주가 할인율이 보다 명확해질 수 있다”며, “향후 지분 매각 성과, 투자수익 실현, 배당 및 자사주 소각을 통한 순자산가치(NAV)의 실질적 주주 귀속 여부가 주가의 향방을 결정지을 것”이라고 분석했습니다.

    (2) 시기별 주가 흐름 예측

    [분할 후 시기별 주가 흐름 및 수급 전망]
    
    ■ 단기 (재상장 직후 ~ 수개월)
      - 카카오AI ───▶ [수급 쏠림 / 프리미엄 형성] (확실한 캐시카우 + AI 모멘텀)
      - 카카오X  ───▶ [지주사 할인 / 변동성 확대] (캐시카우 부재 + FI 엑시트 잡음)
    
    ■ 중장기 (1년 이상)
      - 카카오X의 체질 개선 성공 여부에 따라 합산 시가총액 결정
        ① FI 지분 정리 완료
        ② 자산 유동화 자금의 효율적 재투자 (AI 연계 등)
        ③ 자사주 소각 및 배당 약속 이행
    
    1. 단기적 관점 (재상장 직후): 시장의 수급은 카카오AI로 쏠릴 가능성이 매우 높습니다. 확실한 현금창출원(카카오톡·광고·커머스)을 독점하고 복합기업 할인에서 벗어난 카카오AI에 프리미엄이 부여될 것입니다. 반면 카카오X는 당장의 실적 공백과 지주사 할인으로 단기 약세를 면치 못할 수 있습니다.
    2. 중장기적 관점 (1년 이상): 카카오X가 보유 자산을 효율적으로 유동화하여 카카오AI의 AI 생태계에 재투자하고, 자사주 소각 등 주주환원 약속을 이행하는 선순환을 증명한다면, 비로소 두 회사의 합산 시가총액이 기존 16.8조 원을 넘어 30조 원대에 안착하는 ‘밸류업(Value-up)’이 완성될 것입니다.

    💡 최종 요약 및 투자 자언

    이번 카카오의 인적분할은 표면적으로는 ‘복합기업 디스카운트 해소’를 내세우고 있지만, 본질은 카카오AI라는 핵심 알짜 사업을 자회사들의 중복상장·FI 엑시트 잡음으로부터 보호하고, 카카오X를 통해 그룹 내 복잡하게 얽힌 비핵심 지분과 투자 관계를 대대적으로 수술하는 지배구조 체질 개선 작업입니다.

    투자자 여러분께서는 다음의 핵심 가이드를 참고하시어 대응 전략을 수립하시길 권장합니다.

    • 기존 주주 전략: 단기적으로는 분할 후 신설되는 카카오AI의 프리미엄 재평가를 활용하여 자산 가치를 보전하고, 카카오X에 대해서는 FI 지분 매각 추이 및 자사주 소각 등 주주환원 이행 여부를 확인하며 호흡을 길게 가져가는 것이 유리합니다.
    • 신규 진입 전략: 재상장 초기 카카오X의 지주사 할인이 과도하게 적용되어 주가가 PBR 관점에서 극심한 저평가 구간에 진입할 경우, 자산가치 수렴을 노린 전략적 접근이 유효할 수 있습니다.

    카카오가 과연 이번 분할을 통해 과거의 ‘문어발식 확장’이라는 오명을 벗고, 진정한 ‘AI 기술 중심 기업’으로 거듭날 수 있을지 시장과 함께 계속해서 세밀하게 추적해 나가겠습니다.

    관련 기사:

    https://n.news.naver.com/mnews/article/028/0002819751

  • [2026.08.21]CXL 3.0 패러다임 shift: 스위치 없는 100TB 풀드 메모리 ‘SLiM’의 기술적 실체와 반도체 투자 전략

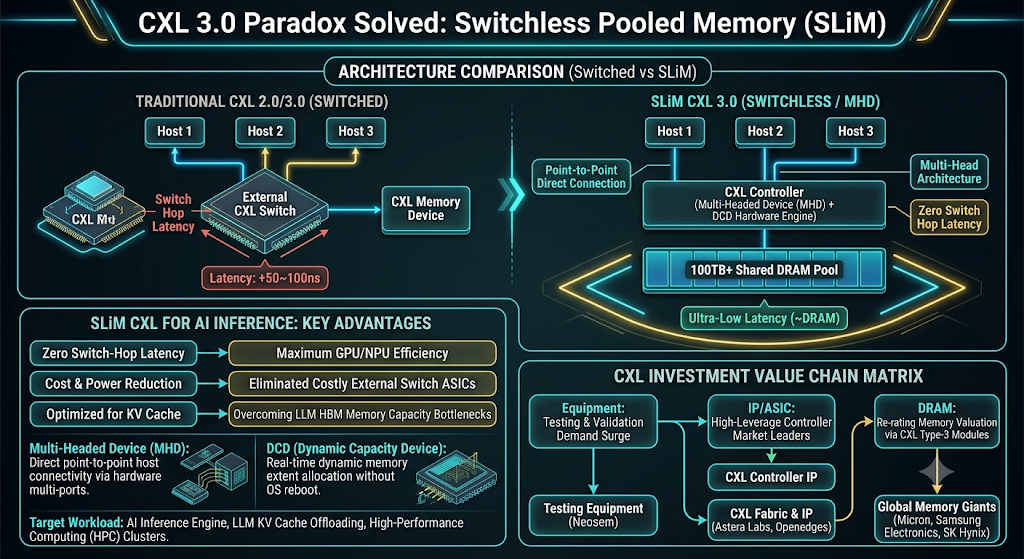
    Title: CXL 3.0 Paradox Solved: Switchless Pooled Memory (SLiM)

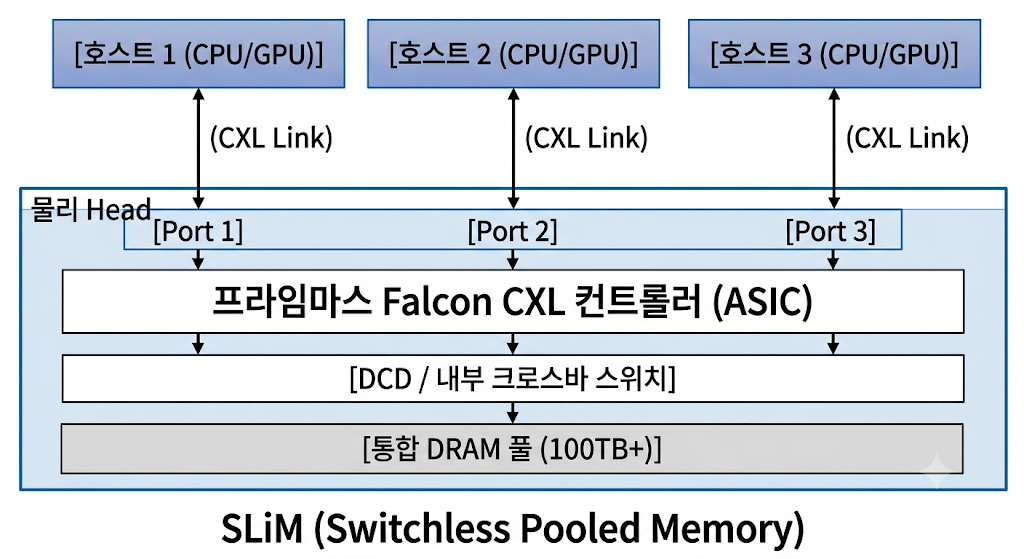
Key Mechanism:

Multi-Headed Device (MHD): Direct point-to-point host connectivity via hardware multi-ports.

DCD (Dynamic Capacity Device): Real-time dynamic memory extent allocation without OS reboot.

Target Workload: AI Inference Engine, LLM KV Cache Offloading, High-Performance Computing (HPC) Clusters.

Investment Catalyst:

Equipment: Testing & Validation Demand Surge

IP/ASIC: High-Leverage Controller Market Leaders

DRAM: Re-rating Memory Valuation via CXL Type-3 Modules

    [핵심 요약 / Executive Summary]

    • 기술적 돌파구: CXL 3.0은 기존 CXL 2.0까지 통용되던 “CXL 메모리 풀링 = 고가의 외부 CXL 스위치 필수” 공식을 깨고, CXL 3.0 MHD(Multi-Headed Device) 메커니즘 기반의 SLiM(Switchless Pooled Memory) 기술이 등장했습니다.
    • 작동 원리: 스위치 라우팅 로직을 디바이스 컨트롤러 내부 포트(Head) 단위로 끌어와, 각 호스트를 point-to-point로 직결합니다. 이를 통해 스위치 홉(Switch Hop) 지연시간(Latency)을 제거하고 비용 구조를 획기적으로 개선했습니다.
    • AI 추론 최적화: 생성형 AI(LLM) 추론 시 병목으로 떠오른 KV 캐시 오프로딩(Offloading) 시장에서 GPU HBM의 가격 부담을 극복할 최적의 대안으로 부각되고 있습니다.
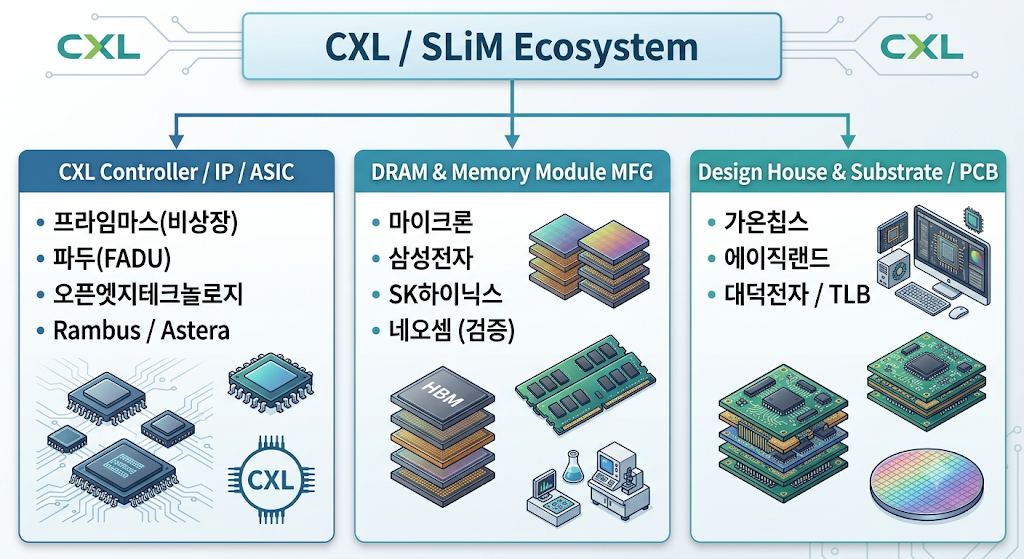
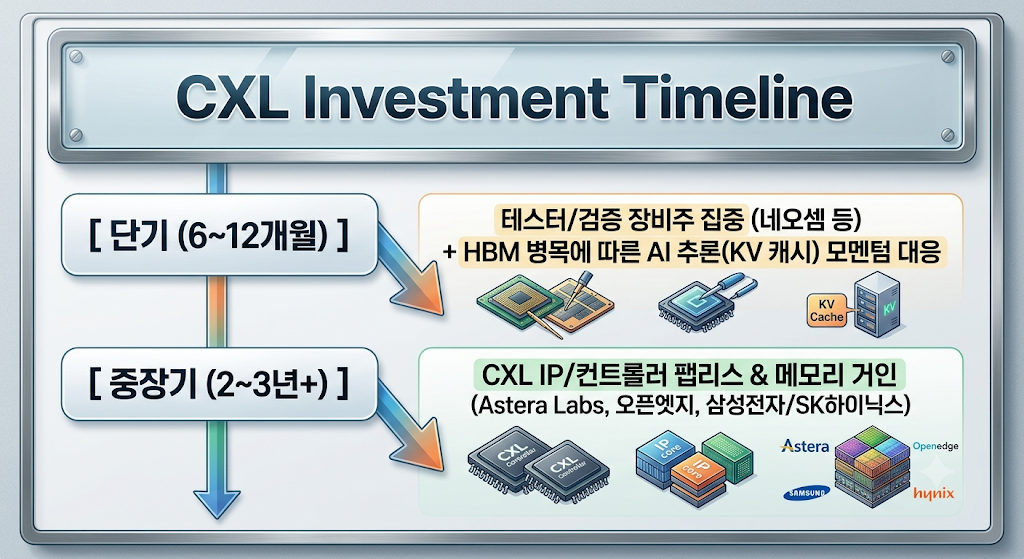
    • 투자가이드: 단기적으로는 실질 수주가 발생하는 검증 장비(네오셈), 중장기적으로는 글로벌 패브릭 독점 기업(Astera Labs)과 핵심 컨트롤러 IP/디자인하우스(오픈엣지테크놀로지) 및 메모리 거인을 중심으로 한 단계별 접근이 유효합니다.

    1. CXL(Compute Express Link)의 본질과 동작 원리

    인공지능(AI)과 고성능 컴퓨팅(HPC)의 시대가 도래하면서, 연산 장치(CPU/GPU)의 데이터 처리 속도는 비약적으로 상승한 반면, 메모리 아키텍처는 심각한 병목 현상에 직면했습니다. 이 한계를 극복하기 위해 등장한 표준 인터커넥트 기술이 바로 CXL(Compute Express Link)입니다.

    (1) 기존 PCIe 버스의 한계와 CXL의 탄생

    기존 서버 아키텍처에서 메모리 접근 방식은 극단적으로 분리되어 있었습니다.

    1. 로컬 DRAM (DDR4/DDR5): CPU 내부의 메모리 컨트롤러(MC)에 직접 연결되어 Load/Store 명령어로 몇십 나노초($ns$) 만에 바이트(Byte) 단위로 접근합니다. 속도는 극도로 빠르지만, CPU 소켓당 꽂을 수 있는 물리적 슬롯(DIMM) 수에 엄격한 한계가 존재합니다.
    2. PCIe 기반 NVMe / 가속기: PCIe 버스를 타고 DMA(Direct Memory Access) 방식으로 통신합니다. 블록(Block) 단위나 4KB 페이지 단위로 데이터를 주고받으며, OS I/O 드라이버 스택과 인터럽트(Interrupt)를 거치므로 수 마이크로초($\mu s$) 수준의 레이턴시(지연시간)가 발생합니다.

    결국 데이터센터는 “PCIe의 물리적 확장성(슬롯 확장성)”과 “로컬 DRAM의 극저지연 Byte 단위 접근성 및 캐시 일관성”을 동시에 갖춘 새로운 인터커넥트를 필요로 했고, 그 결실이 CXL입니다.

    (2) CXL의 3가지 서브 프로토콜 (Sub-protocols)

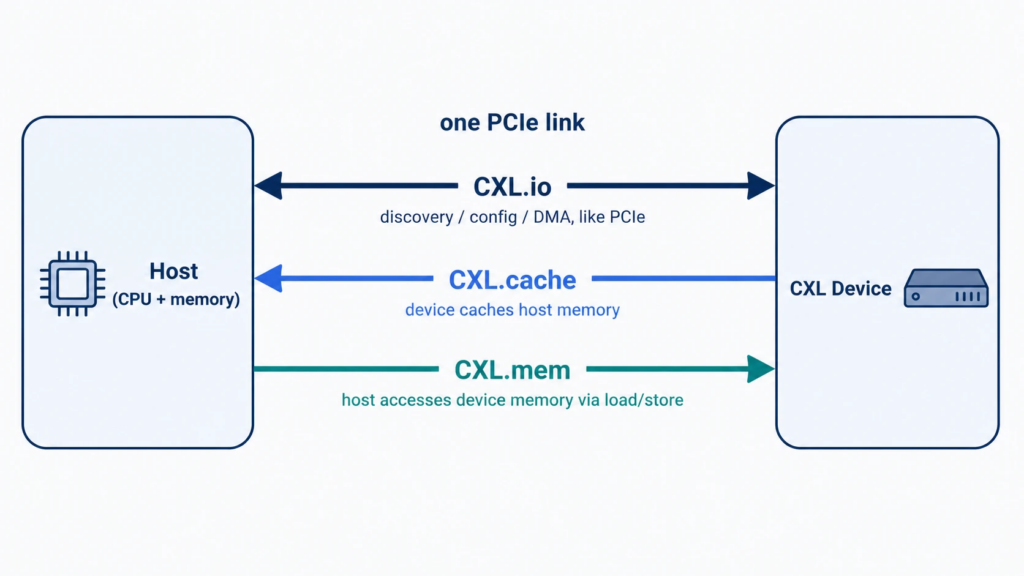
    CXL은 PCIe 5.0/6.0/7.0의 물리 계층(PHY) 핀과 전기적 신호를 그대로 사용하지만, 데이터 패킷을 3개 프로토콜로 분리하여 다룹니다.

    • CXL.io (Configuration & Management): 장치 탐색(Enumeration), 초기화, 자원 할당, DMA 전송, 에러 보고 등 기존 PCIe와 100% 호환되는 제어 채널입니다. 모든 CXL 디바이스는 부팅 시 이 채널을 기본으로 활성화합니다.
    • CXL.cache (Device-centric Cache Coherency): GPU/NPU 등 가속기가 호스트 CPU의 메인 메모리를 자율적으로 가져와 가속기 내부 캐시에 넣어두고 쓸 때, CPU와 가속기 간 데이터 불일치가 생기지 않도록 Snooping 메커니즘을 Ultra-low latency로 지원합니다.
    • CXL.mem (Memory-centric Byte-Addressable Access): CPU가 외부 CXL 메모리 카드의 DRAM을 메인보드에 꽂힌 로컬 메모리처럼 직접 다루게 해주는 핵심 프로토콜입니다. CPU가 MOV RAX, [CXL_Memory_Address] 형태의 단순 Load/Store 명령을 내리면, OS 드라이버 개입 없이 하드웨어 레벨에서 바이트 단위 통신이 이뤄집니다.

    (3) CXL 디바이스 타입 분류

    구분사용 프로토콜대표 장치동작 방식 및 핵심 특징
    Type 1CXL.io + CXL.cacheSmartNIC, PGAS 가속기자체 메모리는 없으나, CPU 메인 메모리를 극도로 빠른 속도로 캐싱하여 네트워크/연산을 처리하는 장치
    Type 2CXL.io + CXL.cache + CXL.memGPU, Tensor 가속기, FPGA가속기 고유 메모리(HBM 등)를 가지며, CPU 메모리와 가속기 메모리를 경계 없이(Shared Memory) 상호 참조하는 대형 연산 장치
    Type 3CXL.io + CXL.memCXL 메모리 확장 카드 (E3.S, AIC 등)[상용화 핵심] 순수 메모리 확장용 카드로, 시스템에 TB 단위의 Massive 메모리를 유연하게 덧붙이는 디바이스

    (4) 핵심 하드웨어 동작 메커니즘

    • ARB/MUX & Flit 전송: 가변 길이 TLP를 쓰는 기존 PCIe와 달리, CXL은 데이터를 68바이트 또는 256바이트 고정 크기의 Flit(Flow Control Digit) 단위로 잘라 시분할 다중화(TDM) 전송함으로써 오버헤드를 극적으로 줄였습니다.
    • HDM(Host-Managed Device Memory) Decoder: CPU 내부 HDM 디코더가 물리 주소(PA)를 감지하여, 로컬 DDR5 영역이 아닌 CXL 슬롯 영역일 경우 소프트웨어 개입 없이 즉시 CXL.mem 패킷으로 변환해 CXL 포트로 송출합니다.

    2. ‘스위치 없는 다중 호스트 메모리 공유’ SLiM의 심층 분석

    국내 반도체 팹리스 프라임마스(Primemass)가 마이크론과 협력해 미국 DOE/PNNL ‘아바코(Abaco)’ 프로젝트에 공급하는 SLiM(Switchless Pooled Memory) 기술은 업계에 신선한 충격을 주었습니다.

    “외부 CXL 스위치 없이 데이터 흐름(Routing) 제어가 불가능한 것 아닌가?”라는 질문에 대한 기술적 답변은 “CXL 3.0 스펙의 MHD 구조를 통해 라우팅 로직을 디바이스 컨트롤러 내부 포트 단위로 흡수시켰기 때문에 완전히 가능하다”입니다.

    (1) SLiM의 3가지 핵심 작동 원리

    1. 물리적 Multi-Head (다중 포트) 직결 구조 (MHD/MH-SLD):CXL 3.0 표준에 정의된 MHD(Multi-Headed Device) 구조를 활용합니다. 별도 스위치 칩을 외부에 두는 대신, 프라임마스 Falcon과 같은 Type 3 메모리 컨트롤러 ASIC 자체가 물리적인 CXL 포트(Head)를 복수 개 탑재합니다. 각 서버(호스트)는 이 포트와 1:1 케이블로 직결(Point-to-Point)됩니다.
    2. 호스트 관점에서의 착각 (독점 디바이스 인식):1번 포트에 연결된 호스트 1은 이 CXL 카드를 자신 혼자 연결된 단일 메모리 카드(SLD: Single Logical Device)로 인식합니다. 포트로 들어오는 신호는 물리적으로 전용 선로를 타고 들어오므로, 외부에 복잡한 라우팅 패킷 헤더를 처리할 스위치가 필요 없습니다.
    3. DCD(Dynamic Capacity Device) 기반 하드웨어 격리 및 공유:컨트롤러 내부 로직이 전체 100TB DRAM 공간을 Extent 단위로 분할합니다. “1번 포트(호스트 1)에게는 A~B 주소 영역 할당”, “2번 포트(호스트 2)에게는 C~D 주소 영역 할당”을 하드웨어 수준에서 락(Lock) 검증 및 매핑합니다.여러 호스트가 동일 영역을 보는 메모리 공유(Sharing) 시에는 CXL 3.0의 Back-Invalidation 및 캐시 일관성 디렉터리 제어를 컨트롤러 내부에서 직접 수행합니다.

    (2) 스위치 기반 CXL vs SLiM (스위치리스) 트레이드오프 비교

    비교 항목스위치 기반 CXL 풀링 (CXL 2.0/3.0 Switch)SLiM (스위치리스 MHD/CXL 3.0)
    지연시간 (Latency)스위치 칩 통과 시 50~100ns 이상의 Switch Hop 추가스위치 홉이 없어 DRAM에 근접한 극저지연 구현
    시스템 비용/전력고가 스위치 ASIC + 보드 면적 증가 + 추가 전력 소비스위치 칩 비용 절감, 전력 절감, BOM 단가 우수
    확장성 Limit스위치 캐스캐이딩(Cascading)으로 수백~수천 대 무한 확장컨트롤러 물리 포트(Head) 개수로 제한 (보통 4~16대)
    타겟 응용처하이퍼스케일 클라우드 전체 데이터센터 메모리 패브릭단일 랙 단위 AI 추론 노드, HPC 클러스터, KV 캐시

    (3) CXL 메모리 접근과 일반 Disk I/O의 근본적 차이

    CXL 풀드 메모리를 이해할 때 흔히 하는 오해가 “외장 하드디스크 파티션을 나누듯 메모리를 저장하고 꺼내 쓴다”는 개념입니다. 그러나 이는 근본적으로 다릅니다.

    • 하드디스크/SSD: OS의 파일시스템을 거쳐 Read/Write 명령어로 블록(Sector) 단위 I/O를 수행하는 비휘발성 저장장치입니다.
    • CXL 풀드 메모리: CPU가 직접 Load/Store 명령어로 바이트 단위 즉시 접근을 수행하는 RAM 주소 공간의 확장입니다. 즉, “파일을 저장하는 공간”이 아니라 “당장 연산에 필요한 작업 공간(RAM)이 물리적으로 대거 확충된 것”입니다.

    3. CXL 생태계 밸류체인 및 수혜 기업 분석

    SLiM 기술의 대중화와 CXL 3.0 시장의 개화는 반도체 밸류체인 전반에 커다란 변화를 가져옵니다.

    CXL 핵심 3사 펀더멘털 비교 분석

    구분Astera Labs (미국: ALAB)네오셈 (국내: 253590)오픈엣지테크놀로지 (국내: 394280)
    주요 역할CXL 스위치 / 리타이머 IC 독점CXL 메모리/SSD 검증 테스터CXL 메모리 컨트롤러 & PHY IP
    재무 상태매우 우수 (매출 급성장, 흑자 구조)양호 (CXL 검증장비 수주 확대로 회복)주의 (R&D 투자 지속으로 영업손실)
    CXL 매출 비중현재 ~20% $\rightarrow$ 중장기 40%+현재 ~30% $\rightarrow$ 중장기 50%+현재 <10% $\rightarrow$ 중장기 25%+
    핵심 고객사Nvidia, AMD, AWS, MS, Meta 등삼성전자, SK하이닉스, 마이크론글로벌 팹리스, 국내외 메모리 거인
    투자 핵심CXL 패브릭 시장의 대장주CXL 모듈 양산 수혜 첫 타자CXL 컨트롤러 IP 레버리지 옵션

    4. CXL 투자 가이드라인

    CXL 시장은 단순한 기술 테마가 아닌 컴퓨팅 패러다임의 구조적 대전환입니다. 단기와 중장기로 나누어 정밀한 접근이 필요합니다.

    (1) 단기 전략 (6개월 ~ 1년): “가시성 높은 수주와 검증 장비에 집중”

    1. 네오셈(253590) Top Pick: CXL 2.0/3.0 표준 도입 시 가장 먼저 돈을 버는 곳은 검증 테스터 장비사입니다. 메모리 3사(삼성·SK하이닉스·마이크론) 모두를 고객사로 확보하고 있어 CMM(CXL 메모리 모듈) 양산 확대에 따른 직수혜가 확실합니다.
    2. AI 추론(Inference) & KV 캐시 모멘텀 활용: GPU HBM 수급 불균형으로 인해 생성형 AI 추론 시 KV 캐시를 CXL 메모리로 오프로딩하려는 수요가 폭발하고 있습니다. SLiM과 같은 “스위치 없는 저지연 풀드 메모리” 스토리는 시장 형성의 핵심 촉매가 될 것입니다.

    (2) 중장기 전략 (2년 ~ 5년): “CXL 3.0 패브릭 정착 및 IP 가치 폭발”

    1. Astera Labs (ALAB) 바이앤홀드(Buy & Hold): 소규모 랙 단위는 SLiM 방식이 침투하겠지만, 데이터센터 전체를 묶는 랙 스케일 확장에는 CXL 스위치 및 리타이머 패브릭이 필수적입니다. ALAB의 글로벌 독점력은 매출 성장을 담보합니다.
    2. 오픈엣지테크놀로지(394280) 분할 매수: 선제적 CXL 3.0 컨트롤러/PHY IP R&D 지출로 단기 실적 부담은 있으나, 글로벌 팹리스들의 CXL ASIC 설계 착수 시 라이선스 및 로열티 매출 증가로 턴어라운드 레버리지가 가장 클 수 있습니다.
    3. 메모리 거인(삼성전자 / SK하이닉스)의 Re-rating: CXL Type 3 메모리 출하 본격화는 단순 Commodity였던 DRAM의 ASP(평균판매단가)를 끌어올려, HBM에 이은 메모리 반도체의 멀티플 재평가(Re-rating)를 이끌 것입니다.

    (3) 핵심 리스크 및 모니터링 포인트 (Checklist)

    • Linux 커널 SW 스택 성숙도: CXL 3.0 DCD(Dynamic Capacity) 기능이 OS 하드웨어 레벨에서 완벽히 연동되는 커널 스택(Linux 6.x 이상)의 안정화 속도를 추적해야 합니다.
    • 서버 CPU 지원 타이밍: 인텔(Granite Rapids 등) 및 AMD(Turin 등) 차세대 서버용 CPU의 CXL 2.0/3.0 지원 및 시장 침투 속도가 CXL 밸류체인 기업들의 실적 타이밍을 결정짓는 핵심 지표가 될 것입니다.

    관련 기사:

    https://n.news.naver.com/mnews/article/092/0002434608

  • [2026.08.19]AI 토큰 경제학: 생산 비용 패러다임 전환과 인프라 병목, 그리고 빅테크 투자 전략

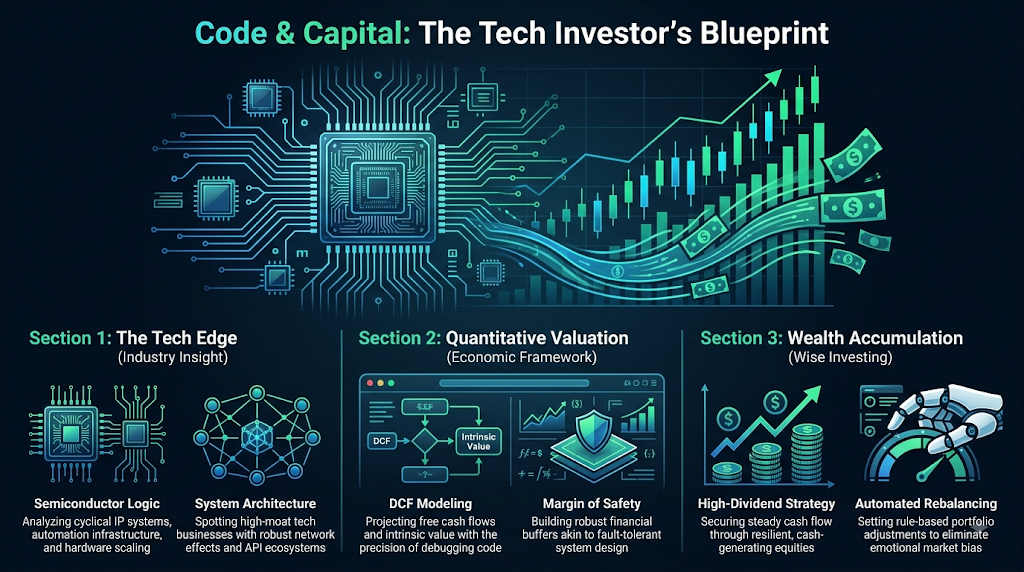
    ai 토큰 생성과 기술 투자자를 위한 청사진 'Code & Capital' 인포그래픽. 상단에는 마이크로칩 회로와 상승하는 주가 차트, 현금 흐름 아이콘이 조화롭게 연결된 그래픽이 위치해 있습니다. 하단은 3개 섹션으로 나뉩니다. Section 1 'The Tech Edge'는 반도체 로직과 시스템 아키텍처, Section 2 'Quantitative Valuation'은 DCF 모델링과 안전식대(Margin of Safety), Section 3 'Wealth Accumulation'은 고배당 전략과 자동 리밸런싱에 대한 주요 내용을 다룹니다.

    오늘은 AI 토큰 생성에 대한 내용으로 알아보려 합니다. 2023년과 2024년이 생성형 AI(Generative AI)의 가능성을 검증하고 프론티어 파운데이션 모델을 훈련(Training)시키는 ‘자본 집약적 군비 경쟁’의 시대였다면, 2026년 현재 AI 산업은 명확하게 ‘수익화, 수율, 그리고 토큰 당 생산 원가 절감’ 중심의 추론(Inference) 서비스 단계로 완벽히 전환되었습니다.

    과거 PC 보급 초기나 인터넷 초창기 초고속 망 구축 시절을 돌아보십시오. 인프라 구축의 폭발적 증가 단계가 지나면 시장의 관심은 자연스럽게 “누가 이 인프라를 통해 가장 저렴하게 서비스를 생산할 수 있는가?” 그리고 “그 과정에서 진짜 병목(Bottleneck)을 쥐고 수익을 독식하는 자는 누구인가?”로 이동합니다.

    본 포스팅에서는 2026년 8월 최신 데이터를 바탕으로 ① 글로벌 주요 기업들의 AI 토큰 생산량 및 비용 구조, ② 토큰 생성에 필요한 TCO(총소유비용) 및 자원 구성 현황, ③ PagedAttention 및 MLA(Multi-head Latent Attention) 등 추론 단가를 극적으로 낮춘 기술적 혁신, ④ Google vs OpenAI vs Anthropic의 인프라 전략 차이, 그리고 ⑤ 이에 기반한 단기/중장기 블록버스터급 투자 가이던스를 심도 있게 다룹니다.

    1. 기업별 AI 토큰 생산량(처리량) 및 시장 현황 (2026년 8월 기준)

    AI 기업들의 실제 ‘공식 발표 총 생산량’은 기업 비밀에 속하지만, API 트래픽 및 주요 리서치 기관(a16z, OpenRouter 등)의 최신 측정 데이터에 따른 2026년 현재 글로벌 토큰 처리량은 가공할 만한 속도로 팽창하고 있습니다.

    주요 기업 및 플랫폼별 토큰 처리 트렌드

    1. OpenAI:
      • OpenAI API 트래픽은 2025년 10월 분당 약 60억 토큰을 기록했으나, 2026년 4월에는 분당 150억 토큰으로 불과 5개월 만에 2.5배 폭증했습니다.
      • 이는 일일 기준으로 약 216억 토큰을 처리하는 규모입니다. GPT-5.6 시리즈(Sol, Luna) 및 엔터프라이즈 에이전트 도입이 본격화되면서 처리량 성장은 상방을 계속 열어두고 있습니다.
    2. Google (내부 Antigravity 플랫폼 및 GCP):
      • Google 개발자 생태계 및 내부 연산 플랫폼인 Antigravity 기준, 2026년 3월 하루 약 5,000억 토큰을 처리했으나, 불과 두 달 뒤인 5월 중순에는 일일 3조 토큰(3 Trillion Tokens/Day)을 돌파했습니다.
      • 이는 Gemini 3.1 Pro / Flash-Lite의 압도적인 맥락 창(Context Window) 처리 능력과 TPU Ironwood(v7) 파이프라인의 가격 경쟁력이 결합된 결과입니다.
    3. OpenRouter (멀티 프로바이더 라우팅 플랫폼):
      • 다양한 오픈소스 및 커머셜 모델을 연결하는 라우팅 인프라 OpenRouter는 2026년 5월 기준 주당 25조 토큰을 처리했습니다. 6개월 전(주당 5조 토큰) 대비 무려 5배 성장한 수치입니다.
    4. 전체 시장 규모 (Global LLM API Market):
      • a16z와 OpenRouter의 공동 연구 조사에 따르면, 2026년 8월 현재 글로벌 LLM API 시장 전체의 일일 토큰 생성량은 약 50조 토큰(50 Trillion Tokens/Day) 규모로 추산됩니다.

    글로벌 AI 랩 및 빅테크 매출 성과 참고 (2026년 상반기)

    • OpenAI: 2026년 1분기 약 57억 달러의 매출을 기록했으며, 2026년 4월 기준 연환산 매출(ARR)은 약 250억 달러 수준을 나타내고 있습니다.
    • Anthropic: Enterprise Claude 3.5/4.8 및 AWS/GCP 멀티클라우드 침투율 급증에 힘입어 2026년 상반기 연환산 매출(ARR) 약 190억~450억 달러 선을 오가며 OpenAI를 턱밑까지 추격하는 기염을 토하고 있습니다.

    2. 토큰당 실제 ‘생산 비용(Cost)’ vs ‘판매 가격(Price)’ 파헤치기

    투자자와 엔지니어 모두가 반드시 구분해야 하는 핵심 개념이 있습니다. “사용자에게 매기는 API 판매 가격(Price)”과 “기업이 토큰 1개를 생성하는 데 드는 실제 컴퓨팅 원가(Cost)”는 천지차이라는 점입니다.

    (1) 실제 순수 컴퓨팅 생산 원가 (Pure Compute Cost)

    1. 에너지 관점 (Energy Cost per Token):
      • 경험적 실측치에 따르면, 추론(Inference) 단계의 에너지 소비는 출력 토큰당 약 0.0001 ~ 0.002 Wh 수준입니다.
      • 중간값인 토큰당 0.0005 Wh를 기준으로 계산하면, 토큰 1개를 생산할 때 소요되는 에너지는 약 1.8 줄(Joule)에 해당합니다.
    2. 하드웨어 및 한계 비용 사례:
      • OpenAI의 최적화된 프론티어 파이프라인 기준, 토큰 1개를 생성하는 순수 인프라 원가는 약 0.00012달러 ($0.00012) 수준으로 추산됩니다. 이는 AI 기업들의 매출총이익률(Gross Margin)을 결정짓는 최고 보안 지표입니다.
    3. GPU 시간 기준 원가와 가동률(Utilization):
      • 추론 비용의 본질은 “토큰당 GPU를 몇 초간 점유했는가”입니다.
      • 2026년 4월 기준 NVIDIA Blackwell B200의 클라우드 임대료는 시간당 $3.49 ~ $14.24 수준입니다. GPU 시간당 임대 비용은 초당 2,000토큰을 생성하든 27,000토큰을 생성하든 일정하므로, 유효 가동률(Utilization Rate) 및 메모리 대역폭 활용 효율이 토큰당 원가를 결정하는 절대적 변수가 됩니다.

    (2) 원가 대비 판매가 (마진 구조) 및 최신 가격 동향

    • 자체 호스팅 원가 vs API 판매가:2026년 기준 H100 GPU에서 Batch Size=8로 구동하는 Llama 4 70B 오픈소스 모델의 자체 호스팅 원가는 백만 토큰(1M Tokens)당 약 $0.18 수준입니다. 이는 상용 서비스인 Claude Sonnet 4.6 API 가격($15.00/1M Tokens)의 약 1.2%에 불과합니다.
    • 최저 원가 하드웨어의 출현:NVIDIA Blackwell(B200) 인프라는 최적화 구동 시 1M 토큰당 $0.02(2센트)라는 전대미문의 추론 비용 하한선을 세웠습니다. DeepInfra, Baseten, Fireworks AI, Together AI 등 최적화 프로바이더들은 Hopper(H100) 세대 대비 최대 10배의 비용 절감을 달성했습니다.
    • 3년간 1,000배 급락한 추론 비용:2021년 11월부터 2024년 말, 그리고 2026년에 이르기까지 동일 성능 기준 추론 비용은 백만 토큰당 $60.00에서 $0.06 이하로 3년 만에 1,000배 이상 급락했습니다.

    💡 추론 비용 1,000배 하락의 6대 복합 요인

    1. GPU/NPU 하드웨어 건축적 진화 (FP8/FP4 Tensor Core 도입)
    2. 양자화(Quantization) 기술 (16비트 FP16 → 4비트 INT4/FP4)
    3. 소프트웨어 최적화 (vLLM, FlashAttention, PagedAttention)
    4. 소형 고성능 모델(SLM)의 등장 (MoE 구조 고도화)
    5. 강화학습(RLHF/RLAIF) 및 연산 효율 개선
    6. 오픈소스 생태계와의 치열한 단가 경쟁

    주요 프로바이더 API 판매가 비교 (2026년 7-8월 기준, 1M 토큰당)

    기업대표 모델입력 가격 (1M)출력 가격 (1M)비고 및 특이사항
    OpenAIGPT-5.6 Sol$5.00$30.00플래그십 고성능 에이전트
    OpenAIGPT-5.6 Luna$1.00$6.00경량화·고속 추론 모델
    AnthropicClaude Opus 4.8$5.00$25.00복잡 코딩 및 논리 추론 특화
    AnthropicClaude Sonnet 5$2.00$10.00프로모션가 적용
    GoogleGemini 3.1 Pro$2.00$12.0020만 토큰 이하 프롬프트 기준
    GoogleGemini 3.1 Flash-Lite$0.25$1.50극가성비 대량 처리용
    DeepSeekDeepSeek-V3 / R1$0.27 ~ $0.50$0.42 ~ $2.18초저가 박리다매 전략

    3. 토큰 생산 자원(TCO) 구성 및 인프라 병목 분석

    AI 토큰을 생산하기 위해서는 ① 하드웨어(가속기 칩/서버), ② 전력 및 냉각 인프라, ③ 부지 및 전력망(Grid) 연결이라는 세 가지 핵심 축이 필요합니다.

    (1) 데이터센터 TCO(총소유비용) 구조

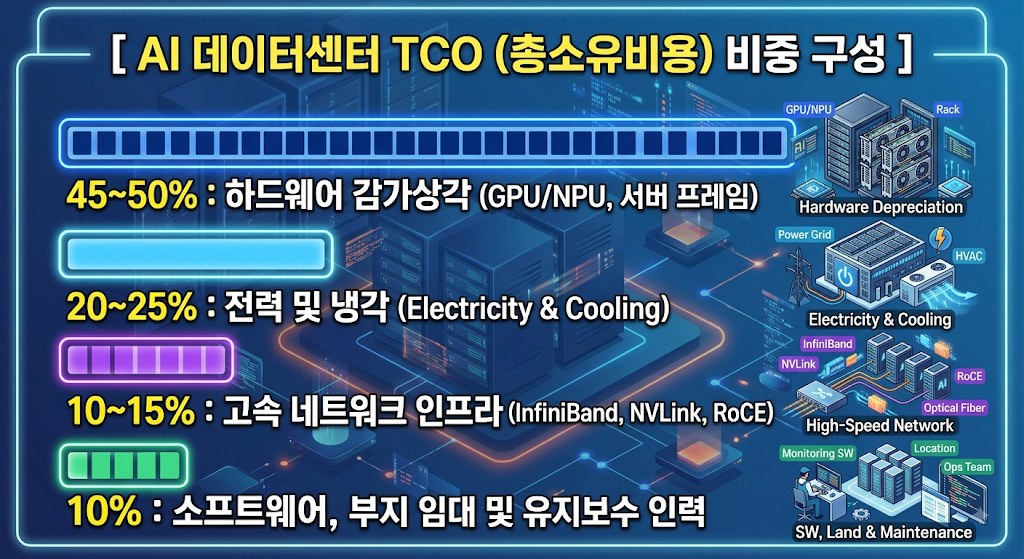
    1기가와트(1GW)급 AI 데이터센터 구축에는 약 380억 달러의 초기 자본지출(CapEx)과 연간 9억 달러의 운영비(OpEx)가 소요됩니다. 자산 수명주기(3~5년)를 감안해 연단위로 환산한 총소유비용(TCO)은 연간 약 85억 달러에 달합니다.

    • 하드웨어 감가상각 (45~50%): GPU(NVIDIA H100, B200) 및 전용 NPU/TPU 서버의 내구연한(3년) 감가상각비가 전체 원가의 절반을 차지하는 단일 최대 항목입니다.
    • 전력 및 냉각 (20~25%): GPU 연산 전력과 함께, 극심한 열을 식히기 위한 냉각 시스템 전력이 포함됩니다.
    • 고속 네트워크 인프라 (10~15%): 수만 개의 GPU를 하나의 거대한 분산 컴퓨터처럼 연결하는 InfiniBand 및 RoCE 스위치 인프라입니다. 네트워크 병목이 발생하면 고가의 GPU가 연산을 멈추고 대기(Idle)하므로 매우 결정적인 투자 항목입니다.

    (2) 패러다임의 전환: “칩 병목”에서 “전력 및 전력망 병목”으로!

    현재 AI 산업의 가장 치명적인 병목은 더 이상 GPU 칩 자체의 리드타임이 아닙니다. 진짜 병목은 변전소 및 전력망 연결 대기시간(전력망 그리드 연결 대기시간 약 4년 이상)과 데이터센터 랙(Rack)당 밀도 폭발입니다.

    • 랙 당 전력 밀도의 극단적 증가: 과거 일반 IT 서버 랙은 5~15kW 수준이었으나, 최신 AI GPU 랙(Blackwell 등)은 랙당 40kW ~ 250kW의 전력을 소비합니다.
    • 냉각 인프라의 강제 전환: 공랭식(Air Cooling) 시설로는 랙당 40kW 이상의 발열을 식히는 것이 물리적으로 불가능합니다. 이에 따라 Direct-to-Chip 액체 냉각(Liquid Cooling) 및 침매 냉각(Immersion Cooling)으로의 급격한 패러다임 전환이 일어나고 있으며, 냉각 설비가 데이터센터 시설 비용에서 차지하는 비중은 기존 22%에서 33% 이상으로 급증했습니다.
    • 추론(Inference) 부하의 압도: 2년 전만 해도 전체 컴퓨팅 자원의 80% 이상이 ‘학습(Training)’에 투입되었으나, 2026년 현재 추론 워크로드가 전체 AI 컴퓨팅 자원의 80~90%를 점유하고 있습니다. 학습과 달리 추론은 24시간 전 세계 사용자에 의해 지속적으로 발생하므로 기저 전력 부하를 극도로 압박합니다.

    4. LLM 추론 단가를 혁신한 2대 핵심 기술: PagedAttention & MLA

    엔지니어링 관점에서 LLM 추론은 두 단계로 나뉩니다.

    1. Prefill 단계 (입력 프롬프트 읽기): 연산 집약적 (Compute-bound)
    2. Decode 단계 (토큰 한 글자씩 생성): 메모리 대역폭 집약적 (Memory-bandwidth bound)

    실제 서비스 처리 시간의 90% 이상을 차지하는 Decode 단계에서 ‘메모리 월(Memory Wall)’을 깨뜨리고 토큰 생성 단가를 1/10 이하로 떨어뜨린 일등 공신이 바로 PagedAttention과 MLA(Multi-head Latent Attention)입니다.

    (1) PagedAttention: OS의 가상 메모리 기법을 GPU에 이식

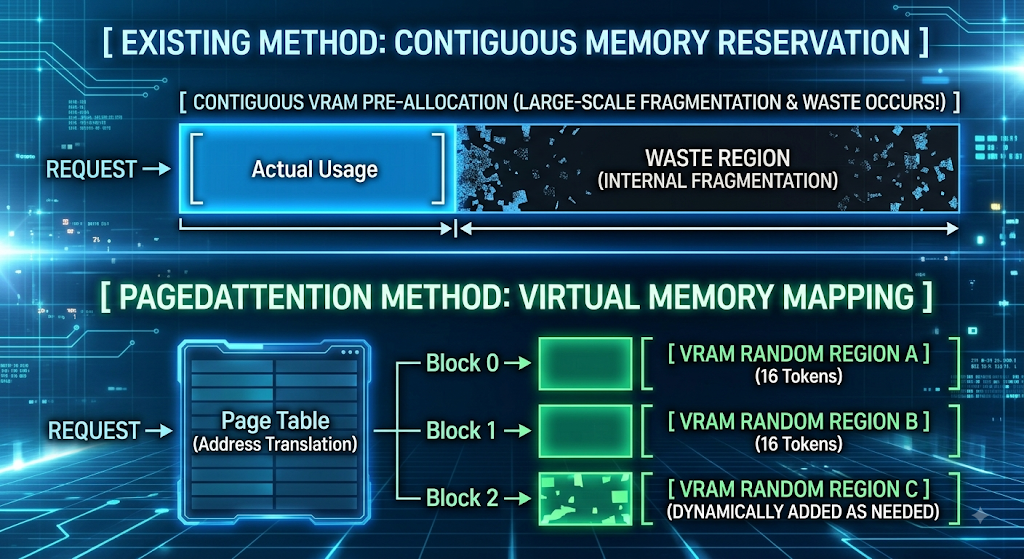
    vLLM 팀이 제안한 PagedAttention은 운영체제(OS)의 페이징(Paging) 메커니즘을 GPU VRAM 관리에 적용한 혁신적 소프트웨어 기술입니다.

    • 기존 문제점: 대화가 얼마나 길어질지 모르기 때문에 기존 추론 엔진은 최대 컨텍스트 길이(예: 2,048~8,192 토큰)에 맞추어 연속된 VRAM을 통째로 예약했습니다. 이로 인해 메모리 낭비율이 60~80%에 달했고, 동시 접속자(Batch Size)를 많이 받아내지 못했습니다.
    • PagedAttention의 해결책: KV 캐시를 ‘블록(Block)’ 단위로 쪼개어 non-contiguous(비연속적) VRAM 공간에 자유롭게 할당하고, Page Table을 통해 관리합니다.
    • 결과: 메모리 파편화 및 낭비를 1% 미만으로 줄였으며, 동일 하드웨어 대비 동시 처리 사용자 수를 2~4배 이상 끌어올려 토큰당 원가를 혁신적으로 인하시켰습니다.

    (2) MLA (Multi-head Latent Attention): 신경망 아키텍처 수준의 데이터 압축

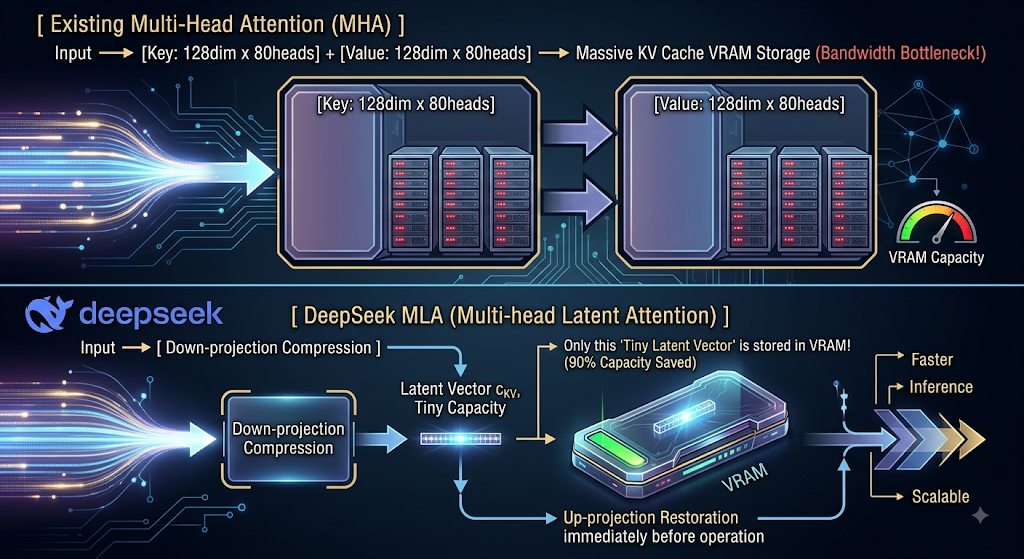
    DeepSeek-V3 및 R1 모델 등에 적용되어 전 세계를 놀라게 한 MLA는 “메모리에 저장되는 KV 캐시 덩치 자체를 1/10로 압축하자”는 아키텍처적 혁신입니다.

    • 기존 방식 한계: MHA 방식에서는 헤드 수와 차원 수가 늘어남에 따라 토큰 1개당 엄청난 양의 Key/Value 벡터를 매번 VRAM에 읽고 써야 하므로 메모리 대역폭 한계(Memory Bandwidth Bottleneck)에 직면했습니다.
    • MLA의 해결책: Key와 Value를 각각 거대하게 저장하지 않고, 차원을 대폭 축소한 ‘잠재 벡터(Latent Vector $c_{KV}$)’ 형태로 압축하여 VRAM에 올려둡니다. 실제 연산이 일어나는 순간에만 수학적 투영(Up-projection)을 통해 복원합니다.
    • 결과: 모델의 정확도 손실을 최소화하면서 KV 캐시 용량을 90% 이상 절감시켰고, 메모리 대역폭 병목을 해소하여 초당 토큰 생성 속도(TPS)를 극적으로 높였습니다.

    5. OpenAI vs Anthropic vs Google 인프라 비용 구조 비교

    세 대표 기업은 인프라를 바라보는 철학에서 근본적인 차이를 보입니다. Google은 자체 데이터센터와 자체 AI 칩(TPU)을 완벽히 소유한 수직계열화 하이퍼스케일러인 반면, OpenAI와 Anthropic은 외부 파트너의 인프라를 대규모 임차·계약하여 사용하는 ‘AI Lab’ 구조입니다.

    3사 인프라 전략 비교 요약 (2026년 8월 기준)

    구분GoogleAnthropicOpenAI
    인프라 구조자체 소유 하이퍼스케일러멀티클라우드 임차형임차형 (주로 MS Azure / Oracle)
    핵심 가속기 칩자체 설계 TPU (Ironwood / v7)Google TPU + AWS Trainium + NVIDIA 혼용NVIDIA GPU 위주 (자체 칩 ‘Jalapeño’ 개발 중)
    2026년 CapEx$1,950억 ~ $2,050억직접 CapEx 없음 (장기 임차 계약)직접 CapEx 없음 (Stargate 등 별도 SPV)
    토큰 원가 우위극상 (수직계열화 + NVIDIA 마진 제거)상 (멀티클라우드 최적화 및 TPU 활용)중 (NVIDIA GPU 고비용 구조 노출)
    재무적 리스크막대한 CapEx로 인한 단기 FCF 압박인프라 미보유로 공급사 가격 협상력 의존공급사 의존도 높음, 부채/SPV 가동

    1) Google: “자체 칩(TPU) + 자체 네트워크”의 압도적 원가 우위

    • NVIDIA 마진 제거: Google은 자체 설계한 TPU(Ironwood)를 사용함으로써 NVIDIA가 가져가는 70~80% 수준의 마진을 완전히 제거합니다. SemiAnalysis에 따르면 Google은 TPU를 통해 내부 워크로드 연산 비용을 NVIDIA 대비 최대 62% 절감하고 있습니다.
    • 광학 회로 스위칭(OCS) 네트워크: Google은 TPU 클러스터 연결에 자체 개발한 OCS(Optical Circuit Switching) 기술을 사용합니다. 이는 OpenAI가 사용하는 구리 기반 InfiniBand 네트워크 대비 확장 비용이 훨씬 저렴하며 전력 소비도 매우 낮습니다.
    • 데이터센터 구축 효율: 10만 개 칩 규모 프론티어 클러스터 기준, Google은 OpenAI가 데이터센터 1개를 지을 수 있는 비용으로 동급 규모 데이터센터 4개를 지을 수 있는 구조적 원가 격차를 확보했습니다.

    2) Anthropic: “현명한 멀티클라우드 레버리지” 전략

    • Anthropic은 단일 클라우드에 종속되지 않고 AWS(Trainium), Google Cloud(TPU), Azure(NVIDIA)를 모두 활용하는 정교한 멀티클라우드 전략을 취하고 있습니다.
    • 2025년 10월 Google과의 파트너십 확장을 통해 최대 100만 개의 TPU 칩 접근 권한을 확보했으며, 2026년 4월에는 Broadcom 및 Google과 협업하여 2027년부터 최대 5GW 규모의 차세대 TPU 용량을 추가 확보하는 대형 계약을 체결했습니다.
    • 향후 5년간 Google Cloud에만 2,000억 달러 지출을 약정하는 한편, AWS와의 주력 훈련 파트너십을 동시에 유지하면서 칩 공급사 간의 경쟁을 유도해 임차 비용을 극단적으로 낮추고 있습니다.

    3) OpenAI: GPU 의존도와 TPU의 견제 효과

    • OpenAI는 Microsoft Azure 및 Oracle 클라우드를 통한 NVIDIA GPU 리소스에 가장 크게 의존하고 있습니다.
    • 재미있는 점은, Google TPU의 막강한 가성비와 위협 덕분에 OpenAI 역시 NVIDIA와의 가격 협상에서 GPU 조달 비용을 약 30% 낮추는 반사 이익을 얻었다는 사실입니다. 경쟁사의 수직계열화 칩이 시장 전체의 GPU 공급가를 끌어내리는 가격 압박 요소로 작용하고 있습니다.

    주요 빅테크 4사 2026년 CapEx 가이던스 참고

    • Amazon (AWS): 약 2,000억 달러
    • Google (Alphabet): 1,950억 ~ 2,050억 달러 (2분기 실적 발표 후 상향)
    • Microsoft: 약 1,900억 달러
    • Meta: 1,250억 ~ 1,450억 달러
    • 합계: 2026년 하이퍼스케일러 4사의 총 CapEx는 약 7,000억 달러(약 950조 원)에 육박합니다.

    6. 투자 가이던스

    AI 산업이 자본집약적 훈련(Training) 단계에서 수익화·수율 중심의 추론(Inference) 서비스 단계로 완벽히 전환된 현 시점, 투자자들은 빅테크의 매출 성장률만 볼 것이 아니라 재무제표 상의 FCF(잉여현금흐름) 변화와 밸류체인 병목을 정밀하게 타격해야 합니다.

    (1) 단기 투자 가이던스 (6~12개월): “FCF 진통과 병목 수혜주 타격”

    1. 빅테크 CapEx 피크아웃 우려 및 FCF 압박 경계:
      • Alphabet의 2026년 2분기 사례처럼, CapEx 급증($449억)으로 영업현금흐름($391억)을 초과하면서 상장 후 최초로 분기 잉여현금흐름(FCF)이 마이너스(-$59억)를 기록하는 현상이 나타나고 있습니다.
      • 시장은 빅테크의 주가를 누르며 “이 막대한 지출이 언제 회수되는가”를 더욱 엄격하게 검증할 것입니다. 따라서 단기적으로 하이퍼스케일러 직접 매수보다는 빅테크가 강제로 돈을 쓸 수밖에 없는 ‘병목 길목’ 기업으로 자금을 이동시켜야 합니다.
    2. 메모리 대역폭(Memory Wall) 및 ASIC 최적화 수혜주:
      • ASIC 디자인하우스 & 파운드리: Broadcom(AVGO), TSMC(TSM) 등 Google TPU, AWS Trainium, Anthropic 연합의 수주를 독점하는 커스텀 칩 밸류체인의 실적 모멘텀이 매우 강력합니다.
      • HBM / CXL 밸류체인: 추론 병목 해소를 위한 HBM3e/HBM4 및 CXL 관련 핵심 장비·소재 기업에 대한 비중 확대를 추천합니다.

    (2) 중장기 투자 가이던스 (3~5년): “구조적 승자와 인프라 패러다임 전환”

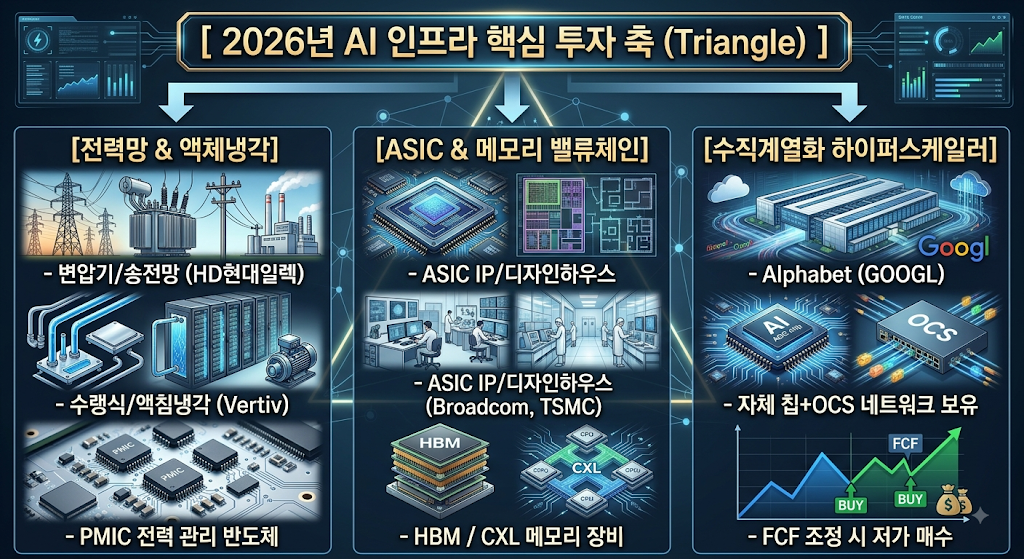
    1. 전력망(Grid) 및 액체 냉각(Liquid Cooling): GPU보다 강력한 진짜 승자:
      • 데이터센터 건설의 절대 병목은 칩이 아니라 변전소 대기 시간(4년+)과 전력 공급입니다.
      • 전력 인프라: 초고압 변압기, 송전선로, 전력 기기 제조업체(HD현대일렉트릭, 효성중공업, Eaton, Schneider Electric) 및 전력 효율화 PMIC 기업을 포트폴리오의 절대적 핵심 축으로 구성해야 합니다.
      • 냉각 솔루션: 랙당 40~120kW+ 발열을 잡기 위한 액체 냉각(CDU, 열교환기, 액침냉각) 전문 기업(Vertiv 등)을 선점하십시오.
    2. 수직계열화 하이퍼스케일러(Google)의 재평가:
      • Google(Alphabet)은 자체 TPU + OCS 광학 네트워크 + 자체 데이터센터를 통해 토큰당 생산 원가 하한선을 지킬 수 있는 유일무이한 공룡입니다. 단기 CapEx 과다로 인한 FCF 우려로 주가가 조정을 받을 때마다 가장 적극적으로 분할 매수해야 할 장기 1순위 자산입니다.

    3) 포트폴리오 자산 배분 전략 요약

    자산군 / 핵심 테마추천 비중 및 투자 전략핵심 대상 종목 및 밸류체인
    전력 & 냉각 인프라[비중 확대] (35%)
    빅테크 CapEx 집행의 가장 확실한 길목
    변압기, 송전망, Vertiv, HD현대일렉트릭, Eaton
    ASIC & 반도체 IP/파운드리[비중 확대] (30%)
    NVIDIA 독주 완화 및 커스텀 TPU/ASIC 전환 수혜
    Broadcom, TSMC, HBM/CXL 패키징 장비사
    수직계열화 빅테크[분할 매수] (25%)
    FCF 훼손 우려로 조정 시 저가 매수
    Alphabet (GOOGL) – 자체 칩/네트워크 완비
    Big GPU 설계사[보유/트레이딩] (10%)
    여전히 강력하나 단가 압박 점검 필요
    NVIDIA – ASIC 침투율 및 클라우드 단가 추이 모니터링

    에필로그: 블로거의 최종 인사이트

    “토큰 1개를 만드는 생산 원가가 3년 만에 1,000배 떨어졌다는 것은, AI 기술의 종말이 아니라 ‘PC의 보급’이나 ‘인터넷 초고속망의 대중화’ 시대로 진입했음을 의미합니다.

    기술이 보편화되고 추론 서비스가 일상화되는 역사적 대전환기에는 단순 연산 칩을 파는 기업보다 ‘전력과 냉각을 공급하는 기업’, ‘원가 절감 소프트웨어 및 압축 아키텍처(PagedAttention/MLA)를 보유한 기업’, 그리고 ‘자체 공급망 수직계열화로 토큰 단가의 마지노선을 지키는 하이퍼스케일러’가 시장의 진짜 알짜 수익을 독식하게 될 것입니다.”

    관련 기사:

    https://www.hankyung.com/article/2026081868306

  • [2026.08.18] 대한민국 원유 수입 비중 미국산 첫 20% 돌파: 호르무즈 봉쇄 지정학 및 국내 정유 4사 투자·공정 심층 분석

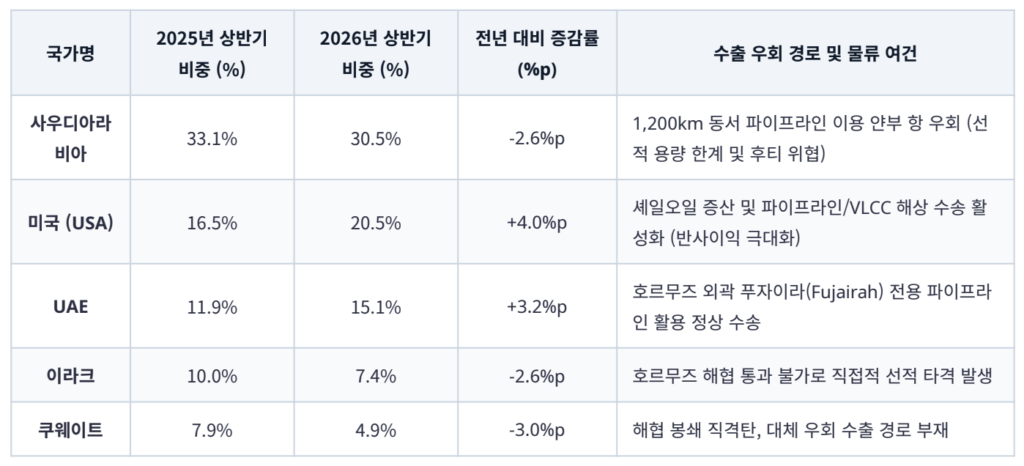
    2026년 상반기 대한민국 원유 수입 구조 변화를 설명하는 인포그래픽. 이란의 호르무즈 해협 봉쇄 영향으로 미국산 원유 수입 비중이 최초로 20%를 돌파(2025년 상반기 16.5% -> 2026년 상반기 20.5%)한 현상을 다룹니다. 국가별 수입 비중 변화(사우디아라비아 30.5%, UAE 15.1%), 중동의 고유황 중질유에 최적화된 국내 정유 설비가 미국산 경질 셰일오일을 가공할 때 발생하는 기술적·경제적 구조적 과제, 그리고 단기(높은 정제마진 및 재고평가이익)·중기(설비 디보틀네킹 및 비축유)·장기(탈탄소화 및 신에너지) 관점의 정유사 투자 프레임워크를 정밀하게 표현한 이미지.

    올해 상반기 대한민국 원유 수입 비중에서 큰 변곡점이 보였습니다. 미국산 원유 수입 비중이 반기 기준 최초로 20%를 돌파(20.5%)한 것입니다. 이란의 호르무즈 해협 봉쇄라는 대형 지정학적 악재 속에서 대한민국 정부와 정유 업계가 발 빠르게 수입선 다변화를 추진한 결과입니다.

    이번 포스팅에서는 최신 통계 수치, 지정학적 물리 수송망, 국내 정유 설비(API 경질화/고도화 공정)의 기술적 특성, 국가 간 석유제품 외교 지렛대(Energy Diplomacy), 그리고 정유 4사(SK이노베이션, GS칼텍스, S-Oil, HD현대오일뱅크)의 실질 수혜 및 투자의견을 종합하여 깊이 있게 다루어 보겠습니다.

    목차

    1. 서론: 상반기 원유 도입 통계와 미국산 20% 돌파의 의의
    2. 지정학적 충격: 호르무즈 해협 봉쇄와 중동 산유국별 우회 수송망 분석
    3. 에너지 안보의 역발상: 석유제품 수입 의존국을 활용한 외교 지렛대 (호주, 미국, 뉴질랜드, 일본)
    4. ‘탈중동’ 전략의 기술적 허들: API Mismatch와 정유 설비 공정 메커니즘
    5. 정부 비상 지원책: 수입부과금 100% 전액 환급 및 정유 4사 수혜 규모 정밀 추정
    6. 섹터 전망 & 최종 종목별 투자 전략

    1. 서론: 상반기 원유 도입 통계와 미국산 20% 돌파의 의의

    한국석유공사의 2026년 상반기(1월~6월) 원유 도입 통계에 따르면, 대한민국 원유 도입량은 총 4억 6,712만 배럴로 집계되었습니다.

    • 사우디아라비아: 1억 4,247만 배럴 (전체 30.5%)로 1위를 유지했으나, 전년 동기(33.1%) 대비 -2.6%p 감소했습니다.
    • 미국 (USA): 9,587만 배럴 (전체 20.5%)을 기록하며 사상 처음으로 20% 벽을 돌파했습니다. 전년 동기(16.5%) 대비 +4.0%p 급증한 수치입니다.
    • UAE (아랍에미리트): 15.1% (+3.2%p 상승)
    • 이라크: 7.4% (-2.6%p 하락)
    • 쿠웨이트: 4.9% (-3.0%p 하락)

    대륙별로 살펴보면 중동산 비중이 68.7% → 62.3% (-6.4%p)로 크게 낮아진 반면, 미주산(23.4% → 26.5%, +3.1%p)과 아프리카산(2.0% → 5.6%, +3.6%p) 비중이 상승하며 대중동 의존도를 완화하는 구조적 전환이 뚜렷하게 확인되었습니다.

    원유 도입 총액은 유가 상승 영향으로 전년 대비 8.1% 증가한 413억 6,700만 달러(약 58조 4,515억 원)를 기록했습니다. 반면 한국 정유사들의 석유제품 수출액은 281억 7,400만 달러(약 39조 8,098억 원)로 무려 36.5% 급증하여 정제마진 폭등의 수혜를 누렸습니다.

    2. 지정학적 충격: 호르무즈 해협 봉쇄와 중동 산유국별 우회 수송망 분석

    중동 유전지대에서 생산되는 원유의 주요 출구인 호르무즈 해협이 이란에 의해 점거 및 봉쇄되면서 산유국별 대체 수송망의 유무에 따라 희비가 갈렸습니다.

    (1) 사우디아라비아: 파이프라인의 물리적 한계와 홍해 후티 위협

    사우디는 동부 유전지대 원유를 약 1,200km 길이의 동서 파이프라인(East-West Pipeline)을 통해 서부 연안 항구인 얀부(Yanbu)로 수송해 홍해로 출하했습니다. 하지만 얀부 항의 일일 최대 선적 용량은 약 500만 배럴 수준으로 한정적이며, 예멘 후티 반군의 홍해 항로 공격 위험이 지속되면서 수송에 병목 현상이 발생했습니다.

    (2) UAE: 호르무즈 외곽 푸자이라(Fujairah)의 반사이익

    UAE는 호르무즈 해협 바깥인 오만만에 위치한 푸자이라 전용 파이프라인을 적극 활용해 정상 수출을 이어갔습니다. 이에 따라 한국으로의 도입 비중도 11.9%에서 15.1%로 상승했습니다.

    (3) 이라크 & 쿠웨이트: 우회 경로 부재에 따른 직접적 타격

    호르무즈 해협 통과에 100% 의존하는 이라크와 쿠웨이트는 해협 봉쇄 직격탄을 맞아 출하량이 급감하였으며, 한국 도입 비중 역시 각각 -2.6%p, -3.0%p 하락했습니다.

    3. 에너지 안보의 역발상: 석유제품 수입 의존국을 활용한 외교 지렛대

    대한민국은 원유를 전량 수입하는 국가이지만, 세계 5위 수준인 일일 330만 배럴 규모의 고도화 정제 인프라를 갖춘 ‘글로벌 정제 스윙 프로듀서(Swing Producer)’입니다. 탈산업화 및 환경 규제로 정유 시설을 폐쇄한 주변국들은 한국산 정제 석유제품에 절대적으로 의존하고 있으며, 이는 강력한 에너지 외교 지렛대로 작용하고 있습니다.

    • 호주 (Australia): 자국 정유공장 폐쇄로 석유제품의 90%를 수입하며, 한국산 점유율이 29.1%에 달합니다. 특히 디젤(경유) 공급 불안에 직면한 호주는 한국에 안정적 정제유 공급을 요청했고, ‘한-호주 에너지자원 안보 공동성명’을 통해 한국의 LNG 및 원유 확보 우선권을 보장하는 상호 의존 협정을 체결했습니다.
    • 미국 (USA): 서부 및 하와이 등 특정 지역 정제 능력 부족으로 한국산 항공유 수입 의존도가 68.6%에 이릅니다. 한국은 항공유를 안정적으로 공급하는 대신 WTI 등 미국산 원유의 안정적 할당 및 원활한 수송 협력을 확보했습니다.
    • 뉴질랜드 & 일본: 뉴질랜드는 정제 설비가 전무하여 SK에너지 등 국내 정유사와 장기 공급 관계를 유지하고 있으며, 일본 역시 정제 설비 축소에 따른 디젤 숏티지를 막기 위해 한국 정부에 수출 제한 조치 자제를 공식 요청했습니다.

    4. ‘탈중동’ 전략의 기술적 허들: API Mismatch와 정유 설비 공정 메커니즘

    미국산 셰일오일 비중 확대가 무조건적인 장밋빛 미래를 뜻하지는 않습니다. 여기에는 정유 공학적인 기술적 허들이 존재합니다.

    API Mismatch (경질유 vs 중질유 처리 제약)

    • 국내 정유 설비 구조: 고유황 중질유(Heavy Crude, API 20~30)를 가공해 높은 마진을 내는 중질유 유분해/탈황 고도화 시설 중심으로 수십 년간 최적화되었습니다.
    • 미국산 셰일오일 특성: 황 함량이 낮고 API가 40 이상인 초경질유(Light Sweet Crude)입니다.
    • 공정 트러블 & 수율 문제: 미국산 경질유를 단독 투입할 경우, 고도화 설비 가동률이 저하되고 마진이 적은 나프타/LPG 유분 생산량이 과도하게 늘어나 정제마진이 오히려 훼손될 수 있습니다.

    따라서 국내 정유사들은 미국산 경질유와 기존 중질유를 이상적인 비율로 혼합하는 Blending(믹싱) 기술을 극대화하여 공정 수율을 방어하고 있습니다.

    5. 정부 비상 지원책: 수입부과금 100% 전액 환급 및 정유 4사 수혜 규모 정밀 추정

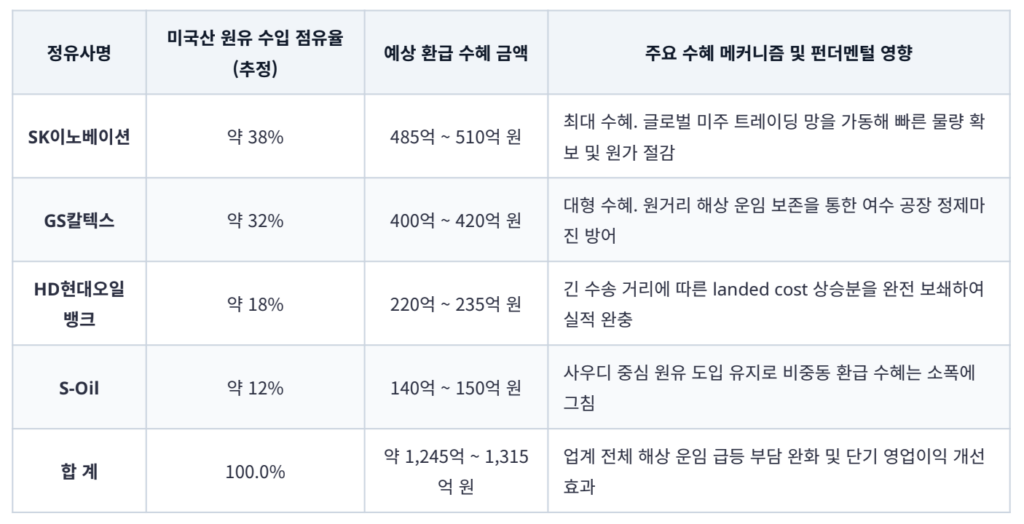
    정부는 비중동 원유 수입 시 발생하는 긴 해상 수송 거리 및 운임 부담을 보전하기 위해 수입부과금 환급 고시를 개정했습니다. 기존에는 초과 운임의 25%만 지원했으나, 한시적으로 초과 운임의 100%(리터당 최대 16원, 배럴당 약 $1.86 / 약 2,544원)를 전액 환급해 주는 파격적인 조치를 단행했습니다.

    정유 4사별 예상 환급 수혜액 및 설비 유연성 비교 (3~4개월 지원 기준)

    1. SK이노베이션 (울산/인천, 일 84만 배럴)
      • 설비 유연성: ★★★★☆ (국내 최대 규모, 인천석유화학 초경질유 가공 노하우 보유)
      • 미국산 수입 점유율(추정): 약 38%
      • 환급 수혜 금액: 약 485억 ~ 510억 원 (최대 수혜)
    2. GS칼텍스 (여수, 일 80만 배럴)
      • 설비 유연성: ★★★★☆ (고도화율 34.3%, 정제유-석유화학 NCC 연계 공정 우수)
      • 미국산 수입 점유율(추정): 약 32%
      • 환급 수혜 금액: 약 400억 ~ 420억 원
    3. HD현대오일뱅크 (대산, 일 52만 배럴)
      • 설비 유연성: ★★★☆☆ (고도화율 40% 이상으로 중질유 가공 최적화 구조)
      • 미국산 수입 점유율(추정): 약 18%
      • 환급 수혜 금액: 약 220억 ~ 235억 원
    4. S-Oil (울산, 일 66.9만 배럴)
      • 설비 유연성: ★★★☆☆ (사우디 아람코 장기 계약 중심 구조)
      • 미국산 수입 점유율(추정): 약 12%
      • 환급 수혜 금액: 약 140억 ~ 150억 원

    6. 섹터 전망 & 최종 종목별 투자 전략

    현재 대한민국 정유 산업은 “지정학적 위험에 따른 정제마진 폭등(단기 모멘텀)”과 “원유 도입 다변화에 따른 운송비 및 API 공정 마찰(중장기 원가 구조)”이 공존하는 정점에 위치해 있습니다.

    정유 섹터 전체에 대해 [Overweight (비중확대)] 투자의견을 유지하며, 단기 실적 모멘텀과 중장기 체질 개선 능력에 따라 차별화된 접근을 권장합니다.

    💡 최종 종목별 추천 전략

    • 단기 Top Pick (3~6개월): SK이노베이션
      • 사유: 수입부과금 100% 환급 조치의 최대 수혜(약 500억 원 원가 절감) 및 미국·호주 등 석유제품 수출 판가 전가력이 가장 뛰어난 최대 정제 규모 보유.
    • 중장기 Defensive Top Pick (1년 이상): S-Oil
      • 사유: 사우디 아람코의 공급망 복원력 및 2026년 이후 본격 가동되는 ‘샤힌 프로젝트(Shaheen Project, Crude-to-Chemicals)’를 통해 원유를 석유화학 기초유분으로 직접 전환하여 도입선 변동성을 완전 흡수할 수 있는 최고의 체질 개선주.

    🏷️ 관련 기사

    https://n.news.naver.com/mnews/article/032/0003464713

  • [2026.08.13]엔비디아의 파격적 반격: 1조 파라미터 ‘네모트론 4’와 오픈소스 AI 패권 전쟁

    엔비디아의 파격적 반격
[인포그래픽 제목]
THE OPEN-SOURCE AI BATTLEGROUND (AUGUST 2026)
(2026년 8월 오픈소스 AI 전장)
[상단 좌측: 엔비디아의 전략적 공세]
- 제목: NVIDIA's 1 TRILLION PARAMETER OFFENSIVE: "NEMOTRON 4" (IN DEVELOPMENT)
- 인물: 젠슨 황(NVIDIA CEO)의 일러스트 및 말풍선 인용구 "Free AI is good for our hardware & chips."
- 그래픽: Blackwell Ultra/B300 서버 인프라에서 뇌 모양의 1T+ 파라미터 게이지로 연결되는 데이터 흐름.
- 체급 비교 (NVIDIA Nemotron Evolution): 기존 Nemotron 3 Ultra (550B) 대비 개발 중인 New Nemotron 4 (1T+)의 2배 규모 성장 시각화.
- 핵심 전략 (Key Strategies): 
  1. GPU Demand Boost (GPU 수요 증대)
  2. Sovereign AI Growth (소버린 AI 성장 육성)
  3. Defeating China's Rise (중국 AI의 부상 방어)

[상단 우측: 글로벌 오픈소스 리더보드 (2026년 8월 7일 기준)]
- 1위: Kimi K3 (Moonshot AI)
- 2위: GLM-5.2 (Z.ai)
- 3위: Kimi K2.6 (Moonshot AI)
- 4위: DeepSeek-V4-Pro-Max (DeepSeek)
- 5위: GLM-5.1 (Z.ai)
- 6위: Qwen3.5-397B-A17B (Alibaba)
- 7위: DeepSeek-V4-Flash-Max (DeepSeek)
- 주석: 상위 7개 모델을 모두 중국계 기업이 차지함. Llama, Gemma, Nemotron 등 미국 모델은 최상위권 진입 실패.
- 중국 상승 요인: 빠른 R&D, 글로벌 개발자 생태계 흡수, 연구소 간 협력 구조.

[하단: 기업 및 투자자를 위한 오픈소스 AI 선택 가이드]
1. TOP PERFORMANCE (비용 무관 최고 성능): KIMI K3 (왕관과 뇌 아이콘)
2. CODING & AGENTS + LIBERAL LICENSE (코딩 및 에이전트 + 자유 라이선스): GLM-5.2 (MIT LICENSE) (코드 화면과 로봇 팔 악수 아이콘)
3. MASS PROCESSING & LOWEST COST (대량 처리 및 최저 비용): DEEPSEEK V4 FLASH ($0.16 / 1M Tokens blended) (동전, 계산기, 속도 아이콘)
4. LARGE CODEBASE & CONTEXT (대규모 코드베이스 및 긴 문맥): QWEN3.6-PLUS (256K+ Context) (네트워크 지식 그래프 아이콘)

[하단 우측: 투자자 인사이트]
- "Compute Business" Paradox & Investor Insights:
  - Open-Weight ≠ Open-Source (라이선스 필수 확인)
  - 오픈 모델 이니셔티브는 결론적으로 NVIDIA GPU 판매를 촉진함.
  - 하드웨어와 소프트웨어의 수직 통합이 엔비디아의 궁극적인 기술적 도랑(Moat)임.

    2026년 8월 현재, 글로벌 인공지능(AI) 생태계는 역사상 가장 치열하고 복잡한 전환점을 지나고 있습니다. 최근 로이터(Reuters)와 디인포메이션(The Information)의 보도에 따르면, 엔비디아(NVIDIA)가 완전히 새로운 차원의 차세대 대형 언어 모델 ‘네모트론 4(Nemotron-4)’를 전격 개발 중인 것으로 확인되었습니다.

    이번 포스팅에서는 어제 공개된 엔비디아의 파격적인 행보와 함께, 최신 오픈소스 AI 시장의 실태, 기술적 메커니즘, 그리고 젠슨 황 CEO가 그리는 하드웨어-소프트웨어 수직 통합 비즈니스 전략까지 깊이 있게 파헤쳐 보겠습니다.

    1. 2026년 8월, 1조 파라미터급 ‘신형 네모트론 4’의 전격 등장

    1조 파라미터(1T+) 체급으로의 대전환

    이번 보도로 밝혀진 신형 네모트론 4는 지난 모델들과 체급 자체가 다릅니다. 최상위 모델의 파라미터(매개변수) 수만 최소 1조 개(1 Trillion+) 수준으로, 지난 6월에 공개되었던 Nemotron 3 Ultra(5,500억 개) 대비 무려 2배 이상 커진 규모입니다.

    엔비디아가 이토록 거대한 거대언어모델(LLM)을 직접 사전학습(Pre-training)하는 배경에는 “글로벌 최정상급 오픈소스 AI 주도권을 되찾겠다”는 강한 위기감이 자리 잡고 있습니다.

    전폭적인 자원 투입과 컴퓨팅 재임차

    엔비디아는 신형 네모트론 4 개발을 위해 미증유의 인적·물적 자원을 쏟아붓고 있습니다.

    • 인력 투입: 직전 모델인 Nemotron 3 Ultra의 논문 저자만 570명에 달했는데, 이번 프로젝트에는 이를 뛰어넘는 수의 핵심 연구진이 참여하고 있습니다.
    • 컴퓨팅 인프라 재임차: 엔비디아는 자사의 최신 GPU(Blackwell Ultra / B300 등)를 구매해 간 주요 클라우드 서비스 제공업체(CSP)들로부터 서버를 다시 역임차(Lease-back)하는 파격적인 방식으로 초대형 인프라를 확보했습니다.

    이 프로젝트는 현재 사전학습 데이터 구축과 기본 아키텍처 설계를 마치고, 이르면 올해 늦가을 출시를 목표로 막바지 준비 단계에 돌입해 있습니다.

    2. 네모트론-4 340B로 증명된 기술적 핵심: ‘합성 데이터’ 파라다임

    엔비디아가 1조 파라미터라는 거대 모델을 효율적으로 정렬(Alignment)할 수 있는 핵심 기술 기반은 이미 Nemotron-4 340B에서 완벽히 검증되었습니다.

    1) Instruct + Reward 모델 쌍 기반 데이터 파이프라인

    1. 응답 생성: Nemotron-4-340B-Instruct 모델이 수많은 입력 프롬프트에 대해 다각도의 후보 응답을 생성합니다.
    2. 다차원 평가: Nemotron-4-340B-Reward 모델이 각 응답을 유용성(Helpfulness), 정확성(Correctness), 일관성(Coherence), 복잡성(Complexity), 장황함(Verbosity) 등 5가지 핵심 정밀 속성으로 채점합니다.
    3. 자동 필터링: 기준 점수를 통과한 최상위 데이터만 골라내어 RLHF(인간 피드백 기반 강화학습)를 대체하는 RLAIF(AI 피드백 기반 강화학습) 정렬 데이터셋을 구축합니다.

    2) Daring Anteater 데이터셋의 충격적 성과

    엔비디아는 이 자동화 파이프라인을 통해 단 10만 행으로 구성된 ‘Daring Anteater’ 합성 데이터셋을 제작했습니다. 이를 활용해 Meta의 오픈 모델인 Llama-3 70B Base 모델을 정렬한 결과, 사람이 직접 데이터 라벨링을 진행한 비중이 1% 미만이었음에도 불구하고 Meta의 공식 Llama-3-70B-Instruct 성능을 상회하는 엄청난 결과를 얻었습니다.

    실제 엔비디아 모델 정렬 과정에 사용된 데이터의 98% 이상이 합성 데이터(Synthetic Data)로 채워졌으며, 이는 1조 파라미터급 차세대 네모트론 4 개발에서도 핵심 동력이 될 것입니다.

    3. 엔비디아의 비즈니스 셈법: “소프트웨어는 공짜, 하드웨어로 돈을 번다”

    엔비디아는 왜 막대한 자금을 들여 만든 프런티어급 AI 모델을 전 세계에 무료(오픈 웨이트)로 뿌리는 걸까요? 여기에는 젠슨 황 CEO의 철저히 계산된 하드웨어 비즈니스 셈법이 작동하고 있습니다.

    “무료 AI는 하드웨어에 좋을 수밖에 없고, 칩에 좋을 수밖에 없다.”

    — 젠슨 황 (NVIDIA CEO, 악시오스 인터뷰 중)

    1) 고객 다변화 및 Big Tech 탈피 전략

    OpenAI, Microsoft, Meta 등 엔비디아의 핵심 고객사들이 독자적인 AI 반도체(ASIC) 개발을 통해 GPU 의존도를 낮추려 시도하고 있습니다. 엔비디아는 최고 성능의 오픈 AI 모델을 무상으로 시장에 풀음으로써 글로벌 스타트업, 일반 기업, 국가 단위의 소버린 AI(Sovereign AI) 진영을 육성하고 있습니다. 결국 전 세계적으로 AI 도입이 폭발할수록, 이를 돌릴 엔비디아 GPU 판매량은 지속 증가하게 됩니다.

    2) 하드웨어 Co-design 및 스트레스 테스트

    1조 파라미터 사전학습은 그 자체로 최첨단 하드웨어 한계 테스트입니다. 엔비디아는 자사 최신 GPU인 Blackwell Ultra 단지 및 NVLink 인터커넥트 통신 인프라상에서 1조 파라미터 모델을 직접 훈련시키며, 차세대 CUDA 라이브러리와 하드웨어 병목(De-bottlenecking)을 미리 포착하고 완벽히 최적화합니다.

    3) 에이전트 라우팅 생태계 주도

    어제 함께 발표된 NeMo Switchyard 및 Nemotron 3.5 Lightning은 초대형 판단 작업은 1조 파라미터 모델(Nemotron-4)에 맡기고, 반복적인 작업은 하위 소형 MoE(Mixture of Experts) 모델에 할당하는 에이전트 오케스트레이션 기술입니다. 엔비디아는 소프트웨어 SDK 프레임워크까지 지배하여 글로벌 개발자 생태계를 완전히 흡수하려 합니다.

    4. 2026년 8월 현재, 오픈소스 AI 시장 현황 분석

    현재 오픈소스(오픈 웨이트) AI 시장은 미·중 간의 기술 격차가 역전되었을 정도로 격변하고 있습니다.

    1) LLM Stats 리더보드 (2026년 8월 7일 기준)

    순위모델명개발사 (국가)종합 점수추론 지수코딩 점수컨텍스트
    1Kimi K3Moonshot AI (중국)55.454.545.4100만 토큰
    2GLM-5.2Z.ai (중국)46.846.138.4100만 토큰
    3Kimi K2.6Moonshot AI (중국)44.644.835.226.2만 토큰
    4DeepSeek-V4-Pro-MaxDeepSeek (중국)43.743.933.7100만 토큰
    5GLM-5.1Z.ai (중국)40.440.133.120만 토큰
    6Qwen3.5-397B-A17BAlibaba (중국)39.739.523.1–
    7DeepSeek-V4-Flash-MaxDeepSeek (중국)39.440.229.4100만 토큰

    ⚠️ 놀라운 현실: 오픈소스 종합 리더보드 상위 1위부터 7위까지가 모두 중국 기술 기업입니다. Meta의 Llama, Google의 Gemma, 엔비디아의 기존 Nemotron 등 미국의 주요 오픈 모델들은 종합 Top 7 진입에 실패하였으며, Nemotron 3 Ultra조차 종합 40위권 밖으로 밀려나 있는 실정입니다.

    2) 분야별 최강자 및 추천 가이드

    • 순수 추론(Reasoning): Moonshot AI의 Kimi K3가 54.5점으로 압도적 1위입니다.
    • 코딩 & 에이전트(Coding/Agent): GLM-5.2는 코딩 점수 38.4점에 MIT 라이선스를 채택해 기업들의 상업적 실무 채택률이 매우 높습니다. 대규모 코드베이스 분석에는 Qwen3.6-Plus가 선호됩니다.
    • 비용 대비 성능(API 가성비): DeepSeek-V4-Flash-Max는 100만 토큰당 혼합 가격이 $0.16에 불과해, Kimi K3($4.33) 대비 27배 이상 저렴합니다. 대량 반복 작업에 최적입니다.
    • 한국어 및 다국어 특화: 글로벌 언어는 Qwen 계열(201개 언어)이 우수하지만, 국내 기업 실무 환경에서는 네이버 HCX, 카카오 Kanana, LG EXAONE 3.5 같은 국산 특화 모델의 만족도가 훨씬 높습니다.

    5. 오픈소스 AI 도입 시 반드시 알아야 할 3가지 쟁점

    기업 및 투자자 입장에서 오픈소스 AI 생태계를 접할 때 유의해야 할 필수 개념들입니다.

    1) ‘오픈소스(Open Source)’ vs ‘오픈 웨이트(Open Weights)’

    대부분의 오픈 AI 모델은 엄밀히 말해 ‘오픈 웨이트’입니다. 모델의 가중치(Weights) 파일은 다운로드할 수 있지만, 학습에 쓰인 수십 테라바이트의 원본 데이터나 구체적 코드는 공개되지 않습니다.

    또한, GLM-5.2처럼 제약이 거의 없는 MIT 라이선스가 있는 반면, Kimi K3나 Llama 시리즈처럼 특정 월간 활성 사용자 수(MAU)나 대형 상업 서비스 이용 시 별도 계약을 요구하는 자체 라이선스도 많으므로 법적 검토가 필수적입니다.

    2) 서빙 인프라 스택의 발전: vLLM & SGLang

    과거에는 가중치를 받아도 이를 효율적으로 구동할 추론 엔진이 부족했습니다. 하지만 2026년 현재, UC 버클리 LMSYS 팀이 주도하는 vLLM이 글로벌 GPU 서빙의 표준 표준으로 자리 잡았고, 구조화된 출력(Structured Output)에 강한 SGLang 기술이 안착하며 기업들의 로컬 구축(On-Premise) 장벽이 대폭 낮아졌습니다.

    3) 거대 모델의 호스팅 부담

    1위 모델인 Kimi K3는 총 파라미터가 2.8조 개(활성 1,040억 개)에 달하여, 온프레미스로 직접 구축하려면 막대한 고성능 클라우드 인프라가 요구됩니다. 반면 DeepSeek V4 Flash 등 가성비 파이프라인을 혼합 구성하는 것이 현명한 AI 엔지니어링 전략입니다.

    6. 결론 및 경제 블로거로서의 투자 인사이트

    중국 AI 랩들이 막대한 연구진과 빠른 반복 개발(Iterative development)을 통해 글로벌 오픈 생태계의 주도권을 장악하자, 엔비디아는 “1조 파라미터 네모트론 4″라는 카드로 정면 승부를 선언했습니다.

    [ 엔비디아의 네모트론 4 정면 승부 3대 핵심 목표 ]
    
    1. 오픈 생태계 주도권 탈환 (중국 독주 저지)
    2. 빅테크 자사 칩(ASIC) 견제 및 글로벌 고객층 다변화
    3. 하드웨어(Blackwell GPU) + 소프트웨어(NeMo/CUDA) 통합 락인

    투자자 시선에서 이번 사태는 엔비디아의 모트(Moat, 기술적 도랑)가 하드웨어 단품에 그치지 않고 소프트웨어 생태계로 더욱 강고해지고 있음을 보여줍니다. AI 기술 확산이 가속화될수록 컴퓨팅 파워 수요는 지속해서 늘어날 수밖에 없습니다.

    올가을 베일을 벗을 엔비디아의 1조 파라미터 신형 네모트론 4가 과연 중국 오픈 모델 진영의 거센 추격을 꺾고 글로벌 AI 인프라 시장의 왕좌를 더욱 공고히 할 수 있을지, 지속적으로 주목해 보시기 바랍니다!

    관련기사:

    https://n.news.naver.com/mnews/article/029/0003042054

  • [2026.08.12] CXL(Compute Express Link) 패러다임 대전환

    AI 추론 시대의 메모리 구원투수 Compute Express Link(CXL): 기술적 본질, 3대 병목, 그리고 투자 전략 보고서

    Compute Express Link(CXL) 경로: POC에서 부분 상용화까지 (CXL Path: PoC to Partial Commercialization - 2026):

글의 맥락: 포스팅 1절과 3절에서 다룬 CXL 표준 발전사(1.0에서 3.2)와 현재 상용화 수준(PoC 완료 및 초기 양산)을 시각화했습니다. 2026년 이정표에는 삼성과 SK하이닉스 로고를 배치하여 국내 기업의 주도성을 강조했습니다.

전통적 메모리 vs. CXL 풀드 메모리 (Traditional Memory VS CXL Pooled Memory):

글의 맥락: 포스팅 2절 "메모리를 나눠 쓸 수 있게 해주는 고속 통로"의 핵심 개념인 '메모리 풀링(Pooling)'과 '유휴 메모리(Stranded Memory)' 문제 해결 과정을 직관적으로 대조했습니다. CXL 스위치가 여러 CPU 간 메모리를 유연하게 배분하는 모습을 보여줍니다.

글로벌 CXL DRAM 모듈 시장 성장 (Global CXL DRAM Module Market Growth 2024-2031):

글의 맥락: 귀하가 제공한 투자 가이드 섹션의 시장 규모 전망 데이터를 활용하여, 연평균 성장률(CAGR)을 시각화했습니다. 2024년 15.9억 달러에서 2031년 63.1억 달러로 약 4배 성장하는 추세를 명확히 보여주어 투자 모멘텀을 제시합니다.

AI를 위한 계층형 메모리 아키텍처 (Layered Memory Architecture for AI):

글의 맥락: 포스팅 4절 "HBM vs CXL: 상호보완적 동반자" 섹션의 핵심 기술적 정답을 피라미드 계층 구조로 시각화했습니다. 'Hot Data'를 위한 Tier 1 HBM과 'KV Cache/Warm Data'를 위한 Tier 2 CXL DRAM의 역할 분담을 명확히 보여줍니다.

    그동안 AI 반도체 시장의 주연은 HBM(고대역폭메모리)이었지만, AI 서비스의 축이 ‘학습(Training)’에서 ‘추론(Inference)’으로 이동함에 따라 메모리 용량과 운용 비용(TCO)의 병목이 심화되고 있습니다. 이러한 상황에서 CXL은 HBM의 물리적·경제적 한계를 완벽히 보완할 핵심 솔루션으로 손꼽히고 있습니다.

    📑 목차 (Table of Contents)

    1. 서론: 왜 지금 CXL인가? (AI 추론 시대의 메모리 대전환)
    2. 개념과 작동 원리: 직관적 이해부터 하드웨어 구조까지
    3. 표준 발전사
    4. HBM vs CXL: 대립 관계인가, 상호보완적 동반자인가?
    5. 상용화를 가로막는 3대 핵심 병목 (Bottlenecks)
    6. 글로벌 밸류체인 및 생태계 기업 지도 (Ecosystem Map)
    7. 투자자를 위한 단기 vs 중장기 프레임워크 & 포트폴리오 전략
    8. 결론 및 최종 요약

    1. 서론: 왜 지금 Compute Express Link인가?

    생성형 AI 패러다임이 급격히 진화하면서 빅테크 및 데이터센터들의 인프라 구축 우선순위가 크게 바뀌고 있습니다. 초기에는 ChatGPT, Claude 등 대규모 언어모델(LLM)을 빠르게 연산·학습시키기 위해 초고속 대역폭을 가진 HBM(High Bandwidth Memory) 중심의 GPU 인프라 확충이 사활을 걸었던 과제였습니다.

    그러나 GPT-4o, Gemini, Claude 3.5 등 초거대 멀티모달 모델들이 대중적인 서비스로 정착하면서, 데이터센터의 핵심 지표는 단순한 연산 파워에서 ‘추론 비용 절감 및 대용량 맥락 처리’로 이동했습니다.

    💡 추론형 AI의 핵심 병목: KV 캐시(Key-Value Cache)의 폭발적 증가

    추론형 AI 서비스의 가장 큰 특징은 수많은 사용자가 동시에 길고 복잡한 대화를 주고받는다는 점입니다. 이때 AI 모델이 이전 대화의 문맥(Context)을 기억하고 유기적인 답변을 생성하기 위해 필연적으로 생성·저장하는 데이터가 바로 ‘KV 캐시(Key-Value Cache)’입니다.

    • 문제점: 대화의 길이가 길어지고 컨텍스트 윈도우(Context Window)가 커질수록 KV 캐시 데이터는 기하급수적으로 증가합니다.
    • HBM의 한계: GPU 바로 옆에 붙어 있는 HBM은 연산 속도는 극도로 빠르지만, 가격이 매우 비싸고 GPU 당 장착할 수 있는 물리적 용량(VRAM)에 엄격한 한계가 존재합니다.
    • 해결책의 등장: 비싸고 용량이 작은 HBM에 대용량 KV 캐시를 모두 담을 수 없게 되면서, ‘HBM에는 당장 연산할 Hot Data만 두고, 대용량 KV 캐시는 CXL 메모리로 이관한다’는 새로운 메모리 계층화 전략이 성립하게 되었습니다.

    삼성전자, SK하이닉스, 마이크론 등 메모리 3사가 최근 미국 FMS(Future Memory and Storage) 2026 등 글로벌 반도체 학회에서 CXL 기술을 전면에 내세우는 이유가 바로 여기에 있습니다.

    2. 기본 개념과 작동 원리: 직관적 이해부터 하드웨어 구조까지

    2.1 직관적 개념: “메모리를 유연하게 나눠 쓰는 고속 고속도로”

    기존 컴퓨팅 메인보드 구조에서는 CPU나 GPU에 D램 슬롯이 물리적으로 직접 결합되어 있었습니다. 마더보드 슬롯 수가 제한되어 있어 서버 1대가 쓸 수 있는 메모리 최대 용량도 고정되었습니다.

    이로 인해 전통적인 데이터센터에는 ‘유휴 메모리(Stranded Memory)’ 문제가 발생했습니다:

    • 기존 구조: A 서버는 메모리가 70% 남아돌고, B 서버는 메모리가 부족해 시스템이 버벅거립니다. 하지만 각자 자기 슬롯에 꽂힌 메모리만 쓸 수 있어 A 서버의 남는 메모리를 B 서버에 나눠줄 방법이 없습니다.
    • CXL 구조: PCIe(그래픽카드를 꽂는 고속 슬롯 규격)를 기반으로 고성능 인터커넥트망을 구축합니다. Compute Express Link 스위치에 여러 서버와 메모리를 연결하여 하나의 ‘공용 저수지(Memory Pool)’로 묶습니다. 필요한 서버가 필요한 순간에 필요한 만큼 메모리를 동적으로 가져다 쓰고 반납하는 구조입니다.

    2.2 Compute Express Link 의 3가지 핵심 프로토콜 구조

    Compute Express Link 규격은 PCIe 물리 계층(PHY) 위에서 세 가지 상위 프로토콜을 결합하여 가동됩니다:

    1. CXL.io: 기존 PCIe 5.0/6.0 규격과 완전히 동일한 입출력(I/O) 프로토콜로, 장치 검색, 초기화, 오류 보고 등을 담당합니다. (모든 CXL 장치의 필수 기본층)
    2. CXL.cache: GPU, NPU 등 가속기 장치가 호스트 CPU의 메인 메모리를 극도로 낮은 지연시간(Latency)으로 직접 캐시 일관성(Cache Coherency)을 유지하며 읽고 쓸 수 있게 지원합니다.
    3. CXL.mem: 호스트 CPU나 GPU가 로드/스토어(Load/Store) 명령어를 사용해 외부 CXL 메모리 모듈에 직접 접근할 수 있도록 하는 핵심 프로토콜입니다.

    3. Compute Express Link 표준 발전사

    Compute Express Link 컨소시엄은 2019년 출범 이래 가파른 속도로 표준 고도화를 추진해 왔습니다.

    규격 구분CXL 1.0 / 1.1 (2019)CXL 2.0 (2020)CXL 3.0 / 3.1 / 3.2 (2022~2026)
    핵심 연결 방식Point-to-Point (1:1 직접 연결)Switch 기반 (1:N 메모리 풀링)Fabric 기반 (N:M 대규모 메모리 공유)
    주요 기능CPU-메모리간 직접 물리적 용량 확장서버간 유휴 메모리 동적 할당 지원P2P 직통 통신, Multi-head 장치, 랙(Rack) 단위 풀링
    기반 PCIePCIe 5.0 (32 GT/s)PCIe 5.0 (32 GT/s)PCIe 6.0 / 7.0 (64 ~ 128 GT/s)
    상용화 현황PoC 완료 및 가이던스 정립서버 CPU(Intel Xeon, AMD EPYC) 지원메모리 3사 샘플링 완료, 하이퍼스케일러 테스트 진입
    • 현재 위치(2026년 기준): CXL 2.0/3.2 기반 메모리 모듈(CMM-D 등) 샘플 검증(PoC)이 마무리 단계에 있으며, 글로벌 하이퍼스케일러(MS Azure, Meta, Google, AWS) 환경에서 초기 파일럿 배포 및 양산 조율이 진행되는 ‘초기 상용화의 분기점’입니다.

    4. HBM vs CXL: 대립 관계인가, 상호보완적 동반자인가?

    투자 시장에서 가장 빈번하게 발생하는 오해는 “CXL이 HBM을 대체하여 HBM 시장이 위축되는 것 아닌가?”라는 질문입니다. 결론부터 명확히 밝히면 CXL과 HBM은 대체재가 아닌 완벽한 역할 분담 관계(보완재)입니다.

    실제로 삼성전자의 최근 논문 발표에 따르면, 긴 대화 맥락 환경에서 KV 캐시를 CXL D램으로 이관했을 때 GPU VRAM만 단독 사용한 환경 대비 추론 처리량이 최대 9배 향상되었고, 첫 토큰 생성 시간(Time-to-First-Token)이 최대 16분의 1로 단축되는 성과를 보였습니다.

    5. 상용화를 가로막는 3대 핵심 병목 (Bottlenecks)

    Compute Express Link 의 장점에도 불구하고, 데이터센터 현장에서의 대규모 확산을 가로막는 엔지니어링 및 생태계 차원의 병목은 크게 3가지로 나뉩니다.

    상용화의 3대 병목 (Bottlenecks)         
    
    1. Hardware & Latency       로컬 DDR 대비 2~3배 긴 지연시간  
    2. Software & Orchestration OS/커널 레벨 Hot/Cold 페이지 이동 
    3. Ecosystem & Dynamic    NVLink 독점 및 메모리사 수익성     

    ① 하드웨어 & 지연시간(Latency) 오버헤드

    • 물리적 차이: CPU 컨트롤러에 직결된 메인 D램 지연시간이 약 60~80ns인 반면, CXL 메모리는 PCIe PHY + CXL 컨트롤러 + CXL 스위치 패브릭을 거치기 때문에 지연시간이 약 150~250ns로 2~3배 깁니다.
    • 대응책: 1나노초의 연산 주기가 중요한 GPU 핵심 계산 루프 데이터(Hot Data)를 CXL에 두면 전체 연산 속도가 떨어지므로, 오직 캐시용 데이터(Warm/Cold Data)로 철저히 분리 제어해야 합니다.

    ② 소프트웨어 스택 & OS 오케스트레이션

    • NUMA 노드 인식과 Page Tiering: 리눅스 커널 등 OS 레벨에서 CXL 메모리는 로컬 메모리가 아닌 별도의 NUMA(Non-Uniform Memory Access) 노드로 인식됩니다.
    • 소프트웨어 최적화: 자주 쓰는 메모리 페이지를 메인 D램으로 올리고, 덜 쓰는 페이지를 CXL로 넘기는 ‘Page Tiering’ 알고리즘이 실시간으로 오류 없이 작동해야 하나, 현재 SW 스택은 고도화 과정에 있습니다.

    ③ 생태계 역학: 엔비디아 NVLink 독점 & 메모리 3사의 자기잠식(Cannibalization) 딜레마

    • 엔비디아 NVLink의 지배력: 엔비디아는 GPU 간 대용량 통신망으로 자사 독점 규격인 NVLink(6세대 기준 초당 3.6TB 대역폭)를 우선시합니다. 엔비디아 입장에서 CXL은 GPU 내부 통신망이 아닌 “외부 대용량 캐시 확장용” 정도로만 역할이 한정되길 바랍니다.
    • 메모리 IDM의 자기잠식 우려: CXL 풀링이 완벽해지면 서버 1대당 필요한 expensive 메인보드 전용 DIMM D램의 개수가 줄어들 수 있습니다. 이 때문에 삼성전자, SK하이닉스, 마이크론 등은 범용 D램 수요를 스스로 갉아먹는 자기잠식(Cannibalization) 효과를 경계하며 시장 속도를 조절하고 있습니다.

    6. Compute Express Link 글로벌 밸류체인 및 생태계 기업 지도 (Ecosystem Map)

    Compute Express Link 생태계는 메모리 IDM, 컨트롤러/스위치 팹리스, 반도체 IP 기업, 데이터센터 CPU 제조사, 그리고 검사장비/소부장 기업으로 세분화됩니다.

    구분핵심 참여 기업핵심 역할 및 주요 제품
    메모리 IDM삼성전자, SK하이닉스, 마이크론• 삼성: CMM-D(MD220, MD310), CXL 3.2 양산 조율
    • SK하이닉스: CXL 3.2 샘플, CMM-Ax(근전동 연산형) 개발
    • 마이크론: FMS 2026 CXL 메모리 솔루션 전면 공개
    컨트롤러 & 스위치 (팹리스)Astera Labs, Marvell, Montage, XConn• Astera Labs (ALAB): CXL 리타이머 및 스위치(Scorpio) 독점적 지위
    • Marvell: Tanzanite 인수 후 Structera A 플랫폼 고도화
    • Montage / XConn: CXL 3.0/4.0 스위치 실리콘 제작
    IP & 인터페이스Rambus, Synopsys, Cadence• CXL 3.0/4.0 패브릭용 PHY, 컨트롤러 핵심 반도체 IP 라이선스 공급
    CPU & 플랫폼Intel, AMD• Intel Xeon, AMD EPYC 서버 CPU 내 CXL 2.0/3.0 컨트롤러 표준 내장
    국내 소부장 / 검사장비네오셈, 엑시콘, 큐알티• 네오셈: 세계 최초 CXL 검사장비 상용화, CXL 테마 대장주
    • 엑시콘: CXL 1.1/2.0 테스터 및 차세대 테스터 공급
    • 큐알티: CXL 신뢰성 평가 및 품질 검사 서비스
    국내 IP / 팹리스오픈엣지테크놀로지, 퀄리타스반도체• 오픈엣지: CXL 컨트롤러 개발용 메모리 컨트롤러 IP 보유
    • 퀄리타스: CXL용 고속 인터페이스 PHY IP 제공

    7. 투자자를 위한 단기 vs 중장기 프레임워크 & 포트폴리오 전략

    투자자의 시각에서 HBM이 ‘초고속 연산(High Speed)’을 담당하는 주연이라면, Compute Express Link 는 ‘대용량 확장(High Capacity)’을 담당하는 최고 효율의 조연입니다.

    7.1 타임라인별 투자 프레임워크

    1. 단기 관점 (~1년): “수주 모멘텀과 검사장비”
      • 삼성전자와 SK하이닉스의 CXL 3.2 양산 스케줄 및 글로벌 하이퍼스케일러 테스트 소식에 따라 국내 소부장(네오셈, 엑시콘)과 IP 기업들의 주가 탄력성이 높게 나타납니다.
      • 뉴스 모멘텀에 따른 기술적 눌림목 매수 전략이 유효합니다.
    2. 중장기 관점 (2~5년): “패브릭 대개막과 실적 중심 리레이팅”
      • 2027년 이후 3.0/3.2 스위치를 통한 랙(Rack) 단위 메모리 풀링이 본격 구동됩니다.
      • 컨트롤러 독점 기업(Astera Labs) 및 메모리 대형주의 펀더멘털 실적이 본격 반영되며 PER 중심의 정석적인 상승 장세가 연출될 것입니다.

    7.2 포트폴리오 비중 전략 가이드

    맞춤형 포트폴리오 자산 배분               
     ■ 안정형 (60%): 삼성전자 / SK하이닉스                       
     - HBM 업황 수혜 기본 탑재 + CXL 시장 개막 시 멀티플 상향     
    
     ■ 성장형 (30%): Astera Labs (ALAB)                         
     - 리타이머/스위치 글로벌 시장 독점력 보유 핵심 고성장주   
    
     ■ 공격형 (10%): 네오셈 / 엑시콘 / 오픈엣지테크놀로지       
     - 검사장비 수주 및 IP 모멘텀 기반 높은 시세 탄력성     

    8. 결론 및 최종 요약

    Compute Express Link 은 일시적인 단기 테마가 아닙니다. AI 데이터센터가 추론 비용 절감(TCO 혁신)이라는 거대한 벽을 넘기 위해 반드시 도입해야만 하는 메모리 패러다임의 근본적 대전환입니다.

    1. 기술적 본질: CXL은 HBM을 대체하는 것이 아니라, HBM이 담지 못하는 대용량 KV 캐시와 유휴 메모리를 효율적으로 제어하는 ‘계층형 메모리 구조의 핵심 축’입니다.
    2. 상용화 시점: 2026년 현재 PoC 검증을 끝내고 CXL 3.2 기반 초기 양산 단계에 진입 중이며, 2027년 하이퍼스케일러 데이터센터 본격 채택이 분기점이 될 것입니다.
    3. 투자 방향: 단기적으로는 검사장비 및 IP 종목의 모멘텀을 활용하되, 중장기적으로는 글로벌 Compute Express Link 패브릭 시장을 독점하는 컨트롤러 팹리스 및 메모리 대형주 중심으로 포트폴리오를 구성하는 지혜가 필요합니다.

    관련 기사:

    https://n.news.naver.com/mnews/article/008/0005398688