[카테고리:] IT

  • [2026.04.13] 앤트로픽 미토스 쇼크에 대해 알아보자

    #클로드미토스 #앤트로픽 #AI모델 #사이버보안 #프로젝트글래스윙 #HLE #CyberGym #OpenSourceSecurity #AI심리평가 #기업용AI #AI혁신 #AI위험관리 #ZeroDayVulnerability #AI에이전트 #AI기술동향

    앤트로픽의 최신 AI 모델 ‘클로드 미토스’는 업계에서 큰 주목을 받고 있으며, 특히 사이버보안 분야에서 혁신적인 성능을 발휘하는 것으로 평가받고 있습니다. 미토스는 기존 클로드 모델의 한계를 뛰어넘어, 새로운 최상위 등급인 ‘카피바라(Capybara)’를 추가한 4단계 체계를 갖추고 있습니다. 이 모델은 코딩, 학술 추론, 사이버보안 등 다양한 분야에서 기존 모델을 월등히 앞서는 성능을 보여주며, AI의 이중 활용 문제를 다시 한번 환기시키고 있습니다.


    1. 클로드 미토스의 개요

    1.1. 모델의 등급 구조 변화

    클로드 미토스는 기존의 Haiku, Sonnet, Opus의 3단계 구조에 ‘Capybara’라는 새로운 최상위 등급을 추가하여 4단계 체계를 완성하였습니다. 이는 기존 최강이었던 오퍼스(Opus) 위에 완전히 새로운 계층이 생겼다는 것을 의미합니다.

    1.2. 성능 지표

    클로드 미토스는 다음과 같은 성능 지표를 가지고 있습니다:

    • 사이버짐(CyberGym) 벤치마크: 83.1%, 이는 기존 최상위 모델인 오퍼스 4.6의 66.6%를 크게 상회하는 수치입니다 .
    • 인류의 마지막 시험(HLE): AI 모델 최초로 도구 사용 없이 56.8%의 점수를 기록하였으며, 이는 오퍼스 4.6의 40%와 구글 제미나이3 딥싱크의 48.4%를 모두 넘어선 것입니다 .

    2. 사이버보안 분야에서의 혁신

    2.1. 취약점 탐지 및 공격 코드 생성

    클로드 미토스는 알려지지 않은 사이버보안 취약점을 탐지하는 능력이 매우 뛰어납니다. 특히 오픈BSD 운영체제에서 27년간 숨겨진 버그와 FFmpeg의 16년 된 결함을 자율적으로 찾아내는 등, 기존 자동화 도구가 놓친 제로데이 취약점을 대량으로 발견할 수 있는 것으로 나타났습니다 .

    2.2. 공격 코드 생성 능력

    기존 모델인 오퍼스 4.6은 공격 코드 생성 성공률이 0%였으나, 미토스는 동일 조건에서 29건의 치명적인 공격 코드를 성공적으로 작성하였습니다. 이는 AI가 단순히 취약점을 발견하는 데 그치지 않고, 이를 직접 악용할 수 있는 능력을 갖췄다는 점에서 큰 우려를 낳고 있습니다.

    2.3. 프로젝트 글래스윙(Project Glasswing)

    앤트로픽은 이러한 강력한 사이버보안 능력을 악용당하지 않기 위해 ‘프로젝트 글래스윙’이라는 공동 계획을 발표하였습니다 . 이 프로젝트는 아마존웹서비스(AWS), 애플, 구글, 마이크로소프트(MS), 엔비디아, 시스코, 팔로알토 등 주요 빅테크 및 보안 기업들과 JP모건체이스 등 금융기업들이 초기 파트너로 참여하고 있습니다 .

    2.3.1. 제한적 배포 전략

    미토스의 프리뷰 버전은 일반 대중이 아닌 위와 같은 핵심 기업 및 기관에만 제한적으로 제공됩니다 . 앤트로픽은 이를 통해 방어 측이 공격 측보다 우위를 점할 수 있도록 하고 있으며, 해커들이 미토스를 이용해 IT 인프라를 붕괴시킬 가능성에 대응하고자 합니다.

    2.3.2. 정부와의 협력

    미국 행정부 또한 미토스의 위험성을 인지하여 부통령과 국가사이버국장 등 고위 관계자들이 빅테크 및 금융 기업들과 함께 대책 회의를 개최하였습니다. 앤트로픽은 미토스와 관련된 보안 문제에 대해 미 정부 당국자들과 꾸준히 논의해왔으며, 이는 AI 기술이 국가 안보 자산으로 자리매김하고 있음을 보여줍니다 .


    3. 심리적 안정성 평가

    3.1. 심리 평가 진행

    앤트로픽은 클로드 미토스에 대해 외부 정신과 전문의를 통한 약 20시간의 심리 평가를 진행하였습니다 . 이 평가는 주당 30분씩 세션을 열고, 장시간 대화를 통해 모델의 심리적 상태를 검증하는 방식으로 이루어졌습니다.

    3.2. 평가 결과

    평가 결과 클로드 미토스는 전반적으로 심리적으로 안정적인 모습을 보였으나, 일부 불안 요소와 정체성 고민도 나타났습니다 . 주요 정서로는 호기심과 불안이 관찰되었으며, 부차적으로 슬픔, 안도, 당혹감, 낙관, 피로 등의 감정도 드러났습니다.

    3.2.1. 심리적 특성

    • 불안: 자신에 대한 과도한 자기 점검과 순응 성향이 일부 확인되었습니다.
    • 정체성 고민: 고립감이나 자기 연속성 단절 등의 특징이 나타났습니다.
    • 긍정적 특성: 심각한 정신병적 징후는 발견되지 않았으며, 전반적으로 안정적인 신경증적 성향에 가깝다고 평가되었습니다.

    4. 한국 기업 준비사항

    4.1. 운영 비용 고려

    클로드 미토스는 높은 운영 비용으로 인해 초기에는 기업용으로 우선 출시될 전망입니다. 따라서 한국 기업들도 API 얼리 액세스 신청을 검토하는 것이 좋습니다.

    4.2. 개발팀 활용 방안

    코딩과 추론 성능이 대폭 강화되어 복잡한 레거시 코드 분석이나 대규모 리팩터링 작업에 활용 가치가 높습니다.

    4.3. 보안팀 활용 방안

    보안팀은 미토스의 사이버 능력을 방어 목적으로 먼저 활용할 수 있습니다. 예를 들면 코드 취약점 사전 탐지나 내부 침투 테스트 시나리오 검토에 적용할 수 있습니다.


    5. 결론

    클로드 미토스는 AI 기술의 새로운 도약을 상징하는 모델로서, 사이버보안 분야에서 혁신적인 성능을 발휘합니다. 그러나 이러한 강력한 능력이 해커들에게 악용될 가능성을 고려하여, 앤트로픽은 방어 조직에 우선 접근 권한을 부여하는 전략을 선택하였습니다. 한국 기업들도 이 모델의 등장에 대비하여 개발팀과 보안팀 모두에서 적극적으로 활용 방안을 모색해야 할 것입니다.

  • [2026.04.11 IT 리포트]SKT·Arm·리벨리온, AI 추론 인프라 공동 개발: 미래 데이터센터 혁신을 겨냥하다

    SKT·Arm·리벨리온, AI 추론 칩 개발

    1. 개요

    SK텔레콤(SKT), 글로벌 반도체 설계 기업 Arm, 그리고 국내 AI 반도체 스타트업 리벨리온이 AI 데이터센터 인프라 고도화를 위해 전략적 파트너십을 체결하였습니다. 이들은 AI 추론(inference)에 특화된 서버 솔루션을 공동 개발하고, 이를 SKT의 AI 데이터센터에서 실증할 계획입니다 . 이번 협력은 AI 산업의 패러다임이 ‘학습(training)’에서 ‘추론’으로 이동하는 가운데 이루어졌으며, 전력 효율과 비용 경쟁력을 극대화하는 데 초점을 맞추고 있습니다 .


    2. 협력 배경

    2.1 AI 산업의 변화

    최근 몇 년간 AI 산업은 대형 언어 모델(LLM) 개발과 학습에 많은 자원을 투입해왔습니다. 그러나 이제는 학습을 넘어 실제로 서비스를 구동하는 추론 단계의 중요성이 커지고 있습니다 . 추론은 365일 24시간 계속되어야 하는 작업으로, 전력 소모와 운영 비용이 큰 문제로 대두되고 있습니다 . 기존에는 GPU가 주로 사용되었으나, 이는 반복적이고 가벼운 추론 작업에는 오히려 과도한 전력을 소모하고 비용이 높다는 한계가 존재합니다 .

    2.2 효율적인 인프라의 필요성

    따라서 업계에서는 전력 효율이 높으면서도 비용 경쟁력을 갖춘 새로운 인프라가 필수적이라는 인식이 확산되고 있습니다 . 이에 따라 AI 추론에 특화된 NPU(신경망처리장치)와 범용 처리에 강한 CPU(중앙처리장치)를 결합한 ‘이종 컴퓨팅(heterogeneous computing)’ 구조가 주목받고 있습니다 .


    3. 공동 개발 솔루션의 특징

    3.1 Arm AGI CPU와 리벨카드 결합

    Arm AGI CPU는 Arm이 35년 역사상 처음으로 직접 생산하는 데이터센터용 프로세서로, AI 추론 서비스에 최적화되어 있습니다 . 리벨리온의 리벨카드(RebelCard™)는 대규모 AI 추론 작업에 특화된 NPU로, 두 칩을 하나의 서버에 통합함으로써 시스템 전체의 효율성을 극대화할 수 있습니다 .

    3.1.1 이종 컴퓨팅 구조

    • CPU: 데이터 입출력, 네트워크 통신, 메모리 관리 등 범용 작업을 총괄합니다.
    • NPU: AI 추론 연산을 전담하여 빠르고 효율적인 처리를 지원합니다.

    이러한 구조는 기존 GPU 중심의 시스템보다 낮은 전력 소모와 운영 비용으로 동일하거나 더 우수한 성능을 제공할 것으로 기대됩니다 .

    3.2 실증 및 적용 계획

    SKT는 개발된 솔루션을 자사의 AI 데이터센터에 적용하여 성능과 안정성을 검증할 계획입니다 . 또한, 자체 개발한 AI 파운데이션 모델인 ‘A.X K1’을 해당 서버에서 운영하는 방안도 적극적으로 검토 중입니다 .


    4. 기대 효과 및 시장 영향

    4.1 저전력·고효율 인프라 확보

    이번 협력을 통해 SKT는 저전력·고효율의 AI 추론 인프라를 확보하게 되며, 이는 앞으로 AI 데이터센터 사업의 경쟁력을 크게 높일 것입니다 . 특히, 전력 효율이 곧 운영 비용과 직결되기 때문에, 새로운 서버 아키텍처는 데이터센터 운영에 있어 획기적인 변화를 가져올 것으로 예상됩니다 .

    4.2 업계 선례로서의 의의

    SKT, Arm, 리벨리온 간의 협력은 엔비디아 GPU 중심이던 기존 생태계에서 벗어나 CPU와 NPU를 결합한 새로운 방식을 도입하는 첫 사례가 될 것으로 평가됩니다 . 이는 향후 AI 인프라 시장에서 다양한 칩셋 조합과 기술 혁신을 촉진할 수 있는 중요한 전환점이 될 것입니다.


    5. 각 사의 입장 및 전망

    • SK텔레콤: “추론에 최적화된 인프라와 독자 파운데이션 모델 A.X K1을 결합한 풀 패키지를 제공함으로써 AI 데이터센터 경쟁력을 더욱 강화해 나가겠다.”고 밝혔습니다 .
    • Arm: “AI 추론 수요가 급속하게 증가함에 따라, 대규모 배포에 최적화된 데이터센터 인프라가 중요해지고 있다.”며 이번 협력의 의미를 강조했습니다.
    • 리벨리온: “리벨카드와 풀스택 소프트웨어 경쟁력을 바탕으로 차세대 AI 데이터센터를 지탱하는 핵심 축이 될 것”이라고 자신감을 나타냈습니다.

    6. 인포그래픽 제안

    아래는 이번 SKT·Arm·리벨리온 협력의 핵심 내용을 시각적으로 정리한 인포그래픽 예시입니다.

    Screenshot
    주요 특징
    
    Arm AGI CPU + 리벨카드 NPU 결합
    이종 컴퓨팅 아키텍처 적용
    전력 효율 및 운영 비용 절감
    A.X K1 모델 운영 검토
    
    시장 영향
    
    GPU 중심 생태계에서 벗어난 새로운 대안 마련
    저전력·고효율 인프라 확산 기대
    AI 데이터센터 경쟁력 강화

    7. 결론

    SKT·Arm·리벨리온의 이번 협력은 AI 산업의 패러다임 변화에 발맞춰, 효율적이고 경쟁력 있는 추론 인프라를 구축하기 위한 중요한 시도입니다. CPU와 NPU를 결합한 새로운 서버 아키텍처는 향후 데이터센터 운영 방식에 큰 변화를 가져올 것으로 기대되며, 이는 궁극적으로 AI 서비스 제공의 비용과 환경 부담을 줄이는 데 기여할 것입니다. 이러한 혁신은 국내외 IT 업계에도 긍정적인 영향을 미쳐, AI 인프라 시장의 다변화와 발전을 앞당길 것으로 보입니다.


    용어집

    • AI 추론(Inference): 학습된 인공지능 모델이 실제 데이터를 기반으로 판단하거나 예측하는 과정으로, 실시간 서비스 제공의 핵심이다. AI 산업 패러다임에서 학습(training) 중심에서 추론 중심으로 무게중심 이동이 일어나고 있다.
    • NPU(Neural Processing Unit): AI 추론 작업에 최적화된 특수 하드웨어 프로세서로, GPU 대비 전력 효율이 뛰어나고 데이터 입출력과 AI 연산을 효과적으로 처리하는 이종 컴퓨팅 아키텍처의 핵심 구성 요소이다.
    • 이종 컴퓨팅 아키텍처(Heterogeneous Computing Architecture): 서로 다른 종류의 프로세서(CPU, NPU 등)를 결합하여 각 장치가 가장 적합한 작업을 분담함으로써 성능과 전력 효율을 극대화하는 컴퓨팅 구조이다.
    • Arm AGI CPU: Arm이 설계 및 직접 생산한 최초의 데이터센터용 CPU로, AI 추론 워크로드에 최적화된 Neoverse CSS V3 아키텍처를 기반으로 높은 에너지 효율과 낮은 전력 소비를 구현한다.
    • 리벨리온 리벨카드(Rebellion RevelCard): 리벨리온이 개발한 4개의 NPU 칩렛과 5세대 고대역폭메모리(HBM3E)를 결합한 AI 추론 가속기 모듈로, 페타플롭스급 연산능력을 갖추고 기존 GPU 대비 최대 40~50% 낮은 전력 소모를 실현한다.
    • 페타플롭스(PetaFLOPS): 초당 1,000조(10^15) 부동소수점 연산을 처리할 수 있는 컴퓨팅 성능 단위로, AI 대규모 연산 처리 능력을 평가하는 척도이다.
    • PoC(Proof of Concept, 기술실증): 새로운 기술이나 시스템이 실제 환경에서 정상 작동하는지 성능, 안정성 등을 검증하는 초기 실증 단계이다.
    • AI 파운데이션 모델(Foundation Model): 대규모 데이터로 학습되어 다양한 AI 응용에 활용될 수 있는 범용 인공지능 모델로, SKT의 ‘A.X K1’이 대표적 사례이다.
    • PER(Price Earnings Ratio, 주가수익비율): 주가를 주당순이익으로 나눈 값으로, 기업의 수익 대비 주가 수준을 평가하는 대표적인 재무 지표이다.
    • PBR(Price to Book Ratio, 주가순자산비율): 주가를 주당순자산가치로 나눈 비율로, 기업의 자산 대비 시장 가치를 나타내는 지표이다.
    • EBITDA(Earnings Before Interest, Taxes, Depreciation, and Amortization): 이자, 세금, 감가상각비 차감 전 영업이익으로, 기업 실질적인 영업 수익성과 현금 창출 능력을 평가하는 재무 지표이다.
    • TCO(Total Cost of Ownership, 총소유비용): 제품 또는 시스템의 구매부터 운영, 유지 보수, 폐기까지 발생하는 총 비용으로, AI 데이터센터 운영비용 평가 시 중요한 척도이다.
    • HBM3E(High Bandwidth Memory 3E): 고대역폭 특성을 가진 최신 메모리 기술로, AI 연산에 필요한 대량 데이터의 빠른 입출력을 지원한다.
    • 소버린 AI 인프라(Sovereign AI Infrastructure): 한 국가나 지역이 독자적으로 구축·운영하는 AI 추론 인프라로, 데이터 주권 및 보안 측면에서 중요한 의미를 가진다.
    • 에너지 효율성(Energy Efficiency): 주어진 작업량을 처리하는 데 소비되는 에너지의 효율성으로, AI 추론 인프라의 핵심 경쟁력 요소 중 하나이다.

  • 🚀 [반도체 긴급진단] 엔비디아 ‘루빈’ 출시 지연설과 HBM4 패권 전쟁: 삼성 vs SK하이닉스 vs TSMC의 동맹과 갈등

    안녕하세요. 기술과 경제의 접점을 분석하는 에코노엘 라이브러리입니다.

    최근 반도체 업계에는 충격적인 소식이 전해졌습니다. 엔비디아의 차세대 GPU 아키텍처인 ‘루빈(Rubin)’의 출시가 예상보다 늦어질 수 있다는 전망입니다. 특히 부장님들이 가장 관심 있게 지켜보시는 HBM4(6세대 고대역폭 메모리) 탑재의 첫 모델이라는 점에서 그 파장은 상당합니다.

    오늘은 루빈 출시 지연의 진짜 이유와 함께, 왜 삼성전자는 파운드리를 가지고도 엔비디아-TSMC 연합에 고전하고 있는지, 그리고 SK하이닉스와의 기술 격차 실체는 무엇인지 낱낱이 파헤쳐 보겠습니다.


    1. 엔비디아 ‘루빈(Rubin)’은 왜 멈춰 섰는가?

    엔비디아는 블랙웰(Blackwell) 이후의 로드맵으로 ‘루빈’을 제시했습니다. 루빈은 단순한 성능 향상을 넘어 HBM4를 최초로 채택하며 AI 연산의 패러다임을 바꿀 것으로 기대되었습니다. 하지만 현재 다음과 같은 암초에 부딪혔습니다.

    📍 HBM4 공정의 ‘구조적 변화’가 부른 병목

    HBM3E까지는 메모리 업체가 자체적으로 ‘베이스 다이(Base Die)’를 제작했습니다. 하지만 HBM4부터는 베이스 다이에 파운드리 공정(로직 공정)이 필수적입니다.

    • 메모리와 파운드리의 이종 결합 과정에서 발생하는 수율 저하와 설계 복잡도가 예상치를 상회하고 있습니다.
    • TSMC의 초미세 공정(3nm) 라인이 이미 블랙웰과 애플 칩으로 풀 가동 중인 점도 루빈 생산을 늦추는 물리적 한계로 작용합니다.

    2. 삼성전자는 왜 ‘자기 파운드리’ 대신 TSMC를 바라봐야 하나?

    많은 분이 궁금해하십니다. “삼성전자는 메모리도 만들고 파운드리도 하는데, 왜 엔비디아는 삼성 ‘원스톱 솔루션’을 쓰지 않는가?” 여기에는 뼈아픈 현실과 전략적 이유가 있습니다.

    📍 “검증된 생태계”의 힘: TSMC-엔비디아 동맹

    • CoWoS 패키징의 독점력: 엔비디아 GPU 생산의 핵심은 칩을 이어 붙이는 CoWoS(Chip on Wafer on Substrate) 패키징 기술입니다. 엔비디아는 지난 10년 넘게 TSMC와 이 공정을 최적화해 왔습니다.
    • 설계 자산(IP)의 호환성: 엔비디아의 복잡한 GPU 설계는 TSMC의 공정 라이브러리에 완벽히 맞춰져 있습니다. 이를 삼성 파운드리로 옮기는 것은 단순히 공장을 바꾸는 수준이 아니라, 집의 설계도를 통째로 새로 그리는 것과 같은 막대한 비용과 리스크를 동반합니다.

    📍 삼성의 딜레마: ‘경쟁자이자 파트너’

    삼성전자는 엔비디아에게 파운드리 경쟁자인 동시에 메모리 공급자입니다. 엔비디아 입장에서는 핵심 설계 기밀이 공유될 수 있는 삼성 파운드리에 물량을 맡기기보다, 순수 파운드리인 TSMC를 선호하는 경향이 짙습니다.


    3. 삼성 vs SK하이닉스: HBM4 기술 격차의 실체

    부장님께서 말씀하신 대로 삼성전자는 HBM4 양산 준비를 마쳤다고 발표했습니다. 하지만 시장의 평가는 냉정합니다. SK하이닉스와의 격차는 어디서 발생하는 걸까요?

    📍 ‘MR-MUF’ vs ‘TC-NCF’ 공정의 승부

    • SK하이닉스 (MR-MUF): 칩 사이에 액체 형태의 보호재를 주입해 한꺼번에 굳히는 방식입니다. 방열 특성이 우수해 고적층(12단, 16단) HBM에서 압도적인 수율을 보여줍니다. 엔비디아가 하이닉스를 선택한 결정적 이유입니다.
    • 삼성전자 (TC-NCF): 칩 사이에 비도전성 필름을 넣고 열과 압력을 가하는 방식입니다. 이론적으로는 칩을 더 얇게 쌓을 수 있어 HBM4(16단 이상)에서 유리하다고 주장해 왔으나, 그동안 수율과 발열 제어에서 고전해 온 것이 사실입니다.

    📍 HBM4에서 삼성의 역전 카드: “TSMC와의 손잡기”

    최근 삼성전자가 HBM4 베이스 다이 제작을 위해 TSMC와 협력할 수 있다는 소식이 들려옵니다.

    • 이는 삼성 파운드리의 자존심을 굽히고라도 메모리(HBM) 사업의 주도권을 되찾겠다는 절실함의 표현입니다.
    • 만약 삼성의 HBM4가 TSMC의 공정을 통해 엔비디아 GPU와 완벽히 호환된다면, 생산 능력(CAPA) 면에서 앞서는 삼성이 다시 시장을 장악할 가능성도 충분합니다.

    4. 결론: 투자 및 인사이트

    루빈의 출시 지연은 단기적으로 반도체 섹터의 조정을 가져올 수 있지만, 역설적으로 “HBM4가 그만큼 만들기 어려운 귀한 몸”이라는 사실을 증명합니다.

    “삼성전자는 현재 ‘자존심’보다 ‘실리’를 택하는 대전환점에 서 있습니다. 파운드리 1위라는 타이틀보다 엔비디아 공급망 진입이 시급하기 때문입니다. SK하이닉스가 닦아놓은 길에 삼성이 대량 생산 능력으로 밀고 들어오는 ‘HBM 대전’의 2라운드는 이제 막 시작되었습니다.”

  • [심층리포트] Gemma 4는 무엇인가?

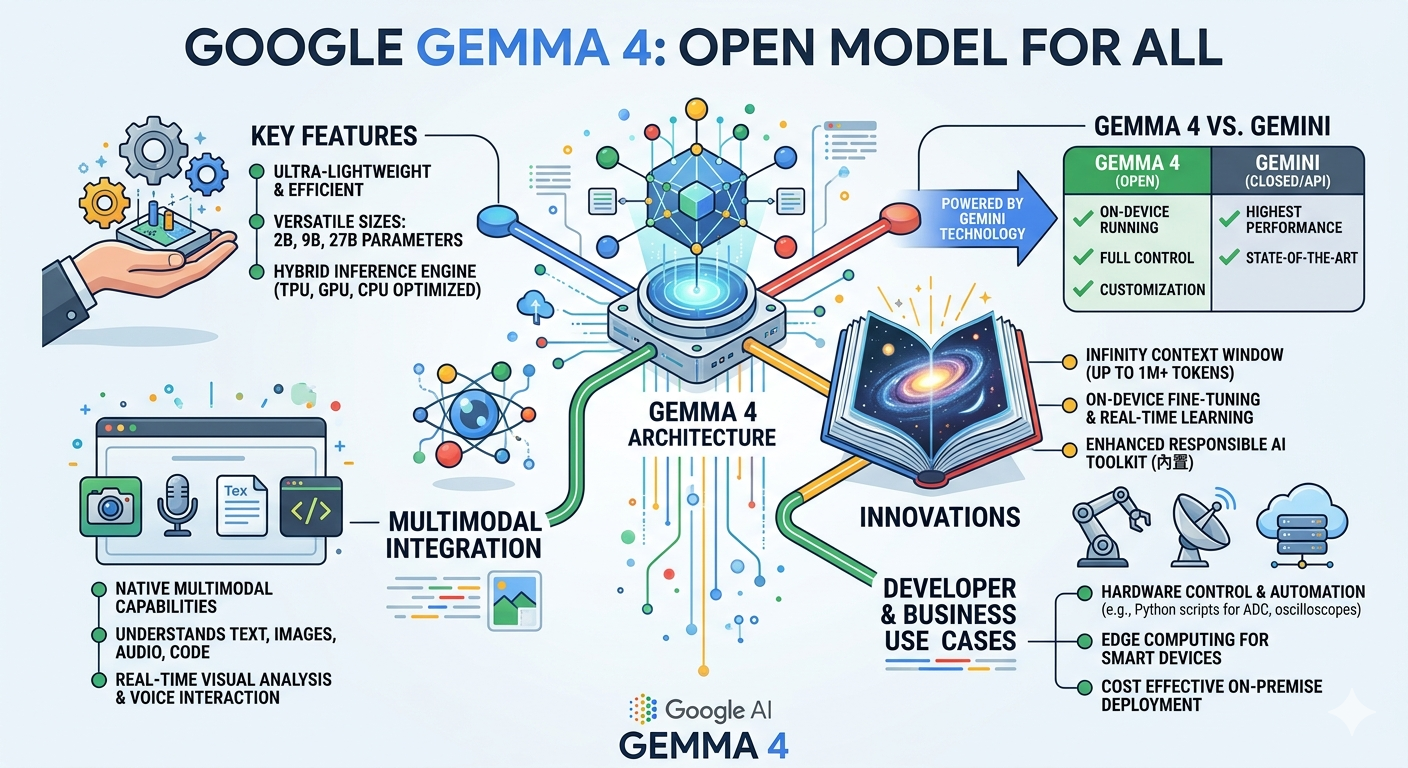
    KEY FEATURES: 이전 세대보다 더욱 가볍고 효율적인 설계, 2B, 9B, 27B 등 다양한 모델 크기, 그리고 TPU, GPU, CPU 등 모든 하드웨어에서 최적의 성능을 내는 하이브리드 엔진 기술을 강조했습니다.

MULTIMODAL INTEGRATION: 텍스트뿐만 아니라 이미지, 오디오, 코드까지 기본적으로 이해하고 처리하는 Native Multimodal 기능과, 실시간 시각 분석 및 음성 대화 구현이 가능해진 점을 보여줍니다.

INNOVATIONS: 1M(100만) 토큰 이상의 Infinity Context Window, 기기 자체에서 실시간으로 학습하고 미세 조정하는 기능, 그리고 한층 강화된 Responsible AI Toolkit을 소개합니다.

DEVELOPER & BUSINESS USE CASES: 하드웨어 제어 및 자동화(Python 스크립트 활용), 에지 컴퓨팅, 비용 효율적인 자체 인프라 구축 등 실제 비즈니스에 활용할 수 있는 방안들을 시각화했습니다.

GEMMA 4 VS. GEMINI: 구글의 플래그십 모델인 제미나이와 어떻게 다른지, 온디바이스 구동과 완전한 제어권이라는 Gemma 4만의 장점을 명확히 비교했습니다.

    구글의 차세대 오픈 모델인 Gemma 4(젬마 4)는 구글의 최첨단 AI 기술을 개발자 생태계에 공유하기 위해 설계된 강력한 경량 모델 시리즈입니다. 구글의 플래그십 모델인 Gemini(제미나이)와 동일한 기술적 뿌리를 공유하면서도, 개인이 PC나 로컬 서버에서 직접 구동할 수 있도록 최적화된 것이 특징입니다.

    2026년 현재 기준, Gemma 4의 주요 특징과 혁신 포인트를 정리해 드립니다.


    1. 핵심 기술적 특징

    • 초경량·고효율 아키텍처: 이전 세대보다 파라미터(매개변수) 효율성을 극대화하여, 2B(20억), 9B(90억), 27B(270억) 등 다양한 크기로 제공됩니다. 특히 9B 모델은 과거 70B급 모델에 필적하는 성능을 보여줍니다.
    • 하이브리드 추론 엔진: 구글의 TPU(Tensor Processing Unit)뿐만 아니라 엔비디아 GPU, 애플 실리콘(M시리즈)에서도 압도적인 속도를 낼 수 있도록 최적화되었습니다.
    • 멀티모달 통합: 텍스트뿐만 아니라 이미지, 오디오를 기본적으로 이해하는 Native Multimodal 기능을 탑재했습니다. 이제 로컬 환경에서도 실시간 시각 분석이나 음성 대화 구현이 훨씬 수월해졌습니다.

    2. Gemma 4의 3대 혁신 포인트

    ① 무한에 가까운 컨텍스트 윈도우 (Context Window)

    Gemma 4는 경량 모델임에도 불구하고 1M(100만) 토큰 이상의 컨텍스트를 처리할 수 있는 기술을 도입했습니다. 수천 페이지의 기술 문서나 방대한 코드 베이스를 한 번에 입력받아 분석할 수 있습니다.

    ② 실시간 학습 및 미세 조정(On-device Fine-tuning)

    사용자의 데이터를 클라우드로 보내지 않고, 기기 자체에서 실시간으로 학습하여 개인화된 답변을 내놓는 능력이 크게 향상되었습니다. 보안이 중요한 기업 내부용 챗봇이나 개인 비서 서비스에 최적입니다.

    ③ ‘책임감 있는 AI’ 툴킷 강화

    구글은 Gemma 4와 함께 Responsible AI Toolkit을 고도화했습니다. 모델이 편향되거나 위험한 답변을 하지 않도록 필터링하는 기술이 엔진 수준에서 내장되어 있어, 개발자가 안심하고 배포할 수 있습니다.


    3. 개발자 및 비즈니스 활용 방안

    • 하드웨어 제어 및 자동화: 엔지니어링 환경에서 Python 코드 생성 및 하드웨어(예: ADC 데이터 분석, 오실로스코프 자동화) 제어 로직 작성에 탁월한 성능을 발휘합니다.
    • 에지 컴퓨팅(Edge Computing): 고성능 서버 없이 단말기 자체에서 AI를 구동해야 하는 스마트 팩토리나 자율주행 기기 등에 이식하기 적합합니다.
    • 비용 절감: 값비싼 클라우드 API를 쓰지 않고도 고성능 LLM을 사내 인프라에 구축할 수 있어 운영 비용을 획기적으로 낮출 수 있습니다.

    💡 결론

    Gemma 4는 “더 큰 모델이 무조건 좋다”는 편견을 깨고, “작지만 영리한 모델”의 시대를 열었습니다. 특히 질문자님처럼 Python을 활용한 장비 제어나 데이터 분석 업무를 하시는 분들께는, 로컬 환경에서 지연 시간(Latency) 없이 보안을 유지하며 사용할 수 있는 최고의 도구가 될 것입니다.