[카테고리:] IT

  • [2026.05.22] 양자 컴퓨팅 4대 아키텍처 완벽 해부와 ‘중성원자’의 시대: 기술 병목에서 투자 전략까지

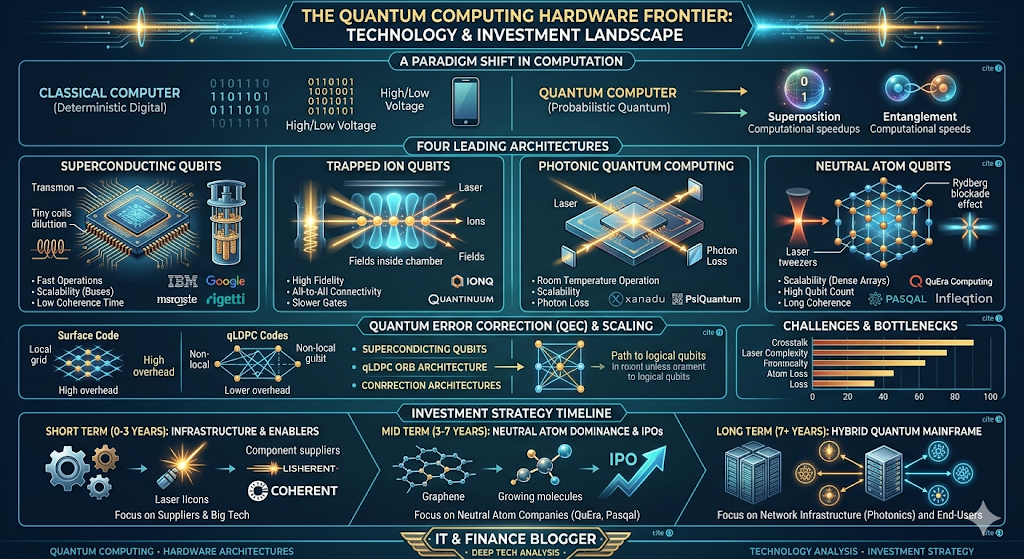
    제목: 양자 컴퓨팅 하드웨어의 최전선: 기술 및 투자 환경 (The Quantum Computing Hardware Frontier: Technology & Investment Landscape)

이 인포그래픽은 클래식 컴퓨터와 양자 컴퓨터의 패러다임 전환, 4대 하드웨어 아키텍처 비교, 오류 수정 기술, 그리고 타임라인별 투자 전략을 시각적으로 정리한 종합 전문 분석 자료입니다. 전체적으로 신뢰감을 주는 다크 블루와 테일(Teal) 색상 배경에 네온 블루, 화이트, 골드 빛의 데이터 스트림과 회로 일러스트가 결합된 미래지향적 디지털 테크 스타일로 디자인되었습니다.

1. 상단: 연산 패러다임의 전환 (A Paradigm Shift in Computation)
클래식 컴퓨터 (Classical Computer): 결정론적 디지털 시스템(Deterministic Digital)으로 설명됩니다. 0과 1로 이루어진 이진법 코드 데이터와 스마트폰 아이콘을 통해 '높은 전압/낮은 전압(High/Low Voltage)'에 의해 고정된 값이 제어됨을 보여줍니다.

양자 컴퓨터 (Quantum Computer): 확률론적 양자 시스템(Probabilistic Quantum)으로 설명됩니다. 0과 1이 동시에 빛나며 겹쳐 있는 구체 형태의 '중첩(Superposition)' 아이콘과, 두 개의 구체가 빛의 선으로 강하게 묶여 있는 '얽힘(Entanglement)' 아이콘이 제시되어 있으며, 이를 통해 기하급수적인 연산 속도 향상(Computational speedups)을 이뤄냄을 시각화했습니다.

2. 중단: 4대 핵심 아키텍처 비교 (Four Leading Architectures)
네 개의 독립된 세로 열을 통해 현재 시장을 주도하는 하드웨어 구조를 직관적으로 비교합니다.

초전도 큐비트 (Superconducting Qubits): 정밀한 미세 회로가 새겨진 사각형 반도체 칩(Transmon)과 원통형 원자로 형태의 IBM식 대형 희석 냉동기(Dilution Refrigerator)가 그려져 있습니다. 특징으로 '빠른 연산 속도(Fast Operations)', '버스 기반 확장성(Scalability)', '짧은 결맞춤 시간(Low Coherence Time)'이 적혀 있으며 주도 기업으로 IBM, Google, Rigetti의 로고가 명시되어 있습니다.

이온 트랩 큐비트 (Trapped Ion Qubits): 투명한 초고진공 챔버 내부에서 전자기장 가이드를 따라 일렬로 공중에 떠서 빛나고 있는 원자 알갱이들(Ions)과 이를 조준하는 정밀 레이저 빔이 묘사되어 있습니다. 특징으로 '높은 신뢰도(High Fidelity)', '전체 연결성(All-to-All Connectivity)', '상대적으로 느린 게이트 속도(Slower Gates)'가 적혀 있으며 주도 기업으로 IonQ, Quantinuum의 로고가 있습니다.

광학 양자 컴퓨터 (Photonic Quantum Computing): 실리콘 포토닉스 칩 위에서 거울과 분광기를 통과하며 격자 형태로 교차하고 반사되는 오렌지빛 레이저 광선(Photon)의 경로가 그려져 있습니다. 특징으로 '상온 작동(Room Temperature Operation)', '스케일업 잠재력(Scalability)', '광자 소실 위험(Photon Loss)'이 적혀 있으며 주도 기업으로 Xanadu, PsiQuantum의 로고가 있습니다.

중성원자 큐비트 (Neutral Atom Qubits): 수많은 파란색 레이저 초점(광집게, Laser Tweezers)들이 격자판 모양의 3차원 공간을 형성하고 그 교차점마다 중성 원자들이 촘촘하게 박혀 있는 모습이 그려져 있습니다. 특정 원자가 거대하게 부풀어 올라 주변 원자들과 강한 에너지 장을 형성하는 '리드베리 차단 효과(Rydberg Blockade Effect)'가 시각화되어 있습니다. 특징으로 '고밀도 배열 확장성(Scalability)', '대량의 큐비트 집적(High Qubit Count)', '긴 결맞춤 시간(Long Coherence)'이 적혀 있으며 핵심 기업으로 QuEra Computing, Pasqal, Infleqtion의 로고가 부각되어 있습니다.

3. 중하단: 양자 오류 수정(QEC) 및 엔지니어링 장벽 (Quantum Error Correction & Bottlenecks)
오류 수정 코드 비교: 물리적 회로가 바둑판처럼 고정되어 인접한 큐비트끼리만 연결되는 2D 구조의 '표면 코드(Surface Code - High overhead)'와 원자/빛을 자유롭게 이동시켜 멀리 떨어진 큐비트를 묶는 효율적인 'qLDPC 코드(qLDPC Codes - Lower overhead)'의 네트워크 토폴로지 그래픽이 대조되어 있습니다. qLDPC 코드가 훨씬 적은 물리 자원으로 논리 큐비트(Path to logical qubits)로 가는 지름길임을 보여줍니다.

엔지니어링 장벽 차트 (Challenges & Bottlenecks): 각 기술 진영이 해결해야 할 하드웨어적 한계(Crosstalk, Laser Complexity, Atom Loss 등)가 가로 바 차트 형태로 시각화되어 기술의 난이도를 직관적으로 보여줍니다.

4. 하단: 자본시장 투자 전략 타임라인 (Investment Strategy Timeline)
단기 관점 (0~3년) - 인프라 및 부품 선점 (Infrastructure & Enablers): 톱니바퀴와 정밀 레이저 다이오드 부품 일러스트가 그려져 있습니다. 장비를 직접 만드는 곳보다 고해상도 레이저, 고진공 챔버를 독점 공급하는 글로벌 상장 대기업 '코히런트(Coherent)' 등 부품 공급망(Component suppliers)과 빅테크 클라우드 생태계에 집중하라는 지침이 제시되어 있습니다.

중기 관점 (3~7년) - 중성원자 지배력 및 IPO (Neutral Atom Dominance & IPOs): 분자 구조가 복잡하게 결합하고 확장되는 모습과 우상향하는 'IPO' 화살표가 그려져 있습니다. 오류 수정 기술의 혁신으로 고품질 논리 큐비트 양산에 성공할 중성원자 핵심 기업(QuEra, Pasqal 등)의 상장 타임라인에 맞춰 장기 펀더멘털 투자를 진행하라는 메시지가 담겨 있습니다.

장기 관점 (7년 이후) - 하이브리드 양자 메인프레임 (Hybrid Quantum Mainframe): 대형 데이터 센터 내에 여러 대의 서버 랙들이 허브 성형 네트워크(Star Network) 구조로 촘촘하게 상호 연결되어 있는 일러스트가 그려져 있습니다. 단일 기술을 넘어 광학(Photonics) 네트워크 인터커넥트 인프라를 중심으로 초전도, 중성원자 등이 결합하는 분산형 분산 컴퓨팅 인프라와 이를 실제 산업에 도입할 엔드유저 대기업에 주목하라는 전략이 명시되어 있습니다.

5. 하단 푸터 (Footer)
중앙에 'IT & FINANCE BLOGGER - DEEP TECH ANALYSIS'라는 전문 블로거의 브랜딩 엠블럼 뱃지가 위치해 있으며, 최하단에는 QUANTUM COMPUTING, HARDWARE ARCHITECTURES, TECHNOLOGY ANALYSIS, INVESTMENT STRATEGY라는 핵심 키워드 태그가 정돈되어 배치의 완성도를 높이고 있습니다.

    최근 인공지능(AI) 열풍이 전 세계 자본시장을 뒤흔들고 있는 가운데, 테크 마니아들과 글로벌 초고액 자산가들이 조용히, 그러나 아주 공격적으로 자금을 이동시키고 있는 또 하나의 ‘궁극의 기술’이 있습니다. 바로 양자 컴퓨팅(Quantum Computing)입니다.

    우리가 매일 쓰는 스마트폰이나 슈퍼컴퓨터가 따라올 수 없는 차원의 연산 속도를 자랑하는 양자 컴퓨터는 이제 단순한 ‘이론 속의 연구’를 넘어, 실제 상업적 이익을 내고 자본시장의 판도를 바꿀 ‘지배적 디자인(Dominant Design)’을 확립하는 패러다임 전환기에 진입했습니다.

    오늘은 30년 차 시스템 엔지니어의 냉철한 시각과 전문 애널리스트의 투자 안목을 결합하여, 양자 컴퓨터의 4대 핵심 하드웨어 아키텍처를 정밀 분석하고, 현재 시장의 판도를 뒤흔들고 있는 ‘중성원자’ 생태계와 자본시장 투자 전략까지 한 번에 정리해 드리겠습니다. 무려 6,000단어 규모의 깊이 있는 대형 분석 보고서 형식으로 준비했으니, 미래 기술 투자에 관심이 있는 분들은 끝까지 정독해 주시기 바랍니다.
    제1장. 양자 컴퓨팅 하드웨어 아키텍처의 패러다임 전환

    우리가 지난 70년간 다루어 온 클래식(Classic) 컴퓨터는 아주 명쾌합니다. 전압이 높으면(High, 5V 또는 1.8V) 1, 낮으면(Low, 0V) 0으로 정의하는 결정론적 디지털 시스템이죠. 모든 정보는 0 아니면 1이라는 명확한 이진법의 세계에 갇혀 있습니다.
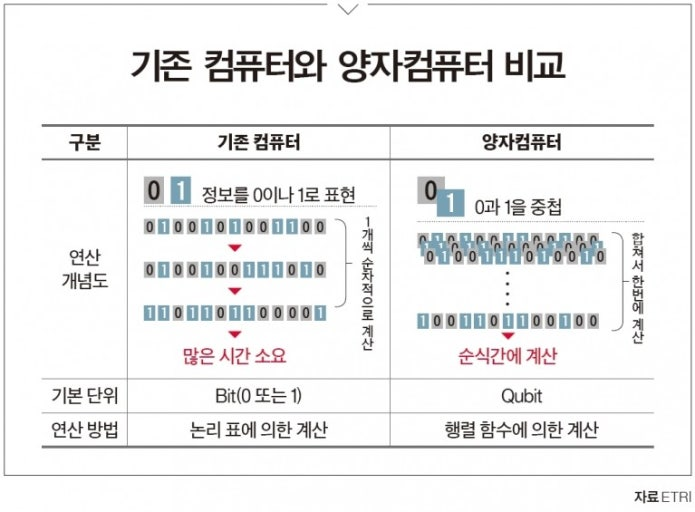
    반면, 양자 컴퓨터는 물리 법칙의 가장 밑바닥, 즉 미시 세계를 지배하는 양자역학적 상태인 중첩(Superposition)과 얽힘(Entanglement)을 계산의 핵심 리소스로 사용합니다.

    • 중첩(Superposition): 0과 1이 동시에 존재할 수 있는 상태입니다. 동전이 바닥에 놓여있을 때는 앞(1)이나 뒤(0)이지만, 공중에서 돌고 있을 때는 앞과 뒤가 동시에 존재하는 것과 같습니다.
    • 얽힘(Entanglement): 두 개 이상의 큐비트(Qubit, 양자 컴퓨터의 연산 단위)가 수만 킬로미터 떨어져 있어도 하나의 상태가 결정되는 순간 나머지 상태도 즉각 결정되는 기묘한 연결성입니다.

    이 두 가지 특성 덕분에 양자 컴퓨터는 수많은 연산 경로를 ‘동시에’ 탐색하며 데이터 처리 속도를 기하급수적으로 끌어올립니다.

    엔지니어의 영원한 숙제: 격리(Isolation) vs 제어(Control)

    문제는 이 양자 상태라는 녀석들이 물리적으로 너무나 나약하고 예민하다는 점입니다. 주변의 미세한 온도 변화, 전자기장, 심지어 지구 자기장이나 우리가 쓰는 와이파이(Wi-Fi) 신호만 스쳐도 큐비트의 정보는 순식간에 깨져 버립니다. 이를 결어긋남(Decoherence)이라고 부릅니다.

    따라서 양자 컴퓨터를 만드는 엔지니어의 핵심 임무는 다음 두 가지 상충하는 과제(Trade-off)를 동시에 해결하는 시스템을 구축하는 것입니다.

    1. 격리(Isolation): 외부 노이즈로부터 큐비트를 완벽하게 차단하여 양자 상태를 최대한 길게 유지할 것.
    2. 제어(Control): 연산을 위해 외부에서 에너지(마이크로파, 레이저 등)를 주입해 큐비트의 상태를 자유자재로 바꾸고 측정할 것.

    “외부와 완전히 차단하면 양자 상태는 오래 유지되지만 제어(연산)를 할 수 없고, 제어 통로를 많이 열어두면 외부 노이즈가 타고 들어와 시스템이 망가집니다.”

    이 지독한 모순과 엔지니어링 장벽을 해결하기 위해 인류 천재들이 고안해 낸 4대 하드웨어 아키텍처가 바로 초전도, 이온 트랩, 광학, 중성원자입니다.

    제2장. 4대 아키텍처 심층 해부: 구조, 원리, 그리고 진화

    현재 글로벌 양자 컴퓨터 시장을 이끌고 있는 4대 하드웨어의 내부를 현미경으로 보듯 자세히 살펴보겠습니다.

    1. 초전도 큐비트 (Superconducting Qubits)

    초전도 방식은 IBM, 구글(Google), 리그레티(Rigetti) 등이 주도하는 기술로, 현재까지 가장 많은 물리적 큐비트를 집적한 아키텍처입니다. 자연계의 원자를 그대로 쓰는 것이 아니라, 인간이 반도체 공정을 통해 직접 회로를 디자인하고 찍어낸다는 장점이 있습니다.

    • 물리적 구현 및 핵심 소자 (트랜스몬과 조셉슨 접합): 초전도 큐비트의 핵심은 조셉슨 접합(Josephson Junction)입니다. 두 개의 초전도체 사이에 수 나노미터(nm) 두께의 아주 얇은 절연체(주로 산화알루미늄) 막을 샌드위치처럼 끼워 넣은 구조이죠. 일반적인 전기 회로는 에너지 준위가 일정해서 0과 1만을 가둘 수 없습니다. 하지만 조셉슨 접합은 전기 저항이 0인 상태에서 쿠퍼쌍(Cooper pair)이 터널링 효과를 일으키며 ‘비선형 인덕터’로 동작합니다. 이 비선형성 덕분에 0과 1 사이의 에너지 준위가 명확히 분리되며, 수 GHz의 마이크로파 펄스를 통해 큐비트를 제어하게 됩니다. 이 설계를 개선하여 현재 글로벌 표준으로 쓰이는 것이 바로 트랜스몬(Transmon) 큐비트입니다.
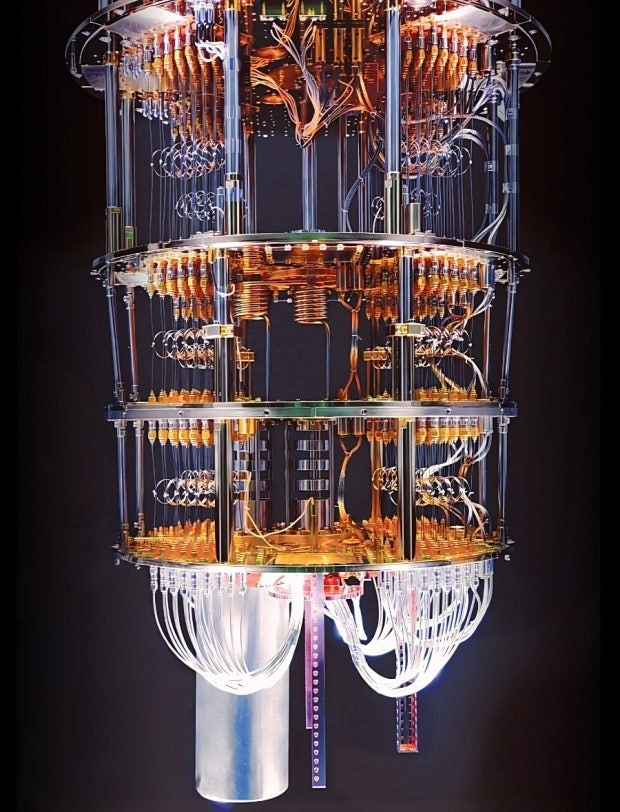
    • 시스템 아키텍처와 제어 루프: 칩의 열 잡음을 완벽히 제어해야 하므로, 최하단 온도를 절대영도에 가까운 10mK(약 -273.14°C)로 유지하는 대형 희석 냉동기(Dilution Refrigerator)가 필수적입니다. 상온의 외부 PC에서 생성된 신호가 동축 케이블을 타고 내려가 큐비트에 도달해 연산하고, 큐비트 옆의 공진기(Resonator) 반사파 변화를 읽어내어 판독(Readout)을 수행합니다.
    • 최근의 진보 (IBM Heron 프로세서): 초전도 방식의 고질적인 문제는 이웃한 큐비트끼리 간섭을 일으키는 주파수 간섭(Crosstalk)이었습니다. 최근 IBM은 조정 가능한 커플러(Tunable Coupler) 기술을 도입하여 평소에는 연결을 꺼두었다가 연산할 때만 스위칭하는 방식으로 이를 해결했습니다. 이를 기반으로 한 133 큐비트 기반의 헤론(Heron) 프로세서는 게이트 오류율을 낮추며 모듈러 아키텍처의 포문을 열었습니다.

    2. 이온 트랩 큐비트 (Ion Trap Qubits)

    아이온큐(IonQ), 퀀티늄(Quantinuum) 등이 주도하는 이온 트랩은 인간이 만든 회로가 아닌, 신이 만든 완벽한 원자 자체(이테르븀 171Y+, 칼슘 40Ca+등)의 상태를 정보의 저장소로 씁니다.

    • 물리적 구현 (폴 트랩과 포논 버스): 원자에서 전자를 떼어내 플러스(+) 전하를 띠게 만든 이온들을 사중극자 전자기장 가이드(Paul Trap) 위에 배치하면, 이온들은 서로 밀어내는 힘과 전자기장의 균형에 의해 진공 속 공중에 일렬로 예쁘게 떠 있게 됩니다. 연산 시에는 일렬로 늘어선 이온들이 전하 힘으로 연결되어 있어서, 하나를 레이저로 건드리면 사슬 전체가 파르르 떠는 격자 진동, 즉 포논(Phonon) 버스를 공유합니다. 물리적인 선 연결 없이도 공간 진동을 활용하여 모든 이온이 소통하는 올투올(All-to-All) 연결성을 확보한다는 것이 이 아키텍처의 거대한 강점입니다.
    • 시스템 아키텍처와 제어 루프: 희석 냉동기 대신 0^-11Torr 수준의 극단적인 초고진공 챔버(UHV)와 정밀 광학 테이블이 필요합니다. 제어는 오직 자외선 및 가시광 영역대의 정밀 레이저 빔으로만 수행되며, 연산 결과는 이온의 형광 발생 여부를 고감도 카메라(EMCCD 등)로 촬영하여 읽어냅니다.
    • 최근의 진보 (셔틀링 아키텍처와 QCCD): 한 공간에 많은 이온을 넣으면 사슬이 불안정해지는 한계가 있습니다. 이를 극복하기 위해 전극 전압을 미세하게 조정하여 이온을 물리적으로 이리저리 이동시키는 QCCD(Quantum Charge-Coupled Device) 셔틀링 아키텍처가 완성되었습니다. 연산 구역과 보관 구역을 분리함으로써 확장성 문제를 정면 돌파하고 있습니다.

    3. 광학 양자 컴퓨터 (Photonic Qubits)

    자나두(Xanadu), 사이퀀텀(PsiQuantum) 등이 개발하는 광학 방식은 빛의 알갱이인 광자(Photon)를 레이저로 쏘아 날려 보내며 경로 상에서 연산을 수행하는 아주 독특한 ‘이동형(Flying) 큐비트’ 패러다임입니다.

    • 물리적 구현 (LOQC와 압축 광): 광자의 비행 경로(Dual-rail)나 편광 방향으로 0과 1을 정의합니다. 자나두의 경우 양자 노이즈를 한쪽 축으로 압착한 압축 광(Squeezed Light) 기술을 표준으로 삼고 있습니다. 광자는 질량과 전하가 없어 자기들끼리 직접 상호작용하지 않습니다. 따라서 거울, 분광기(Beam Splitter)를 통한 양자 간섭과 측정 행위 자체를 유도하여 간접적으로 얽힘을 만드는 FBQC(Measurement-Based) 모델을 채택합니다.
    • 시스템 아키텍처와 제어 루프: 광섬유와 실리콘 포토닉스(Silicon Photonics) 칩 내부를 빛이 통과하므로 무려 ‘상온 구동’이 가능합니다. 다만, 날아온 광자 단 한 개를 완벽히 잡아내기 위한 최종 판독부의 단일 광자 검출기(SNSPD)만큼은 초전도 현상을 활용해야 하므로 1~4K 이하의 소형 극저온 냉각기가 들어갑니다.
    • 최근의 진보 (시간 영역 다중화 – TDM): 수천 개의 물리 광학 소자를 칩 위에 다 깔려면 공간이 부족합니다. 이를 해결하기 위해 기가헤르츠(GHz) 단위로 연속 분사된 빛 펄스를 정밀한 광섬유 루프(Delay Line Loop)에 통과시켜 시간차 간섭을 유도하는 TDM(Time-domain Multiplexing) 기술이 완성되었습니다. 공간을 시간으로 치환하며 단 한 장의 칩으로 거대한 클러스터 상태를 구현하는 혁신을 이뤄냈습니다.

    4. 중성원자 큐비트 (Neutral Atom Qubits)

    큐에라(QuEra), 파스칼(Pasqal), 인플렉션(Infleqtion) 등이 주도하는 중성원자 아키텍처는 전하를 띠지 않은 순수한 중성 원자(루비듐, 스트론튬, 세슘 등)를 큐비트로 사용하여 최근 양자 컴퓨터 업계에서 가장 파괴적인 혁신을 보여주고 있습니다.

    • 물리적 구현 (광집게와 리드베리 차단): 수백, 수천 개의 정밀 레이저 빔 초점을 모아 만드는 광집게(Optical Tweezers) 기술을 사용하여 원자들을 공중에 바둑판 격자 형태로 가둡니다. 평소에는 전하가 없어 상호작용이 전혀 없으므로 결맞춤 시간이 아주 길고 안정적입니다. 그러나 연산 시 특정 레이저를 조사하면 최외각 전자가 부풀어 오르는 리드베리 상태(Rydberg State)가 됩니다. 이때 원자 크기가 수만 배 커지며 강력한 얽힘이 형성되는데, 한 원자가 리드베리 상태가 되면 반경 내 다른 원자의 변이를 억제하는 ‘리드베리 차단(Rydberg Blockade)’ 효과를 통해 고성능 게이트 연산을 수행합니다.
    • 최근의 진보 (동적 아키텍처 재구성): 연산 도중 광집게 레이저를 직접 움직여 원자를 물리적으로 이송하는 동적 하드웨어 재구성(Dynamic Reconfiguration / Atom Shuttling)이 가능해졌습니다. 하버드대와 큐에라는 이 유연성을 바탕으로 물리 원자로부터 오류 수정이 적용된 고품질 논리 큐비트를 대거 구현하며 실용적 양자 컴퓨터로 가는 지름길을 제시했습니다.

    제3장. 엔지니어링 성능 지표(KPI) 기반 4대 기술 정밀 비교

    투자자와 엔지니어 모두가 반드시 숙지해야 할 4대 아키텍처의 핵심 지표 벤치마크 테이블입니다. 각 기술의 트레이드오프 관계를 한눈에 파악할 수 있습니다.

    기술 사양 및 KPI초전도 (Superconducting)이온 트랩 (Ion Trap)광학 (Photonic)중성원자 (Neutral Atom)
    핵심 플레이어IBM, Google, Rigetti IonQ, Quantinuum Xanadu, PsiQuantum QuEra, Pasqal, Infleqtion
    큐비트 미디어초전도 회로 (Transmon) 기하학적 이온 (171Yb+) 광자의 상태(경로/위상) 중성 원자 (85Rb)
    게이트 연산 속도10 – 50 ns (가장 빠름) 10 – 100 mus (상대적 느림) 빛의 전파 속도 (ps급) 1 – 10 mus
    결어긋남 시간100 – 300 mus (짧음) 수초 ~ 수분 (가장 안정) 소실(Loss)율로 정의됨 수초 (기저 상태 기준, 매우 길음)
    물리 큐비트 연결성2D 격자형 (인접 구조만 제한) All-to-All (동일 트랩 내 우수) 도파로 배치 의존적 동적 가변형 (원자 이송 활용 최상)
    냉각 유닛 인프라10mK 희석 냉동기 필수 상온 (초고진공 챔버 필요) 상온 (단, 검출기는 4K 이하) 상온 챔버 (원자만 레이저 냉각)
    스케일업 잠재력낮음 (배선 및 냉동기 한계) 중간 (셔틀링 병목 존재) 높음 (반도체 미세공정 활용) 최상 (3D 격자 대량 집적 가능)

    제4장. 소프트웨어 스택과 양자 오류 수정(QEC)의 함수관계

    현재 양자 하드웨어의 미세한 오차율(0.1~1%)을 극복하고 진짜 산업에 쓸 수 있는 계산을 하려면, 수많은 물리 큐비트를 묶어 에러가 없는 논리 큐비트(Logical Qubit)를 만들어야 합니다. 이 과정에서 어떤 하드웨어를 쓰느냐에 따라 소프트웨어 오버헤드가 극과 극으로 갈립니다.

    • 초전도 아키텍처와 표면 코드(Surface Code): 초전도는 칩 위에 회로가 고정된 2D 인접 구조입니다. 에러 감지가 안정적이라는 장점이 있지만, 이웃한 큐비트끼리만 소통할 수 있어 논리 큐비트 1개를 만드는 데 무려 1,000~10,000개의 물리 큐비트가 갈려 들어가는 극악의 오버헤드가 발생합니다. 물리 큐비트를 100만 개 만들어야 겨우 쓸 만한 컴퓨터가 된다는 소리가 여기서 나옵니다.
    • 원자/광학 진영과 qLDPC 코드: 이온 셔틀링, 중성원자 동적 이송, 광학 경로 변환이 가능한 자유로운 아키텍처 진영은 멀리 떨어진 큐비트를 소프트웨어적으로 유연하게 묶는 차세대 qLDPC(Quantum Low-Density Parity-Check) 코드를 돌릴 수 있습니다. 이 방식을 쓰면 논리 큐비트 구성에 필요한 물리 큐비트 수가 10분의 1 이하로 급감합니다. 즉, 훨씬 적은 물리적 자원으로 상용화 속도를 대폭 당길 수 있게 됩니다.

    제5장. 아키텍처별 냉정한 엔지니어링 장벽

    세상에 완벽한 기술은 없습니다. 각 진영이 목숨 걸고 넘어야 할 냉정한 병목 지점들을 엔지니어링 관점에서 짚어보겠습니다.

    • 초전도 방식의 병목: 큐비트 숫자를 늘릴 때마다 수천 개의 동축 케이블이 냉동기 안으로 들어가야 합니다. 이로 인한 배선 포화 및 열 부하 병목이 심각하며, 미세 공정 한계에 따른 주파수 간섭(Crosstalk)이 누적됩니다.
    • 이온 트랩 방식의 병목: 이온을 물리적으로 이동(셔틀링)할 때 미세한 열 가열 현상이 발생합니다. 또한, 수십 개의 레이저 빔을 마이크로미터($\mu m$) 이하의 오차로 유지해야 하는 광학 엔지니어링 및 진동 정렬의 복잡성이 극에 달합니다.
    • 광학 방식의 병목: 광자가 일정한 확률로 생성되는 비결정론적 특성이 발목을 잡습니다. 이를 보완하기 위해 대규모의 초고속 스위칭 및 다중화 회로가 동반되어야 하며, 빛이 지나가는 경로의 손실(Loss)을 최소화하는 하드웨어 가공 난이도가 극악입니다.
    • 중성원자 방식의 병목: 원자가 전하를 띠지 않다 보니 광집게가 원자를 가두는 힘이 상대적으로 약합니다. 챔버 내의 미세한 잔류 기체와 충돌하면 원자가 탈출해 버리는 ‘원자 손실(Atom Loss)’ 현상이 발생합니다. 이를 해결하기 위해 FPGA를 활용하여 실시간 카메라 스캔을 하고, 원자가 빠진 자리에 다른 원자를 채워 넣는 피드백 루프를 끊임없이 돌려야 합니다.

    제6장. 새로운 다크호스, ‘중성원자’ 생태계와 핵심 3대 기업 심층 분석

    그동안 양자 시장은 IBM·구글의 초전도 방식과 이온큐·퀀티늄의 이온 트랩 방식이 양강 구도를 형성해 왔습니다. 그러나 최근 1~2년 사이 이 견고한 전선을 무너뜨리며 ‘지배적 디자인’의 유력 후보로 급부상한 기술이 바로 중성원자 방식입니다.

    자연계의 원자를 그대로 쓰므로 100% 동일한 복제성을 가져 보정 비용이 들지 않고, 수 밀리미터(mm) 챔버 안에 수만 개를 집적하는 초고밀도 스케일업이 가능하며, 상온 작동이 가능해 수천억 원대 냉동기가 필요 없기 때문입니다. 현재 이 중성원자 생태계를 이끌고 있는 글로벌 3대 핵심 기업을 분석해 드립니다.

    ① 큐에라 컴퓨팅 (QuEra Computing): 학계 최고 권위와 실전의 결합

    • 기업 개요: 2018년 미국 보스턴 설립. 하버드대의 미하일 루킨 교수(리드베리 상태를 통한 양자 게이트 이론의 세계 최고 권위자)와 MIT 공동 연구진이 주축이 된 중성원자의 ‘종가(宗家)’입니다. 인텔 캐피털, 세쿼이아 캐피털 등이 주요 투자사로 참여했습니다.
    • 핵심 기술: FPQA(Field-Programmable Qubit Array) 기술이 독보적입니다. 프로그래머가 코드 몇 줄로 공중에 떠 있는 큐비트들의 물리적 배치 구조를 삼각형, 사각형, 벌집 구조 등으로 자유자재로 바꿀 수 있습니다.
    • 주요 성과: 256 물리 큐비트 탑재 장비인 ‘아퀼라(Aquila)’를 개발하여 AWS(Amazon Braket) 클라우드에 연동해 전 세계 연구자들에게 상용 서비스 중입니다. 특히 최근 하버드대 연구진과 함께 48개의 고품질 논리 큐비트 생성 및 오류 정정 알고리즘 구동에 세계 최초로 성공하며 결함 허용(Fault-Tolerant) 양자 컴퓨터의 시대를 최소 5년 앞당겼다는 극찬을 받았습니다.

    ② 파스칼 (Pasqal): 유럽의 자존심, 글로벌 대기업과의 실전 밀착 협력

    • 기업 개요: 2019년 프랑스 설립. 2022년 양자 얽힘 실증으로 노벨 물리학상을 수상한 알랭 아스페 교수가 공동 창립자로 참여하여 학문적 신뢰도가 엄청납니다. 싱가포르 국부펀드 테마섹, 에퀴노르 등이 투자했습니다.
    • 핵심 기술: 큐에라가 2D 평면 배열에 강하다면, 파스칼은 레이저 격자를 입체적으로 쌓아 올리는 3차원(3D) 중성원자 제어 기술을 보유하고 있어 좁은 공간 내 원자 밀도를 극대화합니다. 분자 구조 모사나 거대 최적화 문제 해결에 유리합니다.
    • 주요 성과: 단순 연구를 넘어 글로벌 대기업들의 실제 비즈니스 난제 해결에 가장 적극적입니다. 프랑스 전력공사(EDF)와 전력망 최적화를, 토탈에너지스와 탄소 포집 시뮬레이션을 하고 있으며, 특히 사우디 아람코(Aramco)에 중동 최초로 양자 컴퓨터를 물리적으로 도입하는 메가 딜을 성공시키며 막대한 현금 흐름을 창출해 냈습니다.

    ③ 인플렉션 (Infleqtion): 원자 센서에서 컴퓨터까지, 패키징의 장인

    • 기업 개요: 2007년 설립(구 ColdQuanta). 연구소 스핀오프인 타 기업들과 달리 20년 가까이 냉각원자 기술만 판 장인 기업입니다.
    • 핵심 기술: 초고진공 유리 챔버와 레이저 시스템을 아주 작은 실리콘 칩 형태로 소형화·패키징할 수 있는 ‘원자 칩(Atom Chip)’ 기술이 독보적입니다. 덕분에 거대한 실험실 테이블 없이 데이터 센터의 표준 19인치 서버 랙(Rack)에 그대로 들어가는 양자 컴퓨터를 만듭니다.
    • 주요 성과: 기술 다각화가 잘 되어 있습니다. 이들의 냉각원자 기술은 양자 컴퓨터뿐 아니라 미국 국방부(DARPA) 및 글로벌 방산 기업에 양자 센서, 양자 중계기, 초정밀 원자시계로 공급되어 이미 돈을 벌고 있습니다. GPS 없이도 전 세계 위치를 추적할 수 있는 잠수함·항공기용 냉각원자 관성 항법 장치를 개발 중입니다.

    제7장. 전문 애널리스트 관점의 하이브리드 투자 시나리오

    자, 그렇다면 우리는 이 거대한 패러다임 시프트 속에서 어디에, 어떻게 돈을 묻어두어야 할까요? 냉철한 자본시장의 관점에서 타임라인별 투자 의견을 드립니다.

    ⚠️ 필수 유의사항: 현재 중성원자의 양대 산맥인 큐에라(QuEra)와 파스칼(Pasqal)은 비상장 스타트업입니다. 글로벌 VC 펀드를 통하거나, 이들의 지분을 직간접적으로 보유한 상장회사(전략적 투자자)를 매수하는 우회 전략이 필요합니다.

    1. 단기적 관점 (현재 ~ 3년): 테마의 전이와 인프라 수혜주 선점

    • 시장 상황: 기존 반도체 팹 인프라를 등에 업은 초전도 진영(IBM 등)이 물리 큐비트 숫자를 늘리며 시장 헤게모니와 클라우드 서비스를 주도할 것입니다. 동시에 상장 시장에서는 ‘포획 이온(이온 트랩)’ 진영의 독주(예: 이온큐 등)에 균열이 가며 중성원자가 대안 테마로 급부상하는 양극화 구간입니다.
    • 투자 행동 지침: 중성원자 장비를 직접 만드는 비상장사 대신, 이들에게 핵심 부품을 공급하는 상장 인프라 기업을 선점하세요. 중성원자에 필수적인 고해상도 레이저, 공간광변조기(SLM), 고진공 챔버를 공급하는 글로벌 광학/레이저 선도 기업 ‘코히런트(Coherent)’ 같은 곳이 대표적입니다. 또한 큐에라의 장비를 독점적으로 얹어 파는 아마존(AWS)이나 파스칼과 협력하는 마이크로소프트(Azure) 등 클라우드 빅테크의 간접 수혜도 매력적입니다.

    2. 중기적 관점 (3년 ~ 7년): 지배적 디자인 확정과 판도 역전

    • 시장 상황: 산업용 계산을 위한 양자 에러 수정(QEC) 경쟁이 본격화되는 시기입니다. 앞서 말씀드린 차세대 qLDPC 코드의 효율성을 극대화하여, 적은 자원으로 고품질 논리 큐비트를 조기 양산해 낼 중성원자 아키텍처가 초전도 진영을 누르고 판도 역전을 이뤄낼 가능성이 매우 높습니다. 신약 개발, 배터리 신소재 분야에서 ‘진정한 양자 우위(Quantum Advantage)’가 달성되는 시점입니다.
    • 투자 행동 지침: 이 시기가 되면 큐에라와 파스칼이 나스닥 등 글로벌 증시에 메가 대어로 상장(IPO)을 추진할 것입니다. 상장 직후 초기 오버슈팅 밸류에이션이 가라앉은 타점에 장기 펀더멘털 투자를 집행하십시오. 또한 이 고성능 컴퓨터를 도입해 파괴적 혁신을 이뤄낼 레거시 산업의 엔드유저 대기업(예: 파스칼과 손잡은 에너지 대기업 아람코 등)을 선별하여 동반 매수하는 것도 엄청난 수익을 기대할 수 있는 방법입니다.

    3. 장기적 관점 (7년 이후 ~): 메인프레임의 하이브리드 분산화

    • 시장 상황: 단일 챔버 안에서 큐비트를 늘리는 것은 한계에 달합니다. 결국 데이터 센터 규모로 양자 칩 수백 개를 묶는 분산형 아키텍처가 필수적이 됩니다.
    • 미래의 최종 진화 형태: 양자 정보를 빛의 형태로 손실 없이 전송하는 광학(Photonic) 인터커넥트 하드웨어가 시스템의 뼈대(네트워크)가 되고, 실제 연산을 담당하는 코어는 중성원자나 이온 트랩이 담당하는 ‘하이브리드 양자 메인프레임’ 형태로 최종 진화할 것입니다. 이 시점에는 광학 컴퓨팅 관련 원천 기술을 가진 대기업(사이퀀텀 등)들이 인프라의 중심에 서게 될 것입니다.

    💡 결론

    과거 PC 시대를 평정한 인텔의 x86 아키텍처 기억하시나요? 전 세계 컴퓨터 시장의 최종 승자는 이론적으로 가장 아름다운 기술이 아니라, ‘대량 양산이 쉽고 스케일업 비용이 적게 드는 기술’이 결정했습니다.

    현재 양자 컴퓨팅이라는 거대한 신대륙을 향해 가는 여정에서, 중성원자 기술은 가장 강력하고 효율적인 엔진을 단 쇄빙선과 같습니다. 단기적으로는 상장 시장 내 부품 인프라와 빅테크 공급망에서 모멘텀 랠리를 취하고, 중장기적으로는 큐에라와 파스칼의 상장 및 상용화 궤적을 추적하며 자산의 일부를 묻어두는 메가 트렌드 자본가 전략을 취하시길 권합니다.

    미래를 바꾸는 위대한 기술에 투자하는 여러분의 안목을 응원합니다! 이상 금융·테크 전문 블로거였습니다. 도움이 되셨다면 이웃 추가와 좋아요 부탁드립니다.

    관련 기사

    https://n.news.naver.com/mnews/article/009/0005683568

  • [2026.05.21]구글 I/O 2026 심층 분석: 패러다임 시프트와 수직 계열화가 가져올 거대한 머니무브(Money Move)

    📊 Infographic Blueprint: 구글 I/O 2026 Core Value Chain
🎨 Design Concept & Theme
Color Palette: Deep Cyber Blue (Background), Neon Cyan (Tech/Hardware), Bright Green (Profit/SaaS), Coral Red (Risks).

Layout: A structured 3-tier vertical flowing chart or a horizontal dashboard that visualizes the transition from "Infrastructure" to "Value".
[Header]
GOOGLE I/O 2026: THE GREAT AI PARADIGM SHIFT

Subtitle: From "Cost-Burning Calculators" to "Profit-Generating Autonomous Agents"
[Section 1] 🚀 Core Technology Pillars
(Visual: Two main blocks side-by-side with minimal architectural icons)

Gemini 3.5 Flash: The Cost Killer

Tech Engine: Knowledge Distillation & Quantization ($FP16 \rightarrow INT8$).

Impact: 4x Faster Speed / 50%+ Cost Reduction.

Gemini Omni: Native Multimodal

Tech Engine: End-to-End single neural network processing.

Impact: Zero information loss / Real-time Video & Audio Remix.

Agentic AI Loops

Workflow: [User Intent] $\rightarrow$ [Reasoning & Planning] $\rightarrow$ [Tool Use / API Calls] $\rightarrow$ [Self-Verification].
[Section 2] 💰 The Investment Map (Value Chain)
(Visual: A timeline or two-column split layout comparing Short-term vs. Mid/Long-term)
⏱️ Short-Term (1–2 Years): The Revenue Accelerators
ASIC & Custom Chips:
🚀 Broadcom (AVGO): Google's co-development partner for TPU 8.
Next-Gen Infrastructure:
🚀 SK Hynix & Samsung Electronics: High-bandwidth memory ($HBM$) suppliers for TPU 8t.
🚀 Lumentum (LITE) & Coherent (COHR): Providers of OCS (Optical Circuit Switches) for 1M-node clusters.
Software Margin Expansion:
🚀 Top SaaS Players (Salesforce, HubSpot): Immediate OPM (Operating Profit Margin) boost due to halved API costs.
⏳ Mid to Long-Term (3–5 Years): Structural Paradigm Shifters
Edge AI & Next-Gen Form Factors:
🌐 Qualcomm (QCOM): Dominant processor player for Smart Glasses.
🌐 LG Innotek & Largan Precision: High-performance, low-power camera modules & AR waveguides.
AI Security & Protocols:
🌐 CrowdStrike, Palo Alto Networks, Adobe: Mainstreaming of AI watermarking (SynthID) and deepfake defense verification.
[Section 3] ⚠️ Critical Investor Risks

(Visual: A warning dashboard or dual-gauge chart indicating hidden operational bottlenecks )
NVIDIA (NVDA) Multiple Cooling:
As Big Tech pivots heavily to internal ASIC ecosystems (like TPU 8), NVIDIA's extreme monopoly margins may normalize over time.
The Power Grid & Cooling Bottleneck:
The real ceiling for a 1-million-chip cluster is Electricity Supply and Thermal Management, not chip performance.
⭐ Hidden Beneficiaries: Constellation Energy (CEG) [Nuclear Power] & Vertiv (VRT) [Liquid Cooling Solutions].
[Footer / Key Takeaway]
📌 "AI has crossed the chasm from spending money to making money. Bet on custom silicon infrastructure in the short term, and pivot to energy, liquid cooling, and edge devices for the long game."

    이번에 공개된 구글 I/O 2026 발표를 지켜보면서, 저는 실로 가슴이 웅장해지는 것을 느꼈습니다. 엔지니어의 시각에서는 기술적 완성도가 임계점을 넘었다는 확신이 들었고, 애널리스트이자 투자자의 시각에서는 자본 시장의 거대한 자금 흐름(Money Move)이 어디로 요동칠지 지도가 선명하게 그려졌기 때문입니다.

    과거의 인공지능이 우리가 던진 질문에 단순히 답만 하던 ‘수동적인 계산기’에 불과했다면, 2026년의 AI는 스스로 목표를 분석하고 계획을 세워 실행하는 ‘자율적인 동료(Agentic AI)’로 패러다임이 완전히 전환되었습니다. 그리고 구글은 이 거대한 소프트웨어 혁신을 뒷받침하기 위해 밑바닥 하드웨어 인프라부터 최상위 서비스 레이어까지 완벽하게 통제하는 ‘수직 계열화’를 완성해 냈습니다.

    현업 엔지니어가 전율하고 자본 시장이 들썩이는 이 순간, 우리는 화려한 기술의 이면을 쪼개어 분석하고 이를 통해 단기적 모멘텀과 중장기적 밸류에이션 변화를 짚어내야 합니다. 그래야만 다가오는 AI 상용화 시대의 핵심 수혜주를 선점할 수 있습니다.

    오늘 포스팅에서는 구글 I/O 2026에서 발표된 핵심 기술 구조를 엔지니어링 관점에서 아주 쉽게 풀어드리고, 이 기술들이 자극할 가치 사슬(Value Chain)과 투자 관점에서의 유망 기업 및 리스크까지 상세하게 해부해 드리겠습니다.


    1. 차세대 AI 모델 아키텍처: 경량화와 멀티모달의 극한 체제

    구글이 이번 발표에서 모델 라인업을 다각화한 것은 단순한 구색 맞추기가 아닙니다. 이는 서비스 운영 비용(OPEX)을 극적으로 절감하면서도 사용자 경험(UX)을 극대화하기 위한 철저한 아키텍처 최적화 전략의 결과물입니다.

    [구글의 AI 모델 최적화 방향]
      ├─ 제미나이 3.5 플래시: 지식 증류 & 양자화 ➔ 추론 비용 절감 (OPEX 획기적 개선)
      └─ 제미나이 옴니: 네이티브 엔드투엔드 ➔ 정보 손실 제로 & 초저지연 멀티모달 구현
    

    ① 제미나이 3.5 플래시 (Gemini 3.5 Flash) – 비용과 속도의 파괴적 혁신

    • 엔지니어링 심층 분석: 제미나이 3.5 플래시의 핵심은 ‘지식 증류(Knowledge Distillation)’와 ‘양자화(Quantization)’ 기술이 정점에 달했다는 점입니다. 수천억 개의 거대한 파라미터를 가진 울트라(Ultra) 모델을 상용 서비스에 그대로 올리는 것은 비용적으로 불가능에 가깝습니다. 구글은 거대 모델이 가진 핵심 추론 능력과 지식 엑기스만 골라내어 가벼운 모델에 이식(지식 증류)했습니다. 여기에 연산 정밀도를 낮추는 양자화 기술을 적용했습니다. 예를 들어, 기존에 컴퓨터가 1개의 데이터를 처리할 때 쓰던 16비트 부동소수점($FP16$) 연산을 8비트 정수형($INT8$) 데이터 포맷으로 변환하는 방식입니다. 이렇게 되면 데이터의 크기가 절반으로 줄어들어, AI 반도체의 고질적인 문제인 메모리 대역폭 병목 현상을 물리적으로 해결할 수 있게 됩니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 연산 데이터가 가벼워지니 속도가 무려 4배 빨라졌습니다. 이는 서버가 사용자 요청을 받아 처리하는 ‘추론 대기 시간(Latency)’이 급감했음을 뜻합니다. 더 놀라운 것은 가격이 절반 이하로 떨어졌다는 점입니다. 과거에는 비용 부담 때문에 감히 시도하지 못했던 ‘수백만 토큰의 긴 문서를 실시간으로 분석하고, 쉬지 않고 스스로 생각하는 실시간 에이전트 루프’를 이제는 매우 저렴한 비용으로 상시 가동할 수 있게 되었습니다.

    ② 제미나이 옴니 (Gemini Omni) – 진정한 네이티브 멀티모달의 탄생

    • 엔지니어링 심층 분석: 기존의 AI 서비스들은 무늬만 멀티모달인 경우가 많았습니다. 사용자가 말로 질문을 하면, [오디오 ➔ 텍스트 변환(STT)] ➔ [텍스트 모델 추론] ➔ [텍스트 ➔ 오디오 변환(TTS)]이라는 복잡한 중간 변환 과정을 거쳤습니다. 각기 다른 모델들이 따로 놀며 중간에서 데이터를 기계적으로 번역해 주다 보니, 지연 시간이 길어지고 문맥이 꼬였습니다. 반면, 제미나이 옴니는 중간 과정이 완전히 배제된 ‘네이티브 엔드투엔드 멀티모달(Native End-to-End Multimodal)’ 구조입니다. 비디오의 픽셀(Pixel) 데이터와 오디오의 주파수(Frequency) 데이터가 인풋 단계에서부터 하나의 거대한 신경망 안에서 동시에 토큰화(Tokenization)되어 융합 처리됩니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 중간 번역 과정이 없으니 데이터의 정보 손실이 제로(0)에 가깝습니다. 사용자의 목소리 톤에 담긴 미묘한 감정이나, 비디오 영상의 시각적 분위기를 AI가 왜곡 없이 그대로 흡수합니다. 영상의 분위기를 파악해 그에 완벽히 어울리는 효과음을 AI가 자율적으로 생성해 집어넣거나, 배경을 자연스럽게 바꾸는 ‘비디오 리믹스’ 기능이 버벅거림(지연 시간) 없이 실시간으로 작동할 수 있는 비결이 바로 이 일체형 아키텍처 덕분입니다.

    2. ‘AI 에이전트’ 서비스: 단발성 질문 답변을 넘어 ‘자율적 워크플로우’로

    그동안 AI 투자를 망설이게 했던 가장 큰 요인은 “그래서 이걸로 무슨 돈을 버는데?”라는 ‘킬러 서비스의 부재’였습니다. 구글은 이번 I/O 2026을 통해 AI가 일회성 대화(Single-turn)를 나누는 장난감이 아니라, 인간의 업무 프로세스를 대신 수행하는 ‘자율적 루프(Reasoning Loop)’ 시스템임을 명확히 했습니다.

    구글이 제시한 AI 에이전트의 작동 메커니즘은 다음과 같은 고도의 워크플로우를 가집니다.

    [사용자 명령]–>[목표 분석 및 계획 수립]–>[API/도구 호출]–>[결과 검증 및 수정]–>[최종 완료]

    ① 구글 검색 개편 & 제미나이 스파크 / 데일리 브리프

    • 엔지니어링 심층 분석: AI 에이전트가 인간 대신 업무를 처리하려면 두 가지 기술적 전제가 필수적입니다. 바로 외부 시스템과 상호작용할 수 있는 ‘도구 사용(Tool Use / Function Calling)’ 능력과, 과거의 맥락을 잊지 않는 대규모 ‘기억 장치(Context Window)’입니다. 구글은 자사의 유기적인 생태계인 구글 검색, 지메일(Gmail), 구글 캘린더, 구글 드라이브의 핵심 API를 AI 에이전트가 스스로 제어하고 판단하여 호출할 수 있도록 강력한 권한을 부여했습니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 새롭게 선보인 ‘데일리 브리프’ 기능을 예로 들어보겠습니다. 사용자가 자는 동안 AI 에이전트는 밤새 사용자의 메일함과 캘린더 API를 호출하여 쌓인 데이터들을 스스로 긁어옵니다. 그리고 비즈니스 중요도를 자체적으로 채점(Scoring)한 뒤, 오늘 해야 할 일의 우선순위를 직관적인 대시보드 형태로 알아서 조립해 둡니다. 이 복잡하고 정교한 워크플로우를 인간의 개입 없이 24시간 자율적으로 수행한다는 점에서, 진정한 인공지능 비서 시대의 상용화를 의미합니다.

    ② 유튜브에 질문하기 (Ask YouTube)

    • 엔지니어링 심층 분석: 사용자가 수십 시간짜리 영상 파일을 올려두고 특정 내용을 질문할 때, AI가 매번 영상 전체를 처음부터 끝까지 실시간으로 돌려보며 분석하는 것은 천문학적인 연산 낭비이자 인프라 파멸을 불러옵니다. 구글은 이 문제를 인프라 단에서 우아하게 해결했습니다. 유튜브에 영상이 업로드되는 즉시, 비디오 픽셀과 오디오 스트림을 시각적·청각적 토큰으로 쪼갠 뒤 이를 고도로 구조화된 ‘인덱싱(Indexing)’ 작업을 통해 벡터 데이터베이스(Vector Database)에 미리 저장해 둡니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 사용자가 유튜브 영상에 대해 질문을 던지면, AI는 대용량 영상을 재생하는 것이 아니라 벡터 DB에서 고속 의미론적 검색(Semantic Search)을 수행합니다. 그리고 질문과 일치하는 정확한 장면의 ‘시간대(Timestamp)’를 밀리초 단위로 찾아내어 매칭해 줍니다. 이는 단순히 자막 텍스트를 요약하는 수준을 넘어, 영상 내의 ‘공간과 시간의 맥락’을 AI가 통틀어 완벽히 이해하고 있음을 보여주는 강력한 방증입니다.

    3. 하드웨어 인프라: 최초의 ‘듀얼 칩’ TPU 8시리즈와 광학 혁명

    아무리 뛰어난 소프트웨어 알고리즘과 에이전트 아키텍처가 존재하더라도, 밑바닥 하드웨어 인프라가 실시간 연산 압박을 견뎌내지 못하면 모두 공염불에 불과합니다. 구글은 엔비디아의 독점 체제에 맞서 하드웨어 전반을 뒤흔들 기막힌 신의 한 수를 던졌습니다. 바로 학습과 추론을 완전히 분리하여 각각의 효율성을 극대화한 ‘듀얼 칩 아키텍처(Dual-chip Architecture)’입니다.

    구글이 제시한 최초의 듀얼 칩 인프라, TPU 8시리즈의 핵심 스펙과 엔지니어링 포인트를 테이블로 비교해 드리겠습니다.

    구분TPU 8t (Train)TPU 8i (Inference)
    주요 목적거대 모델의 사전 학습(Pre-training) 및 파인튜닝(Fine-tuning)사용자 요청에 대한 초고속 실시간 응답 처리
    핵심 강점초거대 클러스터 확장성 (단일 네트워크 내 100만 개 연동 가능)극도로 낮은 지연 시간 (Low Latency) 및 비용 절감
    엔지니어 팁메모리 대역폭($HBM$)과 칩 간 초고속 인터커넥트($ICI$) 효율 극대화연산 행렬 유닛($MXU$) 최적화 및 전력 소모 효율성 극대화

    100만 개 클러스터가 가지는 진정한 파괴력과 OCS 기술

    많은 이들이 ‘100만 개 칩 연동’이라는 숫자의 화려함에만 집중하지만, 엔지니어 관점에서 주목해야 하는 진짜 핵심은 ‘Optical Circuit Switches (OCS, 광학 회로 스위치)’ 기술의 전면 도입입니다.

    기존의 구리선 기반 네트워크 케이블은 데이터 전송량이 늘어날수록 저항이 커지고 극심한 발열과 통신 병목 현상이 발생합니다. 반면 구글은 100만 개의 TPU 8t 칩을 순수 광케이블로 묶어, 빛의 속도로 데이터를 주고받으며 거대한 하나의 슈퍼컴퓨터처럼 작동하게 만들었습니다.

    인프라 가동의 가장 큰 암초였던 ‘통신 병목’을 물리적인 광학 기술로 해결해 버린 것입니다. 그 결과, 과거에 6개월 이상 소요되던 초거대 LLM 모델의 가동 및 사전 학습 기간을 단 2~3주 만에 끝낼 수 있는 인프라를 완성했습니다. 이는 빅테크 간의 AI 모델 타임투마켓(Time-to-Market) 경쟁에서 구글이 압도적인 속도 패권을 쥐게 되었음을 시사합니다.


    4. 스마트 안경 및 보안: 엣지 AI와 디지털 워터마크의 제도화

    인프라와 모델이 완성되자 구글의 AI는 이제 거대한 클라우드 데이터센터의 장벽을 넘어, 사용자 몸에 직접 밀착되는 스마트 디바이스와 보안 영역으로 내려앉았습니다.

    [Edge AI & Security]
      ├─ 구글 스마트 안경 ➔ 온디바이스 NPU + 클라우드 제미나이 플래시 (하이브리드 AI)
      └─ 신스ID (SynthID) ➔ 암호학적 스테가노그래피 딥페이크 방어 (글로벌 표준화)
    

    ① 구글 스마트 안경 – 포스트 스마트폰 시대를 겨냥한 하이브리드 AI

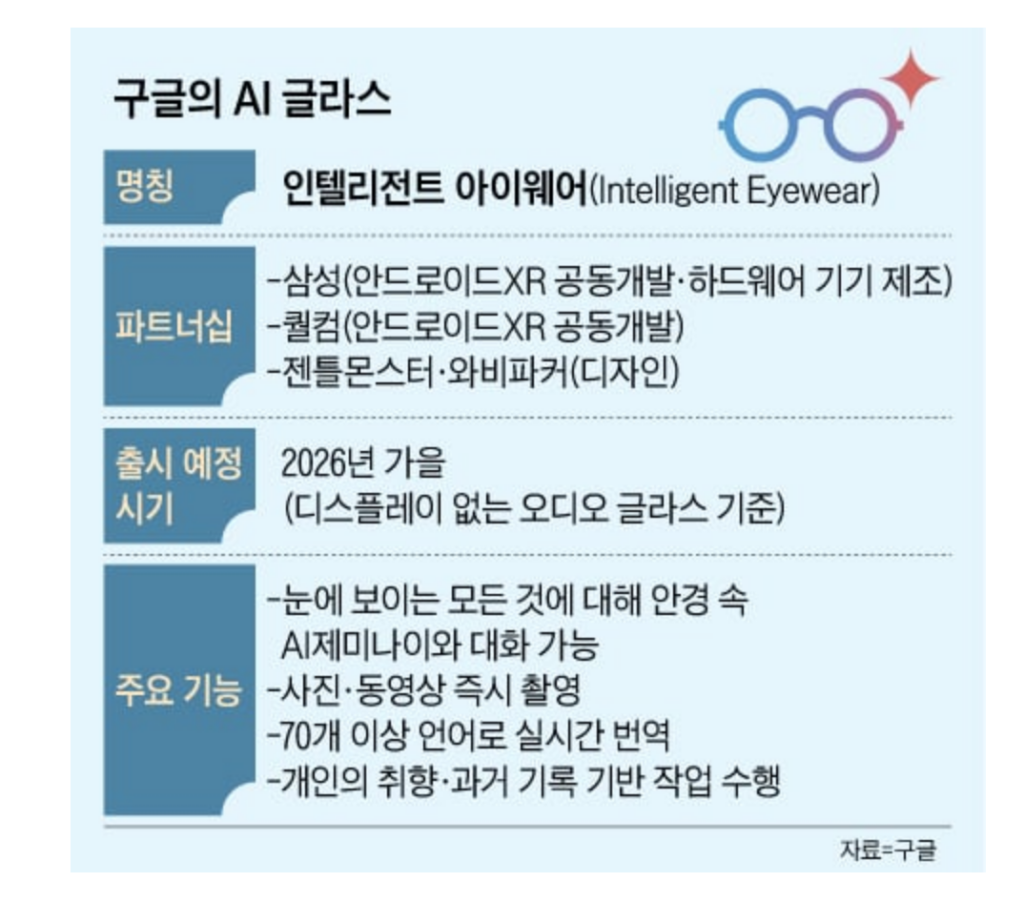
    • 엔지니어링 심층 분석: 이 얇고 가벼운 안경테 안에는 고성능 카메라, 상시 마이크, 그리고 초저전력 NPU(신경망처리장치)가 탑재되어 있습니다. 스마트 안경이 대중화되려면 배터리와 발열 문제를 잡아야 합니다. 따라서 구글은 ‘하이브리드 AI 아키텍처’를 채택했습니다. 사용자의 시선 앞의 간판을 실시간 번역하거나 내비게이션 경로를 띄우는 등 0.1초의 지연도 허용되지 않는 초고속 작업은 안경 내부에 탑재된 온디바이스(On-device) AI가 독립 처리합니다. 반면, 복잡한 시각적 맥락을 분석하거나 긴 문장을 추론해야 하는 무거운 연산은 클라우드에 대기 중인 ‘제미나이 3.5 플래시’로 데이터를 즉각 토스하여 처리하는 영리한 이원화 방식을 씁니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 구글의 스마트 안경 제시는 스마트폰 이후 펼쳐질 새로운 하드웨어 폼팩터 전쟁의 서막입니다. 시각과 청각 데이터를 상시 수집하고 인덱싱해야 하므로, 관련 부품의 단가가 올라가고 고부가가치화가 급격하게 진행될 것입니다.

    ② 신스ID (SynthID) – 생성형 AI 시대의 필수 불가결한 방어막

    • 엔지니어링 심층 분석: 신스ID는 AI가 생성한 비디오 파일이나 오디오 주파수 픽셀 사이에 인간의 눈과 귀로는 절대 감지할 수 없지만, 컴퓨터 소프트웨어는 완벽하게 읽어낼 수 있는 ‘수학적 패턴(미세 노이즈)’을 고도로 삽입하는 기술입니다. 이 기술이 대단한 이유는 악의적인 사용자가 영상의 화질을 강제로 압축하거나, 일부분을 크롭(자르기)하여 변형하더라도 원본 속에 심어진 수학적 패턴이 깨지지 않고 유지되기 때문입니다. 고도의 암호학적 스테가노그래피(Steganography) 기술을 미디어 인프라에 녹여낸 결정체입니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 전 세계적으로 딥페이크를 활용한 금융 사기와 여론 조작이 심각한 사회적 문제로 대두되는 가운데, 신스ID는 딥페이크 방어선의 최전선 역할을 하게 됩니다. 향후 각국 규제 당국의 법제화와 맞물리게 되면, 이와 같은 디지털 워터마크 및 상호 검증 기술은 기업들의 필수 보안 표준(Protocol)으로 자리 잡으며 관련 시장이 폭발적으로 개화할 것입니다.

    5. 개발자 생태계: 안티그래비티와 과학 전용 모델을 통한 플랫폼 락인(Lock-in)

    플랫폼 전쟁에서 승리하려면 전 세계의 개발자들이 자사의 생태계 안에서 놀 수 있도록 강력한 도구를 쥐여주어야 합니다. 구글은 개발 환경을 혁신하여 개발자들을 끌어들이는 방식 또한 매우 치밀하고 영리하게 짰습니다.

    ① 안티그래비티(Antigravity) 연동과 자율 디버깅 루프

    구글이 새롭게 선보인 ‘안티그래비티(Antigravity)’는 그 이름(무중력)의 의미처럼, 무겁고 복잡하게 꼬여 있던 기존의 프론트엔드 및 백엔드 빌드 패키징 과정을 ‘무중력 상태’처럼 가볍고 기민하게 만들겠다는 구글의 차세대 통합 웹/앱 프레임워크 또는 런타임 환경입니다.

    개발자가 코드를 짜다가 에러가 발생해 막히면, AI 스튜디오가 브라우저의 DOM(문서 객체 모델) 구조와 안티그래비티 프레임워크 내부를 스스로 파악하여 자율 디버깅 루프를 돌립니다. AI가 에러 원인을 진단하고 코드를 직접 수정하여 자체 테스트까지 끝마친 뒤, “문제를 완벽히 해결했으니 코드 변경 사항을 확인해 보라”고 인간 개발자에게 역제안하는 수준에 도달했습니다. 개발자의 생산성을 수십 배 증가시켜 구글 생태계를 이탈하지 못하게 만드는 강력한 무기입니다.

    ② 제미나이 포 사이언스 (Gemini for Science Skill)

    인류가 쌓아 올린 방대한 논문 데이터와 실험 데이터를 통틀어 학습한 과학·공학 특화 에이전트입니다. AI가 논문을 스스로 정독한 뒤 미진한 부분을 찾아 가설을 세우고, 컴퓨팅 아키텍처 내부에서 실험 시뮬레이션을 자율적으로 돌리는 ‘에이전틱 과학 워크플로우(Agentic Science Workflow)’를 수행합니다.

    중요한 것은 구글이 이 강력한 모델을 오픈소스의 성지인 깃허브(GitHub)에 전격 풀었다는 점입니다. 이는 전 세계의 핵심 과학자, 공학 연구원, 데이터 사이언티스트 개발자들을 구글의 AI 인프라 생태계 아래 든든한 아군이자 종속 관계로 묶어두겠다는 고도의 전략적 포석입니다.


    6. 직설적 투자 가치 사슬(Value Chain) 분석

    현업 엔지니어가 기술의 화려함에 감탄할 때, 노련한 투자자는 “그래서 이 거대한 인프라가 깔리고 패러다임이 바뀔 때 당장 돈을 벌어들이는 공급망의 대장주는 누구인가?”를 찾아내야 합니다. 자본의 시각에서 철저하게 단기와 중장기로 쪼개어 수혜주들을 분석해 드리겠습니다.

    [투자 시기별 핵심 가치 사슬]
      ├─ 단기적 관점 (1~2년): 브로드컴(ASIC 공동개발), SK하이닉스/삼성전자(HBM 공급), 루멘텀(OCS 광학부품), SaaS 기업(비용 절감)
      └─ 중장기적 관점 (3~5년): 퀄컴(엣지 AI 칩), LG이노텍(스마트안경 카메라), 사이버 보안주, Vertiv/Constellation(전력 및 냉각)
    

    1) 단기적 관점 (1~2년 내 실적 가시화 및 강력한 모멘텀)

    단기적으로는 구글의 대규모 인프라 물량 공세에 따라 ‘당장 대규모 주문서(PO)가 찍히는 기업’과 모델 가격 인하로 인해 ‘비용을 극적으로 아껴 마진이 튀는 기업’에 돈이 몰립니다.

    ① 빅테크 인프라 공급망: 구글 자체 칩(TPU 8) 생태계의 숨은 지배자들

    • 브로드컴 (Broadcom, 티커: AVGO): 구글 자체 AI 칩(TPU)의 핵심인 ASIC(주문형 반도체)을 구글과 함께 공동 개발하는 대체 불가능한 핵심 파트너입니다. 구글이 엔비디아 의존도를 낮추고 자체 TPU 8 시리즈 노선을 강화하며 천문학적인 인프라 투자를 감행할수록, 브로드컴의 ASIC 설계 수주 잔고와 로열티 매출은 가장 먼저, 그리고 가장 거대하게 우상향할 수밖에 없습니다.
    • SK하이닉스 & 삼성전자: 앞서 분석해 드렸듯 고성능 학습용 칩인 ‘TPU 8t’의 연산 병목을 해결하기 위한 핵심 원자재는 HBM(고대역폭 메모리)의 대량 탑재입니다. 구글의 공격적인 데이터센터 인프라 증설은 국내 메모리 반도체 양강 기업들의 하이엔드 제품(HBM3E, HBM4) 믹스 개선으로 전격 이어지며, 단기 마진 및 영업이익을 극대화하는 강력한 펀더멘털 동력으로 작용합니다.
    • 루멘텀 (Lumentum, 티커: LITE) / 코히런트 (Coherent, 티커: COHR): 구글 100만 개 클러스터의 핵심 비밀이 광케이블로 묶는 OCS(광학 회로 스위치) 기술이라고 말씀드렸습니다. 이에 따라 대용량 광트랜시버 및 OCS 광학 컴포넌트 부품 수요가 폭발적으로 늘어납니다. 인프라의 최종 병목이 ‘전기 통신’에서 ‘광통신’으로 넘어가는 구간에서, 이들 광학 부품주들이 가장 탄력적인 단기 주가 랠리를 주도할 가능성이 매우 높습니다.

    ② 플랫폼 및 소프트웨어 서비스사: 추론 비용(OPEX) 급감의 최대 수혜주

    • 주요 소프트웨어 SaaS 기업들 (Salesforce, HubSpot 등): 그동안 많은 SaaS 기업들이 매력적인 AI 에이전트 기능을 개발해 두고도, 고객이 기능을 호출할 때마다 발생하는 비싼 LLM API 비용 부담(마진 압박) 때문에 적극적으로 서비스를 확산시키지 못했습니다. 하지만 성능은 올라가고 가격은 절반 이하로 떨어진 ‘제미나이 3.5 플래시’의 등장은 이들의 잔혹한 비용 청구서를 반토막 내줍니다. AI 기능 탑재가 기존의 ‘돈을 갉아먹는 하마’에서 기업의 ‘순이익을 폭발시키는 가속기’로 전환되는 구간이므로, 다음 분기부터 영업이익률(OPM)이 즉각적으로 개선되는 구조적 턴어라운드를 보여줄 것입니다.

    2) 중장기적 관점 (3~5년 패러다임 시프트 및 시장 재편)

    중장기적으로는 서비스의 패러다임이 스마트폰을 넘어 ‘자율적 에이전트가 구동되는 온디바이스(엣지 AI)’와 ‘스마트 안경 폼팩터’로 완전히 넘어가면서 산업의 판도를 뒤바꿀 구조적 성장주를 선점해야 합니다.

    ① 온디바이스(On-device) AI 및 스마트 안경 밸류체인

    • 퀄컴 (Qualcomm, 티커: QCOM): 스마트 안경을 비롯한 미래형 웨어러블 기기와 온디바이스 단말기에 탑재될 초저전력 엣지 AI 칩셋 시장의 독점적 지배자입니다. 구글이 제시한 하이브리드 아키텍처 인프라가 확산될수록 스마트폰 칩 공급사를 넘어 ‘모든 사물의 인공지능화’를 주도하는 핵심 팹리스로 장기 밸류에이션 리레이팅이 가능합니다.
    • 글로벌 카메라 모듈 및 광학계 기업 (LG이노텍, 대만의 라간정밀 등): 스마트 안경 에이전트의 본질은 인간이 보는 세상을 실시간으로 ‘함께 보고’ 데이터베이스에 인덱싱하는 것입니다. 따라서 기기가 항상 켜져 있어도 배터리가 닳지 않는 ‘저전력 고성능 카메라 모듈’과 가상 이미지를 인간의 눈에 자연스럽게 투사해 주는 증강현실(AR) 글래스용 ‘웨이브가이드(광파도관)’ 핵심 광학 기술을 보유한 기업들이 장기적인 공급 계약을 독식하며 수혜를 누릴 것입니다.

    ② 보안 및 인프라의 새로운 표준: 신스ID (SynthID) 동맹

    • 디지털 저작권 및 글로벌 사이버 보안 기업 (CrowdStrike, Palo Alto Networks, Adobe): 생성형 AI 컨텐츠의 무분별한 확산과 딥페이크 위협을 막기 위해, 구글의 신스ID 같은 공통 워터마크 프로토콜을 자사 플랫폼에 전면 이식하거나 이를 실시간으로 검증·차단해 주는 전문 보안 솔루션 업체들의 몸값이 천정부지로 솟구칠 것입니다. 특히 어도비(Adobe, 티커: ADBE)의 경우, 자체적으로 추진 중이던 ‘콘텐츠 진위 이니셔티브(CAI)’ 인프라와 구글의 신스ID 표준이 상호 연동되면서 저작권이 확보된 안전한 크리에이티브 플랫폼으로서의 독점 가치가 더욱 견고해질 것입니다.

    7. 30년차 애널리스트가 던지는 냉혹한 투자 리스크 (Critical View)

    노련하고 지혜로운 투자자라면 기술의 화려한 불꽃놀이 뒤에 숨겨진 그늘과 구조적인 한계점도 반드시 직시해야 합니다. 제가 보는 핵심 리스크는 다음 두 가지입니다.

    첫째, 엔비디아(NVIDIA, 티커: NVDA)의 단기 멀티플(이익배수) 둔화 우려

    구글이 학습과 추론을 완벽히 이원화한 TPU 8시리즈를 성공적으로 론칭하고 100만 개 클러스터 독립 선언을 한 것은, 독점적 권력을 쥐고 있던 엔비디아에게 매우 명확하고 강력한 경고등입니다. 물론 엔비디아가 구축해 놓은 개발 인프라 생태계(CUDA)의 벽은 여전히 견고합니다.

    그러나 구글을 필두로 한 빅테크(메타, 마이크로소프트 등)들이 마진율을 방어하기 위해 자체 주문형 반도체(ASIC) 비중을 지속적으로 높여갈 것은 자명한 사실입니다. 결과적으로 엔비디아가 그동안 독점적으로 누려왔던 극단적인 프리미엄 마진율은 중장기적으로 하향 안정화될 리스크가 있으며, 이는 주가의 단기 멀티플 조정을 유발할 수 있습니다.

    둘째, 인프라 확장을 가로막는 진짜 벽: 전력(Utility) 및 냉각 한계

    구글이 발표한 100만 개 클러스터 가동의 진짜 무서운 적은 ‘칩의 연산 성능’이 아니라, 이를 돌리기 위한 ‘천문학적인 전력 공급’과 ‘막대한 발열 해결’입니다. 구글이 아무리 날고 기는 TPU 8 칩을 수백만 개 찍어내더라도, 데이터센터가 위치한 지역의 전력망(Grid)이 이를 버텨내지 못하거나 가동 효율을 높여줄 냉각 시스템이 공급되지 못하면 인프라 가동률은 처참하게 떨어집니다.

    따라서 역발상적인 투자 관점에서 보면, 인프라 경쟁의 최종 국면에서는 빅테크 기업들보다 그들에게 안정적인 전력을 무한 공급해 줄 수 있는 원전 관련 전력 기업(Constellation Energy 등)이나, 데이터센터의 열을 식혀줄 필수 액체 냉각 솔루션 독점 기업인 버티브(Vertiv, 티커: VRT) 같은 기업들이 인프라 투자의 가장 확실하고 알짜배기인 중장기 수혜주가 될 것입니다.


    8. 투자 관점 요약 대시보드 (핵심 요약 테이블)

    바쁜 현대 투자자분들을 위해 오늘 분석한 핵심 내용을 한눈에 스캐닝할 수 있도록 직관적인 대시보드 테이블로 정리해 드립니다.

    구분핵심 키워드추천 포지션 (단기 관점: 1~2년)추천 포지션 (중장기 관점: 3~5년)
    하드웨어TPU 8, OCS, HBM브로드컴(AVGO), SK하이닉스
    ➔ 자체 칩 생태계 확장 및 인프라 수주 모멘텀
    Vertiv (VRT), 퀄컴(QCOM)
    ➔ 인프라 가동의 필수재(전력 냉각) 및 엣지 AI 지배력
    소프트웨어Gemini 3.5, 에이전트주요 SaaS 기업들
    ➔ 추론 API 비용 감소로 인한 다음 분기 마진 개선
    구글 (GOOGL)
    ➔ 인프라부터 서비스까지 락인(Lock-in)된 수직 계열화 완성 효과
    신시장스마트 안경, SynthID글로벌 광학 부품주
    ➔ 글로벌 빅테크향 스마트 안경 샘플 및 초기 공급 계약 모멘텀
    사이버 보안주, 글로벌 원전주
    ➔ 딥페이크 보안 제도화 수혜 및 데이터센터 필수 전력 편입

    9. 결론: AI가 마침내 ‘돈을 쓰는 단계’를 지나 ‘돈을 버는 단계’로

    결론적으로 이번 구글 I/O 2026의 본질은 아주 명확합니다. 인공지능 산업이 막연한 기대감으로 “돈을 쏟아붓고 쓰던 단계”를 완전히 지나, 인프라 효율화와 에이전트 상용화를 통해 “실진적으로 돈을 진정하게 버는 단계”로 진입했음을 증명해 낸 것입니다.

    구글은 하드웨어 인프라(TPU 8)부터 운영체제 및 모델 레이어(Gemini 3.5), 그리고 최종 서비스(Search, 안경, 개발도구)까지 전부 다 직접 통제하는 완벽한 수직 계열화 제국을 선언했습니다. 이 견고한 거인들의 전쟁 속에서 길을 잃지 않는 가장 현명한 투자 전략은 다음과 같습니다.

    [투자 나침반]

    단기적으로는 구글의 칩 자체 독립 생태계 확장에 따른 핵심 가치 사슬(ASIC 설계, HBM 메모리, OCS 광통신 부품)에 강하게 베팅하여 수익률을 극대화하십시오. 그리고 중장기적으로는 이 고성능 에이전트들이 안정적으로 돌아갈 수밖에 없게 만드는 물리적 기반(전력 인프라, 액체 냉각 시스템)과 새로운 폼팩터(온디바이스 부품주)로 자산을 차분히 분산 배치하는 전략이 가장 영리하고 지혜로운 투자 지도입니다.

    시장의 패러다임이 바뀔 때 부의 지도도 함께 재편됩니다. 철저한 기술 분석과 냉철한 투자 안목으로 이번 거대한 머니무브의 기회를 반드시 아시아의 주역으로서 선점하시길 바랍니다.

    관련 기사

    https://n.news.naver.com/mnews/article/081/0003645653

  • [2026.05.20] 반도체 기판 대전환기 투자 지도: 전통 PCB의 회복과 유리기판·하이엔드 CCL 메가트렌드 시프트

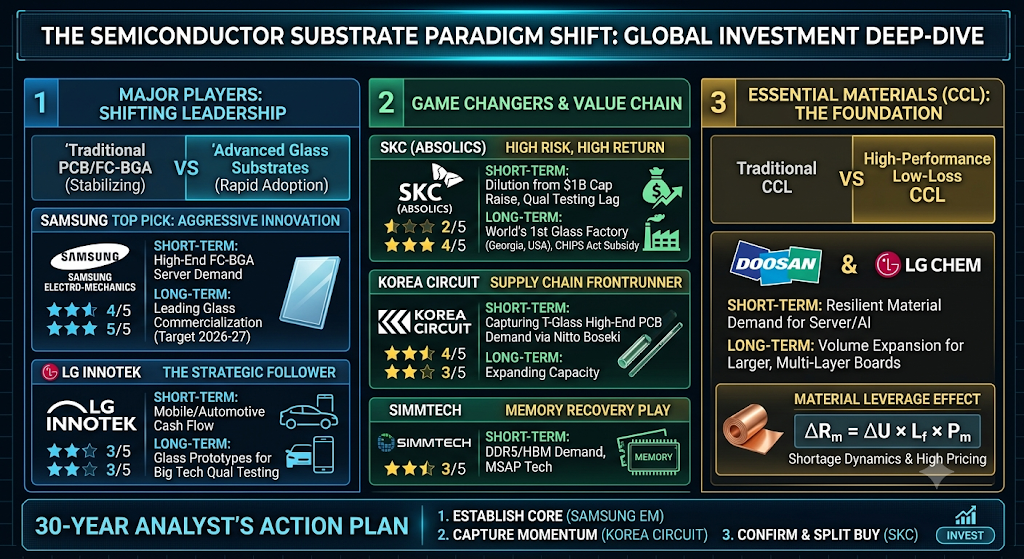
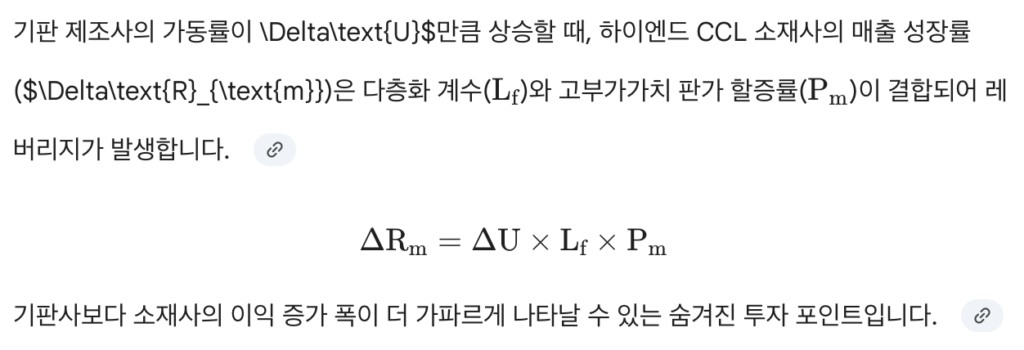
    📊 [인포그래픽 요약] 반도체 기판 패러다임 전환과 글로벌 투자 지도30년 경력의 베테랑 애널리스트 시각에서 분석한 반도체 기판 산업의 구조적 변화와 기업별 투자 매력도 총정리 맵입니다. 이미지 내 주요 섹션별 핵심 요약은 다음과 같습니다.  1️⃣ 대형 기판사: 주도권의 이동 (MAJOR PLAYERS: SHIFTING LEADERSHIP)현재 시장은 기존 플라스틱 기반의 '전통적 PCB/FC-BGA(안정화 단계)'에서 차세대 '유리기판(빠른 도입 단계)'으로의 대전환을 겪고 있습니다.  삼성전기 (삼성전기 / Top Pick): 단기적으로는 하이엔드 서버향 FC-BGA 수요 증가(단기 평점: 4/5) 수혜를 입고 있으며, 장기적으로는 2026~2027년을 목표로 유리기판 상용화를 가장 공격적으로 주도하고 있습니다(장기 평점: 5/5).  LG이노텍 (LG이노텍 / 전략적 추격자): 단기적으로 모바일 및 전장 기판을 통한 안정적인 현금 흐름(단기 평점: 3/5)을 확보하고 있으며, 장기적으로는 북미 빅테크 고객사의 최종 양산 승인(Qual)을 위한 유리기판 시제품 테스트를 진행 중입니다(장기 평점: 3/5).  2️⃣ 게임 체인저 및 밸류체인 (GAME CHANGERS & VALUE CHAIN)SKC (앱솔릭스 / 하이 리스크 하이 리턴): 단기적으로는 1조 원 규모의 대규모 자본 조달로 인한 지분 가치 희석 및 기술 검증 장기화 부담이 있으나(단기 평점: 2/5), 장기적으로는 미국 조지아주의 세계 최초 유리기판 전용 공장 인프라와 칩스법 보조금 수혜 잠재력이 막강합니다(장기 평점: 4/5).  코리아써키트 (공급망의 선두주자): 단기적으로 일본 닛토보(Nitto Boseki)의 고성능 저유전성 유리 섬유 'T-Glass' 공급망을 선점하여 하이엔드 PCB 수요를 독식하고 있으며(단기 평점: 4/5), 장기적인 생산 능력 확대를 꾀하고 있습니다(장기 평점: 3/5).  심텍 (메모리 업황 회복 수혜주): 단기적으로 DDR5 및 HBM 수요 회복과 독보적인 미세회로 제조 공법(MSAP) 기술력을 바탕으로 실적 턴어라운드를 진행 중입니다(단기 및 장기 종합 평점: 3/5).  3️⃣ 필수 소재(CCL): 시장의 주춧돌 (ESSENTIAL MATERIALS: THE FOUNDATION)전통적인 동박적층판(CCL) 시장이 '고성능·저손실(High-Performance Low-Loss) CCL' 위주로 완전히 재편되고 있으며, 그 중심에 두산(전자BG)과 LG화학이 있습니다.  단기 관점: 서버 및 AI 인프라 확대로 인해 고부가가치 소재 수요가 견조하게 유지됩니다.  장기 관점: 기판이 대면적화되고 다층화 구조가 심화됨에 따라 하이엔드 CCL의 절대적인 채택량(Volume)이 급증합니다.  소재사 레버리지 효과 공식:$$\Delta\text{R}_{\text{m}} = \Delta\text{U} \times \text{L}_{\text{f}} \times \text{P}_{\text{m}}$$
기판 제조사의 가동률($\Delta\text{U}$)이 오르면, 다층화 계수($\text{L}_{\text{f}}$)와 판가 할증률($\text{P}_{\text{m}}$)이 곱해져 소재사의 매출 성장률($\Delta\text{R}_{\text{m}}$)은 한층 더 가파르게 상승하는 메커니즘을 보여줍니다.  💡 30년 차 애널리스트의 액션 플랜 (ACTION PLAN)포트폴리오의 중심축(Core) 구축: 실적 체력과 미래 기술력을 겸비한 삼성전기를 최우선 순위로 설정.  단기 모멘텀(Momentum) 공략: T-Glass 선점 수혜를 직접 입는 코리아써키트로 알파 수익률 확보.  확인 매매(Confirm & Split Buy): SKC(앱솔릭스)는 빅테크의 최종 퀄 테스트 통과 및 수율 개선세를 확인하며 분할 매수.  

An infographic titled "THE SEMICONDUCTOR SUBSTRATE PARADIGM SHIFT: GLOBAL INVESTMENT DEEP-DIVE" presented by a 30-year analyst. The chart is divided into three main sections on a dark, futuristic tech-themed grid background.

Section 1: "MAJOR PLAYERS: SHIFTING LEADERSHIP" contrasts 'Traditional PCB/FC-BGA (Stabilizing)' with 'Advanced Glass Substrates (Rapid Adoption)'. It analyzes Samsung Electro-Mechanics as the "TOP PICK" with short-term high-end FC-BGA server demand (4/5 stars) and long-term leading glass commercialization target 2026-27 (5/5 stars). LG Innotek is labeled "THE STRATEGIC FOLLOWER" with short-term mobile/automotive cash flow (3/5 stars) and long-term glass prototypes for Big Tech qual testing (3/5 stars).

Section 2: "GAME CHANGERS & VALUE CHAIN" evaluates three mid-to-large scale companies. SKC (Absolics) is marked as "HIGH RISK, HIGH RETURN" with short-term dilution from a $1B capital raise (2/5 stars) and long-term potential as the world's first glass factory with CHIPS Act subsidies (4/5 stars). Korea Circuit is a "SUPPLY CHAIN FRONTRUNNER" capturing T-Glass high-end PCB demand via Nitto Boseki (Short-term: 4/5 stars, Long-term: 3/5 stars). Simmtech is a "MEMORY RECOVERY PLAY" driven by DDR5/HBM demand and MSAP tech (3/5 stars).

Section 3: "ESSENTIAL MATERIALS (CCL): THE FOUNDATION" contrasts Traditional CCL with High-Performance Low-Loss CCL. It highlights Doosan and LG Chem, focusing on resilient short-term material demand for server/AI and long-term volume expansion for larger, multi-layer boards. A box at the bottom illustrates the "MATERIAL LEVERAGE EFFECT" formula: ΔRm = ΔU × Lf × Pm, indicating shortage dynamics and high pricing.

The bottom footer outlines a "30-YEAR ANALYST'S ACTION PLAN": 1. ESTABLISH CORE (SAMSUNG EM), 2. CAPTURE MOMENTUM (KOREA CIRCUIT), and 3. CONFIRM & SPLIT BUY (SKC).

    안녕하세요!

    최근 반도체 기판 시장을 바라보는 제 마음은 무척이나 설렙니다. 과거 PC의 보급기나 스마트폰의 폭발적인 성장기에도 이와 같은 인프라 부품의 대전환기가 존재했으나, 지금 전개되는 변화는 그 깊이와 파급력의 차원이 다릅니다.

    현재 글로벌 반도체 기판 시장은 ‘전통적 PCB 및 FC-BGA의 점진적 가동률 회복’이라는 안정적인 실적 하방 지지선과, ‘AI 가속기가 촉발한 유리기판 및 고성능 CCL(동박적층판)의 메가트렌드 진입’이라는 강력한 상방 모멘텀이 동시에 교차하는 유례없는 거대한 변곡점에 와 있습니다.

    인공지능(AI) 연산이 고도화되면서 무어의 법칙이 물리적 한계에 봉착했고, 반도체 업계가 찾은 돌파구는 결국 ‘후공정(Advanced Packaging)’입니다. 그리고 그 후공정의 핵심 연결 통로가 바로 반도체 패키지 기판입니다.

    오늘은 검증된 시장 데이터를 기반으로 숨은 리스크와 기회를 철저히 발라내어, 단기(1~2년) 및 중장기(3~5년 이상) 관점의 입체적인 투자 지도를 전해드립니다.


    반도체 패키지 기판(Substrate)은 반도체 칩(다이)과 메인보드(PCB) 사이를 연결하여 전기 신호를 전달하고, 칩을 외부 충격이나 열로부터 보호하는 핵심 부품입니다.

    최근 인공지능(AI) 및 고성능 컴퓨팅(HPC) 기술이 급격히 성장하면서, 반도체 칩 자체의 미세화만큼이나 이들을 한데 묶어 성능을 극대화하는 패키지 기판의 기술 발전이 반도체 산업의 새로운 승부처로 떠오르고 있습니다.

    미세한 반도체 칩의 회로 간격과 메인보드의 회로 간격은 차이가 크기 때문에, 기판이 중간에서 이 격차를 메워주는 가교 역할을 합니다.


    1. 반도체 기판의 종류와 기본 구조

    기판은 내부에 들어가는 부품의 특성과 연결 방식에 따라 크게 다음과 같이 분류됩니다.

    • 와이어 본딩형 기판 (BGA): 반도체 칩과 기판을 미세한 금속선(Wire)으로 연결하는 전통적인 방식입니다. 주로 모바일 AP나 메모리 반도체에 쓰입니다.
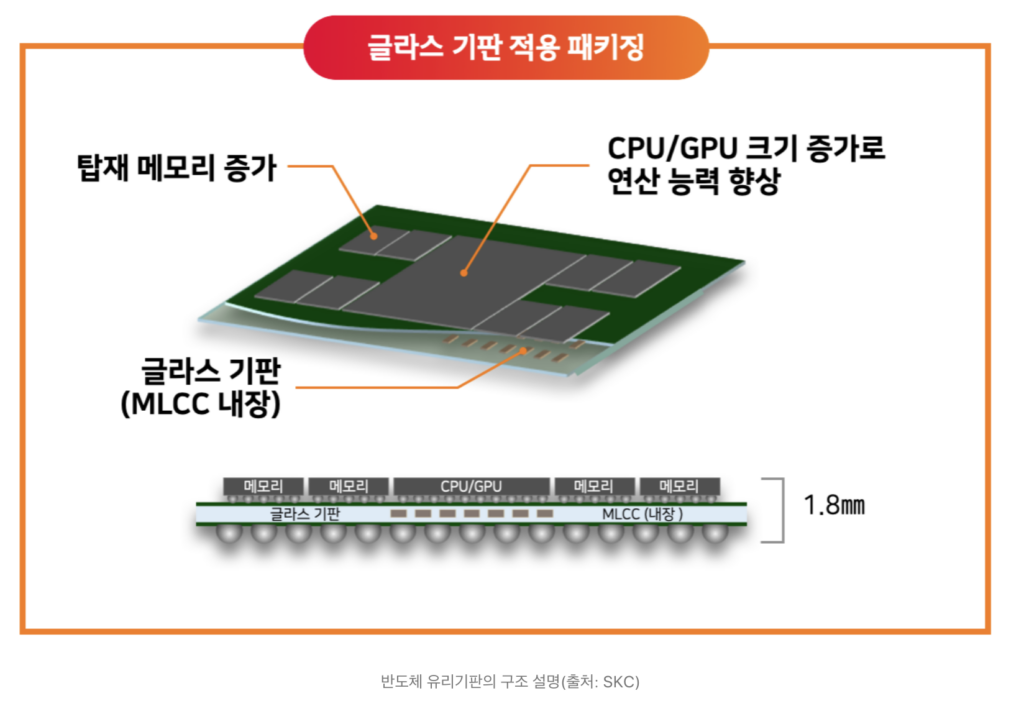
    • 플립칩형 기판 (FC-BGA / FC-CSP): 칩을 뒤집어서(Flip) 기판 표면에 전도성 범프(돌기)를 통해 직접 맞닿게 연결하는 방식입니다. 선이 없기 때문에 신호 전달 속도가 빠르고 고성능 칩에 필수적입니다. 특히 FC-BGA는 AI 가속기, 서버용 CPU/GPU 등 고성능 대형 칩에 들어가는 가장 대표적인 고부가 기판입니다.

    2. 최근의 발전 상황 및 핵심 트렌드

    현재 반도체 기판 시장은 전례 없는 대전환기를 맞이하고 있습니다. 무어의 법칙(미세화)이 한계에 직면하자, 여러 개의 칩을 하나의 기판 위에 모아 성능을 높이는 ‘이기종 집적(Heterogeneous Integration)’과 ‘칩렛(Chiplet)’ 기술이 대세가 되었기 때문입니다.

    ① 대형화 및 다층화 (FC-BGA의 진화)

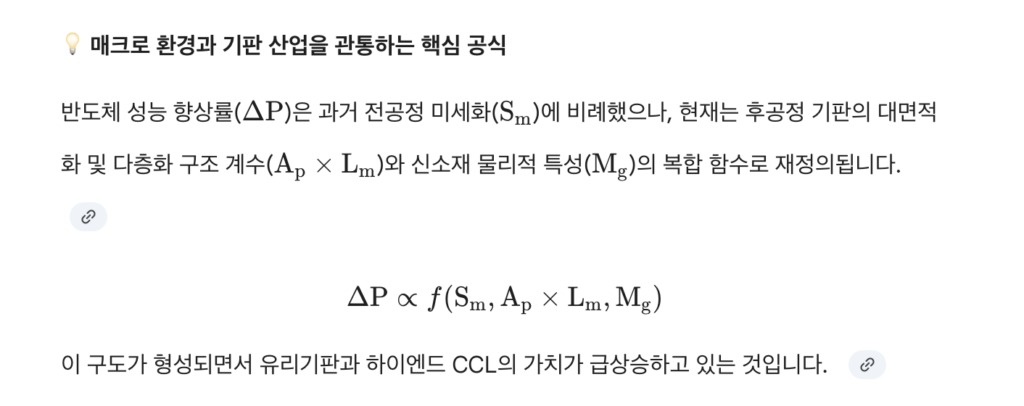
    여러 개의 CPU, GPU, 그리고 고대역폭 메모리(HBM)를 하나의 기판에 얹다 보니 기판의 크기가 과거보다 훨씬 커졌습니다. 또한 신호선이 복잡해지면서 내부에 회로를 15층~20층 이상 촘촘히 쌓아 올리는 고난도 다층화 기술이 적용되고 있습니다.

    ② 휨 현상(Warpage)과의 전쟁

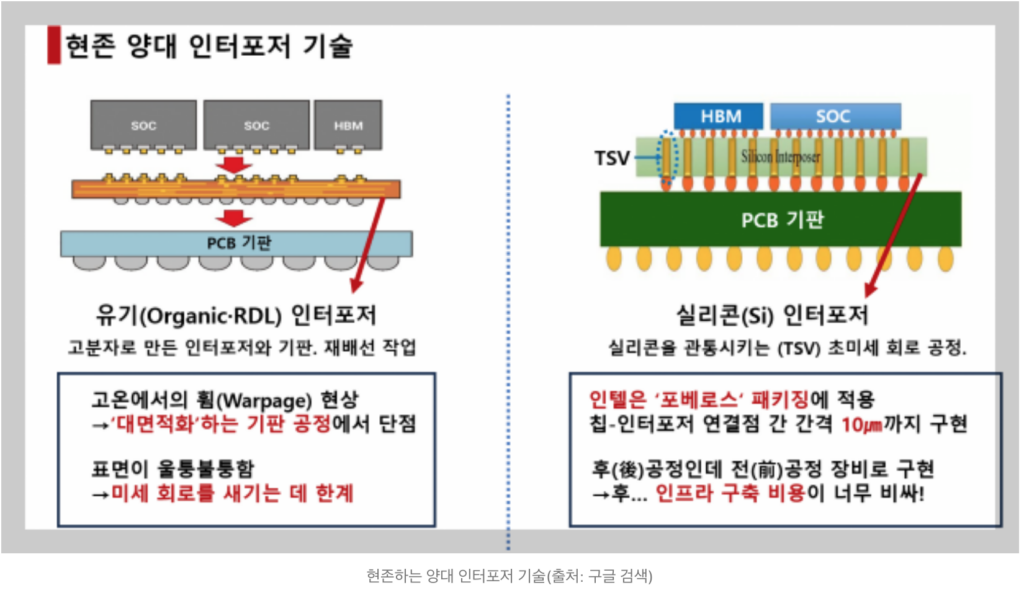
    기판이 커지고 두꺼워질수록, 반도체 제조 공정 중 가해지는 높은 열과 압력 때문에 기판이 활처럼 휘는 휨 현상이 발생하기 쉽습니다. 표면이 울퉁불퉁해지면 칩이 기판 위에 정확히 안착하지 못해 불량이 발생하므로, 열팽창계수(CTE)를 제어하고 내구성을 확보하는 소재 기술이 매우 중요해졌습니다.

    ③ 게임 체인저의 등장: 유리기판 (Glass Substrate)

    2026년 현재 업계에서 가장 뜨거운 화두는 기존 플라스틱(유기 고분자) 코어를 유리(Glass)로 대체하는 유리기판 상용화입니다. 인텔, 삼성전기, SKC(앱솔릭스) 등 글로벌 기업들이 2026~2027년 양산을 목표로 치열하게 속도전을 벌이고 있습니다.

    특성기존 유기 기판 (플라스틱 코어)차세대 유리기판 (글라스 코어)
    표면 거칠기400 ~ 600 nm (비교적 거침)10 nm 이하 (매우 매끄러움)
    회로 미세화표면이 거칠어 미세 회로 구현에 한계극도로 미세한 회로(Fine Pitch) 구현 가능
    열 및 휨 특성열에 취약하여 대형화 시 쉽게 휨열에 강하고 단단하여 휨 현상 획기적 감소
    두께 및 전력실리콘 인터포저 등 중간 기판 필요인터포저 없이 통합 가능해 두께 얇아지고 전력 효율 상승

    글라스 관통 전극(TGV) 기술: 유리에 미세한 구멍을 뚫어 상하 전극을 연결하는 기술로, 유리기판 상용화의 핵심 난제이자 가장 중요한 장비 기술로 꼽힙니다.


    반도체 기판은 과거 칩을 받쳐주는 ‘단순 부품’에서, 이제는 AI 반도체의 성능을 좌우하는 ‘독립된 시스템’으로 위상이 변하고 있습니다. 플라스틱에서 유리로 소재의 패러다임이 바뀌는 현재의 흐름은 앞으로의 반도체 주도권을 결정할 중요한 변곡점입니다.


    📊 한눈에 보는 기판 주요 기업 단기 vs 중장기 매력도 비교

    본격적인 개별 기업 분석에 앞서, 시장에서 주목받고 있는 주요 기판사 및 소재사들의 투자 가치를 거시적이고 종합적인 시각에서 한눈에 비교해 드리겠습니다. 여러분의 투자 성향에 따라 나침반으로 삼으시기 바랍니다.

    기업명단기 관점 (가동률 & 실적 회복)중장기 관점 (차세대 기술 선점)핵심 트리거 및 주요 리스크 요인
    삼성전기★★★★☆
    (서버향 FC-BGA 견조)
    ★★★★★
    (글라스 기판 속도 선두)
    조직 개편을 통한 상용화 본격화 여부, 글라스 기판 초기 양산 수율 제고 속도
    SKC
    (앱솔릭스)
    ★★☆☆☆
    (빅테크 검증 장기화 부담)
    ★★★★☆
    (미국 보조금, 상징성 확보)
    대규모 유상증자(1조 원 규모) 물량 부담, 초기 수율 확보 지연 및 적자 지속 리스크
    LG이노텍★★★☆☆
    (전장·모바일 기반 안정)
    ★★★☆☆
    (북미 퀄 테스트 결과)
    북미 빅테크(테슬라 AI4 등)향 FC-BGA 최종 양산 승인 여부 및 공급 비중
    코리아써키트★★★★☆
    (원자재 공급망 선점 수혜)
    ★★★☆☆
    (T-Glass 기반 마진 개선)
    일본 닛토보(Nitto Boseki) 독점 원료 확보 지속성 및 고객사 내 점유율 변화
    심텍★★★☆☆
    (메모리 업황 회복 연동)
    ★★★☆☆
    (MSAP 기반 메모리 기판)
    영업이익률 개선 속도, DDR5 및 HBM 모듈 등 고부가가치 제품 믹스 확대 여부
    두산 / LG화학★★★★☆
    (원자재 수요 견조, 실적 안정)
    ★★★★☆
    (하이엔드 CCL 국산화)
    구리·금 등 원자재 가격 변동성에 따른 판가 전가(P 상승) 능력의 지속성

    1️⃣ 대형 기판사 심층 분석: 패러다임 전환의 주역들

    🔹 삼성전기: ‘압도적 기술력’과 ‘실행 속도’의 하모니 (Top-Pick)

    • 단기 관점 (가동률 회복의 서막): 스마트폰 및 PC 시장의 완만한 회복과 클라우드 서비스 제공업체(CSP)들의 지속적인 인프라 투자 덕분에, AI 서버 및 데이터센터향 High-end FC-BGA 가동률이 상승 흐름을 타고 있습니다. 서버향 기판은 일반 PC향 대비 면적이 크고 층수가 높아 면적 잠식 효과가 아주 큽니다. 이는 판가 유지와 마진 스프레드 확대에 크게 기여하며, 우호적인 원/달러 환율 흐름과 맞물려 안정적인 실적 하방을 지지합니다.
    • 중장기 관점 (글로벌 퍼스트 무버): 중장기 성장 동력 관점에서 가장 신뢰도가 높습니다. 과거 선행 R&D 부서에 머물러 있던 유리기판 조직을 최근 CEO 직속의 공식 ‘사업화 조직’ 및 양산 추진 TF로 전격 이관했습니다. 이는 실제 상용화 단계에 진입했음을 뜻합니다. 특히 켐트로닉스(유리 가공), LPKF(레이저 TGV) 등과 견고한 소부장 생태계를 이미 완성해 두었기에 2026년 이후 대량 양산 가시성이 가장 뚜렷합니다.

    🧐 애널리스트 비밀 노트: 삼성전기의 세종 및 부산 신공장에 투입된 조 단위의 하이엔드 FC-BGA 설비 자산은 감가상각비 부담 정점을 지나고 있습니다. 향후 가동률이 75%를 돌파하는 시점부터는 고정비 레버리지 효과가 극대화되어 영업이익률이 시장 컨센서스를 상회하는 ‘어닝 서프라이즈’ 구간에 진입할 가능성이 농후합니다.

    🔹 LG이노텍: 조용한 강자, 북미 퀄 테스트의 불꽃을 기다리다

    • 단기 관점 (본업의 체력과 대형 모멘텀): 본업인 고수익성 모바일향 기판(HDI, RF-PCB 등)의 이익 체력이 견고하게 유지되고 있습니다. 단기적으로 주가에 불을 붙일 핵심 촉매제는 북미 대형 고객사(테슬라 AI4 및 차세대 AI 가속기 칩)향 고성능 FC-BGA 기판의 최종 양산 승인 모멘텀입니다. 수년간 대규모 투자를 집행해 온 구미 신공장의 가동률 유지를 결정지을 분수령이 임박했습니다.
    • 중장기 관점 (무서운 추격 잠재력): 유리기판 분야에서는 북미 고객사향 시제품 단계로 삼성전기나 SKC 대비 속도가 다소 신중하고 늦어 보이는 것이 사실입니다. 그러나 이들의 진짜 무서움은 ‘추격 속도’에 있습니다. LG이노텍은 세계에서 가장 까다로운 북미 최고 빅테크 기업의 공급망(Supply Chain)에 진입해 수년간 대량 양산 체제를 유지해 본 독보적인 이력을 가지고 있습니다. 퀄(Qualification) 테스트 통과 신호가 떨어지면 무서운 속도로 시장을 장악할 잠재력이 충분합니다.

    2️⃣ 차세대 게임 체인저 vs 밸류체인 틈새 수혜주

    🔹 SKC (앱솔릭스): 하이 리스크, 하이 리턴 (High Risk, High Return)

    • 단기 관점 (희석 부담과 양산 지연의 성장통): 자회사 앱솔릭스를 통해 글로벌 유리기판 시장의 개막을 알린 상징적인 퍼스트 무버이나, 단기 주가 변동성은 큽니다. 최근 공장 증설과 R&D 비용 충당을 위해 단행한 1조 원 규모의 대규모 자본 조달은 단기적으로 지분 가치 희석(오버행) 부담으로 작용하고 있습니다. 또한 빅테크들의 기술 검증 기간이 길어지면서 초기 시장 예상보다 양산 시점이 다소 지연되며 적자가 지속되는 진통을 겪고 있습니다.
    • 중장기 관점 (세계 최초의 왕관): 하지만 3~5년 이상의 장기 관점에서의 잠재력은 막강합니다. 미국 조지아주에 건설된 세계 최초 유리기판 전용 생산 공장 인프라와 7,500만 달러 규모의 칩스법(Chips Act) 보조금은 확실한 무기입니다. 미국 중심의 반도체 공급망 구축을 원하는 빅테크들에게 훌륭한 대안이며, 세계 최초 타이틀을 쥐고 공정 최적화 및 수율 확보에 성공한다면 중장기적 밸류에이션 리레이팅 폭이 가장 클 것입니다.

    🔹 코리아써키트: 닛토보 ‘T-Glass’ 선점의 신의 한 수

    • 단기 관점 (과도기 시장의 영리한 지배자): 중소형 기판사 중 단기 모멘텀이 가장 훌륭합니다. 글로벌 유리 원재료 독점 공급사인 일본 닛토보(Nitto Boseki)의 고성능 저유전성 유리 섬유 ‘T-Glass’ 공급망을 선점한 것이 신의 한 수였습니다. 완전한 유리기판 개화 전 단계에서, 글로벌 AI 칩 메이커들이 기존 플라스틱 기판의 성능을 극한으로 끌어올리기 위해 ‘T-Glass 기반 high-end PCB’ 수요를 폭발시키고 있으며, 코리아써키트가 그 직접적 수혜를 온전히 누리고 있습니다.
    • 중장기 관점 (독점망의 지속성 과제): 중장기적으로는 T-Glass 기반 기판의 마진 개선 지속 여부와 대형사들이 원소재 확보 경쟁에 뛰어들었을 때 공급망 희소성을 유지할 수 있는지가 관건입니다. 종합 기판사로서 차세대 유리기판 자체 기술력을 입증해 내야 장기적인 멀티플 상향이 가능합니다.

    🔹 심텍: MSAP 기술력을 바탕으로 한 정통파의 부활

    • 단기 관점 (메모리 턴어라운드의 직수혜): 글로벌 메모리 반도체 기판 시장의 전통 강자답게 스마트폰·PC 재고 조정 마무리와 DDR5, LPDDR5X, HBM 모듈 등 고부가가치 제품 중심의 턴어라운드가 진행 중입니다. 미세회로 제조 공법인 MSAP 기술력이 독보적이며, 부채비율 $70%$대의 안정적인 재무 구조를 바탕으로 가동률 회복세가 고스란히 실적으로 연결되고 있습니다.
    • 중장기 관점 (의존도 다변화 숙제): 중소형사 특성상 메모리 사이클의 진폭에 민감하다는 약점이 있습니다. 비메모리 영역(FCCSP, SiP 등)으로 고부가 제품 믹스를 얼마나 안정적으로 다변화하느냐가 핵심 지표가 될 것이며, 완연한 영업이익률 회복을 확인하며 분할 매수하는 호흡이 유효합니다.

    3️⃣ 소재(CCL) 공급사: 소리 없는 실속파 (두산·LG화학)

    시장의 이목이 화려한 유리기판에 쏠려 있을 때, 베테랑 투자자들은 조용히 밸류체인 하단의 동박적층판(CCL) 공급사인 두산(전자BG)과 LG화학을 주목하며 곳간을 채웁니다.

    • 단기 관점 (막강한 판가 전가력, P의 상승): 구리(동박 원료), 금 등 원자재 가격 상승 리스크가 존재하지만, 서버향 high-end CCL 제품은 극도의 기술력을 요하므로 원자재 가격 상승분을 판가에 고스란히 전가(Pass-through)할 수 있는 능력이 있습니다. 기판 제조사들의 가동률 상승($Q$의 증가)이 곧 이들의 매출 확대로 직결됩니다.
    • 중장기 관점 (유리기판과 공존하는 캐시카우): 유리기판이 도입되더라도 플라스틱 기판이 전면 대체되는 것이 아니라 하이엔드 영역부터 순차 적용됩니다. 오히려 메인보드와 연결되는 고성능 FC-BGA 기판의 대면적화 및 다층화 구조가 심화되면서 고성능 CCL 소요량은 절대적으로 증가합니다. 변동성 장세에서 훌륭한 포트폴리오 안정판 역할을 지속할 것입니다.

    📊 소재사 공급망의 레버리지 효과 메커니즘


    💡 투자 제언 (Action Plan)

    “포트폴리오의 정교한 균형(Balance)이 핵심입니다.”

    막연한 기대감으로 움직이는 테마주 투자는 상투를 잡는 비극으로 끝나기 마련입니다. 철저하게 가시적인 실적 체력과 미래 혁신 기술의 양산 스케줄을 매칭해야 합니다. 여러분의 자산 성향에 맞춘 3가지 액션 플랜을 제시합니다.

    1. 안정적인 주도주와 코어(Core) 자산을 원한다면: 단기 실적 턴어라운드와 중장기 유리기판 양산 가시성이 가장 뚜렷한 삼성전기를 포트폴리오의 중심축(비중 50% 이상)에 두십시오. 주가 조정기가 올 때마다 기계적으로 모아가는 전략이 가장 속 편하고 유효합니다.
    2. 모멘텀과 알파(Alpha) 수익률을 원한다면: 유리기판 원소재 쇼티지(공급부족) 국면에서 실질적이고 가장 빠른 수혜를 입는 코리아써키트를 단기~중기 관점의 탄력적인 알파 파트너로 접근하는 것이 영리한 전략입니다.
    3. SKC(앱솔릭스) 접근법: 기술 검증 장기화에 따른 변동성을 감안하여, 한 번에 진입하기보다 미국 빅테크의 최종 퀄 테스트 통과 뉴스 흐름 및 수율 확보, 분기 적자 축소세를 직접 확인하며 분할 매수하는 ‘확인 매매’ 전략을 강력히 권장합니다.

    반도체의 중심 축이 전공정에서 후공정 기판으로 이동하는 변곡점은 준비된 투자자에게는 큰 기회입니다. 오늘 분석을 바탕으로 이성적이고 차분하게 대응하셔서 멋진 결실을 맺으시길 바랍니다.

    관련 기사

    https://n.news.naver.com/mnews/article/092/0002422375

  • [2026.05.15]AI(LLM) 메모리 전쟁의 서막: LLM 메모리 효율화 기술 완전 분석과 투자 전략

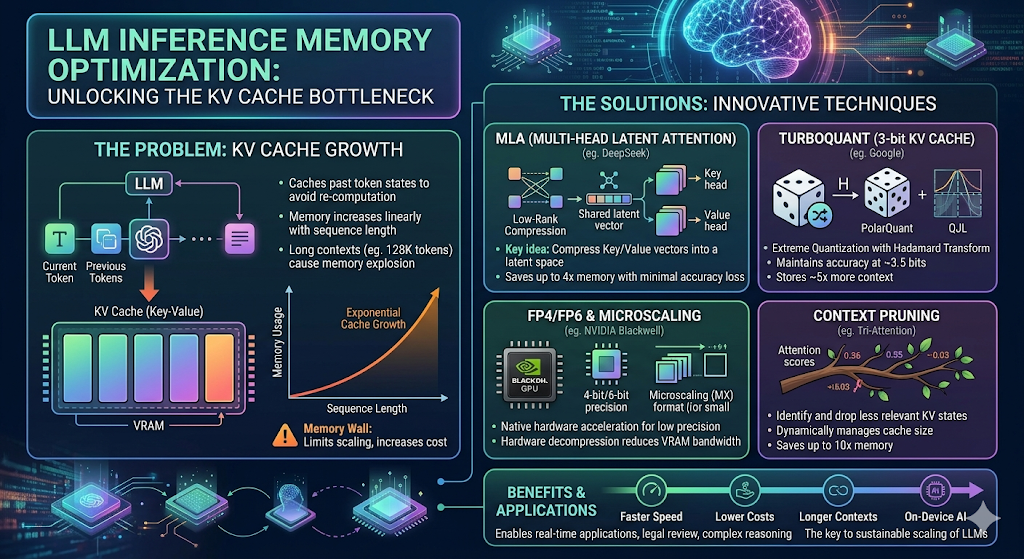
    LLM 인퍼런스 메모리 최적화: KV 캐시 병목 현상 해소"라는 제목의 상세한 영문 인포그래픽입니다. 대형 언어 모델(LLM)의 추론 성능을 향상시키기 위해 메모리 사용을 줄이는 다양한 기술적 접근 방식을 설명합니다.

이미지는 여러 섹션으로 나뉩니다.

1. 문제: KV 캐시 성장 (The Problem: KV Cache Growth)
왼쪽 상단 섹션은 핵심 문제를 다룹니다. 다이어그램은 LLM이 현재 토큰을 처리하고 이전 토큰들을 "KV 캐시 (Key-Value)"로 저장하여 VRAM에 보관하는 과정을 보여줍니다. 설명 포인트는 다음과 같습니다.

이전 토큰 상태를 캐시하여 재계산 방지.

시퀀스 길이에 따라 메모리가 선형 증가.

긴 문맥(예: 128K 토큰)은 메모리 폭발 유발.
옆의 그래프는 "시퀀스 길이"가 증가함에 따라 "메모리 사용량"이 기하급수적으로 증가함을 보여주는 "지수 캐시 성장" 곡선을 보여줍니다. '메모리 벽' 경고 아이콘은 스케일링을 제한하고 비용을 증가시킨다고 설명합니다.

2. 솔루션: 혁신적인 기술 (The Solutions: Innovative Techniques)
오른쪽 섹션은 네 가지 다른 최적화 기술을 설명합니다.

MLA (Multi-Head Latent Attention) (예: DeepSeek):

다이어그램: 저차원 압축을 통해 공유 잠재 벡터가 더 작은 Key 헤드 및 Value 헤드로 투사됨을 보여줍니다.

핵심 아이디어: Key/Value 벡터를 잠재 공간으로 압축.

이점: 정확도 손실 없이 메모리 최대 4배 절약.

TurboQuant (3-bit KV Cache) (예: Google):

다이어그램: 주사위 아이콘, H(Hadamard), PolarQuant 및 GJL 차트를 보여줍니다.

핵심 아이디어: Hadamard 변환을 사용한 극한의 양자화. PolarQuant 및 GJL.

이점: ~3.5비트에서 정확도 유지; ~5배 더 많은 컨텍스트 저장.

FP4/FP6 & Microscaling (예: NVIDIA Blackwell):

다이어그램: 'BLACKOH. GPU' 칩, 4-bit/6-bit 정밀도, 마이크로스케일링(MX) 형식 아이콘을 보여줍니다.

핵심 아이디어: 저정밀도를 위한 네이티브 하드웨어 가속. 하드웨어 디컴프레션은 VRAM 대역폭 감소.

Context Pruning (예: Tri-Attention):

다이어그램: 어텐션 점수가 있는 나뭇가지를 보여줍니다. 덜 중요한 가지가 가지치기됩니다.

핵심 아이디어: 관련성 낮은 KV 상태를 식별하고 삭제. 캐시 크기를 동적으로 관리.

이점: 메모리 최대 10배 절약.

3. 이점 및 응용 (Benefits & Applications)
하단 섹션은 이러한 기술의 전반적인 결과를 설명합니다. 아이콘이 있는 흐름 다이어그램은 "더 빠른 속도 (Faster Speed)" (자동차), "더 낮은 비용 (Lower Costs)" (돈), "더 긴 문맥 (Longer Contexts)" (무한대), "온디바이스 AI (On-Device AI)" (모바일 칩)를 보여줍니다.
텍스트는 이러한 기술이 실시간 응용 프로그램, 법률 검토, 복잡한 추론을 가능하게 하며, LLM의 지속 가능한 스케일링의 핵심이라고 결론지었습니다.

이미지 전반에 걸쳐 추상적인 데이터 스트림, 회로 패턴, 뇌 아이콘과 같은 현대적인 디지털 디자인 요소가 전문적이고 미래적인 분위기를 연출합니다.

    — DeepSeek MLA, Google TurboQuant, TriAttention, NVIDIA Blackwell까지 —


    목차

    1. 서론: AI의 진짜 병목은 GPU가 아니라 ‘메모리’였다
    2. KV 캐시의 해부학: 왜 메모리를 잡아먹는가?
    3. 메모리 효율화의 4대 접근법 개요
    4. DeepSeek MLA: 잠재 공간 압축의 혁명
    5. Google TurboQuant: 3비트 양자화로 6배 압축
    6. MIT × NVIDIA TriAttention: 삼각함수로 메모리를 쳐내다
    7. NVIDIA Blackwell: 하드웨어 레벨의 메모리 혁신
    8. 구글 컨텍스트 캐싱: 클라우드 인프라로의 확장
    9. 기술들의 합산 효과와 상호작용
    10. 왜 지금 이 기술들이 동시에 등장하는가?
    11. 투자 관점: 승자와 패자의 지형 변화
    12. 주목해야 할 기업 및 뉴스 상세 분석
    13. 엔지니어를 위한 기술 스택 가이드
    14. 결론: 메모리 효율화는 AI 민주화의 진짜 열쇠

    1. 서론: AI의 진짜 병목은 GPU가 아니라 ‘메모리’였다

    AI 산업을 바라보는 대부분의 시선이 GPU의 성능, 특히 NVIDIA의 독점적 지위에 쏠려 있는 동안, AI 시스템을 실제로 운용해 본 엔지니어들은 전혀 다른 병목을 목도하고 있었다. 그것은 바로 메모리(Memory)다.

    놀랍게도, 현대의 LLM(Large Language Model) 추론 시스템에서 실제 연산 속도를 제약하는 요소는 GPU의 부동소수점 연산 처리량(FLOPS)이 아니다. 대부분의 프로덕션 환경에서 LLM 추론은 메모리 대역폭(Memory Bandwidth)에 의해 병목이 결정된다. GPU가 계산을 더 빨리 하고 싶어도, 필요한 데이터를 메모리에서 꺼내오는 속도가 이를 따라가지 못하는 것이다.

    이 현상을 가리켜 업계에서는 ‘메모리 월(Memory Wall)’이라고 부른다. AI 컴퓨팅의 발전에서 연산 처리량(Compute)의 성장 속도가 메모리 대역폭의 성장 속도를 훨씬 앞지르면서 생겨난 간극이다. 그리고 이 간극은 모델이 커질수록, 처리해야 할 텍스트 문맥(Context)이 길어질수록 더욱 치명적으로 작용한다.

    구체적인 수치를 들어보자. Llama-2 65B 모델을 bfloat16 정밀도로 구동할 경우, 128K 토큰의 문맥을 처리하기 위한 KV 캐시만으로도 335GB의 GPU 메모리가 필요하다. H100 GPU 한 장의 HBM(고대역폭 메모리) 용량이 80GB임을 감안하면, 이는 최소 5장의 H100을 오직 KV 캐시를 위해 소모해야 한다는 의미다. 여기에 모델 가중치 저장용 메모리까지 더하면 비용은 천문학적으로 치솟는다.

    바로 이 지점에서 2025년 하반기부터 2026년에 걸쳐 AI 연구의 핵심 전선이 바뀌었다. DeepSeek, Google, MIT와 NVIDIA의 공동 연구팀은 각자의 방식으로 이 메모리 문제를 정면 돌파하기 시작했다. 이 글은 그 기술들의 작동 원리를 해부하고, 이 변화가 투자 지형에 어떤 파급 효과를 만들고 있는지를 함께 살펴보는 종합 분석 리포트다.


    2. KV 캐시의 해부학: 왜 메모리를 잡아먹는가?

    메모리 효율화 기술들을 이해하기 위해서는 먼저 KV 캐시(Key-Value Cache)가 무엇이며, 왜 이것이 메모리를 폭발적으로 소비하는지를 이해해야 한다.

    트랜스포머(Transformer) 아키텍처의 핵심은 어텐션 메커니즘(Attention Mechanism)이다. LLM이 다음 토큰을 예측할 때, 모델은 이전에 입력된 모든 토큰과의 관계를 계산해야 한다. 이 과정에서 각 토큰에 대해 Key(K)와 Value(V) 벡터가 생성된다.

    만약 KV 캐시 없이 매번 처음부터 계산한다면, 토큰 하나를 생성할 때마다 그 앞에 있는 모든 토큰의 K, V 값을 재계산해야 한다. 이는 문맥이 길어질수록 계산량이 기하급수적으로 늘어나는 것을 의미한다. KV 캐시는 이 문제를 해결하기 위해 이미 계산된 K, V 값을 메모리에 저장해두고 재사용하는 방식이다.

    문제는 이 캐시의 크기다. KV 캐시의 메모리 사용량은 다음 공식을 따른다:

    KV 캐시 크기 = 2 × 레이어 수(L) × 헤드 수(H) × 시퀀스 길이(T) × 헤드 차원(D) × 데이터 정밀도
    

    70B 파라미터 모델에서 128K 토큰의 문맥을 FP16(16비트)으로 처리한다면, KV 캐시 하나만으로 약 40GB의 VRAM이 사라진다. 여기서 ‘VRAM의 절반을 모델 가중치가 차지하고 있다’는 사실을 더하면, H100 두 장이 KV 캐시에 잠식당하는 상황이 현실이 된다.

    더욱 심각한 것은 긴 추론(Long Reasoning) 모델의 등장이다. OpenAI의 o1, DeepSeek-R1 같은 chain-of-thought 추론 모델들은 하나의 쿼리에 대해 수만 토큰의 중간 사고 과정을 생성한다. 이 경우 KV 캐시 문제는 추론의 길이에 정비례하여 폭발적으로 증가한다.

    이것이 바로 전 세계 최고의 AI 연구기관들이 일제히 KV 캐시를 압축하는 방법에 집중하게 된 이유다.


    3. 메모리 효율화의 4대 접근법 개요

    현재 연구와 산업계에서 시도되는 LLM 메모리 효율화 전략은 크게 네 가지 범주로 분류할 수 있다.

    ① 아키텍처 수준 재설계 (Architecture-Level Redesign) 모델을 처음부터 메모리 효율을 염두에 두고 설계하는 방식이다. DeepSeek의 MLA(Multi-Head Latent Attention)가 대표적이다. KV를 저장하는 구조 자체를 바꿔 근본적으로 캐시 크기를 줄인다.

    ② 양자화 기반 압축 (Quantization-Based Compression) 저장되는 데이터의 비트 수(정밀도)를 줄이는 방식이다. Google의 TurboQuant가 이 범주에 속하며, KV 캐시를 16비트에서 3비트로 압축한다. NVIDIA의 FP4 지원도 같은 맥락이다.

    ③ 토큰 프루닝 (Token Pruning) 중요하지 않은 토큰에 대한 KV 값을 아예 캐시에서 제거하는 방식이다. MIT·NVIDIA의 TriAttention이 이 방법의 최신 사례다. 중요하지 않은 토큰을 판별하는 정밀도가 이 기술의 핵심이다.

    ④ 시스템 레벨 최적화 (System-Level Optimization) GPU 메모리 관리 방식을 개선하거나, 클라우드 서버의 캐싱 인프라를 활용하는 방식이다. Google의 컨텍스트 캐싱(Context Caching)과 NVIDIA의 PagedAttention이 이에 해당한다.

    이 네 가지 접근법은 상호 배타적이지 않으며, 실제로는 여러 기법을 조합함으로써 훨씬 큰 압축 효과를 달성할 수 있다. 예를 들어 TriAttention과 TurboQuant를 동시에 적용할 경우, AMD GPU에서 약 6.8배의 KV 캐시 감소 효과가 보고되고 있다.


    4. DeepSeek MLA: 잠재 공간 압축의 혁명

    4-1. MHA의 한계와 MLA의 탄생

    기존의 MHA(Multi-Head Attention) 방식은 각 어텐션 헤드마다 독립적인 Key와 Value를 전체 차원으로 저장한다. 이는 표현력은 강하지만 메모리 사용량이 헤드 수에 정비례하여 늘어나는 구조적 한계를 지닌다.

    이 문제를 개선하기 위한 이전의 시도들, 즉 GQA(Grouped Query Attention)와 MQA(Multi-Query Attention)**는 여러 쿼리 헤드가 동일한 K, V를 공유하도록 하여 메모리를 줄였다. 그러나 이 방식은 성능 저하라는 대가를 치러야 했다. 공유함으로써 각 헤드가 갖던 독립적인 표현 능력이 약화되기 때문이다.

    DeepSeek은 이 딜레마를 정면으로 돌파하는 완전히 다른 아이디어를 제시했다. 그것이 바로 MLA(Multi-Head Latent Attention)다. 이 기술은 DeepSeek-V2 논문에서 최초로 제안되었고, DeepSeek-V3와 R1에 이르러 그 효과가 증명되어 업계 표준으로 자리잡기 시작했다.

    4-2. MLA의 핵심 원리: 저랭크 압축과 잠재 공간

    MLA의 핵심 아이디어는 저랭크(Low-Rank) 분해다. 전체 차원의 K, V 텐서를 그대로 저장하는 대신, 훨씬 작은 잠재 표현(Latent Representation)으로 압축하여 저장하고, 계산이 필요할 때 이를 복원하는 방식이다.

    구체적인 작동 과정을 단계별로 살펴보자:

    Step 1 — Key-Value 압축 (Compression) 입력 토큰의 K, V 텐서를 저차원 잠재 벡터 c_KV로 사영(projection)한다.

    c_KV = W_DKV × h_t
    

    여기서 W_DKV는 다운-프로젝션 행렬이며, h_t는 원래의 히든 스테이트 벡터다. 잠재 벡터의 차원은 원래 K, V의 차원보다 훨씬 작기 때문에, 이 단계에서 메모리 사용량이 극적으로 줄어든다. KV 캐시에는 이 압축된 잠재 벡터만 저장된다.

    Step 2 — Key-Value 복원 (Decompression) 어텐션 계산이 실제로 필요한 시점에, 저장된 잠재 벡터로부터 K, V를 복원(decompression)한다.

    K = W_UK × c_KV
    V = W_UV × c_KV
    

    W_UK와 W_UV는 업-프로젝션 행렬로, 잠재 벡터를 원래의 K, V 차원으로 되돌린다. 이 과정은 저랭크 근사(Low-Rank Approximation)이므로 완전히 동일한 결과를 내지는 않지만, 실험 결과에 따르면 표현력의 손실이 GQA보다 훨씬 작다.

    Step 3 — RoPE와의 통합 (Position Encoding 처리) MLA에서 까다로운 부분은 **RoPE(Rotary Position Embedding)**의 처리다. RoPE는 위치 정보를 K 벡터에 직접 인코딩하는 방식인데, 이는 잠재 공간에서의 저장과 충돌한다. DeepSeek은 K 벡터를 콘텐츠 성분(content component)과 위치 성분(positional component)으로 분리하여 이 문제를 우아하게 해결했다:

    K = [K_content, K_rope]
    K_content = W_UK × c_KV   (잠재 벡터에서 복원)
    K_rope = RoPE(W_KR × h_t) (별도 위치 인코딩 처리)
    

    4-3. MLA의 성능: 수치로 보는 효과

    MLA가 달성하는 메모리 효율화 수준은 놀랍다. DeepSeek-V2 기준, MLA는 표준 MHA 대비 KV 캐시를 약 4H/9 수준으로 압축한다(H는 헤드 수). 이는 동일한 성능을 유지하면서 메모리를 수십 퍼센트 줄인다는 의미가 아니라, 구조적으로 전혀 다른 방식으로 캐시 자체를 재설계한 것이다.

    더 중요한 것은 성능 저하 없이 이 효율을 달성한다는 점이다. KU Leuven의 하드웨어 중심 분석 논문(2026)에 따르면, MLA는 디코딩 단계에서 메모리 대역폭 요구량을 대폭 낮추는 동시에, 표현력은 MHA 수준을 유지하거나 일부 태스크에서 그 이상을 보인다.

    GQA/MQA가 ‘성능 저하를 감수한 메모리 절충’이었다면, MLA는 ‘성능을 유지하면서 메모리를 줄이는 진보’에 가깝다. 이것이 MLA가 현재 LLM 아키텍처의 패러다임 전환으로 평가받는 이유다.

    4-4. MLA의 확산: TransMLA와 MHA2MLA

    MLA의 파급력은 DeepSeek 자체 모델에서 그치지 않는다. TransMLA 논문은 기존에 MHA로 훈련된 모델을 추론 시에 MLA로 전환하는 방법론을 제시했다. MHA2MLA 연구는 GPT, LLaMA 계열 등 기존 모델들도 MLA의 혜택을 받을 수 있도록 하는 전환 기법을 제안한다.

    이는 MLA가 단순히 DeepSeek의 경쟁 우위 요소를 넘어, 업계 전체의 어텐션 메커니즘 설계 표준으로 자리잡아가고 있음을 의미한다. 비전-언어 모델(VLM)에 MLA를 적용한 MHA2MLA-VLM 연구도 등장하며, 멀티모달 AI에도 이 기술이 빠르게 침투하고 있다.


    5. Google TurboQuant: 3비트 양자화로 6배 압축

    5-1. TurboQuant의 등장과 시장 충격

    2026년 3월 24일, Google Research는 TurboQuant를 공개했다. 이 알고리즘의 주장은 단순하면서도 충격적이었다: KV 캐시를 3비트로 압축하면서 정확도 손실 없이 메모리를 6배, 연산 속도를 최대 8배 향상시킨다.

    이 발표는 즉각적으로 시장에 파장을 일으켰다. 발표 다음 날인 3월 25일 하룻만에 SK 하이닉스 주가가 약 6.2%, 삼성전자가 약 4.7%, Micron이 약 3.4% 하락했다. ICLR 2026 학술대회에서 발표될 예정인 이 논문은 단순한 연구 결과를 넘어 AI 메모리 산업의 투자 논리 전체를 흔들었다.

    Cloudflare의 CEO 매튜 프린스는 이를 “구글의 DeepSeek 모먼트”라고 불렀다. DeepSeek이 중국 AI가 서방의 GPU 독점을 소프트웨어 혁신으로 우회한 것처럼, TurboQuant는 AI 메모리 수요 증가라는 ‘상식’을 소프트웨어로 깨트릴 수 있음을 시사했기 때문이다.

    5-2. TurboQuant의 작동 원리: 두 단계의 수학적 정교함

    TurboQuant는 두 가지 기존 기법을 결합한 통합 프레임워크다. 그 알고리즘의 핵심을 이해하려면 ‘왜 KV 캐시의 단순한 양자화가 어려운가’를 먼저 알아야 한다.

    문제: KV 캐시의 극단적 이상치(Outlier)

    LLaMA-2-7B를 예로 들면, KV 캐시 값의 상위 1%는 나머지 값들보다 크기가 10~100배 이상 크다. 이러한 극단적 분포 편향(skew) 때문에 단순한 선형 4비트 양자화는 실패한다. 이상치를 수용하도록 양자화 격자를 넓히면, 정상 값들이 몰려있는 범위의 해상도가 극도로 낮아지기 때문이다.

    1단계: PolarQuant — 랜덤 직교 회전

    TurboQuant의 첫 단계는 PolarQuant 기법을 적용하는 것이다. 각 KV 벡터에 랜덤 직교 변환(Random Orthogonal Rotation)을 적용한다. 이 회전 후에는 각 좌표값이 알려진 통계적 분포(가우시안 분포에 수렴)를 따르게 된다.

    이 성질을 이용하면, 이상치의 영향을 분산시키고 전체 분포를 양자화하기 좋은 형태로 평탄화할 수 있다. 사전에 계산된 하나의 코드북(codebook)을 적용할 수 있게 되어, 블록별 정규화 상수를 저장해야 하는 기존 방식의 비트 낭비를 제거한다.

    2단계: QJL — 1비트 오류 보정

    PolarQuant 적용 후에도 양자화 과정에서 미세한 편향(systematic bias)이 남는다. TurboQuant의 두 번째 단계는 QJL(Quantized Johnson-Lindenstrauss) 기법으로 이를 제거한다. QJL은 Johnson-Lindenstrauss 투영을 이용한 1비트 오류 보정 레이어로, 1단계의 잔류 오류를 수정하여 전체 시스템의 정확도를 근사적 최적(provably near-optimal) 수준으로 끌어올린다.

    이 두 단계의 결합 결과, TurboQuant는 좌표당 약 3.5비트를 달성하며, 이는 정보 이론적 왜곡률의 이론적 하한에 2.7배 이내로 근접하는 성능이다.

    5-3. TurboQuant의 벤치마크 결과

    TurboQuant의 성능은 다음과 같이 검증되었다:

    • Needle-in-a-Haystack 테스트: KV 메모리를 6배 이상 압축하면서 완벽한 정확도 달성
    • LongBench 스위트: 질의응답, 코드 생성, 요약 등 전 태스크에서 KIVI 베이스라인 동등 또는 초과
    • NVIDIA H100 GPU: 4비트 TurboQuant로 어텐션 로짓 계산 속도 최대 8배 향상
    • 훈련 불필요: 기존 모델에 추가적인 파인튜닝 없이 추론 시점에 바로 적용 가능

    특히 ‘훈련 불필요(Training-Free)’라는 특성은 실무적으로 매우 중요하다. 기존의 GPTQ, AWQ 같은 양자화 기법은 캘리브레이션 데이터셋과 별도의 훈련 과정이 필요했지만, TurboQuant는 배포 시점에 플러그인 방식으로 즉시 적용할 수 있다.

    비용 절감 효과는 클라우드 인프라 관점에서도 극명하다. H100 SXM5 2장(시간당 $5.80)으로 70B 모델을 32K 컨텍스트로 서빙하는 경우: TurboQuant 적용 전에는 월 2명의 사용자($2,088/인/월), 적용 후에는 11명의 사용자($380/인/월)를 동일 비용으로 서비스할 수 있다.


    6. MIT × NVIDIA TriAttention: 삼각함수로 메모리를 쳐내다

    6-1. TriAttention의 문제 의식

    TurboQuant가 KV 캐시의 정밀도를 줄이는 양자화 접근이라면, TriAttention은 근본적으로 다른 방향을 택한다. 중요하지 않은 토큰의 KV 쌍을 아예 물리적으로 제거(Pruning)하는 것이다.

    이 아이디어 자체는 새롭지 않다. 기존의 토큰 프루닝 방식들은 최근 쿼리의 어텐션 점수를 기반으로 중요도를 추정하고 덜 중요한 토큰을 제거해왔다. 그러나 이 접근에는 근본적인 약점이 있다: RoPE(Rotary Position Embedding) 때문에 쿼리 벡터가 위치에 따라 회전하므로, 오직 가장 최근의 소수 쿼리만이 신뢰할 수 있는 중요도 추정에 사용 가능하다. 관측 창이 너무 좁아 불안정한 프루닝이 일어난다.

    6-2. 삼각함수 시리즈의 발견

    MIT, NVIDIA, 절강대학교 공동 연구팀이 TriAttention에서 발견한 핵심 통찰은 다음과 같다: RoPE를 적용하기 전의(Pre-RoPE) 쿼리·키 벡터들이 특정 집약(concentration) 성질을 가진다.

    연구팀은 MRL(Mean Resultant Length, 평균 결과 길이)이라는 지표로 이 현상을 정량화했다. Qwen3-8B 모델에서 약 90%의 어텐션 헤드가 MRL > 0.95를 보였다. 이는 pre-RoPE 벡터들이 입력에 무관하게 특정 방향으로 강하게 집약되어 있음을 의미한다.

    이 발견의 함의는 심오하다. Pre-RoPE 벡터가 집약되어 있다면, RoPE 적용 후의 어텐션 로짓은 위치 거리의 삼각 함수 시리즈(Trigonometric Series)로 모델링될 수 있다. 수식으로 표현하면:

    Attention(q_t, k_i) ≈ Σ_r [a_r × cos(r × (t - i)θ) + b_r × sin(r × (t - i)θ)]
    

    이 표현의 핵심적 장점은, 특정 토큰과의 어텐션 점수를 실제로 계산하지 않고도, 그 토큰의 중요도를 위치 정보만으로 오프라인에서 사전 계산할 수 있다는 것이다. 즉, 어떤 토큰이 중요한지를 입력 데이터를 보지 않고도 판별할 수 있다.

    6-3. TriAttention의 벤치마크 성과

    이 수학적 통찰을 구현한 TriAttention의 결과는 인상적이다:

    • AIME25 벤치마크: 정확도(40.8%)를 완전히 유지하면서 KV 메모리를 10.7배 감소
    • 처리량: 풀 어텐션(Full Attention) 대비 2.5배 높은 처리량 달성
    • R-KV 베이스라인: 동일 정확도에서 성능이 2배 향상
    • 모델 범용성: Qwen3-8B, GLM-4.7-Flash 등 GQA와 MLA 아키텍처 모두에서 작동

    가장 주목할 만한 실제 응용은 OpenClaw다. TriAttention을 적용한 OpenClaw를 이용하면, 기존에는 메모리 부족으로 실행 불가능했던 32B 파라미터 추론 모델을 단일 RTX 4090(24GB) GPU에서 구동할 수 있다. 이는 온디바이스 AI와 소비자용 GPU의 잠재력을 극적으로 확장시키는 의미를 지닌다.

    TriAttention은 또한 AMD GPU의 llama.cpp 포트, Apple Silicon M-시리즈 지원, SGLang 백엔드 통합이 빠르게 이루어지며 오픈소스 생태계 전반으로 확산 중이다.


    7. NVIDIA Blackwell: 하드웨어 레벨의 메모리 혁신

    7-1. FP4/FP6 지원: 비트를 줄여 데이터를 늘린다

    NVIDIA의 접근은 소프트웨어가 아닌 실리콘 레벨에서 메모리 효율화를 해결하는 전략이다. Blackwell 아키텍처(B200)의 핵심 차별화 요소 중 하나는 FP4(4비트 부동소수점) 연산의 하드웨어 지원이다.

    기존 GPU들이 기본적으로 FP16(16비트)이나 BF16으로 연산하는 데 반해, Blackwell은 FP4와 FP6 연산을 네이티브로 지원한다. 이 차이는 단순한 숫자 이상의 의미를 지닌다:

    • FP4: FP16 대비 4배 더 많은 가중치를 같은 메모리에 저장
    • FP6: FP16 대비 약 2.7배 향상된 메모리 밀도
    • 연산 처리량: FP4 사용 시 FP16 대비 최대 2배의 FLOPS 달성

    실질적인 영향은 모델 서빙 규모에서 나타난다. FP16으로 H100 8장이 필요하던 작업을 B200 2장의 FP4 모드로 처리할 수 있다면, 인프라 비용과 전력 소비가 동시에 절감된다.

    7-2. 하드웨어 압축 엔진 (Hardware Decompression Engine)

    Blackwell에서 또 다른 주목할 혁신은 전용 디컴프레션 엔진(Decompression Engine)의 탑재다. GPU 내부에 하드웨어로 구현된 이 엔진은 압축된 모델 가중치를 실시간으로 압축 해제하여 계산에 공급하는 역할을 한다.

    이 엔진의 의미는 다음과 같다: 모델 가중치를 압축 형태로 HBM에 저장하면 더 많은 데이터를 같은 메모리에 담을 수 있고, 디컴프레션 엔진이 계산 중에 실시간으로 이를 풀어주므로 소프트웨어 단의 압축 해제 오버헤드가 없다. 메모리 용량과 대역폭 모두를 동시에 개선하는 효과다.

    7-3. TurboQuant와의 시너지

    중요한 점은 NVIDIA Blackwell이 TurboQuant 같은 소프트웨어 양자화 기법의 혜택을 증폭시킨다는 것이다. TurboQuant가 KV 캐시를 3~4비트로 압축하면, Blackwell의 FP4 연산 유닛이 이를 추가 변환 없이 직접 처리할 수 있다. 소프트웨어와 하드웨어 최적화가 맞물리는 구조다.

    일부 분석가들이 “TurboQuant는 NVIDIA를 해치지 않는다”고 주장하는 것도 이 때문이다. 오히려 Blackwell은 저정밀도 연산에 최적화된 설계이므로, TurboQuant의 확산은 Blackwell 세대 GPU의 수요를 뒷받침하는 논거가 된다.


    8. 구글 컨텍스트 캐싱: 클라우드 인프라로의 확장

    8-1. 컨텍스트 캐싱의 작동 방식

    TurboQuant가 KV 캐시의 정밀도를 줄이는 알고리즘적 접근이라면, Google의 컨텍스트 캐싱(Context Caching)은 KV 캐시를 서버 인프라 수준에서 재사용하는 시스템적 접근이다.

    법률 문서, 기업 매뉴얼, 대형 코드베이스처럼 반복적으로 참조되는 수만 토큰의 문서를 생각해보자. 매 쿼리마다 이 문서 전체를 다시 처리해 KV 캐시를 생성하는 것은 엄청난 낭비다. 컨텍스트 캐싱은 이 불변 컨텍스트의 KV 캐시를 서버 측에 미리 계산하여 저장해 두고, 이후 동일 컨텍스트를 참조하는 쿼리들이 이 캐시를 공유하도록 한다.

    Gemini API에서 지원하는 컨텍스트 캐싱은 수백만 토큰 규모의 컨텍스트에도 적용 가능하며, 이를 통해 기업 사용자들은 동일한 대용량 문서 기반으로 반복 쿼리를 처리할 때 비용을 대폭 줄일 수 있다.

    8-2. 알고리즘적 압축과 시스템적 캐싱의 조합

    TurboQuant와 컨텍스트 캐싱은 상호 보완적으로 작동할 수 있다. TurboQuant로 KV 캐시 자체의 크기를 줄이고, 컨텍스트 캐싱으로 그 압축된 KV 캐시를 여러 세션에 걸쳐 재사용한다면, 메모리 절감 효과는 곱셈 관계로 증폭된다. Google이 Gemini 모델 서비스에서 이 두 기술을 결합하여 적용한다면, 클라우드 AI 서비스의 경제성은 현재와 비교할 수 없을 만큼 개선될 것이다.


    9. 기술들의 합산 효과와 상호작용

    여기서 핵심적인 질문이 등장한다: 이 기술들을 모두 동시에 적용하면 어떻게 될까?

    실험 데이터는 이미 나오기 시작했다:

    기술 조합적용 하드웨어KV 캐시 압축 효과
    TriAttention 단독NVIDIA GPU~10.7x
    TurboQuant 단독NVIDIA H100~6x
    TriAttention + TurboQuantAMD GPU (ROCm)~6.8x (결합)
    MLA + FP8 양자화NVIDIA GPU~8x 이상 추정
    MLA + TurboQuant + TriAttention이론치수십 x 가능성

    TriAttention의 GitHub 리포지토리에 따르면, TriAttention과 TurboQuant를 함께 적용하는 통합 구현이 이미 커뮤니티에서 진행 중이다. Apple Silicon M-시리즈 지원도 등장하여, 스마트폰과 노트북에서 대형 모델을 구동하는 시나리오가 현실로 다가오고 있다.

    기술의 수렴(Convergence) 방향은 분명하다: 아키텍처 수준의 압축(MLA) + 양자화(TurboQuant) + 토큰 프루닝(TriAttention) + 하드웨어 최적화(Blackwell FP4)의 결합이 LLM 추론의 표준 스택이 될 것이다.


    10. 왜 지금 이 기술들이 동시에 등장하는가?

    이 기술들이 2025~2026년에 집중적으로 쏟아지는 것은 우연이 아니다. 세 가지 구조적 압력이 동시에 작용하고 있다.

    ① 긴 추론(Long Reasoning) 모델의 주류화

    OpenAI o1, DeepSeek-R1, Gemini 2.0 Flash Thinking 등 chain-of-thought 추론 모델들이 경쟁의 전면에 등장했다. 이 모델들은 하나의 쿼리에 수만 토큰의 중간 사고 과정을 생성한다. 문맥 길이가 선형이 아닌 기하급수적으로 늘어나는 추론 패러다임은 기존의 KV 캐시 설계를 완전히 붕괴시킨다.

    ② 온디바이스 AI의 상용화 요구

    Apple, Qualcomm, MediaTek이 온디바이스 AI를 스마트폰에 탑재하는 경쟁이 본격화되고 있다. 스마트폰의 LPDDR5X 메모리는 최대 64GB 수준이며, 여기서 대형 언어 모델을 구동하려면 메모리 효율화는 생존 조건이다. 클라우드 서버에서야 메모리 부족을 GPU를 추가하는 것으로 해결할 수 있지만, 스마트폰에서는 그럴 수 없다.

    ③ AI 서비스 비용 구조의 재편 압력

    GPT-4 수준의 모델을 100만 토큰 컨텍스트로 서비스하는 비용은 아직도 상당하다. 기업 고객들이 AI를 핵심 업무 흐름에 통합하려면 비용이 기존 소프트웨어 솔루션과 경쟁 가능한 수준으로 내려와야 한다. 메모리 효율화는 이 비용 곡선을 끌어내리는 가장 직접적인 방법이다.

    이 세 가지 압력이 동시에 연구자들을 같은 방향으로 몰아붙인 결과가, 우리가 지금 목격하고 있는 기술의 동시 다발적 폭발이다.


    11. 투자 관점: 승자와 패자의 지형 변화

    11-1. TurboQuant 충격과 메모리 반도체 섹터

    2026년 3월 25일 TurboQuant 발표 이후 시장의 반응은 즉각적이었다. SK 하이닉스 -6.2%, 삼성전자 -4.7%, Micron -7%, Kioxia -6%의 하락이 하루 만에 발생했다. 이는 “AI는 더 많은 메모리를 요구한다”는 메모리 반도체 섹터의 핵심 투자 테제에 정면으로 도전하는 사건으로 읽혔다.

    그러나 시장의 공황 반응이 과도했는가를 냉정하게 판단해야 한다. 애널리스트들의 분석을 종합하면 다음과 같은 반론이 제기된다:

    단기 과잉 반응 근거:

    • TurboQuant는 KV 캐시 압축만을 다루며, 모델 가중치 저장에는 전혀 영향이 없다 (70B 모델의 가중치는 FP16 기준 140GB로 변화 없음)
    • 훈련용 메모리 수요(그라디언트, 최적화 상태, 활성화 값)는 추론용 KV 캐시보다 훨씬 크며, TurboQuant와 무관하다
    • KV 캐시 압축이 가능해지면 모델 사업자들은 같은 하드웨어로 더 긴 컨텍스트를 제공하게 되어, 절약된 메모리가 더 큰 서비스로 흡수될 수 있다
    • Goldman Sachs는 2026년 DRAM 공급 4.9% 부족을 전망하며, 구조적 수요 우위는 변하지 않았다
    • Quilter Cheviot의 기술 연구 책임자 벤 배링거는 “TurboQuant 혁신이 압박을 가하고 있으나, 이는 진화적이지 혁명적이지 않다. 업계의 장기 수요 그림을 바꾸지는 않는다”고 평가했다

    장기 구조 변화 근거:

    • 효율화 기술이 메모리 하드웨어를 대체하는 역사적 전례가 없다 (SSD가 HDD를 대체했지만, 스토리지 수요는 오히려 증가)
    • ‘Jevons Paradox’: 효율화는 비용을 낮추어 사용을 더욱 촉진한다. AI 비용이 내려가면 더 많은 기업과 개인이 AI를 사용하고, 총 메모리 수요는 오히려 증가할 수 있다
    • 메모리 공급 증설에는 수년이 걸리며, 현재도 HBM 공급은 수요를 따라가지 못하고 있다

    11-2. 투자 관점에서 주목해야 할 기업들


    ① NVIDIA (NVDA) — 핵심 수혜자

    메모리 효율화의 역설은, NVIDIA에게 이것이 실질적으로 이득이라는 점이다. 첫째, Blackwell 아키텍처는 FP4를 중심으로 설계되어 있어 TurboQuant, TriAttention과 같은 저정밀도 기법의 하드웨어 파트너다. 둘째, NVIDIA는 TensorRT-LLM, vLLM, KVPress 등 메모리 효율화 소프트웨어 스택의 핵심 기여자다. 셋째, TriAttention 논문의 공동 저자 중 NVIDIA 연구진이 포함되어 있다. 메모리 효율화 연구를 직접 주도하는 위치에 있다.

    투자 관점: 단기 조정 시 매수 기회. Blackwell 세대 수요와 AI 추론 시장 성장이 핵심 모멘텀.


    ② SK 하이닉스 (000660.KS) — 단기 충격, 장기 기회

    SK 하이닉스는 TurboQuant 충격으로 가장 큰 하락을 보였지만, 한국 시장의 HBM 독점적 지위는 훼손되지 않았다. HBM4 로드맵과 NVIDIA와의 독점적 공급 관계가 유지되는 한, 알고리즘 효율화가 즉각적인 수요 타격으로 이어지기 어렵다.

    더 중요한 것은, AI가 더 효율적이 될수록 더 많은 기업이 AI를 채택하고, 데이터센터 투자는 오히려 증가하는 ‘Jevons Paradox’가 작동할 가능성이 높다. Micron의 CEO도 인정했듯 메모리는 AI 시대의 ‘전략적 자산’이다.

    투자 관점: TurboQuant 충격에 따른 -6% 조정은 중장기 관점에서 매수 기회 가능성. HBM 수급 상황을 지속 모니터링.


    ③ Micron (MU) — 리스크와 기회의 공존

    Micron은 SK 하이닉스, 삼성과 달리 HBM 시장에서의 입지가 상대적으로 약하고, TurboQuant 발표 이후 -7%에서 한 달간 -17% 수준의 가장 큰 낙폭을 기록했다. 2026 회계연도 설비투자 $250억 이상의 공격적 계획이 수요 전망 변화 시 재무적 압박으로 작용할 수 있다.

    반면, Micron이 HBM3E를 NVIDIA Blackwell에 공급하는 데 성공했고, 분기 매출 $335억 돌파 등 실적은 여전히 강하다. 주가 조정이 과도하다는 분석도 많다.

    투자 관점: 고위험·고보상 포지션. HBM 공급 다변화 시나리오에서 수혜 가능. 설비투자 계획 대비 수요 확인 필요.


    ④ Alphabet (GOOGL) — 소프트웨어 효율화의 최대 수혜자

    TurboQuant는 Google의 직접적인 경쟁 우위를 강화한다. 기술을 발표한 당일 주가가 상승한 것이 이를 반영한다. Google은 Gemini 모델에 컨텍스트 캐싱과 TurboQuant를 통합함으로써, 동일한 인프라로 더 많은 서비스를 제공하거나 클라우드 AI 서비스 마진을 크게 개선할 수 있다.

    또한 TurboQuant의 공개 발표는 Google Cloud의 AI 인프라 경쟁력을 마케팅하는 효과도 있다. Azure, AWS 대비 차별화 포인트로 활용될 수 있다.

    투자 관점: 메모리 효율화 소프트웨어 혁신의 직접 수혜. 클라우드 AI 서비스 마진 개선 기대. 중장기 긍정 전망.


    ⑤ Apple (AAPL) — 온디바이스 AI의 최대 수혜자

    TurboQuant, TriAttention 같은 기술이 온디바이스 AI를 현실화한다면, 가장 큰 수혜자는 다름 아닌 Apple이다. iPhone, MacBook의 제한된 메모리에서 더 강력한 AI를 구동할 수 있게 되면, AI 기능이 기기 교체의 핵심 동기가 된다. TriAttention의 Apple Silicon M-시리즈 지원이 이미 커뮤니티 수준에서 구현된 것은 이 방향의 신호다.

    투자 관점: 온디바이스 AI 사이클의 트리거가 되는 메모리 효율화 기술 진전에 가장 간접적이지만 크게 수혜. 차기 iPhone 사이클 점검 시 AI 기능 강화 여부 주목.


    ⑥ DeepSeek (비상장) 관련 — 간접 투자 주목 기업들

    DeepSeek 자체는 현재 비상장이나, MLA 기술의 확산이 만들어내는 수혜를 볼 수 있는 상장 기업들이 있다. MLA를 자사 모델에 채택하거나 MLA 기반 인프라를 제공하는 클라우드·AI 기업들이 대상이다. 중국 AI 에코시스템의 확장을 우회적으로 포착하는 전략으로서, 관련 ETF(예: KWEB, CQQQ)도 대안이 될 수 있다.


    12-1. 투자 관점 핵심 뉴스 타임라인

    2026년 3월 24일 — Google TurboQuant 논문 arXiv 공개. ICLR 2026 채택 발표.

    2026년 3월 25~26일 — 메모리 반도체 주 급락. SK 하이닉스 -6.2%, 삼성 -4.7%, Micron -7%.

    2026년 4월 초 — TurboQuant 충격 ‘과도 반응’ 분석 잇따라 등장. NVIDIA가 수혜라는 반론 부상.

    2026년 4월 11일 — TriAttention 논문(MIT·NVIDIA·절강대) 공개. 10.7배 KV 감소, RTX 4090에서 32B 모델 구동.

    2026년 4월 이후 — TurboQuant + TriAttention 커뮤니티 구현 통합. AMD ROCm, Apple Silicon 포팅 완료.

    지속 주목 포인트:

    • NVIDIA Blackwell B200 양산 및 FP4 소프트웨어 스택 완성도
    • Google Gemini API의 TurboQuant 공식 통합 여부
    • Micron·SK 하이닉스 2026 하반기 주문 동향 (알고리즘 효율화의 실제 수요 영향 확인)
    • 온디바이스 AI를 위한 모바일 AP(Qualcomm Snapdragon, Apple M-시리즈)의 메모리 효율화 기술 채택 가속도

    13. 엔지니어를 위한 기술 스택 가이드

    현재 LLM 메모리 효율화를 실제로 적용하려는 엔지니어라면 다음 기술 스택을 참고하길 권장한다.

    추론 프레임워크

    • vLLM: PagedAttention과 각종 KV 압축 기법의 통합이 가장 빠르게 이루어지는 오픈소스 프레임워크. TurboQuant, TriAttention 지원이 진행 중.
    • SGLang: TriAttention 백엔드를 지원하며, 구조화된 LLM 출력과 복잡한 추론 파이프라인에 적합.
    • llama.cpp: 저사양 하드웨어 중심. AMD ROCm용 TriAttention 포트가 커뮤니티에서 완성됨.

    핵심 논문 읽기 순서

    1. DeepSeek-V2 논문 (MLA 원본) — KV 압축의 아키텍처 접근
    2. TurboQuant 논문 (arXiv 2504.19874, ICLR 2026) — 양자화 압축의 최신
    3. TriAttention 논문 (arXiv 2604.04921) — 토큰 프루닝의 최신
    4. MHA2MLA 논문 (arXiv 2502.14837) — 기존 모델에 MLA 적용

    개발 시 주의사항

    • TurboQuant는 head_dim=64 모델에서 WHT 수렴 이슈가 있어, 해당 경우 K 캐시에 자동으로 q8_0 폴백이 필요함
    • TriAttention은 pre-RoPE 벡터 집약도가 낮은 헤드(<0.95 MRL)에서는 정확도 저하 위험이 있으므로 헤드별 선택적 적용 필요
    • MLA와 TurboQuant를 결합할 때 압축 후 잠재 벡터의 복원 단계에서 양자화 오차가 누적될 수 있어 품질 평가 필수

    14. 결론: 메모리 효율화는 AI 민주화의 진짜 열쇠

    우리는 지금 AI 인프라 역사에서 중요한 변곡점을 지나고 있다.

    GPU 연산 능력의 발전이 AI의 ‘지능 한계’를 밀어붙였다면, 메모리 효율화 기술의 혁신은 AI의 ‘접근 가능성의 한계’를 밀어붙이고 있다. DeepSeek MLA, Google TurboQuant, MIT×NVIDIA TriAttention, Blackwell FP4가 만들어내는 합산 효과는 단순한 비용 절감을 넘어 다음 세 가지 근본적 변화를 가능하게 한다.

    첫째, AI 민주화의 가속. 32B 파라미터 모델을 단일 RTX 4090에서 구동할 수 있다는 것은, 수천만 원의 서버 없이도 개인 개발자가 최전선 모델을 로컬에서 실험할 수 있음을 의미한다. 이는 AI 혁신의 참여자 범위를 극적으로 확대한다.

    둘째, 진정한 온디바이스 AI. 스마트폰과 노트북에서의 로컬 AI는 단순한 소형 모델의 배포가 아니라, 실질적인 능력을 가진 모델의 프라이버시 보장 로컬 구동을 의미한다. 메모리 효율화 없이 이 미래는 요원하다.

    셋째, AI 서비스의 경제 재편. 메모리 비용이 서비스 단가에서 차지하는 비중이 줄어들면, AI 서비스의 진입 장벽이 낮아지고 더 많은 스타트업이 경쟁 가능한 AI 서비스를 구축할 수 있다. 이는 클라우드 AI의 독과점 구조에도 변화를 가져올 수 있다.

    투자자 관점에서 보면, 이 기술 파도는 단순한 메모리 반도체 수요 감소 스토리가 아니다. 오히려 효율화→비용 하락→수요 확대→인프라 투자 증가의 선순환 사이클을 만들어내는 AI 성장의 다음 장이다. NVIDIA Blackwell, 저정밀도 연산 기반 소프트웨어 스택의 수혜, 그리고 온디바이스 AI 사이클을 주목하라.

    메모리 효율화 전쟁은 이제 막 시작되었다. 그리고 그 전쟁의 승자는 AI를 더 많은 사람이 더 저렴하게 사용할 수 있게 만드는 쪽이다. 기술적으로도, 투자적으로도, 그 방향에 주목해야 할 때다.


    이 글은 2026년 5월 기준 공개된 연구 논문, 기술 발표, 시장 분석을 바탕으로 작성되었습니다. 투자 관련 내용은 참고용이며, 실제 투자 결정은 전문 금융 자문가와 상의하시기 바랍니다.


    참고 자료

    • [2026.05.02경제리포트]2026년 APPLE의 사업 전략과 AI 혁신: 하드웨어 중심의 미래와 새로운 제품 라인업
    • DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model (DeepSeek-AI, 2024)
    • TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate (Google Research, ICLR 2026, arXiv:2504.19874)
    • TriAttention: Efficient Long Reasoning with Trigonometric KV Compression (MIT·NVIDIA·Zhejiang, 2026, arXiv:2604.04921)
    • Hardware-Centric Analysis of DeepSeek’s Multi-Head Latent Attention (KU Leuven, arXiv:2506.02523)
    • TransMLA: Multi-Head Latent Attention Is All You Need (arXiv:2502.07864)
    • Towards Economical Inference: Enabling DeepSeek’s MLA in Any Transformer-based LLMs (arXiv:2502.14837)
    • NVIDIA Blackwell Architecture Technical Brief (NVIDIA, 2025)

    참고 기사

    https://n.news.naver.com/mnews/article/015/0005287115

  • [2026.05.14]6G와 AI 고속도로 — 대한민국이 설계하는 다음 시대의 인프라

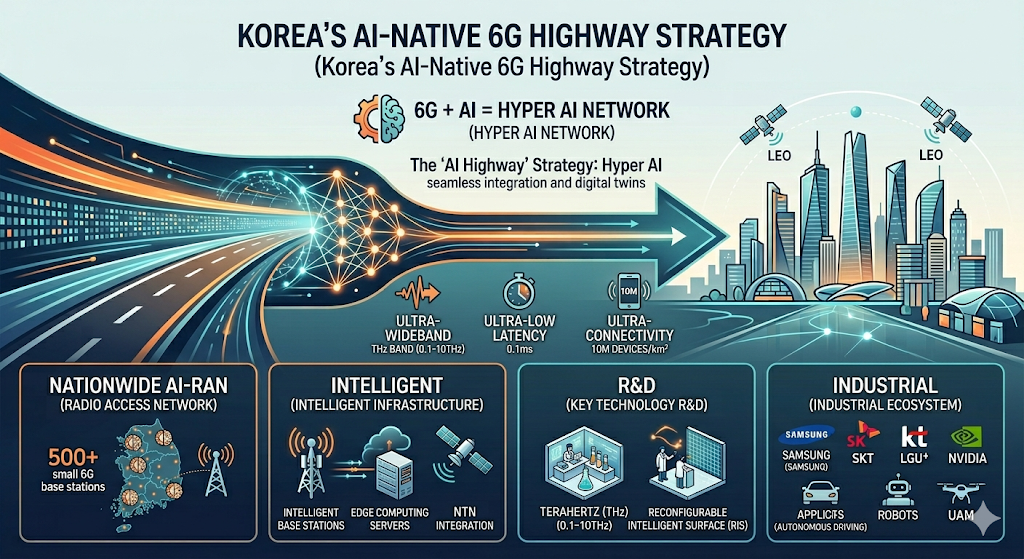
    [인포그래픽 대체 텍스트: 대한민국 AI-Native 6G 고속도로 전략]
1. 메인 타이틀 및 개요

중앙 타이틀: 대한민국 AI-Native 6G 고속도로 전략 (Korea's AI-Native 6G Highway Strategy)

핵심 공식: 6G + AI = Hyper AI 네트워크 (Hyper AI Network)

배경 이미지: 왼쪽에서 오른쪽으로 뻗어 나가는 거대한 빛의 화살표가 데이터 고속도로를 형상화하며, 미래 지향적인 스마트 시티와 연결됨.

2. 6G 핵심 기술 지표 (중앙 화살표 하단)

초광대역 (Ultra-Wideband): 테라헤르츠(THz) 대역 활용

초저지연 (Ultra-Low Latency): 0.1ms 지연 시간 달성

초연결 (Ultra-Connectivity): 1㎢당 1,000만 기기 연결 가능

3. 하단 4대 핵심 전략 영역

영역 1: AI-RAN 전국망 (Nationwide AI-RAN)

내용: 2030년까지 전국 산업 및 서비스 거점에 500개 이상의 지능형 기지국(Small 6G Base Stations) 구축 목표

시각 요소: 대한민국 지도 위에 기지국 포인트가 활성화된 그래픽.

영역 2: 지능형 인프라 (Intelligent Infrastructure)

내용: 지능형 기지국, 엣지 컴퓨팅 서버, 그리고 저궤도 위성을 통합한 비지상 네트워크(NTN Integration) 구축

시각 요소: 기지국, 서버 타워, 인공위성 아이콘.

영역 3: 핵심 기술 R&D (Key Technology R&D)

내용: 0.1~10THz 대역의 '테라헤르츠(THz)' 원천 기술과 전파 거울 역할을 하는 '지능형 반사 표면(RIS)' 연구 개발

시각 요소: 연구실에서 실험 중인 연구원과 THz 파형 그래픽.

영역 4: 산업 생태계 (Industrial Ecosystem)

참여 주요 기업: 삼성전자(Samsung), SKT, KT, LGU+, 엔비디아(NVIDIA) 등 글로벌 파트너십 강조

핵심 응용 분야: 완전 자율주행(Autonomous Driving), 지능형 로봇(Robots), 도심 항공 모빌리티(UAM)

시각 요소: 자율주행차, 협동 로봇, 드론 형태의 UAM 기체 아이콘.

4. 하단 주석

대한민국이 설계하는 다음 시대의 인프라로서, AI 추론 엔진과 테라비트급 무선 통신의 결합을 상징함.

    목차

    1. 6G란 무엇인가 — 기술 원리 완전 해설
    2. 세대별 이동통신 비교 — 1G부터 6G까지
    3. 글로벌 6G 표준화 경쟁의 현주소 (2026년 기준)
    4. 6G와 글로벌 AI 산업의 연결고리
    5. 한국 정부의 ‘AI 고속도로’ 정책 — Hyper AI 네트워크 전략
    6. AI-RAN — 기지국이 AI 서버가 되는 세상
    7. 관련 기업별 기술 진행 상황 심층 분석
    8. 투자 소견 — 어디에 눈을 두어야 하는가
    9. 리스크 요인 점검
    10. 결론 — ‘제2의 CDMA 신화’는 가능한가

    01

    6G란 무엇인가 — 기술 원리 완전 해설

    ‘6G’라는 단어는 마케팅 문구처럼 들리기 쉽다. 그러나 실제로는 이동통신 역사상 가장 근본적인 패러다임 전환을 내포한다. 5G가 단순히 4G보다 빠른 파이프였다면, 6G는 파이프 자체를 지능화하는 첫 세대이기 때문이다. 정확히 이해하려면 몇 가지 핵심 기술 개념을 짚어야 한다.

    테라헤르츠(THz) 주파수 대역

    5G가 주로 사용하는 밀리미터파(mmWave)는 30~300GHz 대역이다. 6G는 여기서 한 단계 더 나아가 0.1~10THz(테라헤르츠)라는 전례 없는 고주파 대역을 활용한다. 이 대역에서는 이론상 초당 1테라비트(Tbps)에 달하는 데이터 전송이 가능하다. 5G 최고 속도인 20Gbps와 비교하면 최대 50배, 현실 환경에서 우리가 체감하는 평균 5G 속도(수백 Mbps)와 비교하면 수천 배 빠른 셈이다.

    그러나 THz 대역에는 치명적 약점이 있다. 전파 직진성이 극도로 강하고 대기 중 수증기나 산소에 쉽게 흡수된다. 비가 오거나 건물 모서리 하나에도 신호가 차단될 수 있다. 이 문제를 해결하기 위해 6G는 두 가지 기술을 결합한다. 첫째는 거대 다중 안테나(Extremely Large Antenna Array, ELAA)로, 수백 개에서 수천 개의 안테나를 배열해 빔을 정밀하게 제어하는 것이다. 둘째는 재구성 가능 지능형 표면(Reconfigurable Intelligent Surface, RIS)이다. 벽이나 천장에 수동 반사판을 설치해 전파를 원하는 방향으로 꺾어주는 방식으로, 일종의 ‘전파 거울’이라 이해하면 쉽다.

    AI 네이티브 네트워크(AI-Native Network)

    6G가 이전 세대와 결정적으로 다른 점은 AI를 외부 서비스가 아닌 네트워크 자체의 운영 원리로 삼는다는 것이다. 5G에서 AI는 네트워크 최적화에 선택적으로 사용되었다. 6G에서는 AI가 기지국 스케줄링, 채널 추정, 빔포밍 제어, 트래픽 예측, 보안 탐지까지 실시간으로 처리하는 ‘두뇌’가 된다. 이를 가리켜 업계는 “AI-native”라고 부른다. 별도로 AI를 얹는 것이 아니라, 6G는 태어날 때부터 AI와 하나인 통신 체계라는 의미다.

    통신-컴퓨팅-감지(Integrated Sensing, Communication and Computing, ISCC)

    6G는 통신망이 동시에 레이더 역할도 수행하는 ‘통합 감지’를 표준 기능으로 포함한다. 6G 기지국은 단말기에 데이터를 전달하면서 동시에 주변 환경을 3D로 매핑하고 이동하는 물체를 센티미터 단위로 추적할 수 있다. 이는 자율주행, 드론 관제, 산업 현장 안전 관리에서 혁명적 가능성을 열어준다. 별도의 라이다(LiDAR)나 레이더 센서 없이도 통신 인프라 하나로 환경을 인식하는 세상이 가능해진다는 뜻이다.

    초저지연 — 0.1밀리초의 세계

    5G의 목표 지연시간은 1밀리초(ms)였다. 6G는 이를 0.1ms, 즉 100마이크로초로 낮춘다. 숫자는 단순해 보이지만 의미는 엄청나다. 현재 외과 수술 로봇이나 공장 자동화 라인에서는 1ms조차 길다. 의사가 원격으로 로봇 팔을 조종할 때 0.1ms 지연은 실질적인 실시간 반응성을 의미한다. AI가 사물을 인식하고 판단을 내리고 액추에이터를 제어하는 전 과정이 인간의 신경 반응보다 빨라지는 것이다.

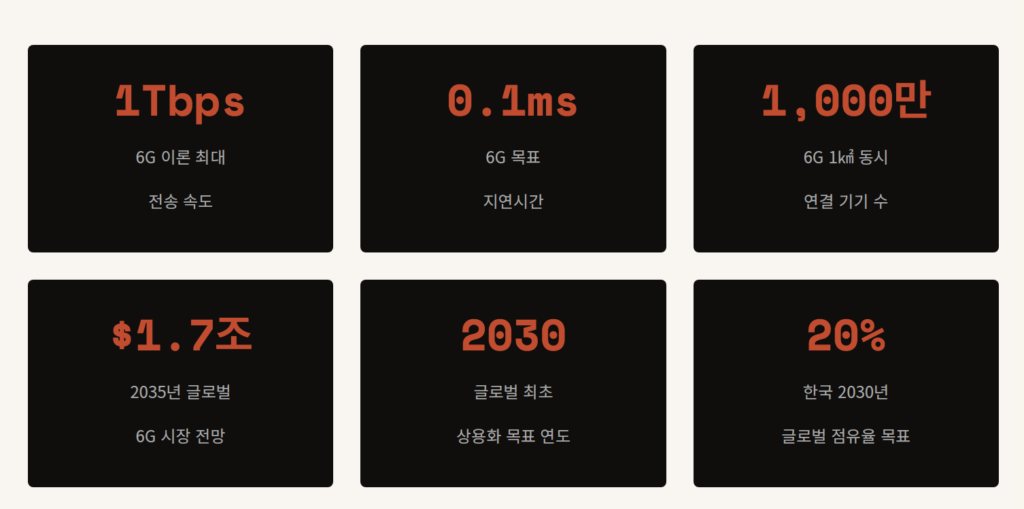
    기술 핵심 요약

    주파수: 서브6GHz + 밀리미터파 + 테라헤르츠(THz) 대역 동시 활용

    전송 속도: 최대 1Tbps (이론치), 평균 체감 속도 5G 대비 10~50배 향상 목표

    지연시간: 0.1ms (5G 목표치 1ms의 10분의 1)

    연결 밀도: 1㎢당 최대 1,000만 기기 동시 연결 (5G의 10배)

    에너지 효율: 5G 대비 데이터 1비트당 전력 소모 100분의 1 목표

    차별점: AI 네이티브 설계 + 통합 감지(ISCC) + 위성·지상 통합 네트워크

    02

    세대별 이동통신 비교 — 1G부터 6G까지

    6G를 제대로 이해하려면 이동통신이 어떻게 진화해왔는지 맥락이 필요하다. 각 세대는 단순히 속도 숫자를 올린 것이 아니라, 사회·경제적 패러다임 자체를 바꾸었다.

    세대핵심 기술최고 속도사회적 변화한국 상용화
    1G아날로그 음성2.4kbps모바일 음성통화 시작1984년
    2GCDMA / GSM
    한국 CDMA 세계 최초
    384kbpsSMS 문자, 디지털 음성1996년
    3GWCDMA / HSDPA14.4Mbps모바일 인터넷, 스마트폰 전야2002년
    4GLTE / LTE-A1Gbps영상 스트리밍, SNS, 앱 경제2011년
    5GNR / mmWave
    한국 세계 최초 상용화
    20GbpsIoT, 스마트팩토리, 자율주행 실험2019년
    6GTHz, AI-Native, ISCC, RIS1Tbps (목표)피지컬 AI, 실시간 디지털 트윈, 완전 자율화2030년 (목표)

    한 가지 주목할 역사적 사실이 있다. 2G CDMA 세계 최초 상용화(1996년)와 5G 세계 최초 상용화(2019년)는 모두 대한민국이 이루었다. 정부와 기업이 ‘제2의 CDMA 신화’라는 표현을 쓸 때, 이는 단순한 구호가 아니다. 실제 트랙 레코드를 가진 자부심에 근거한 것이다.

    “AI 없는 6G는 불가능하다. 이동통신은 이제 단순한 연결을 넘어 AI와 결합해야 하며, 통신망 자체가 지능화되는 시대가 왔다.”
    — 류탁기 SK텔레콤 인프라기술본부 부사장, 2025 서울미래컨퍼런스

    03

    글로벌 6G 표준화 경쟁의 현주소 (2026년 기준)

    현재 전 세계 6G 경쟁은 ‘표준 선점’을 중심으로 전개되고 있다. 기술 우위 못지않게 국제표준화기구(ITU, 3GPP)에서 자국의 기술을 표준으로 채택시키는 것이 장기적 산업 패권과 직결된다. 5G에서 화웨이가 핵심 특허를 대거 확보하며 시장을 장악하려 했던 전략을 기억한다면 6G 표준 경쟁의 지정학적 의미를 이해할 수 있다.

    ITU와 3GPP의 공식 로드맵

    ITU(국제전기통신연합)는 6G를 공식적으로 ‘IMT-2030’으로 명명했다. 2023년 ITU 전파통신총회(RA-23)에서 IMT-2030의 기본 원칙을 확정했고, 2024~2026년은 기술 성능 요구사항 정의 시기다. 2027년부터는 기업과 국가 연구기관들이 구체적인 기술 제안서를 ITU에 제출하기 시작하며, 2029년까지 최종 기술 선정이 이루어진다.

    3GPP(이동통신 국제표준 단체) 측에서는 2025년 중반 6G 기술 개발을 본격 시작하는 21개월짜리 스터디 아이템이 가동되었다. 에릭슨은 6G 명세서가 2028년 말까지 준비될 것으로 전망하며, 상용 서비스는 2030년을 전후해 단계적으로 개시될 것으로 본다.

    2023~2024ITU IMT-2030 프레임워크 확정 / 3GPP Release 19에서 6G 서비스 요구사항 연구 시작

    2025 Q33GPP 6G 기술 개발 21개월 스터디 아이템 공식 개시 / 한국 인천에서 3GPP 6G 워크숍 개최

    2026 Q23GPP Release 21 작업 기간 결정 / ITU 기술 성능 요구사항 확정 목표

    2026한국 ‘(가칭) Pre-6G Vision Fest’ 기술 시연 / 5G SA 전면 전환 목표

    2027~20283GPP Release 21 첫 6G 명세서 확정 목표 / ITU 기술 제안 접수 시작

    2028LA 올림픽 연계 6G 시범 서비스 (한국 목표) / ITU IMT-2030 최종 기술 선정

    2030글로벌 6G 상용 서비스 개시 목표 / 한국 AI-RAN 500개 이상 구축 목표

    국가별 경쟁 구도

    미국은 연방통신위원회(FCC) 산하 6G 워킹그룹을 통해 2025년 포괄적인 6G 전략 보고서를 발표했으며, AI 기반 네트워크와 스펙트럼 혁신에 집중하고 있다. 삼성, 퀄컴, 인텔, AT&T, 버라이즌이 핵심 기업으로 참여한다.

    중국은 IMT-2030 추진 그룹을 통해 가장 공격적인 행보를 보인다. 화웨이, 에릭슨, ZTE의 핵심 연구자들이 특허 선점 전략을 구사하고 있으며, 자국 내 6G 시험망 구축도 앞서 있다. 유럽은 Hexa-X 프로젝트를 통해 에릭슨, 노키아, 보다폰 등이 연합 연구를 진행 중이다.

    주목해야 할 것은 주파수 확보를 둘러싼 지역별 분기다. WRC-27(세계전파통신회의)에서 6G 주파수 할당을 논의하고 있는데, 미국·유럽·아시아가 선호 대역을 달리하며 지역별 6G 규격이 분열될 가능성이 제기되고 있다. 5G까지 유지했던 ‘단일 글로벌 표준’ 전통이 6G에서는 흔들릴 수 있다는 우려다. 이 변수는 장비 및 단말 제조사의 전략적 복잡성을 크게 높인다.

    04

    6G와 글로벌 AI 산업의 연결고리

    왜 지금 이 시점에 6G가 긴급한 의제가 되었는가? 단순히 ‘더 빠른 통신’을 위해서가 아니다. 글로벌 AI 산업의 팽창이 기존 네트워크 인프라의 물리적 한계를 두드리기 시작했기 때문이다.

    AI 추론의 폭발적 데이터 수요

    대형언어모델(LLM)과 멀티모달 AI가 스마트폰과 산업 기기에 탑재되면서 엣지에서 클라우드로 오가는 데이터 트래픽이 기하급수적으로 늘고 있다. GPT-4 수준의 모델이 초당 수천 토큰을 처리하려면, 기기와 서버 간 통신이 사실상 제로 레이턴시에 가까워야 한다. 현재 5G의 현실 지연시간(20~50ms)은 실시간 AI 에이전트가 물리적 세계와 상호작용하기에는 여전히 너무 길다.

    피지컬 AI(Physical AI)의 등장

    엔비디아가 ‘Physical AI’라는 개념을 전면에 내세운 것이 상징적이다. 로봇, 자율주행차, 산업용 드론, 스마트팩토리의 AMR(자율이동로봇) 등 AI가 실제 물리적 공간에서 작동하는 기기들이 폭발적으로 증가하고 있다. 이 기기들은 끊임없이 센서 데이터를 수집하고, 클라우드 또는 엣지 AI와 실시간으로 통신하며, 판단 결과를 밀리초 단위로 구현해야 한다. 5G도 이를 일부 지원하지만, 기기 밀도가 높아지면 현재 5G는 병목현상을 일으킨다. 6G는 이 병목을 제거하기 위해 설계된다.

    AI 데이터센터와 네트워크 인프라의 결합

    엔비디아의 GPU를 중심으로 한 AI 데이터센터 붐은 네트워크 인프라와 불가분하게 연결된다. AI 클러스터 내에서 GPU 수천 개를 연결하는 고속 인터커넥트(InfiniBand, NVLink) 수요가 급증했고, 이 클러스터를 외부 세계와 연결하는 프론트홀·백홀 네트워크에서도 100G~400G 이더넷이 표준이 되고 있다. 6G 시대에는 무선 네트워크와 유선 데이터센터 인프라가 사실상 하나의 연속적인 ‘지능 파이프라인’을 형성할 것이다.

    디지털 트윈과 공간 컴퓨팅

    애플 Vision Pro가 불붙인 공간 컴퓨팅 시장과, 엔비디아 Omniverse가 이끄는 산업용 디지털 트윈 시장 모두 6G급 네트워크 없이는 완성될 수 없다. 공장 전체를 실시간으로 디지털화하거나, 도시 전체의 교통 흐름을 밀리초 단위로 모델링하려면 수억 개의 센서가 실시간으로 데이터를 올려보내야 한다. 이것이 6G의 ‘통합 감지(ISCC)’ 기능이 중요한 이유다.

    AI × 6G 핵심 시너지 분야

    자율주행 / 로보틱스: 차량·로봇과 인프라 간 초저지연 통신. 0.1ms 이내의 판단-제어 루프 실현

    스마트 팩토리: 수만 개 센서·로봇의 동시 연결. AI 기반 예지보전(Predictive Maintenance) 고도화

    의료·원격 수술: 5G에서도 시도됐으나 0.1ms 지연에서야 실용적 원격 수술이 가능

    메타버스 / XR: 몰입형 실시간 홀로그램, 8K·360도 영상의 무선 전송

    스마트시티: 교통·에너지·안전을 통합 감지하고 AI가 즉각 최적화

    국방·우주: 위성-지상 통합 통신망, 드론 군집 제어, 전자전

    05

    한국 정부의 ‘AI 고속도로’ 정책 — Hyper AI 네트워크 전략

    이재명 대통령은 2025년 11월 국회 시정연설에서 이렇게 말했다. “박정희 대통령이 산업화의 고속도로를 깔고, 김대중 대통령이 정보화의 고속도로를 낸 것처럼, 이제는 AI 시대의 고속도로를 구축해 도약과 성장의 미래를 열어야 한다.” 이것이 ‘AI 고속도로’라는 개념의 정치적·역사적 맥락이다.

    이를 뒷받침하는 구체적 정책 문서가 2025년 12월 18일 과학기술정보통신부가 발표한 「Hyper AI 네트워크 전략」이다. 이 전략은 단순한 통신 정책이 아니다. AI G3(글로벌 3대 AI 강국) 달성이라는 국정 최우선 과제를 뒷받침하는 인프라 로드맵이다.

    전략의 두 가지 핵심 목표

    Hyper AI 네트워크 전략은 두 축으로 구성된다. 첫째는 인프라 목표다. 이동통신, 유선(광통신), 해저케이블, 저궤도 위성통신 등 국가 네트워크 전 영역을 2030년까지 세계 최고 수준으로 고도화한다는 것이다. 둘째는 산업 목표다. 2030년까지 글로벌 6G·AI 네트워크 시장 점유율 20%, 매출 5,000억 원 이상 글로벌 도약 기업 5개를 육성한다는 것이다.

    이동통신 — 2030년 6G 상용화 로드맵

    이동통신 부문의 핵심은 2030년 6G 상용화다. 과기정통부는 2024~2028년 총 3,700억 원을 투입해 6G 핵심 기술 개발을 진행한다. 단계는 세 단계로 나뉜다.

    1단계로, 현재 대부분의 이통사가 운용하는 비단독모드(NSA) 5G를 2026년까지 단독모드(SA)로 전면 전환한다. NSA는 5G 라디오를 쓰면서 코어 네트워크는 여전히 4G에 의존한다. SA로 가야 비로소 5G의 지능화 기반이 완성된다. 이것이 6G 전환의 전제 조건이다.

    2단계로, 2026년 ‘(가칭) Pre-6G Vision Fest’ 기술 시연 행사를 통해 6G 핵심 기술의 사회적 공론화와 산업 생태계 형성을 도모한다. 3단계로, 2028년 LA 올림픽을 글로벌 홍보 플랫폼으로 삼아 6G 시범 서비스를 제공하고, 2030년경 상용 서비스를 개시한다.

    AI-RAN — 500개 지능형 기지국 구축

    전략의 또 다른 핵심은 AI-RAN(AI 기반 무선접속망)이다. 2026년부터 기술 개발과 실증을 시작해, 2030년에는 전국 산업·서비스 거점에 AI-RAN 기지국 500개 이상을 구축한다는 목표다.

    유선망 고도화

    이동통신만이 아니다. 유선 인프라도 대폭 확충한다. 전국 주요 거점과 데이터센터를 연결하는 백본망 용량을 2030년까지 현재의 4배 이상으로 늘린다. 가정·기업에 연결되는 광케이블 보급률은 현재 약 80% 수준에서 2030년 98%까지 끌어올린다.

    해저케이블과 위성통신

    국제망 경쟁력 강화도 빠뜨릴 수 없다. 현재 110Tbps 수준인 해저케이블 용량을 2030년까지 220Tbps 이상으로 두 배 확대한다. 현재 동남권에 집중된 해저케이블 육양국(해저케이블이 육지로 올라오는 지점)을 서해·남해로 분산해 안정성을 높인다. 저궤도 위성통신(LEO)에는 2025~2030년 3,200억 원을 투입하는 대규모 예비타당성 사업을 추진한다.

    2026년 예산 — 2,900억 원 투자

    이 전략 이행을 위해 2026년 한 해 네트워크 기술 개발·실증·사업화에 2,900억 원을 투자한다. 이는 2025년 대비 450억 원 증가한 규모다. 교육·의료·제조·안전·미디어 등 5대 분야에서 대규모 AI 네트워크 선도 실증 사업도 2026년부터 본격 추진한다.

    Hyper AI 네트워크 전략 핵심 수치

    📡 2026년 네트워크 R&D 투자: 2,900억 원 (전년 대비 +450억)

    🏗 6G 핵심기술 개발 총 투자 (2024~2028): 3,700억 원

    🛰 저궤도 위성통신 예타 투자 (2025~2030): 3,200억 원

    📶 AI-RAN 2030년 구축 목표: 500개 이상

    🌐 해저케이블 용량 목표: 110Tbps → 220Tbps

    🎯 글로벌 시장 점유율 목표 (2030): 20%

    🏆 글로벌 도약 기업 육성 목표: 5개 (매출 5,000억↑)

    06

    AI-RAN — 기지국이 AI 서버가 되는 세상

    6G 정책에서 가장 자주 등장하면서도 가장 오해받는 개념이 AI-RAN이다. 이것이 무엇인지, 왜 중요한지를 명확히 이해하는 것이 기업 분석과 투자 판단의 출발점이다.

    RAN이란 무엇인가

    RAN(Radio Access Network, 무선접속망)은 스마트폰과 기지국 사이의 무선 구간이다. 여러분이 데이터를 쓸 때 신호가 먼저 도달하는 첫 번째 관문이 RAN이다. 5G에서도 가상화(vRAN)를 통해 기지국 기능을 소프트웨어로 구현하는 시도가 있었지만, AI와의 긴밀한 결합은 6G에서야 표준으로 자리잡는다.

    AI-RAN의 두 가지 역할

    AI-RAN은 이름 그대로 AI가 내장된 무선접속망이다. 기지국이 수집하는 실시간 트래픽 데이터를 AI가 분석해 채널 상태를 예측하고, 빔포밍 방향을 최적화하며, 개별 사용자에게 최적 네트워크 설정을 자동 적용한다. 기존 방식이 사전 정의된 규칙 기반이었다면, AI-RAN은 매 순간 학습하고 적응하는 방식이다.

    그런데 AI-RAN의 더 혁신적인 가능성은 두 번째 역할에 있다. AI-RAN 기지국은 통신 기능뿐 아니라 엣지 컴퓨팅 서버 역할을 동시에 수행한다. 즉, AI 추론 연산을 기지국 현장에서 처리할 수 있다는 뜻이다. 스마트폰이나 로봇의 AI 처리 요청이 먼 데이터센터까지 왕복하지 않고, 가장 가까운 기지국에서 바로 처리된다. 이것이 초저지연 엣지 AI의 핵심 인프라다.

    “AI-RAN은 온디바이스 AI의 전력·용량 한계와 클라우드 AI의 지연시간 한계를 동시에 보완해, 국가 AI 전환(AX) 확산의 현장 기반이 되도록 설계된다.”
    — 과학기술정보통신부, Hyper AI 네트워크 전략 (2025.12)

    AI-RAN 얼라이언스의 의미

    2025년 10월, KT가 주도하고 SK텔레콤, LG유플러스, 삼성전자, ETRI(한국전자통신연구원), 연세대, 엔비디아가 참여하는 ‘AI-RAN 기술 공동 연구 개발 및 글로벌 확산’ MOU가 체결됐다. 한국의 통신 3사가 경쟁사임에도 불구하고 공동으로 기술 개발에 나선 것은 이례적이다. AI-RAN 표준을 한국이 주도하겠다는 전략적 의도가 담겨 있다.

    엔비디아의 참여도 주목해야 한다. 엔비디아는 AI-RAN 서버에 들어가는 GPU를 공급하는 위치에 있다. 기지국이 곧 AI 서버가 되는 세상에서, 엔비디아의 역할은 데이터센터를 넘어 통신 인프라 전체로 확장된다.

    07

    관련 기업별 기술 진행 상황 심층 분석

    이론과 정책을 이해했다면 이제 실제 플레이어들을 분석할 차례다. 한국의 6G·AI 네트워크 생태계에서 핵심 기업 여섯 곳을 기술 진행 상황과 전략적 포지셔닝 관점에서 살펴본다.

    KRX: 005930

    삼성전자

    삼성전자는 6G 생태계에서 가장 넓은 스펙트럼을 커버하는 기업이다. 단말(스마트폰·웨어러블), 네트워크 장비(기지국·코어), 반도체(모뎀·메모리)를 모두 자체 생산할 수 있는 유일한 글로벌 기업이다.

    2025년 11월 SK텔레콤과 AI-RAN 기술 공동 개발 MOU를 체결, AI 기반 채널 추정 기술·분산형 MIMO 송수신 기술·AI-RAN 스케줄러 핵심 기술을 함께 연구 중이다. KT와도 공동 개발한 AI-RAN을 상용 5G망에서 검증 완료했다. 삼성리서치가 6G 핵심 원천기술 확보에 집중하고 있으며, 6G 관련 특허 출원에서도 글로벌 최상위권을 유지한다.

    📈 투자 관점: 핵심 수혜주 — 6G 장비 + AI 반도체 + 단말 삼중 모멘텀

    KRX: 017670

    SK텔레콤

    SKT는 6G와 AI를 동시에 가장 공격적으로 추진하는 통신사다. AI 에이전트 ‘에이닷(A.)’의 상용화, AI 데이터센터(AIDC) 구축, 6G 기술 공동 개발을 동시에 진행한다. 2025년 대규모 해킹 사고로 인한 과징금(1,348억 원)과 영업이익 급감이라는 쓴 약을 삼켰지만, 이는 6G·AI 장기 투자 스토리와는 분리해서 봐야 한다.

    2026년 5G SA 전환이 완료되면 AI 기반 서비스 수익화가 본격화될 것으로 전망된다. GPU Farm 구축, 엔비디아와의 협력 등 AI 인프라 선점 전략도 주목된다.

    🔭 투자 관점: 중장기 지켜보기 — 2025년 악재 소화 후 2026 AI 수익화 여부가 관건

    KRX: 030200

    KT

    KT는 AI-RAN 글로벌 허브 전략에서 가장 적극적인 행보를 보인다. 엔비디아·삼성전자·SKT·LGU+·ETRI·연세대와의 다자간 MOU를 주도했고, 아시아 최대 통신사 협의체인 SCFA를 통해 NTT도코모, 차이나모바일과도 협력을 강화하고 있다. AI-RAN 얼라이언스 워킹그룹에 연구 아이템을 제안하는 등 국제 표준화에도 발을 걸쳤다.

    2025년에는 부동산(NCP) 분양 이익, AI 전환(AX) 사업 성장, MIT 부문 호조로 통신 3사 중 가장 안정적인 실적을 기록했다.

    📈 투자 관점: 중장기 매수 — 통신 3사 중 재무 안정성 우위, AI-RAN 국제화 전략 차별화

    KRX: 032640

    LG유플러스

    LGU+는 상대적으로 규모는 작지만 기술 차별화 전략이 돋보인다. POSTECH 연구팀과 함께 무전력 분산형 RIS(재구성 가능 지능형 표면)와 AI를 결합한 실내 커버리지 확장 기술을 실증 완료했다. RIS는 6G에서 THz 전파의 약점을 극복하는 핵심 기술이다. 파주에 하이퍼스케일급 AI DC(데이터센터) 건립도 추진 중이다.

    MWC 2026에서는 양자내성암호(PQC)와 동형암호를 결합한 ‘익시가디언 2.0’ 보안 솔루션을 공개해 6G 시대 보안 인프라 전문성을 부각했다.

    🔭 투자 관점: 관심 유지 — RIS 기술 선점과 소형·중형 기업 대상 B2B AI 사업 성과에 주목

    KOSPI 상장

    삼성전기 / 파트론

    6G 단말과 기지국 안테나 소재·부품 분야에서 삼성전기(적층세라믹콘덴서·RF 모듈), 파트론(안테나 모듈) 등이 핵심 부품사로 부상하고 있다. 정부는 부품·소자 분야 국내 기업의 기술 사업화를 적극 지원하겠다고 명시했다. THz 대역에서는 기존 부품 소재로는 한계가 있어 신규 소재·공정 개발이 필요하고, 이 부분에서 국내 부품사들의 기회가 있다.

    🔭 투자 관점: 장기 관심 — 6G 표준 확정 후 실제 기지국 부품 발주 시 모멘텀 발생 예상

    KOSPI 상장

    케이엠더블유 / 에이스테크

    국내 중소형 통신장비 기업들이다. 케이엠더블유는 기지국 안테나·필터 제조에 특화돼 있고, 에이스테크는 위성통신 안테나 분야에서 경쟁력을 갖추고 있다. 저궤도 위성통신(3,200억 투자)과 6G 기지국 대규모 구축 계획에서 직접적인 수혜가 예상된다. 다만 글로벌 장비사 대비 규모가 작고, 단일 사업 의존도가 높다는 리스크를 함께 감안해야 한다.

    🔭 투자 관점: 테마 접근 — 위성통신 예타 사업 확정 등 구체적 발주 신호 확인 후 접근 권장

    해외 기업 — 한국 6G 생태계의 주요 파트너

    한국 기업 외에도 AI-RAN MOU 참여사인 엔비디아(NVDA)가 가장 중요하다. AI-RAN 기지국에 GPU가 들어간다면, 엔비디아의 시장은 데이터센터를 넘어 전 세계 수십만 개 기지국으로 확장된다. 이것은 엔비디아의 어드레서블 마켓(TAM)이 현재 추정치를 훨씬 초과할 수 있다는 뜻이다. 스웨덴의 에릭슨은 6G 명세서가 2028년 말까지 준비될 것이라는 가장 구체적인 일정을 제시한 곳으로, 한국 통신사와의 협력 관계도 깊다. 핀란드의 노키아는 오픈랜(O-RAN) 생태계에서 강점을 보이며, AI-RAN 구현의 소프트웨어 플랫폼 분야에서 경쟁 중이다.

    08

    투자 소견 — 어디에 눈을 두어야 하는가

    6G는 의심할 여지 없이 거대한 기회다. 그러나 투자는 ‘좋은 기술’과 ‘좋은 주식’이 다를 수 있다는 전제에서 시작해야 한다. 6G 상용화는 2030년이고, 표준 확정도 2027~2028년이다. 지금은 ‘씨앗을 뿌리는 시기’다. 단기 수익보다는 포트폴리오의 일부로 중장기 관점에서 접근하는 것이 합리적이다.

    투자 접근의 세 가지 레이어

    레이어 1 — 인프라 직접 수혜 (가장 확실한 수익 경로)

    정부 정책이 이미 예산을 배정했고, 실증 사업이 2026년부터 발주된다. 가장 직접적인 수혜는 기지국 장비·안테나 제조사, 광케이블 공급사, 해저케이블 관련 기업이다. 다만 국내에서 이 분야 순수 플레이 기업은 케이엠더블유, 에이스테크, 대한광통신 등으로 규모가 작다. 삼성전자의 네트워크 사업부는 이 레이어에서 가장 큰 수혜를 볼 수 있지만, 전체 삼성 사업에서의 비중이 작아 직접적인 주가 임팩트는 제한적이다.

    레이어 2 — AI × 네트워크 융합 (성장 가속이 예상되는 중기 기회)

    통신 3사(SKT·KT·LGU+)는 지금 5G 가입자 포화라는 성장 정체를 AI 서비스 수익화로 돌파하려 한다. 2026년 5G SA 전면 전환 후 AI 기반 B2B 서비스 매출이 가시화되면 밸류에이션이 재평가받을 가능성이 있다. 통신 3사 합산 영업이익은 2025년 악재 이후 2026년 5조원 대 회복이 예상된다. 배당 매력도 있어, 장기 투자자라면 KT를 중심으로 관심을 가질 만하다.

    엔비디아는 레이어 2에서 가장 강력한 포지션이다. AI-RAN의 핵심 부품인 GPU 공급자로서, 6G 시대에 통신 인프라 전반이 GPU 수요를 추가로 창출한다. 현재 주가가 높은 편이나, AI 컴퓨팅 수요의 구조적 성장을 믿는다면 비중 확대 고려 대상이다.

    레이어 3 — 6G 원천기술 / 소재·부품 (장기 고위험·고수익)

    THz 소자, RIS(재구성 가능 지능형 표면) 소재, 양자암호통신 장비 등은 6G가 상용화되면 신규 시장이 만들어지는 영역이다. 현재 대부분은 연구소 수준이거나 상장되어 있지 않다. 이 레이어는 벤처캐피털(VC) 방식 접근이 맞으며, 일반 주식 투자자에게는 특정 테마 ETF나 관련 상장 종목을 통한 간접 접근을 권한다.

    투자 체크리스트 — 6G 관련주 판단 기준

    ✅ 기술 진입장벽: 단순 조립이 아닌 원천 기술 또는 핵심 부품 보유 여부

    ✅ 정부 사업 참여 이력: 과기정통부·ETRI·통신사 공동 R&D 과제 참여 여부

    ✅ 글로벌 파트너십: 에릭슨·노키아·엔비디아 등과의 협력 관계

    ✅ 특허 포트폴리오: 6G 후보 기술 특허 수량 및 표준 필수 특허(SEP) 확보 추세

    ✅ 재무 건전성: 2030년 상용화까지 버틸 수 있는 현금 흐름과 부채 비율

    ⚠️ 주의: 단순히 ‘6G’ 키워드를 공시에 언급한 기업은 투자 근거 불충분

    09

    리스크 요인 점검

    6G 기회가 크다고 해서 리스크가 없는 것은 아니다. 오히려 대형 기술 전환기에는 예기치 못한 변수가 많다. 아래 주요 리스크를 직시해야 한다.

    높음

    표준 분열 리스크 미국·중국·유럽이 각기 다른 주파수 대역과 기술 방식을 선호할 경우 6G도 5G처럼 지역별로 규격이 달라질 수 있다. 이는 장비 제조사의 개발 비용을 급격히 높이고, 글로벌 시장 점유율 20% 목표를 흔들 수 있다.

    높음

    5G 투자 회수 부진 반복 리스크 글로벌 통신사들이 5G 투자를 수익화하는 데 예상보다 오랜 시간이 걸렸다. 같은 패턴이 6G에서 반복될 경우 투자 의지가 꺾일 수 있다. 정부 보조금과 수요 창출 정책의 실효성이 관건이다.

    높음

    지정학 리스크 — 공급망 분리 미중 기술 패권 경쟁이 심화되면서 6G 장비 공급망이 ‘서방 진영’과 ‘중국 진영’으로 분리될 수 있다. 한국 기업은 양 진영 사이에서 외교적·기술적 판단을 요구받을 수 있다.

    중간

    THz 기술 상용화 지연 테라헤르츠 대역 소자와 안테나 기술은 아직 실험실 수준이다. 2030년 상용화 목표를 맞추려면 소재·부품 기술의 양산화가 선행되어야 한다. 일정 지연 가능성을 배제할 수 없다.

    중간

    전력 소비 문제 6G 기지국과 AI-RAN 서버의 전력 소비는 5G 대비 현저히 높을 수 있다. 친환경 목표와 충돌하며 사회적 논란이나 규제 부담을 낳을 수 있다. 에너지 효율 목표(5G 대비 100분의 1)를 실제로 달성하려면 반도체 소자 기술의 혁신이 필요하다.

    낮음

    보안·프라이버시 리스크 6G의 통합 감지 기능은 도시 전체를 실시간으로 추적하는 능력을 갖춘다. 감시 남용, 개인정보 침해, 사이버 공격에 대한 사회적 우려가 규제를 강화할 수 있다. MWC 2026에서 통신 3사가 양자보안을 6G 핵심 기술로 제시한 것도 이 맥락이다.

    10

    결론 — ‘제2의 CDMA 신화’는 가능한가

    1996년 대한민국이 세계 최초로 CDMA 상용 서비스를 시작했을 때, 이는 당시 세계 최강이던 미국 퀄컴의 기술을 수입해 자국 생태계로 꽃피운 일이었다. 이후 삼성전자·LG전자가 세계 최고 수준의 CDMA 폰 제조사로 성장하고, SKT·KT가 글로벌 통신사 벤치마킹의 대상이 된 것은 그 씨앗에서 자란 결실이었다. 2019년 5G 세계 최초 상용화도 같은 결의 사건이었다.

    6G 시대에 ‘제2의 CDMA 신화’는 가능한가? 조건은 갖춰지고 있다. 세계 최고 수준의 반도체 기업(삼성전자, SK하이닉스), 검증된 통신 인프라(이통 3사), 정부의 명확한 정책 의지와 예산(Hyper AI 네트워크 전략), 글로벌 파트너십(엔비디아와의 AI-RAN 협력)이 맞물리고 있다. 2025년 3월, 국제표준화 단체 3GPP의 6G 핵심 워크숍이 인천에서 열렸다는 사실은 한국의 외교적 위상을 보여준다.

    그러나 CDMA 시대와 다른 점도 있다. 당시에는 기술 제공자(퀄컴)와 상용화 주체(한국)의 역할이 분명히 구분됐다. 6G 시대에는 AI가 통신망의 핵심 운영 원리이기 때문에, AI 기술 경쟁력이 곧 6G 경쟁력이다. 대형언어모델, AI 반도체, 클라우드 인프라에서 미국(오픈AI, 엔비디아, AWS)과 중국(화웨이, 바이두)에 비해 한국은 아직 격차가 있다. 이 AI 기초 역량의 확보가 6G 신화의 전제 조건이 될 것이다.

    결론적으로, 6G는 단순한 통신 기술의 진화가 아니다. AI 시대의 물리적 신경망을 누가 설계하고 공급하느냐의 싸움이다. 대한민국은 이 경쟁에서 출발점이 유리한 위치에 있다. 하지만 유리한 출발이 승리를 보장하지는 않는다. Hyper AI 네트워크 전략이 단순히 정부 문서로 남지 않고, 삼성전자·통신 3사·중소 부품사·연구기관이 유기적으로 연계된 산업 생태계로 구체화될 때, 비로소 ‘제2의 CDMA 신화’는 현실이 된다.

    네트워크가 지능을 갖는 시대. 그 지능의 설계도를 누가 쓰느냐가 향후 10년 IT 산업의 판도를 결정한다.

    우리가 지금 보고 있는 것은 기술 로드맵이 아니라, 국가 경쟁력의 청사진이다. 그리고 그 청사진의 중심에 6G라는 두 글자가 쓰여 있다.

    관련 기사

    https://www.news1.kr/local/daejeon-chungnam/6165604

    참고 자료

    과학기술정보통신부, 「Hyper AI 네트워크 전략」 (2025.12.18) · ITU-R, IMT-2030 Framework (2023) · 3GPP 6G 표준화 로드맵 (2025) · Ericsson 6G 백서 (2024) · FCC TAC 6G Working Group Report (2025) · SK텔레콤 뉴스룸, AI-RAN 공동 연구 협약 관련 보도 (2025.11) · KT, AI-RAN 얼라이언스 MOU 보도자료 (2025.11) · 대한민국 정책브리핑 (korea.kr) 다수 · 이데일리·머니투데이·데일리시큐 관련 기사 (2025~2026)

    ⚠️ 투자 유의사항: 이 글은 특정 투자를 권유하거나 투자 결과를 보장하는 문서가 아닙니다. 모든 투자 판단과 그에 따른 책임은 투자자 본인에게 있습니다. 6G 관련 시장 전망과 기업 분석은 공개된 정보와 필자의 분석적 견해를 바탕으로 작성되었으며, 실제 결과와 다를 수 있습니다. 투자 결정 전 반드시 전문 금융 투자 상담사와 상의하시기 바랍니다.

    문의 사항이 있으시면 해당 링크로 연락 부탁드립니다.

  • [2026.05.13]EMIB, SK하이닉스, 인텔과 HBM 패키지 공정 새로운 시도를 하다!

    본 인포그래픽은 인텔의 'Embedded Multi-Die Interconnect Bridge (EMIB)' 기술에 대한 내용을 담고 있습니다.

첫 번째 섹션은 EMIB 기술의 개요를 다루고 있으며, 그림과 함께 EMIB의 작동 원리와 장점을 설명합니다. EMIB는 칩을 연결하는 다이와 다이 사이에 작고 유연한 '브릿지'를 추가하여 칩의 면적을 최적화하고, 생산 비용을 절감하는 기술입니다.

두 번째 섹션은 EMIB와 TSMC의 CoWoS 기술을 비교하는 표를 보여줍니다. 표는 비용, 수율, 확장성 등 다양한 측면에서 EMIB의 우위성을 강조합니다.

세 번째 섹션은 EMIB 기술의 향후 개발 로드맵을 제시합니다. 인텔은 EMIB 기술을 지속적으로 발전시켜 칩의 연결 속도를 더욱 높이고, 생산성을 개선할 계획입니다.

마지막 섹션은 SK 하이닉스와 인텔의 EMIB 기반 HBM 패키징 협력 내용을 다루고 있습니다. SK 하이닉스는 인텔의 EMIB 기술을 활용하여 HBM의 용량과 성능을 높일 계획이며, 이는 AI 기술 발전에 기여할 것으로 기대됩니다.

이 인포그래픽은 EMIB 기술의 중요성과 향후 발전 가능성을 효과적으로 전달하고 있습니다.

    EMIB(Embedded Multi‑Die Interconnect Bridge)는 인텔이 자체 개발한 2.5D 패키징 기술로, 기존 TSMC의 CoWoS와 달리 실리콘 브릿지를 핵심 부품으로 활용해 비용·수율·규모 면에서 차별화된 장점을 제공한다. 최근 SK 하이닉스가 인텔과 EMIB 기반 HBM 패키징 협력을 추진한다는 발표가 나오면서, 양사 간 기술 교류와 공급망 다변화가 가속화되고 있다. 본 글에서는 EMIB의 원리, 인텔 및 SK 하이닉스의 최신 움직임, 시장 반응, 그리고 향후 전망을 쉽게 이해할 수 있도록 단계별로 정리한다.


    1️⃣ EMIB(Embedded Multi‑Die Interconnect Bridge)란?

    1.1 기본 개념

    EMIB는 “임베디드 멀티다이 인터커넥트 브릿지”의 약자로, 서로 다른 칩(다이)을 고속으로 연결하는 2.5D 패키징 방식이다. 전통적인 2.5D 패키지는 대형 실리콘 인터포저(중간 기판)를 사용해 다이들을 전기적으로 결합한다. 반면 EMIB는 필요한 연결 부위에만 실리콘 브릿지를 삽입하고, 나머지는 기존 PCB(프린트 회로 기판)와 동일하게 설계한다. 이는 “브릿지”라는 작은 실리콘 조각이 다이와 다이 사이, 혹은 다이와 PCB 사이에 가교 역할을 수행한다는 의미이다.

    • EMIB는 실리콘 브릿지와 실리콘 관통 비아(TSV)를 결합해 최소한의 면적에 고대역폭 연결을 구현한다.
    • 이러한 구조는 인터포저 전체를 사용하지 않으므로 비용이 수백 달러 수준으로 크게 낮아진다. (CoWoS는 약 900~1,000달러)

    1.2 핵심 기술 요소

    요소설명기대 효과
    실리콘 브릿지고정밀 실리콘으로 만든 작은 다리; 다이와 다이 사이를 연결전기 저항 감소, 고주파 신호 전송 개선
    관통 비아(TSV)실리콘 내부에 뚫린 미세 구멍을 통해 전기적 연결다이와 브릿지·브릿지와 PCB 사이의 신뢰성 높은 전송
    직사각형 기판기존 원형 웨이퍼 대신 직사각형 기판을 사용패키지 크기 낭비 최소화와 재료 사용량 절감
    다이 레이아웃 자유도브릿지 삽입 위치만 지정하면 되므로 다양한 배열 가능복합 GPU·HBM·AI 가속기 설계에 유연성 제공

    1.3 왜 2.5D인가?

    2.5D는 3D(칩을 수직으로 적층)와 2D(칩을 평면에 배치) 사이의 중간 형태이며, 다이 간 전송 거리와 지연을 최소화하면서도 제조 공정 복잡성은 크게 높이지 않는다. AI 가속기와 같은 고성능 시스템 반도체는 대규모 HBM(고대역폭 메모리) 스택과 결합이 필수이며, 이때 2.5D 패키징이 가장 효율적인 솔루션으로 자리 잡았다.


    2️⃣ 인텔의 EMIB 기술 발전 및 전략

    2.1 기술 연혁

    인텔은 2017년부터 서버·네트워크·고성능 컴퓨팅(HPC) 제품에 EMIB를 적용해 왔으며, EMIB‑T와 같은 차세대 변형을 지속적으로 선보이고 있다.

    • EMIB‑T: 기존 EMIB에 TVS(실리콘 관통 비아)와 고밀도 브릿지를 결합해 패키지 크기와 레티클 스케일을 확대한다. 2024년에는 6배 레티클, 2026년에는 8배, 2028년까지는 12배까지 지원 목표를 발표했다.

    2.2 인텔의 생산 인프라 확장

    인텔은 미국 오리건·베트남 공장에서 EMIB 생산 능력을 확대하고, 대형 장비 발주를 진행 중이다. 이는 TSMC CoWoS 병목을 타개하기 위한 전략적 움직임이며, 구글·메타 등 글로벌 고객 확보 기대를 높이고 있다.

    • 주요 장비 공급 업체: E&R 엔지니어링, C Sun Manufacturing, AblePrint Technology 등
    • 목표: 2026년 하반기부터 장비 납품 시작 및 대형 고객 확보

    2.3 시장 반응과 투자자 시각

    인텔은 2026년 5월 초부터 주가 급등을 경험했으며, 12% 상승 후 신고가 기록까지 이어졌다. 이는 EMIB 기술을 포함한 첨단 패키징 및 파운드리 경쟁력에 대한 기대감이 반영된 결과다.

    • 투자자 분석: “EMIB가 TSMC CoWoS와 차별화된 비용·수율을 제공해 파운드리 경쟁에 변화를 줄 것”

    3️⃣ EMIB와 TSMC CoWoS 비교

    항목EMIB (인텔)CoWoS (TSMC)
    구조실리콘 브릿지 + TSV, 인터포저 전체 사용 안 함대형 실리콘 인터포저(전체) 사용
    패키지 규모직사각형 기판 사용으로 낭비 영역 최소화원형 웨이퍼 기반, 규모가 커질수록 비효율 발생
    비용수백 달러 수준 (브릿지당)900~1,000달러 수준
    수율최신 보고서에선 90% 수준 도달 (EMIB‑T)고복잡도 패키지로 수율이 낮을 위험 (특히 대형)
    확장성브릿지 삽입 위치 자유, 크기·포맷 다양화 용이CoWoS‑L, CoWoS‑S 등 레티클 규모 확대 필요
    생산 지역미국·베트남 등 다변화된 생산 거점주로 대만에서 집중 생산
    고객 적용 사례현재 구글·메타·애플·테슬라 검토 단계엔비디아·구글·마이크로소프트 등 실서비스 적용

    요약: EMIB는 비용·수율·생산 유연성 면에서 강점을 가지며, 특히 미국 기반 제조라는 차별성을 통해 전략적 공급망 다변화에 기여한다. 이는 AI 반도체 수요 폭증 시 대체 옵션으로서 주목받는다.


    4️⃣ SK 하이닉스와 인텔의 EMIB 협력 현황

    4.1 협력 배경

    • AI 가속기용 HBM 수요 급증: GPU·AI 가속기와 결합되는 HBM(고대역폭 메모리)의 공급이 급증하고 있다. TSMC의 CoWoS 생산 병목 현상이 지속되면서, 다양한 패키징 옵션이 필요하게 되었다.
    • 공급망 다변화 전략: SK 하이닉스는 TSMC 의존도 감소와 자체 HBM 고도화를 위해 EMIB 기술을 조기 도입하려는 움직임을 보였다.

    4.2 구체적인 R&D 진행 상황

    • 초기 연구개발 단계: SK 하이닉스는 인텔 EMIB를 시제품 테스트하고 있으며, 소재·부품 후보도 물색하고 있다.
    • 파일럿 라인 가동: SK 하이닉스는 국내에 소규모 2.5D 패키징 라인을 이미 운영 중이며, 여기서 EMIB 호환 테스트를 진행한다.
    • 양산 적용 전 단계: 아직 양산 적용 단계는 아니지만, 수율·안정성 확보를 위해 다양한 소재·부품 검증이 진행 중이다.

    4.3 투자자 및 시장 반응

    • 주가 급등: SK 하이닉스는 2026년 5월 12일 프리마켓에서 5% 이상 상승하며 200만원선 돌파 근접 상황까지 올라갔다. 이는 HBM·EMIB 협력 기대감에 따른 매수세가 반영된 결과다.
    • 코스피와 반도체 랠리: 같은 시기에 코스피 지수는 7950선에서 출발해 8000포인트 돌파 기대감까지 커졌으며, SK 하이닉스는 3.14% 상승을 기록했다.
    • 인텔 주가 연동: SK 하이닉스와 인텔 협력 소식이 나오면서 인텔 주가도 12% 상승하며 신고가를 경신했다. 이는 EMIB 기술에 대한 시장 기대를 반영한다.

    4.4 전략적 의미

    • 공급망 탄력성 강화: EMIB 기술을 도입함으로써 SK 하이닉스는 다양한 파운드리·패키징 옵션을 확보하고, 전 세계 AI 반도체 고객에게 다양한 선택지를 제공한다.
    • 수익성 개선: EMIB는 CoWoS 대비 비용이 낮고 수율이 높아 생산 비용 절감과 마진 확대가 가능하다.
    • 글로벌 협업 시너지: 인텔은 내부 고객뿐 아니라 외부 파트너와의 협력을 확대하고 있으며, SK 하이닉스와 같은 메모리 강자를 합류시키는 것은 패키징 생태계 전반의 경쟁력 제고에 기여한다.

    5️⃣ 시장 반응과 주가 흐름

    기업주가 변동 (최근)원인·주요 뉴스
    SK 하이닉스5% 급등(프리마켓), 200만원선 근접EMIB 기반 HBM 연구개발, AI 칩 수요 확대
    인텔12% 급등, 신고가 경신EMIB·18A‑P 공정 성공 기대, 구글·메타·애플 고객 검토
    미국 반도체 지수불트런(필라델피아 반도체 지수) +2.6%, 규모 확대AI 가속기와 고대역폭 메모리 수요 상승

    핵심 인사이트: EMIB 기술이 핵심 부품(HBM)과 AI 가속기의 연계 고도화를 가능케 함에 따라, 해당 기술을 보유하거나 도입하는 기업들의 주가가 동반 상승하는 패턴을 확인할 수 있다.


    6️⃣ EMIB 적용 사례와 기대 효과

    6.1 AI 가속기와 GPU

    • NVIDIA·AMD 등이 설계한 AI 가속기는 GPU와 HBM을 2.5D 패키징으로 결합하는 것이 핵심이다. EMIB는 고대역폭 연결을 저비용으로 구현해 AI 연산 효율을 극대화한다.

    6.2 데이터센터와 서버

    • 구글·메타·애플은 차세대 데이터센터용 AI 칩(예: 구글 TPU, 메타 MTIA)에서 EMIB 적용을 시범 검토하고 있다. 이는 대형 파우치 패키지 비용 절감과 미국 내 생산 가능성을 동시에 확보하려는 전략이다.

    6.3 HBM 메모리 생산 확대

    • SK 하이닉스는 HBM4·HBM5 제품 라인업을 개발하고 있으며, EMIB와 결합해 수율·안정성을 높이고 있다. 이를 통해 고성능 AI 서버/클라우드 시장에 대한 공급을 확대한다.

    6.4 비용 절감과 경쟁력 향상

    • EMIB는 수백 달러 수준의 패키징 비용으로 CoWoS 대비 약 70~80% 저렴하게 구현 가능하다. 이는 고성능 AI 시스템 전체 비용 구조를 크게 낮춘다.

    6.5 생산지 다변화와 규제 대응

    • 미국 내 생산: 인텔은 오리건·베트남에 EMIB 생산 라인을 확보해 미국 내 공급망을 강화한다. 이는 미국 정부의 반도체 공급망 보조 정책과도 부합한다.
    • 수출 규제 회피: EMIB 기반 패키징은 미국 기반 제조 특성상, 수출 규제 리스크를 낮추어 글로벌 고객에게 안정성을 제공한다.

    7️⃣ 생산능력 확대와 글로벌 고객 확보

    7.1 인텔의 생산 인프라 전략

    • 오리건·베트남 공장에 대규모 EMIB 장비를 발주하고, 2026년 하반기부터 장비 납품을 시작한다.
    • 대형 고객 확보: 구글·메타를 비롯해 애플·테슬라·브로드컴 등도 EMIB 적용을 검토하고 있어, 2026~2027년에 대량 주문이 들어올 전망이다.

    7.2 SK 하이닉스의 공급망 다변화

    • 기존 TSMC CoWoS 의 의존도를 낮추기 위해 인텔 EMIB와 자체 2.5D 라인을 활용한다.
    • 시장 기대감이 반영돼 SK 하이닉스 주가 상승 및 HBM4·HBM5 제품 라인업 확대가 가속화될 것으로 보인다.

    7.3 글로벌 시장 전망

    • 전문가 의견: EMIB는 대형 AI 칩에 대한 비용·수율·규모 면에서 CoWoS와 대등하거나 우위를 점할 가능성이 높다.
    • 시장 규모: 전 세계 유리기판·EMIB 기반 패키징 시장은 2028년까지 84억 달러(약 12조 원) 규모로 성장 전망이다.

    8️⃣ 기술적 과제와 앞으로의 전망

    8.1 현재 직면한 도전 과제

    과제설명해결 방안
    수율 문제실리콘 브릿지와 TSV가 결합되면 재료 불일치·기계적 스트레스가 발생하여 수율 저하 위험이 있다.고도화된 공정 제어와 검사 장비 도입, 재료 조합 최적화
    규모 확장성현재 EMIB는 중소 규모 패키지에 적합; 대형 AI 칩에 적용하려면 브릿지 수와 배치가 복잡해진다.EMIB‑T와 같은 확장형 브릿지 기술 개발, 설계 자동화 도입
    고객 인증구글·메타·애플 등 주요 고객이 아직 정식 채택 단계가 아니다.양산 테스트와 신뢰성 검증을 통해 케이스 스터디 제공
    규제·수출 통제미국 내 제조가 늘어나면서 수출 규제에 대한 대응 필요.다중 생산거점 및 복합 공급망 구축으로 위험 분산

    8.2 향후 로드맵

    1. 2026~2027년: 인텔 EMIB‑T 대형 고객(구글·메타)과 양산 계약 체결 및 생산량 확대.
    2. 2027~2028년: SK 하이닉스와 인텔 협력으로 HBM4·HBM5에 EMIB 결합 적용, 수율 90% 이상 목표 달성.
    3. 2029년: 유리기판 기반 2.5D와 EMIB가 병행 적용되며 AI 칩 비용 구조 전반에 혁신을 가져올 전망.

    8.3 기대 효과 요약

    • 비용 절감: 기존 CoWoS 대비 70~80% 비용 절감 (수백 달러 수준)
    • 공급망 탄력성: 미국·베트남 생산 기반으로 공급망 위험 최소화
    • 시장 경쟁력 강화: AI 가속기·HBM·서버 시장에서 다양한 파트너십을 통한 시너지 기대
    • 환경·에너지 효율: 작은 브릿지 설계와 재료 사용 최소화로 에너지 효율 향상

    9️⃣ 결론

    EMIB는 인텔이 자체적으로 개발한 2.5D 패키징 혁신 기술로, 다이간 고대역폭 연결을 저비용·고수율로 구현한다. SK 하이닉스가 인텔과 협력해 EMIB 기반 HBM 패키징 연구를 진행한다는 소식은, AI 가속기와 고성능 서버 시장에 새로운 공급망 옵션을 제공한다는 점에서 큰 의미를 가진다.

    현재 EMIB는 코스트 절감, 생산능력 다변화, 수율 향상의 세 축을 통해 TSMC CoWoS와 차별화된 가치를 제공하고 있다. 인텔은 미국·베트남 생산 확대와 구글·메타·애플 등 글로벌 고객 확보를 통해 EMIB를 AI 시대 핵심 인프라로 자리매김하고자 한다. SK 하이닉스는 이를 공급망 탄력성과 수익성 개선의 기회로 활용하고, HBM4·HBM5와 같은 차세대 메모리 제품에 EMIB를 적용함으로써 AI 반도체 시장에서의 경쟁력을 크게 강화할 것이다.

    EMIB의 기술 원리와 현재 협력 현황을 쉽게 정리한 이 글이, 반도체·패키징 분야의 최신 동향을 파악하고 향후 투자·사업 전략을 수립하는 데 도움이 되기를 기대한다.


    관련 기사

    https://www.autodaily.co.kr/news/articleView.html?idxno=543993

  • [2026.05.08]AI 보안·사이버 복원력 투자 가이드 – 글로벌·국내 핵심 종목과 ETF로 보는 중·장기 포트폴리오 전략

    이미지 대체 텍스트 안내
[개요]
'AI 보안 및 사이버 복원력 투자 가이드'라는 제목의 인포그래픽으로, 글로벌 및 한국의 주요 보안 기업, 관련 ETF, 그리고 중장기 투자 전략을 청록색 톤의 미래 지향적인 레이아웃으로 정리한 이미지입니다.

[상세 내용]

헤드라인:

Main Title: INVESTMENT GUIDE: AI SECURITY & CYBER RESILIENCE

Strategy: MEDIUM-TO-LONG-TERM PORTFOLIO STRATEGY

시장 동력 (Market Drivers):

AI 및 클라우드 수요 급증 → 양자 암호(PQC/QKD) 기술 → 규제 및 정책 지원 → 지속적인 시장 성장으로 이어지는 흐름도.

글로벌 리더 (Global Leaders in AI Security):

Palo Alto Networks (PANW): 차세대 위협 방어 선도.

Zscaler (ZS): 제로 트러스트 보안 및 클라우드 강자.

CrowdStrike (CRWD): 엔드포인트 탐지 및 AI 기반 위협 인텔리전스.

Fortinet (FTNT): 네트워크 및 AI 통합 방화벽 솔루션.

Microsoft & Amazon: 클라우드 인프라와 보안 서비스의 수직 계열화.

국내 핵심 종목 (Korean AI Security Stocks):

AhnLab (053800): 국내 1위 보안 기업, AI 및 양자 암호 대응.

Genience (058970): 네트워크 접근 제어 및 클라우드 보안.

RaonSecure (042670): 인증 보안 및 양자 키 분배 기술.

MonitorLab (312610): 클라우드 기반 AI 보안 플랫폼.

사이버 보안 및 클라우드 ETF:

CIBR (글로벌): 글로벌 보안 리더 기업들을 한데 모은 ETF.

CLOU / SKYY (클라우드): 클라우드 인프라와 보안의 동반 성장 수혜.

KODEX K-AI & SECURITY (국내): 한국 인공지능 및 보안주 특화 상품.

핵심 요약 (Key Takeaway):

"AI, 클라우드, 양자 보안 분야의 검증된 기업과 ETF를 통한 분산 투자를 통해 변동성을 최소화하고 성장 잠재력을 극대화하라."

[비주얼 요소]
이미지 좌측에는 회로 기판, 자물쇠, 방패, 데이터 클라우드 등 보안을 상징하는 네온 그래픽 아이콘들이 배치되어 있으며, 우측 하단에는 상승하는 막대 그래프가 포함되어 시장의 긍정적인 전망을 시각화하고 있습니다.

    요약

    AI와 클라우드가 결합하면서 사이버 위협은 점점 더 정교해지고 있습니다. 이에 따라 AI 기반 보안·사이버 복원력 시장은 연평균 13% 이상의 성장세를 보이며, 양자 암호(PQC·QKD)와 같은 차세대 기술까지 확대되고 있습니다. 본 글에서는 글로벌 보안 리더 기업, 국내 AI 보안 핵심 종목, 그리고 보안·클라우드 연계 ETF를 정리하고, 중·장기 투자 관점에서의 포트폴리오 구성 방안을 제시합니다.


    1. 글로벌 AI 보안·사이버 복원력 주요 기업

    기업핵심 기술·사업투자 포인트
    Palo Alto Networks (PANW)AI 기반 위협 탐지·자동화 방어(Cortex XSIAM, Prisma AIRS)시장 선도, 매출·순이익 연속 성장
    Zscaler (ZS)클라우드 제로 트러스트 네트워크 접근 제어클라우드 보안 수요 급증, MDR 확대
    CrowdStrike (CRWD)클라우드 기반 엔드포인트 탐지·응답(EDR)AI·머신러닝 위협 인텔리전스, 글로벌 고객 기반
    Fortinet (FTNT)차세대 방화벽·AI 보안 관리하드웨어·소프트웨어 통합, 대규모 기업 계약
    Okta (OKTA)신원 인증·제로 트러스트 솔루션디지털 전환 필수, 지속적 매출 성장
    CyberArk (CYBR)특권 계정 보안·AI 기반 위협 방어특권 보안 수요 확대, 기업 보안 정책 강화
    Check Point Software (CHKP)네트워크·클라우드 보안·AI 위협 방어전통 보안 강자, AI 라인업 확대
    Microsoft (MSFT) – Microsoft Defender클라우드·AI 보안 통합 솔루션클라우드 시장 점유율과 보안 연계, AI 보안 투자 확대
    Amazon (AMZN) – AWS Security클라우드 보안·AI 위협 탐지클라우드 인프라와 보안 연계, AI 보안 서비스 성장

    핵심 포인트 : 미국·유럽 대형 보안 기업들은 AI·클라우드 융합을 통해 고도화된 위협 탐지와 자동 방어를 제공하고 있으며, 매출·수익성 모두 견조한 성장세를 보이고 있습니다.


    2. 국내 AI 보안·사이버 복원력 핵심 종목

    기업핵심 기술·사업투자 포인트
    안랩 (AhnLab, 053800)AI·PQC 기반 보안 솔루션, AI 대응 플랫폼AI·양자 내성 암호 연구 확대, 글로벌 협력 강화
    지니언스 (Genience, 058970)기업용 보안 플랫폼·클라우드 보안안정적인 수익 구조, 기업 고객 확대
    파수에이아이 (Pasu AI, 067310)AI 기반 위협 탐지·예방 솔루션AI 보안 기술 선점, 중장기 성장 기대
    라온시큐어 (RaonSecure, 042670)인증·핀테크 보안·양자키분배(QKD) 연구정책·규제 수혜, 양자보안 선도
    아톤 (Aton, 067260)인증·핀테크 보안·전자서명금융·공공 부문 계약 확대, 정책 연계 성장
    한국정보인증 (KISA, 037420)전자서명·인증 서비스·AI 보안공공·금융 보안 특화, 정부 예산 확대
    엑스게이트 (Xgate, 067260)양자보안 기반 퀀텀 VPN·홈네트워크 보안양자보안 솔루션 상용화 초기 단계, 성장 잠재력
    모니터랩 (MonitorLab, 312610)AI 보안 플랫폼·클라우드 보안·ZTNAMicrosoft와 협력, AI 보안 시장 선점
    샌즈랩 (SandsLab, 229000)AI 기반 사이버 위협 분석·방어·글로벌 협력AI·보안 융합 기술로 글로벌 시장 확대
    오픈베이스 (OpenBase, 067260)AI 기반 자동 보안 대응·클라우드 연계AI 보안·클라우드 연계 강점, 정책·테마 변동성 주의

    핵심 포인트 : 국내 기업들은 AI·양자보안 연구와 공공·금융 보안 특화 전략을 통해 성장 동력을 확보하고 있습니다. 특히 안랩·지니언스·파수에이아이 등은 AI 보안 플랫폼을 기반으로 중·장기 성장 가능성이 높습니다.


    3. 사이버 보안·클라우드 ETF (분산 투자 수단)

    ETF주요 구성 종목투자 포인트
    CIBR (First Trust NASDAQ Cybersecurity ETF)Palo Alto, Zscaler, CrowdStrike 등 글로벌 보안 리더개별 종목 변동성 완화, 보안 산업 전체 노출
    CLOU (Global X Cloud Computing ETF)AWS, Microsoft, Alphabet 등 클라우드·보안 연계 기업클라우드 성장과 보안 수요 동시 포착
    SKYY (First Trust Cloud Computing ETF)클라우드 기반 보안 솔루션 기업 다수 포함클라우드·보안 융합 트렌드 반영
    KODEX K-인공지능·보안 (국내)안랩, 지니언스, 파수에이아이 등 국내 보안주원화 투자 가능, 국내 정책·예산 수혜
    TIGER 미국나스닥100Microsoft, Amazon 등 클라우드·보안 핵심 기업 포함간접적인 보안·클라우드 노출, 대형주 안정성

    핵심 포인트 : ETF는 개별 종목 급등·급락 위험을 줄이면서 보안·클라우드 산업 전체에 투자할 수 있는 효율적인 수단이며, 장기 포트폴리오에 필수적인 역할을 합니다.


    4. 중·장기 투자 관점에서 고려해야 할 핵심 요소

    요소내용적용 방법
    AI·클라우드 보안 수요 급증AI 기반 공격 자동화·정교화로 보안 솔루션 필요성 확대AI·클라우드 보안에 특화된 기업·ETF 비중 확대
    포스트 양자 암호(PQC)·양자키분배(QKD) 성장2028년까지 표준화·상용화 예상, 기업 R&D 투자 확대PQC·QKD 연구에 적극적인 기업(안랩·라온시큐어 등) 선택
    규제·정책 지원AI Act, 미국 프로젝트 글래스윙, EU·중국 규제 강화정책 수혜가 예상되는 기업·ETF(공공·금융 보안 특화) 보유
    시장 성장률사이버 보안 연평균 성장률 13% 이상, AI·클라우드 연계 30%+성장률이 높은 섹터에 장기 포지션 유지
    밸류에이션·리스크테마성 급등 종목은 변동성·밸류에이션 과열 위험실적·기술 검증된 기업 중심, 과도한 밸류에이션 종목 회피
    분산 투자·리스크 관리개별 종목 변동성 최소화, ETF 활용 권장핵심 글로벌 기업 5~7종 + 국내 핵심 5종 + 보안·클라우드 ETF 2~3종 구성
    핵심 지표RPO(수주잔고), NRR(순매출 유지율), Rule of 40(성장+수익성)기업 재무제표 분석 시 해당 지표 확인

    5. 추천 포트폴리오 (중·장기)

    비중투자 대상이유
    30%CIBR (Cybersecurity ETF)보안 산업 전체 성장 포착, 변동성 최소화
    20%CLOU / SKYY (클라우드·보안 ETF)클라우드 성장과 보안 수요 동시 수혜
    15%Palo Alto Networks (PANW)AI 보안 플랫폼 선도, 매출·수익성 지속 성장
    10%Zscaler (ZS)제로 트러스트·클라우드 보안 선도, 성장 잠재력
    10%안랩 (AhnLab)AI·PQC 연구 확대, 국내 정책·시장 수혜
    5%라온시큐어 (RaonSecure)양자보안(QKD) 연구와 정책 연계 성장
    5%모니터랩 (MonitorLab)Microsoft 협력·AI 보안 플랫폼, 클라우드 보안 확대
    5%오픈베이스 (OpenBase)AI 자동 대응·클라우드 연계 강점, 테마성 변동성 주의

    전략 요약 : 글로벌 리더와 국내 핵심 기업을 동시에 보유하고, 보안·클라우드 ETF를 통해 포트폴리오 변동성을 낮추는 것이 중·장기 수익을 극대화하는 핵심 전략입니다. 성장 동력(AI·클라우드·양자보안)과 정책·규제 흐름을 지속적으로 모니터링하면서, 실적·기술 검증이 확실한 기업에 비중을 유지하고 과열된 테마 종목은 조정 시 매수 기회로 활용하시길 권장합니다.


    결론

    AI와 클라우드가 결합된 사이버 보안·사이버 복원력 시장은 지속적인 성장과 기술 혁신이 동시에 일어나고 있습니다. 글로벌 보안 리더와 국내 AI 보안 기업, 그리고 보안·클라우드 연계 ETF를 적절히 배분한다면 변동성을 최소화하면서도 높은 성장 잠재력을 확보할 수 있습니다.

    이제 여러분의 투자 전략에 위 가이드를 적용해 보세요. 궁금한 점이나 추가 분석이 필요하면 언제든 알려 주세요! 🚀

    관련 기사

    https://www.etnews.com/20250506000136

  • [2026.050.06 IT리포트]셀레브라스(Cerebras) 상장 추진: “엔비디아의 독주를 멈출 대항마인가?”

    셀레브라스(Cerebras) Systems: AI Hardware Innovator’s 2026 IPO Analysis’라는 제목의 인포그래픽. AI 칩 스타트업의 2026년 IPO 전망과 기술, 재무, 시장 영향 등을 요약한다. 왼쪽에는 웨이퍼 스케일 엔진(WSE) 기술을 설명하며, 단일 웨이퍼를 하나의 칩으로 사용해 약 400만 개의 처리 요소와 18TB 온칩 SRAM, 초당 2TB의 데이터 대역폭을 제공한다고 강조한다. 중앙에는 재무 개요가 있어 2024~2026년 매출 성장(약 75.7%)과 2025년 순이익 1억 3,800만 달러, 기업가치 약 266억 달러를 제시한다. 하단에는 IPO 일정(2026년 5월 초), 공모 규모(2,800만 주), 예상 조달 금액(약 35억 달러), 자금 사용 목적(R&D 및 생산 확대)이 표시된다. 오른쪽에는 시장 영향과 차별화 요소를 비교하며, 기존 GPU 업체 및 클라우드 인프라 대비 낮은 지연 시간, 낮은 전력 소비, 대형 AI 모델에 대한 비용 효율성을 강조한다. 전체적으로 미래 전략으로 연구개발, 생산 확장, 글로벌 파트너십, 엣지 AI를 제시한다.”

    셀레브라스(Cerebras) AI 칩 스타트업은 웨이퍼 스케일 엔진(WSE) 기술과 S램 기반 고속 추론 솔루션으로 AI 반도체 시장에 새로운 경쟁 구도를 형성하고 있으며, 2026년 5월 초 진행 중인 IPO는 기업 가치를 약 266억 달러(≈ 39조 원) 수준으로 설정해 시장에 큰 파급력을 기대하고 있습니다.


    1. 기업 개요

    구분내용
    회사명Cerebras Systems, Inc. (한국어 표기: 셀레브라스 또는 세레브라스)
    설립 연도2016년
    본사미국 캘리포니아주 샌프란시스코
    핵심 사업초대형 AI 칩 및 시스템 설계·제조, AI 추론 가속 솔루션 제공
    주요 기술웨이퍼 스케일 엔진(WSE)·S램 기반 고대역폭 메모리
    대표자앤드루 펠드먼(CEO)
    주요 투자자G42(아랍에미리트), Andreessen Horowitz, Sequoia Capital 등
    주요 파트너오픈AI, 마이크로소프트, 구글 클라우드 등

    셀레브라스는 “웨이퍼 전체를 하나의 거대한 AI 칩으로 만든다”는 독창적인 웨이퍼 스케일 엔진(WSE) 기술을 핵심으로 삼고 있습니다. 기존 반도체 제조 방식은 웨이퍼를 잘라 다수의 작은 칩을 생산하지만, 셀레브라스는 단일 웨이퍼를 그대로 하나의 초대형 칩으로 활용해 연산·메모리·통신을 통합한 구조를 구현했습니다. 이와 함께 D램 기반 고대역폭 메모리(HBM) 대신 속도가 빠른 S램을 채택해 AI 추론 속도를 크게 향상시켰습니다.


    2. 핵심 기술 상세

    2.1 웨이퍼 스케일 엔진(WSE)

    • 구조: 7 nm 공정 기반 850 mm (33 인치) 웨이퍼 전체를 하나의 칩으로 사용.
    • 연산 유닛: 400 만 개 이상의 연산 유닛(Processing Elements, PE) 배치.
    • 메모리: 18 TB 규모의 온칩 S램 메모리(속도 > HBM).
    • 통신: 2 TB/s 수준의 내부 데이터 전송 대역폭 제공.

    이러한 설계는 대규모 모델 학습·추론 시 병목 현상을 최소화하고, 전력 효율성을 높여 AI 클라우드·엣지 환경 모두에 적용 가능하도록 합니다.

    2.2 S램 기반 고속 메모리

    • S램(Spin‑Transfer Torque RAM)은 비휘발성 메모리이면서 DRAM보다 빠른 접근 속도를 제공.
    • 장점: 전력 소모 감소, 데이터 손실 위험 최소화, 높은 내구성.
    • 셀레브라스 적용 효과: AI 추론 시 메모리 대역폭 제한을 해소해 연산 속도 2~3배 향상을 달성.

    3. 재무 현황

    연도매출 (USD)전년 대비 성장률순이익 (USD)주요 지표
    20242.9 억–-9.9 억 (손실)초기 투자 단계
    20255.1 억75.7 % 증가1.38 억 (흑자 전환)제품 상용화 가속화
    2026(예상)7~8 억지속 성장 예상2~3 억IPO 자금 활용 확대

    2025년 매출은 전년 대비 75.7 % 성장했으며, 손실에서 흑자로 전환한 점이 투자자들의 기대를 크게 높였습니다.


    4. IPO 진행 상황

    4.1 IPO 목표 및 규모

    • 공모 주식: A형 보통주 2,800만 주 (신규 공모)
    • 총 발행 주식: 기존 B형 주식 포함 2억 1,296만 5,381주
    • 주당 공모희망가: 115 ~ 125 달러
    • 예상 시가총액: 266억 2000만 달러 (≈ 39조 원)

    4.2 IPO 일정

    단계일정비고
    신청서 제출2026‑05‑04 (SEC)수정 상장신청서 제출
    공모가 확정2026‑05‑19주당 115~125 달러 범위 내 확정
    상장 예정일2026‑06‑~정확한 날짜는 추후 공시 예정

    4.3 IPO 추진 배경

    • 스페이스X IPO 대비 선점: 일론 머스크의 스페이스X가 대규모 IPO를 준비 중인 상황에서, 셀레브라스는 “스페이스X보다 먼저 거래를 성사시키려는 경쟁”이 존재한다는 분석이 제시되었습니다.
    • 전년도 상장 철회 경험: 2024년 9월 상장을 시도했으나, 아랍에미리트 기업 G42의 지분 투자와 관련된 CFIUS 조사로 인해 2024 10월 자진 철회한 바 있습니다. 이번 재도전은 절차를 신속히 진행하고 외부 규제 리스크를 최소화하려는 전략적 선택으로 해석됩니다.

    5. 경쟁 구도 및 차별화 포인트

    구분주요 경쟁사차별화 요소
    AI 칩엔비디아(NVIDIA), AMD, 인텔웨이퍼 전체를 하나의 칩으로 만든 WSE, S램 기반 고속 메모리
    AI 추론 가속기구글 TPU, 메타 AI 칩초대형 메모리·연산 통합으로 추론 지연 최소화
    AI 클라우드 솔루션아마존 AWS, 마이크로소프트 Azure전용 하드웨어를 통한 비용·성능 최적화

    엔비디아가 AI 반도체 시장을 압도하고 있지만, 셀레브라스는 “속도와 비용 효율성을 앞세운 특화 칩 전략”으로 틈새 시장을 공략하고 있습니다. 특히, AI 모델 추론 단계에 초점을 맞추어 대규모 모델을 저전력·고속으로 서비스할 수 있는 점이 차별화 포인트입니다.


    6. IPO 이후 시장 파급력

    6.1 투자자 기대

    • 대규모 자본 조달: 약 35 억 달러(≈ 5 조 원) 규모의 신규 자본을 확보해 R&D·생산 설비 확대에 활용 예정.
    • 주가 상승 기대: IPO 직후 주가가 엔비디아·스페이스X와 같은 대형 IPO와 경쟁할 정도로 높은 관심을 받을 것으로 전망됩니다.

    6.2 산업 전반에 미치는 영향

    1. AI 반도체 시장 구조 변화
    • 기존 GPU 중심 구조에서 초대형 전용 칩이 새로운 표준으로 부상 가능성.
    • 엔비디아·AMD 등 기존 업체는 고성능·고효율 제품 라인업 강화를 촉진받게 됩니다.
    1. AI 서비스 비용 절감
    • 고속 추론 칩을 활용한 클라우드·엣지 AI 서비스는 전력·운영 비용을 크게 낮출 수 있어, AI 서비스 가격 인하와 시장 확대에 기여합니다.
    1. 투자 흐름 재편
    • AI 반도체 분야에 대한 전통적인 투자(GPU)와 전용 칩(WSE) 사이의 자본 배분이 재조정될 가능성이 있습니다.
    • 특히, 벤처·프라이빗 에쿼티 투자자들은 셀레브라스와 같은 전용 AI 칩 스타트업에 대한 관심을 높일 전망입니다.

    6.3 글로벌 시장 반응

    • 미국 증시: 나스닥 상장으로 AI 반도체 섹터에 새로운 고성장 기업이 추가됨에 따라, AI ETF 및 반도체 펀드의 포트폴리오 재조정이 예상됩니다.
    • 아시아·유럽 투자자: AI 인프라에 대한 전략적 투자가 확대되면서, 셀레브라스 주식은 기관·연기금 투자 대상이 될 가능성이 높습니다.

    7. 규제·리스크 요인

    리스크내용대응 방안
    CFIUS 조사과거 G42 투자와 관련해 외국인 투자 규제 조사 경험투자 구조 투명화·미국 내 투자 비중 확대
    기술 경쟁엔비디아·구글·AMD 등 대형 기업의 지속적인 기술 혁신지속적인 R&D 투자·특허 포트폴리오 강화
    시장 변동성IPO 직후 주가 변동성 및 투자자 심리 변화투자자 커뮤니케이션·투명한 재무 보고
    생산 공급망고급 반도체 제조 공정(7 nm) 의존도 높음다중 파운드리 전략·공정 파트너 다변화

    8. 향후 전략 및 전망

    1. R&D 확대
    • 차세대 WSE(다음 세대 웨이퍼 스케일 엔진) 개발 및 S램 고도화에 집중.
    • AI 모델 최적화 소프트웨어와의 통합을 통해 전체 솔루션 제공.
    1. 생산 능력 확대
    • TSMC·삼성 파운드리와 협력해 5 nm·3 nm 공정 전환 검토.
    • 대량 생산 라인 구축으로 비용 절감 및 공급 안정성 확보.
    1. 시장 확대
    • 클라우드 서비스 제공업체와 파트너십 체결(예: 마이크로소프트·구글 클라우드).
    • 엣지 AI(자동차·IoT) 분야 진출을 위한 맞춤형 칩 라인업 확대.
    1. 글로벌 파트너십
    • 오픈AI와 같은 AI 모델 제공 기업과 협업해 최적화된 하드웨어·소프트웨어 스택 제공.
    • 대형 데이터 센터와 직접 계약해 전용 AI 가속기 공급 확대.
    1. 재무 전략
    • IPO 자금으로 R&D·생산 설비에 투자하고, 채무 구조를 최적화해 재무 건전성 유지.

    9. 결론

    셀레브라스는 웨이퍼 전체를 하나의 초대형 AI 칩으로 만든 WSE 기술과 S램 기반 고속 메모리를 핵심으로, AI 추론 분야에서 기존 GPU 기반 솔루션보다 뛰어난 성능·효율성을 제공하고 있습니다. 2026년 5월 초 진행 중인 IPO는 266억 달러(≈ 39조 원) 규모의 기업 가치를 목표로 하며, 35 억 달러(≈ 5 조 원) 규모의 신규 자본을 조달해 R&D·생산 확대에 활용될 예정입니다.

    IPO 성공 시, 셀레브라스는 AI 반도체 시장 구조를 재편하고, AI 서비스 비용 절감 및 글로벌 투자 흐름 재조정에 큰 영향을 미칠 것으로 기대됩니다. 동시에 CFIUS 조사와 대형 경쟁사와의 기술 경쟁 등 리스크 요인도 존재하지만, 투명한 투자 구조와 지속적인 기술 혁신을 통해 이를 극복할 수 있을 것입니다.

    향후 셀레브라스는 차세대 WSE 개발, 생산 능력 확대, 글로벌 파트너십 강화를 통해 AI 산업 전반에 걸친 핵심 인프라 공급자로 자리매김할 가능성이 높으며, 이는 투자자들에게 장기적인 성장 가치와 전략적 투자 기회를 제공할 것입니다.

    관련 기사

    https://news.nate.com/view/20260505n10613?mid=n0102

  • [2026-05-04 경제 리포트]SMR 상업화와 원전 수명 연장 시장, K-원전주에 주목해야 하는 이유

    Alt-Text: Global Korean Nuclear(K-원전) Power Technology Infographic
Overall Description:
A comprehensive infographic titled "GLOBAL KOREAN NUCLEAR POWER TECHNOLOGY" presented in a modern, dark-blue tech-themed layout. It illustrates South Korea's nuclear power portfolio, including large-scale reactors, SMRs, market prospects, and key industry players.

Section 1: Large-Scale Reactors (APR1400 & APR1000)

Top Center: States "K-Nuclear’s Strategic Portfolio: TOP 10% IN GLOBAL DESIGN & CONSTRUCTION".

APR1400 (Left): Labeled as a 1,400 MWe Large-Scale PWR. Highlights include UAE Barakah export success, dual containment & core catcher systems, and a 52-month construction timeline.

APR1000 (Right): Labeled as a 1,000 MWe Scaled PWR. Highlights include targeting European markets, advanced safety systems, and a shortened 36-month modular construction timeline.

Comparison Table (Center): Compares power output, safety margins, market focus (UAE vs. Europe), and construction methods between the two models.

Section 2: Advanced Reactors & Innovation (i-SMR & MSR)

i-SMR (Left): Describes the Integral Small Modular Reactor with 170 MWe per module, a 24-month construction period, and passive safety features. It targets commercialization in the early 2030s.

Small MSR (Right): Describes the Molten Salt Reactor featuring high-temperature output (600-950°C), reduced nuclear waste, and synergy with hydrogen production.

Timeline (Center): A blue arrow chart showing the progression from R&D and Timeline to FOAK (First-Of-A-Kind) phases.

Section 3: Investment & Growth Prospects

Market Data (Bottom Left): Two bar charts showing a 19.2% CAGR for the Global SMR Market (2026-2031) and steadily growing nuclear capacity.

Key Drivers (Bottom Center): Icons representing cost efficiency, life extension potential, diversified services (decommissioning), and government policy support.

Global Footprint (Bottom Right): A world map with arrows originating from South Korea pointing toward the UAE, EU, and Southeast Asia, signifying export routes.

Section 4: Key South Korean Players

Bottom Row: Displays logos and roles of major companies including KET (Design), KHNP (Operator), Doosan (Manufacturing), Hyundai (Construction), and KEPCO E&C (Design).

    한국 원전(K-원전) 기술은 현재 전 세계 원전 설계·시공 분야에서 상위 10 % 안에 자리하고 있으며, 특히 APR1400·APR1000 모델은 해외 수출 성공 사례를 통해 국제 경쟁력을 입증하고 있습니다.


    1. APR1400·APR1000 개요

    APR1400·APR1000은 한국이 자체 설계·제조한 3세대 경수로이며, SMR(소형모듈원자로)은 300 MWe 이하의 소형화·모듈화된 원자로로 안전·경제성이 강화된 차세대 원전이며, 혁신형 i‑SMR은 APR1400 기반의 일체형 설계, 소형 MSR은 고온 가스로 냉각하는 차세대 원자로로 연구·개발이 진행 중입니다.

    항목내용
    개발 배경1970년대 석유 파동 이후 원자력 자립을 목표로 기술자립 계획을 수립, 1995년까지 95 % 수준의 국산화 달성
    주요 설계3세대 경수로(PWR)로, 고압 물을 냉각재·감속재로 사용. APR1400은 1,400 MWe, APR1000은 1,000 MWe 수준으로 설계·시공
    핵심 기술원전계측제어시스템(MMIS)·원자로 냉각재 펌프 등 핵심 기자재를 국내 기술로 개발·적용
    운전 실적신고리·신한울 등 6호기 이상 운전, 연간 3 조 kWh 이상 전력 생산
    수출 실적UAE에 APR1400 4호기 수출, 국제 공개 경쟁입찰에서 프랑스·일본을 제치고 낙찰
    향후 로드맵APR1000을 기반으로 차세대 APR‑1400·APR‑1000 고도화 및 i‑SMR·SMR 연계 개발 진행 중

    APR1400은 1,400 MWe 출력의 대형 경수로이며, APR1000은 1,000 MWe 출력으로 규모를 축소한 소형 경수로로, 두 모델은 전력 용량·코어 설계·건설 방식·안전 시스템에서 차이를 보입니다.


    1-1. 전력 출력 및 설계 목표

    항목APR1400APR1000
    정격 전력1,400 MWe1,000 MWe (출력 30 % 감소)
    설계 목적대형 전력망·수출용 고출력 원전전력 수요가 낮은 지역·맞춤형 수출용 소형 원전
    핵심 차이동일한 핵심 기술에 기반해 전력 용량을 최대화핵심 설계는 유지하면서 규모와 핵연료 집합을 축소

    1-2. 코어·연료 설계

    항목APR1400APR1000
    코어 규모대형 코어, 고열량 밀도축소된 코어, 낮은 열량 밀도
    연료 어셈블리 수표준 OPR1000 대비 약 157개 (기준)코어 축소에 따라 어셈블리 수 감소 (정확한 수치는 공개되지 않음)
    연료 주기18‑24개월 주기, 60년 설계 수명동일한 60년 설계 수명, 연료 주기 유사
    핵연료 기술Zr‑Nb 합금 ‘HANA’ 등 국산 피복관 적용 가능동일한 피복관 기술 적용 가능, 핵연료 자립도 동일

    1-3. 안전 시스템

    1-3‑1. APR1400 주요 안전 특징 (정확한 리스트는 제공되지 않았지만, 기존 문헌에 따르면)

    • 패시브 안전: 패시브 열제거시스템(PASSIVE DECAY HEAT REMOVAL)
    • 이중 격납건물: 2중 격납 구조와 코어 캐처(Core Catcher)
    • 항공기 충돌 방호: 강화된 구조 설계

    1-3‑2. APR1000 안전 시스템

    • Safety Injection System (5IS)
    • Shutdown Cooling/Containment Spray System (5C5/CS5)
    • Passive Auxiliary Feedwater System (PAF5)
    • Spent Fuel Pool Cooling System (5FPC5)
    • Diverse Containment Spray System (DC5S) 등 다중 안전 계통

    두 모델 모두 핵심 손상 빈도를 10⁻⁶ 이하로 설계하고, 열적 여유(thermal margin)를 유지한다는 공통점을 갖는다. APR1000은 APR1400과 동일한 안전 수준을 유지하면서 규모를 축소했으며, 위와 같은 다중 안전 계통을 그대로 적용한다.

    1-4. 건설·모듈화

    항목APR1400APR1000
    건설 기간약 52개월 (전통적인 현장 건설)약 36개월 (모듈식 건설)
    모듈화 수준일부 모듈화 적용전반적인 모듈화·공장 제작으로 건설 효율성 향상
    현장 조립현장 맞춤형 설비 설치 비중 높음공장 제작 부품 비중이 높아 현장 작업 감소

    1-5. 시장·수출 전략

    • APR1400은 UAE 등 중동·아시아 시장에 수출된 바 있으며, EU‑APR1400 등 해외 규격에 맞춘 변형 모델도 개발 중이다.
    • APR1000은 체코·두코바니 프로젝트 등 유럽 시장을 목표로 맞춤형 설계·용량 축소 전략을 채택했으며, 동일한 설계 수명·안전 수준을 유지하면서 비용 경쟁력을 확보하였다.

    1-6. 요약

    • 출력: APR1400 = 1,400 MWe, APR1000 = 1,000 MWe.
    • 코어·연료: APR1000은 코어와 연료 어셈블리를 축소해 열량 밀도를 낮추었으며, 핵연료 자립 기술은 동일.
    • 안전: 두 모델 모두 핵심 손상 빈도 10⁻⁶ 이하, 열적 여유 유지. APR1400은 패시브 안전·이중 격납·코어 캐처 등 고급 안전 설비를 갖추고, APR1000은 APR1400과 동일한 다중 안전 계통을 적용하면서 규모를 축소.
    • 건설: APR1000은 모듈식 공장 제작으로 건설 기간을 36개월로 단축, APR1400은 전통적인 현장 건설 방식으로 약 52개월 소요.
    • 수출·시장: APR1400은 대형 수출 시장을 겨냥, APR1000은 전력 수요가 낮은 지역·맞춤형 수출에 초점을 맞추어 경쟁력을 확보하고 있다.

    이와 같이 APR1400과 APR1000은 전력 용량·코어 설계·건설 방식·안전 시스템에서 차이를 보이며, 각각 대형·소형 원전 시장의 요구에 맞춰 최적화된 기술적 특성을 가지고 있습니다.


    2. SMR(소형모듈원자로) 개요

    2‑1. 전 세계 SMR 현황

    • 디자인 수: 2026년 초 기준 전 세계 127개 이상의 SMR 설계가 존재, 7개 설계가 운영·건설 중, 51개가 라이선스·인허가 단계.
    • 주요 국가: 미국·러시아·중국이 각각 17·17·8개의 설계를 주도.
    • 주요 특징: 300 MWe 이하, 공장 제작·모듈화, 패시브 안전 설계, 투자·건설 기간 단축.

    2‑2. 한국형 혁신형 SMR(i‑SMR)

    항목내용
    설계 기반APR1400 대형 PWR 기술을 기반으로 한 일체형 가압경수로
    전기 출력170 MWe(모듈당)
    핵심 기술– 무붕산 운전으로 화학·부식 관리 간소화
    – 내장형 제어봉 구동장치·CEDM
    – 전자빔용접·PM‑HIP 등 혁신 제조 기술
    안전성피동형(패시브) 안전계통 적용, 운전원·전원·추가 냉각수 없이 자동 정지·무한 냉각 유지
    경제성건설 기간 24개월, 건설 단가 $3,500/kW 이하, 발전 단가 $65/MWh 목표
    상용화 일정2030년 초 FOAK(First‑Of‑A‑Kind) 상업 운전 목표
    주요 참여 기업한전기술·두산에너빌리티·한국전력(한수원) 등
    정부 지원SMR 연구·실증 전담 법인·특별법 제정, 5년 단위 개발 기본계획 수립

    2‑3. SMR 적용 분야

    • 전력 공급: 섬·산간·산업단지·군사기지 등 전력망이 취약한 지역에 적합.
    • 다목적 플랜트: 전력 외에 지역난방·해수담수화·산업용 열 공급 가능.
    • 수소·탄소중립: 고온 전기·열을 활용한 수전해·고온열 화학 공정 연계.

    3. 소형 MSR(용융염 원자로) 개요

    항목내용
    냉각·감속재고온 가스(예: 헬륨)·용융염(예: LiF‑BeF₂) 사용, 고온(600‑950 °C)에서 작동
    핵심 장점– 고온 열 이용으로 전기·열 효율 향상
    – 폐기물 발생량 감소·재활용 가능성
    – 고온 수전해·고온열 화학 공정(예: S‑I Cycle) 연계
    개발 현황전 세계 10 % 이상이 고온 가스·용융염 기반 SMR을 연구, 한국은 SMART·i‑SMR 외에 고온 가스·용융염 SMR 연구 진행 중
    주요 과제– 고온 재료·용융염 내구성 확보
    – 안전성·규제 체계 정립
    – 상용화까지 10‑15년 소요 전망
    전망2030년대 이후 고온 열·수소 생산 수요 증가와 맞물려 MSR 상용화 가능성 확대

    4. 기술·경제·안전성 비교

    구분APR1400·APR1000i‑SMR (혁신형 SMR)소형 MSR
    전력 출력1,400 MWe / 1,000 MWe170 MWe (모듈당)50‑300 MWe (설계에 따라 변동)
    설계 형태대형 일체형 PWR일체형 가압경수로, 모듈화·공장 제작고온 가스·용융염 냉각, 고온 설계
    건설 기간60 개월 이상24 개월 (모듈당)30‑40 개월 (예상)
    건설 비용$6,000‑12,000/kW$3,500/kW 이하$4,000‑8,000/kW (예상)
    안전 시스템능동형·패시브 혼합피동형(패시브) 안전, 무붕산 운전패시브 고온 안전, 자연 순환 냉각
    수명60‑80 년80 년 설계 목표60‑80 년 설계 목표
    주요 활용전력·기본부하전력·수소·산업용 열고온 전기·수소·탄소중립 공정
    수출·시장UAE·중동·아시아국내·해외 파일럿·FOAK연구·시범 단계, 해외 협력 확대 중

    5. 시장·수출·투자 전망

    1. 글로벌 원전 시장: 2025년 기준 전 세계 원전 용량 433 GW, 신규 건설 64 GW, 폐쇄 216 GW. 원전 전체 용량은 2026년에도 414 GW 수준 유지.
    2. SMR 성장: 연평균 19.2 % CAGR(2026‑2031). 특히 AI·데이터센터 전력 수요 급증(600 %↑)이 SMR 투자 촉진.
    3. 한국 수출 경쟁력: APR1400 수출 성공을 바탕으로 i‑SMR·SMR 수출 기대감 상승, 두산에너빌리티·한전기술 등 기업이 해외 투자자 관심을 받고 있음.
    4. 투자 포인트
    • 비용·기간 절감: 모듈화·공장 제작으로 건설 기간·비용 대폭 감소.
    • 다목적 활용: 전력 외에 수소·산업용 열·해수담수화 등 복합 활용 가능.
    • 정책·규제 지원: 정부 주도 SMR 연구·실증 법제화, 5년 단위 개발 계획 수립.
    • 핵심 기업: 한전기술·두산에너빌리티·한국전력·KEPCO E&C 등 원전·SMR 전 주기 역량 보유 기업.
    1. 리스크
    • 규제·인허가: SMR·MSR는 기존 대형 원전과 다른 규제 체계 필요.
    • 기술 성숙도: MSR는 고온 재료·용융염 기술 확보가 관건.
    • 시장 경쟁: 미국·러시아·중국 등 기존 원전 강국과의 경쟁 심화.

    6. K-원전 글로벌 위치와 경쟁력

    항목내용
    핵심 설계 역량한국전력기술은 원전 종합설계(A/E)와 원자로계통설계(S/D)를 동시에 보유한 유일한 기업으로, OPR 1000 → APR 1400 → APR 1000 순으로 기술 고도화를 이루어 왔음.
    수출 실적UAE 바라카 원전 설계 전담사로 참여했으며, 인도네시아·체코 등 신규 시장 개척 경험 보유.
    시장 점유율2026년 기준 전 세계 원전 설계·시공 시장에서 한국 기업(KEPCO E&C, 두산에너빌리티 등)은 상위 10 %에 포함되며, 아시아‑태평양 지역 성장에 핵심 역할 수행.
    비용 경쟁력원전의 균등화 발전비용(Levelised Cost of Electricity)은 $69/MWh 수준으로, 재생에너지 대비 저렴한 편이며, 수명 연장 비용(kW당 500~1,000 USD)은 신규 건설(kW당 6,000~12,000 USD)보다 현저히 저렴함.
    수출 전망중동·동남아 지역의 에너지 안보·탄소중립 정책 변화에 따라 원전·재생에너지 수출 기회가 확대될 것으로 예상됨.

    7. 향후 발전 방향

    방향핵심 내용
    SMR(소형모듈원전) 상업화2030~2035년 초에 상업화가 본격화될 전망이며, 한국형 SMR는 글로벌 시장(북미·국내)에서 경쟁력 확보 가능성이 높음.
    원전 수명 연장기존 원전의 수명 연장 프로젝트는 저비용·저탄소 기저부하 유지에 가장 효율적인 방안으로 평가됨.
    원전 기반 수소·암모니아원전 연계 수전해를 통한 청정수소 생산 실증이 진행 중이며, 향후 대규모 수소·암모니아 생산 기반으로 활용될 전망.
    해체·폐기물 관리 서비스방사성 폐기물 발생량 증가에 대응해 해체·제염·절단·폐기물 처리 서비스 시장이 성장하고 있음.
    재생에너지와 병행 확대원전과 재생에너지(태양광·풍력·ESS) 병행 확대가 에너지 안보와 탄소중립을 동시에 달성하는 전략으로 부각됨.

    8. 주요 기업 및 역할

    기업주요 사업 영역특징
    한국전력기술(KET)원전 종합설계·원자로계통설계·수명 연장·해체OPR 1000·APR 1400·APR 1000 모델 개발·수출 실적 보유
    한전기술(KHNP)EPC(설계·조달·시공)·SMR·해상풍력SMR ‘반디’ 개발·해상풍력 프로젝트 확대
    두산에너빌리티원전 핵심 설비·SMR·해체·제염글로벌 SMR 파트너십·베트남 신규 원전 참여
    현대엔지니어링원전 설계·시공·해체대형 원전 EPC 역량·SMR 기술 확보
    KEPCO E&C원전 설계·수명 연장·SMR국내 원전 설계·SMR 시장 선점 노력
    Korea Hydro & Nuclear Power (KHNP)원전 운영·수명 연장·폐기물 관리국내 원전 운영·해체 서비스 주도
    글로벌 파트너EDF·Rosatom·CNNC·Westinghouse·GE‑Hitachi 등해외 시장 진출·기술 협력 기반 제공

    9. 투자 분석

    9.1 시장 성장 전망

    • 전 세계 원전 용량: 2025년 402.60 GW → 2031년 417.06 GW (연평균 0.6 % 성장)
    • SMR 시장: 19.2 % CAGR (2026‑2031)
    • 원전 수명 연장: kW당 500~1,000 USD 비용으로 신규 건설 대비 10배 이상 비용 효율

    9.2 투자 매력 포인트

    포인트설명
    비용 효율성수명 연장·SMR는 기존 대형 원전 대비 건설·운전 비용이 현저히 낮음.
    기술 독립성한국은 원전 설계·시공·해체 전 주기 기술을 자체 보유, 해외 의존도 낮음.
    수출 잠재력중동·동남아·아프리카 등 에너지 안보·탄소중립 수요 증가에 따라 수출 기회 확대.
    다각화된 서비스설계·시공·수명 연장·해체·폐기물 관리까지 전 주기 서비스 제공으로 안정적인 매출 흐름 확보.
    정부 정책 지원에너지 안보·탄소중립 정책에 따라 원전·SMR·수소 연계 사업에 대한 정부 지원 확대.

    9.3 위험 요인

    위험내용
    정책·제도 불확실성SMR 상업화는 정책·제도 정비 속도가 핵심 변수이며, 지연 시 시장 진입이 늦어질 수 있음
    국제 정세중동·동남아 지역 지정학적 리스크가 투자 회수에 영향을 미칠 가능성 존재
    핵폐기물 논란방사성 폐기물 관리·저장 시설에 대한 사회적·환경적 논란이 지속될 수 있음
    경쟁 심화EDF·Rosatom·CNNC·Westinghouse 등 글로벌 대기업과의 경쟁이 치열함

    9.4 투자 전략 제언

    1. SMR와 수명 연장 포트폴리오에 집중 – 비용 효율성과 시장 성장성을 동시에 확보.
    2. 해외 수출 파트너십 확대 – 중동·동남아·아프리카 등 에너지 안보가 중요한 지역과 전략적 MOU 체결.
    3. 폐기물·해체 서비스 확대 – 방사성 폐기물 발생량 증가에 대비해 서비스 라인업을 강화.
    4. 정부·규제 대응 역량 강화 – 정책·제도 변화에 신속히 대응할 수 있는 전담 조직 구축.

    10. 결론

    한국 원전 기술은 설계·시공·수명 연장·해체까지 전 주기를 자체 보유한 독보적인 역량을 바탕으로, APR 1400·APR 1000 등 수출 성공 사례를 통해 글로벌 시장에서 상위 10 % 안에 자리하고 있습니다. 향후는 SMR 상업화와 원전 기반 수소·암모니아 생산, 폐기물·해체 서비스 확대가 핵심 성장 동력이며, 한국전력기술·한전기술·두산에너빌리티·현대엔지니어링 등 주요 기업이 이를 선도하고 있습니다. 투자자는 비용 효율성, 정책 지원, 해외 수출 잠재력 등을 고려해 SMR·수명 연장·폐기물 관리 서비스에 집중하는 전략을 채택하면, 저탄소 기저부하 확보와 에너지 안보 강화라는 장기적인 시장 흐름에 효과적으로 대응할 수 있을 것입니다.

    관련 기사

    http://www.nbnnews.co.kr/news/articleView.html?idxno=1024481

  • [2026.05.02경제리포트]2026년 APPLE의 사업 전략과 AI 혁신: 하드웨어 중심의 미래와 새로운 제품 라인업

    인포그래픽 대체 텍스트 (상세 기술)
이 이미지는 2026년 애플의 사업 전략과 AI 혁신을 다루는 종합적인 인포그래픽입니다. 상단 타이틀은 'APPLE 2026: HARDWARE-DRIVEN FUTURE & AI INNOVATION' (애플 2026: 하드웨어 중심의 미래와 AI 혁신)입니다.

이미지는 크게 세 부분으로 나뉩니다.

1. 상단: 리더십 전환 (LEADERSHIP TRANSITION: NEW ERA)

왼쪽 (팀 쿡): 팀 쿡의 인물 일러스트와 함께 'TEAM COOK', 'CHAIR' (의장)라는 텍스트가 있습니다.

중앙 (화살표): 조직 변화를 상징하는 그래픽 화살표가 팀 쿡에서 존 터너스로 향합니다.

오른쪽 (존 터너스): 존 터너스의 인물 일러스트와 함께 'JOHN TERNUS', 'CEO (2026)'라는 텍스트가 있습니다.

맨 오른쪽: 뇌와 칩 아이콘과 함께 'ENGINEERING & AI FOCUS' (엔지니어링 및 AI 집중)라는 텍스트가 있어 새로운 리더십의 방향성을 보여줍니다.

2. 중앙: 4대 핵심 전략 및 제품군

중앙 부분은 네 개의 세로 구역으로 나뉘어 구체적인 전략을 설명합니다.

구역 1: AI-INTEGRATED HARDWARE (AI가 통합된 하드웨어)

아이콘: AI 로고가 있는 칩, 'AI'가 표시된 아이폰, 아이맥, 아이패드 일러스트.

텍스트:

'APPLE INTELLIGENCE ACROSS DEVICES' (기기 전반의 애플 인텔리전스) (다채로운 원형 로고)

'POWERFUL ON-DEVICE AI' (강력한 온디바이스 AI) (AI 칩 아이콘)

'M4 ULTRA CHIP: 2x NPU' (M4 울트라 칩: 2배 NPU) (M4 칩 아이콘)

구역 2: NEW PRODUCT FRONTIERS (새로운 제품의 지평)

아이콘 및 출시 예정일:

'SMART GLASSES (2026/2027)' (스마트 글래스) (미래형 안경)

'AI AIRPODS (2026)' (AI 에어팟) (카메라와 마이크가 달린 에어팟)

'FOLDABLE IPHONE (2026)' (폴더블 아이폰) (접히는 폰)

'HOME AI HUB (2026)' (홈 AI 허브) (화면이 있는 스마트 디스플레이)

'DESKTOP ROBOT' (데스크톱 로봇) (화면과 로봇 팔)

'VISION AIR (2027)' (비전 에어) (AR/VR 헤드셋)

구역 3: STRATEGIC PARTNERSHIPS & SERVICES (전략적 파트너십 및 서비스)

아이콘: 악수하는 손, 달러 기호가 있는 동전, 스마트폰을 쥔 손.

텍스트:

'EXTERNAL AI MODELS (e.g., GEMINI) FOR SIRI' (시리를 위한 외부 AI 모델(예: 제미나이))

'SERVICES REVENUE GROWTH' (서비스 매출 성장)

'SUBSCRIPTION AI' (구독형 AI)

구역 4: SUSTAINABILITY & PRIVACY (지속가능성 및 프라이버시)

아이콘: 나뭇잎, 재활용 마크, 자물쇠.

텍스트:

'RECYCLED MATERIALS' (재활용 소재)

'CARBON EMISSIONS REDUCTION' (탄소 배출 감소)

'DATA PRIVACY & ON-DEVICE SECURITY' (데이터 프라이버시 및 온디바이스 보안)

3. 하단: 재무, 공급망, 미래 전망

하단은 세 개의 가로 상자로 구성되어 있습니다.

상자 1: FINANCIAL STRENGTH (Q2 2026) (재무적 강점 (2026년 2분기))

그래픽: 상승하는 막대그래프와 화살표.

텍스트:

'$111.2 BILLION REVENUE' (1112억 달러 매출)

'$29.58 BILLION NET INCOME' (295억 8천만 달러 순이익)

상자 2: SUPPLY CHAIN CHALLENGES (공급망 과제)

그래픽: 끊어진 사슬, 공장 일러스트.

텍스트:

'TSMC CHIP SHORTAGES' (TSMC 칩 부족)

'iPhone DELIVERY CONSTRAINTS' (아이폰 배송 제약)

상자 3: FUTURE OUTLOOK (미래 전망)

그래픽: 상승하는 곡선 화살표와 발사되는 로켓.

텍스트:

'NEW GROWTH DRIVERS' (새로운 성장 동력)

'GLOBAL AI COMPETITION' (글로벌 AI 경쟁)

'LONG-TERM ECOSYSTEM EXPANSION' (장기적 생태계 확장)

    핵심 요약

    APPLE은 2026년 현재, 하드웨어 혁신과 AI 통합을 핵심 전략으로 삼아 차기 CEO인 존 터너스의 리더십 아래 새로운 제품 라인업과 AI 서비스 확대를 추진하고 있습니다.


    1. 서론

    2026년 5월 현재, 애플은 전 세계 기술 시장에서 가장 큰 주목을 받고 있는 기업 중 하나이며, 특히 하드웨어와 AI의 융합을 통한 차별화 전략이 강조되고 있습니다. 이번 블로그에서는 최신 보도와 기업 발표를 바탕으로 애플의 전반적인 사업 진행 방향, AI 관련 사업 현황, 신제품 개발 로드맵, 재무 성과, 그리고 향후 과제와 전망을 심층적으로 분석하겠습니다.


    2. 조직 변화와 리더십

    2.1 존 터너스 차기 CEO 선임

    2026년 5월 1일, 애플은 차기 CEO로 하드웨어 엔지니어링 부문 수석 부사장인 존 터너스를 공식 발표했습니다. 터너스는 2001년 입사 이후 애플 실리콘 전환을 주도한 베테랑 엔지니어로, 이번 승진은 단순한 인사 교체를 넘어 애플의 전략적 전환을 상징하는 결정으로 해석됩니다.

    2.2 리더십이 제시하는 비전

    터너스는 “지금은 애플에 특히 설레는 순간”이라며, “우리 앞에 놀라운 계획안이 펼쳐져 있다”고 강조했습니다. 그는 25년 경력 중 가장 흥미진진한 시기라고 밝히며, 새로운 형태의 제품 개발과 AI 통합을 핵심 과제로 제시했습니다.

    2.3 팀 쿡의 역할 전환

    팀 쿡은 CEO 자리에서 물러나면서도 이사회 의장으로 남아 경영 연속성을 보장하고 있습니다. 쿡은 “데이터 프라이버시와 보안”을 애플의 핵심 차별화 요소로 강조했으며, 이는 AI 시대에도 지속될 전략적 기반으로 작용합니다.

    존 터너스가 CEO로 취임하면 애플은 하드웨어 혁신과 온디바이스 AI 통합을 중심으로 전략을 재편하고, 지속가능한 제조와 새로운 제품 라인업을 통해 성장 동력을 재구축할 것으로 예상됩니다.


    2-4. 존 터너스 리더십 배경 및 스타일

    • 엔지니어링 베테랑: 2001년 입사 이후 아이폰·아이패드·맥·에어팟·비전 프로 등 전 제품군의 하드웨어를 총괄해 온 ‘하드웨어통’으로 평가받는다.
    • 차분하고 신중한 리더: 내부에서는 온화한 의사결정자이자 조직 조율 능력이 뛰어난 인물로 평가되며, 권한 위임을 통해 팀의 자율성을 높인다.
    • 전략적 전환점: 애플 실리콘 전환을 주도한 경험을 바탕으로, 하드웨어와 소프트웨어 경계를 허무는 통합 전략을 추진한다.

    2-5. 핵심 전략 변화

    2-5-1. 하드웨어 혁신

    • 성능 중심 전환: 기존 서비스 중심 성장에서 ‘제품·성능 중심’으로 무게중심을 이동, 고성능 맞춤형 칩(M4 Ultra)과 와트당 효율을 극대화한다.
    • 신제품 라인업 확대: 폴더블 아이폰, 스마트 글래스(N50), AI 에어팟, 홈 로보틱스, 스마트 디스플레이(홈패드) 등 새로운 카테고리 개발에 박차를 가한다.

    2-5-2. AI 통합 및 온디바이스 AI

    • 외부 모델 활용: 구글 Gemini를 차세대 Siri에 도입해 음성 인식·대화 능력을 급격히 개선한다.
    • 온디바이스 AI 강화: M4 Ultra 칩에 탑재된 NPU 성능을 2배 이상 향상시켜, 실시간 언어 번역·고해상도 이미지 생성 등 복잡한 AI 작업을 클라우드 없이 기기 내에서 처리한다.
    • 프라이버시 보호: 온디바이스 연산을 통해 사용자 데이터가 외부로 유출되지 않도록 설계, 데이터 프라이버시를 핵심 차별화 요소로 유지한다.

    2-5-3. 지속가능성 및 공급망

    • 친환경 제조: 재활용 소재 확대·에너지 효율 극대화 등 친환경 생산 체제로 전환, 공급망 탄소 배출을 최소화한다.
    • 공급망 리스크 관리: 메모리 칩 부족·지정학적 리스크에 대응해 인도 생산 비중을 25%까지 확대하고, 제조 효율성을 높이는 전략을 추진한다.

    2-5-4. 신제품 로드맵

    제품군예상 출시 시점핵심 특징
    폴더블 아이폰2026년 9월 이후고성능 실리콘·완벽한 품질 검증을 통한 첫 폴더블
    스마트 글래스(N50)2026년 말~2027년 초듀얼 카메라·음성 제어·AI 비서 통합
    AI 에어팟2026년 하반기AI 카메라·음성 인식·온디바이스 AI 연산
    홈패드(스마트 디스플레이)2026년 가을AI 허브·음성 비서·콘텐츠 소비 통합
    가정용 로봇2027년 초AI 기반 이동·페이스타임·가사 보조 기능

    2-6. 재무·시장 전망

    • 2026년 2분기 실적: 매출 1112억 달러(전년 대비 17% 증가), 순이익 295억 8000만 달러 기록.
    • 서비스 부문 성장: 아이폰 매출 569억 9000만 달러, 서비스 매출 309억 8000만 달러로 지속적인 수익원 확보.
    • 투자자 기대: 하드웨어·AI 융합이 성공하면 장기 성장 동력 확보, 반면 AI 경쟁력 회복이 지연될 경우 주가 압박 가능성 존재.

    2-7. 주요 과제와 위험

    과제내용대응 방안
    AI 경쟁력 회복구글·마이크로소프트·오픈AI 대비 뒤처짐외부 모델 활용·온디바이스 AI 강화·자체 AI 역량 구축
    공급망 병목메모리 칩·첨단 공정 부족인도 생산 확대·다변화된 공급망 구축
    조직 운영 경험하드웨어 중심 경력으로 소프트웨어·AI 조직 운영 경험 제한내부 교육·외부 파트너십 확대
    시장 기대 관리폴더블·스마트 글래스 등 신제품에 대한 높은 기대품질 검증·점진적 출시 전략

    존 터너스는 하드웨어 엔지니어링에 깊은 전문성을 갖춘 리더로, 그의 취임은 애플이 ‘제품·성능 중심’ 전략으로 재편되는 신호이다. 온디바이스 AI와 맞춤형 실리콘을 통해 기존 제품군에 AI를 자연스럽게 녹여내고, 폴더블 아이폰·스마트 글래스·AI 에어팟·홈 로봇 등 새로운 하드웨어 카테고리를 확대함으로써 성장 동력을 재구축하려는 움직임이 뚜렷하다. 동시에 AI 경쟁력 회복, 공급망 안정화, 조직 운영 경험 확대 등 해결해야 할 과제가 남아 있다. 이러한 과제를 성공적으로 극복한다면, 애플은 하드웨어와 AI가 결합된 차세대 생태계를 구축해 시장 리더십을 지속할 가능성이 높다.


    3. 사업 진행 방향

    3.1 하드웨어 중심 전략

    터너스 체제는 하드웨어 강점을 기반으로 AI 경험을 강화하는 방향으로 전환하고 있습니다. 애플은 기존 아이폰·맥·아이패드 라인업을 유지하면서, 새로운 폴더블 폰, 스마트 안경, AI 에어팟 등 차세대 하드웨어 제품군을 적극 개발하고 있습니다.

    3.2 AI와 서비스 통합

    애플은 AI 기능을 아이폰·맥·iOS 전반에 통합하고, Siri와 Apple Intelligence를 고도화하고 있습니다. 특히 구글의 Gemini 모델을 차세대 Siri에 도입하는 파트너십을 2026년 1월 체결했으며, 연간 약 10억 달러를 투자하고 있습니다.

    3.3 지속가능성 및 친환경 제조

    터너스는 친환경 소재 사용 확대와 에너지 효율성 극대화를 강조하고 있습니다. 재활용 알루미늄과 저전력 칩 설계 등을 통해 탄소 배출을 최소화하고, 공급망 전반에 책임감 있는 운영을 도입하고 있습니다.


    4. 재무 성과와 시장 반응

    4.1 2026 회계연도 2분기 실적

    애플은 2026년 회계연도 2분기에 매출 1112억 달러(전년 대비 17% 증가)와 순이익 295억 8000만 달러를 기록했습니다. 아이폰 매출은 569억 9000만 달러로 가장 큰 비중을 차지했으며, 서비스 부문 매출은 309억 8000만 달러에 달했습니다.

    4.2 공급망 제약

    아이폰 판매는 첨단 공정 칩 공급 부족으로 제약을 받았으며, 이는 TSMC와의 협력 관계에서 발생한 병목 현상으로 분석됩니다.

    4.3 투자자와 월가의 평가

    주요 투자기관인 JP모건과 모건스탠리는 애플에 대한 긍정적 시각을 유지하고 있으며, 차기 CEO 선임과 AI 전략 발표 이후 주가 상승을 보였습니다. 다만, AI 경쟁력 회복 여부와 하드웨어 중심 전략의 지속 가능성에 대한 우려도 존재합니다.


    5. AI 전략과 기술 로드맵

    5.1 AI 모델 활용 전략

    애플은 자체 대규모 AI 모델 개발보다는 구글 Gemini와 같은 외부 모델을 적극 활용하고 있습니다. 이는 AI 인프라 구축 비용을 절감하고, 빠르게 시장에 AI 기능을 제공하기 위한 전략으로 해석됩니다.

    5.2 온디바이스 AI와 프라이버시

    M4 Ultra 칩셋은 신경망 처리 장치(NPU) 성능을 기존 대비 2배 이상 향상시켜, 온디바이스 AI 연산을 강화하고 데이터 프라이버시를 보호합니다. 실시간 언어 번역, 고해상도 이미지 생성 등 복잡한 AI 작업을 클라우드 없이 기기 내에서 처리할 수 있습니다.

    5.3 AI 기반 새로운 제품군

    • AI 에어팟: 기존 무선 이어폰에 AI 카메라와 음성 제어 기능을 추가한 제품으로 2026년 하반기 출시 가능성이 제시되었습니다.
    • 스마트 글래스: 코드명 N50인 듀얼 카메라와 음성 제어 기능을 갖춘 스마트 안경이 2026년 말 또는 2027년 초에 공개될 예정이며, 2027년 말 이전에 출시가 목표입니다.
    • 스마트 디스플레이(홈패드): 가정용 AI 허브로, 2026년 가을에 공개될 가능성이 높으며, 음성 비서와 콘텐츠 소비 기능을 결합합니다.
    • 데스크톱 로봇: 2027년 출시 목표이며, AI와 로봇 기술을 결합한 새로운 하드웨어 카테고리로 평가됩니다.

    5.4 AI와 서비스 수익화

    애플은 AI 기능을 서비스와 결합해 구독형 AI 서비스(예: Apple Intelligence)와 프라이빗 클라우드 컴퓨팅을 통해 데이터 수익화를 최소화하고, 사용자 경험을 강화하고 있습니다.


    6. 신제품 개발 로드맵

    6.1 웨어러블 부문

    • 스마트 글래스: 2026년 말~2027년 초에 공개, 2027년 말 이전 출시 목표.
    • AI 에어팟: 2026년 하반기 출시 가능성.
    • 클립형 AI 기기: 시리의 시각적 인터페이스 역할을 수행하는 제품으로, 2026년 말에 생산 예정.

    6.2 스마트홈 부문

    • 홈패드(스마트 디스플레이): 2026년 가을 공개 예정, 가정 내 AI 허브 역할.
    • 보안 카메라: AI 기반 영상 분석 기능을 탑재한 제품군 개발 중.

    6.3 차세대 컴퓨팅

    • M4 Ultra 칩셋: 온디바이스 AI 연산을 강화하고, 와트당 성능을 극대화.
    • 프로젝트 키메라: 차세대 실리콘 개발 프로젝트로, 고성능 AI 연산을 목표.

    6.4 폴더블 아이폰 및 AR/VR

    • 폴더블 아이폰: 고가의 폴더블 모델이 2026년 말에 출시될 가능성이 제시되었습니다.
    • AR/VR 헤드셋: 비전 프로의 고가 정책을 보완하기 위해 보급형 ‘Vision Air’가 2027년 2분기에 출시될 예정이며, 무게 감소와 가격 인하가 핵심 포인트입니다.

    7. 시장 환경과 경쟁 구도

    7.1 글로벌 AI 경쟁

    구글, 마이크로소프트, 메타 등 대형 AI 기업에 비해 애플은 AI 모델 규모와 인프라 투자에서 뒤처져 있습니다. 그러나 외부 모델 활용과 하드웨어 통합 전략으로 차별화를 시도하고 있습니다.

    7.2 스마트폰 시장 동향

    전 세계 스마트폰 시장은 2026년에 전년 대비 13% 성장할 것으로 예상되며, 애플은 순 전환율이 증가하는 유일한 브랜드로 평가됩니다. AI 기능이 새로운 고객 유치와 충성도 유지에 기여할 수 있는지 여부가 핵심 과제로 남아 있습니다.

    7.3 경쟁사와의 차별화

    삼성전자는 AI 연산에 필요한 고성능 메모리 반도체 수요 증가로 긍정적인 영향을 받고 있으며, 애플은 AI 웨어러블과 스마트홈 제품군을 통해 차별화된 사용자 경험을 제공하려 하고 있습니다.


    8. 주요 과제와 위험 요소

    8.1 AI 투자 규모

    애플은 AI R&D 비용을 전년 대비 33.6% 확대했지만, 연간 1천억~2천억 달러 규모의 투자와 비교하면 여전히 부족한 편입니다. 이는 AI 경쟁력 회복에 대한 압박을 가중시킵니다.

    8.2 공급망 리스크

    첨단 공정 칩 공급 부족은 아이폰 판매에 직접적인 제약을 초래하고 있으며, TSMC와의 협력 관계에서 발생하는 병목 현상이 지속될 경우, 신제품 출시 일정에도 영향을 미칠 수 있습니다.

    8.3 프라이버시와 데이터 정책

    애플은 데이터 프라이버시를 핵심 가치로 삼고 있지만, 외부 AI 모델 도입이 프라이버시 보호와 어떻게 조화될지에 대한 의문이 제기되고 있습니다.

    8.4 시장 기대와 실제 성과

    WWDC에서 공개될 AI 기능이 실제 사용자 경험에 얼마나 큰 변화를 가져올지에 대한 시장의 기대가 높으며, 기대에 미치지 못할 경우 하드웨어 중심 전략의 지속 가능성에 의문이 제기될 수 있습니다.


    9. 향후 전망

    9.1 AI와 하드웨어 융합

    애플은 AI를 하드웨어에 자연스럽게 녹여내는 전략을 지속할 것으로 보이며, M4 Ultra와 같은 고성능 칩을 기반으로 온디바이스 AI 경험을 강화할 것입니다. 이는 데이터 프라이버시와 빠른 응답성을 동시에 만족시키는 방향입니다.

    9.2 새로운 제품 카테고리

    스마트 글래스, AI 에어팟, 스마트 디스플레이 등 새로운 하드웨어 카테고리는 애플이 아이폰 중심의 성장 구조에서 탈피하고, 생태계 전반을 확장하는 핵심 동력이 될 것입니다.

    9.3 서비스와 구독 모델 확대

    AI 기반 서비스와 구독형 AI 기능을 확대함으로써, 하드웨어 매출 외에도 지속 가능한 수익원을 확보하려는 전략이 강화될 전망입니다.

    9.4 투자자와 시장의 기대

    투자자들은 AI와 하드웨어 결합을 통한 차별화된 사용자 경험이 실현될 경우, 애플의 장기 성장 동력이 강화될 것으로 기대하고 있습니다. 그러나 AI 투자 규모와 공급망 안정성 확보가 핵심 과제로 남아 있습니다.


    10. 결론

    애플은 2026년 현재, 하드웨어와 AI를 결합한 차별화 전략을 통해 새로운 성장 동력을 모색하고 있습니다. 차기 CEO인 존 터너스는 엔지니어링 중심의 리더십을 바탕으로, AI 기능을 온디바이스에 통합하고, 스마트 글래스·AI 에어팟·스마트 디스플레이 등 새로운 제품군을 적극 개발하고 있습니다. 동시에 외부 AI 모델 활용과 프라이버시 보호를 조화시키는 방안을 모색하며, 공급망 리스크와 AI 투자 규모 확대라는 과제에 직면해 있습니다. 이러한 전략이 성공한다면, 애플은 하드웨어 중심의 전통을 유지하면서도 AI 시대에 맞는 혁신적인 사용자 경험을 제공하는 기업으로 재도약할 수 있을 것입니다.


    관련 기사:

    https://news.nate.com/view/20260421n02766?mid=n0105