[태그:] AI에이전트

  • [2026.08.25] 엔비디아 그록3(Groq3) LPX 랙 양산과 AI 반도체 패러다임의 대전환: SRAM vs HBM 구조 분석 및 밸류체인 투자 전략

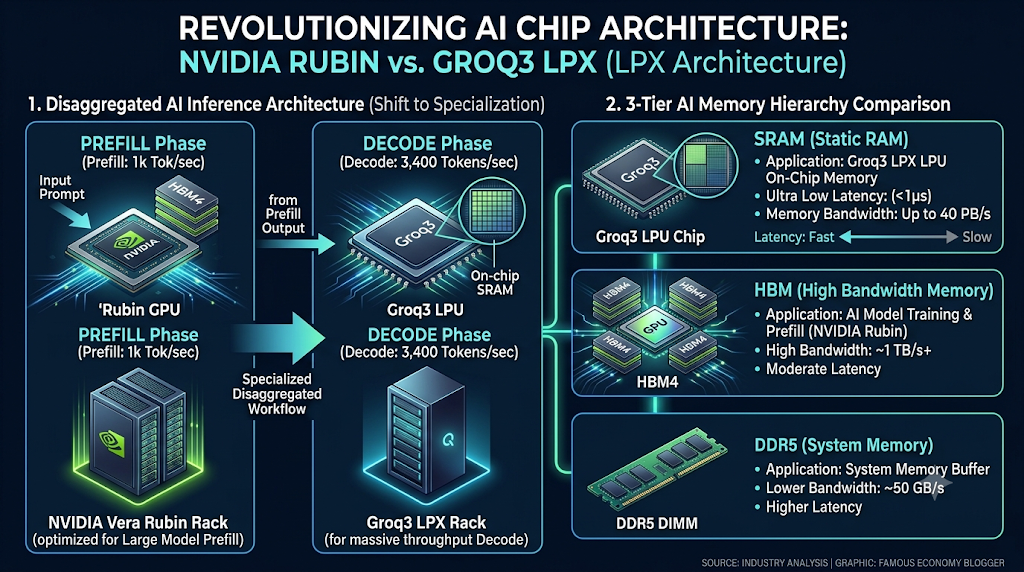
    엔비디아 그록랙 구조
디스어그리게이티드 추론 구조 (Disaggregated AI Inference Architecture)

Rubin GPU (HBM4): 입력 데이터 분석 및 문맥 파악을 전담하는 Prefill 단계

Groq3 LPU (On-chip SRAM): 초당 3,400 토큰 생성을 전담하는 초저지연 Decode 단계

3단계 메모리 계층 구조 비교 (3-Tier Memory Hierarchy)

SRAM: Ultra Low Latency / 40 PB/s Bandwidth (실시간 순차 토큰 생성)

HBM: High Bandwidth / Large Capacity (학습 및 병렬 연산)

DDR5: System Memory Buffer (대용량 KV 캐시 및 백업)

디자인 톤앤매너: 글로벌 테크 및 금융 분야에 어울리는 다크 네이비 & 네온 블루/그린 아키텍처 비주얼로 완성되었습니다.

    📌 엔비디아 그록3 LPX Executive Summary

    1. 역대 최대 라이선스 계약의 상용화: 엔비디아가 200억 달러(약 27조 원) 규모의 라이선스 계약으로 확보한 그록(Groq) 기술 기반 ‘그록3 LPX’ 랙 양산에 돌입했습니다. 네오클라우드 네비우스(Nebius) 데이터센터에 베라 CPU, 루빈 GPU와 함께 첫 배치되며 올해 말 가동됩니다.
    2. 추론 시장의 게임 체인저 (Disaggregated Architecture): 프롬프트 입력(Prefill)은 고성능 GPU(루빈)가, 실시간 응답 토큰 생성(Decode)은 초저지연 SRAM 기반 LPU(그록3)가 분담하는 ‘디스어그리게이티드(분산) 추론’이 본격 적용됩니다.
    3. 압도적인 초저지연 성능: Gemma 4 31B 모델(10만 토큰 컨텍스트) 기준 초당 3,400 토큰을 처리하며, 경쟁사 대비 최대 4배 빠른 반응성을 확보하여 실시간 AI 코딩 및 에이전트 서비스의 핵심으로 부상했습니다.
    4. 투자의 패러다임 변화: ‘GPU + HBM’ 단일 공식에서 벗어나 SRAM, 비메모리 OSAT/테스트, 대면적 FC-BGA 기판, CPO(광반도체), 데이터센터 전력 인프라 중심으로 수혜주 밸류체인이 이동합니다.

    1. 서론: AI 데이터센터 시장의 미세 균열과 대변혁의 시작

    AI 반도체 시장을 수년간 지배해 온 패러다임은 명확했습니다. “더 커다란 GPU에 더 넓은 대역폭의 HBM(고대역폭 메모리)을 부착하여 거대한 단일 클러스터로 묶는다.” 이 공식은 거대언어모델(LLM)의 사전 학습(Training) 및 대규모 컨텍스트 입력 처리에는 최적의 성능을 발휘해 왔습니다.

    하지만 AI 시장의 중심축이 단순 모델 개발과 학습을 넘어 실질적인 상용 서비스, 즉 ‘AI 에이전트(AI Agent)’, ‘실시간 자율 코딩’, ‘초저지연 대화형 AI’ 형태의 추론(Inference) 단계로 빠르게 이동함에 따라 기존 GPU 단일 구조의 치명적인 한계가 드러나기 시작했습니다.

    가장 큰 문제는 바로 ‘디코드(Decode) 단계에서의 메모리 병목 현상’입니다. AI 모델이 응답 토큰을 하나씩 순차적으로 생성할 때, GPU 내부 연산기(ALU)는 일거리가 부족해 노놀 정도로 놀고 있는 반면, 외부 메모리에서 파라미터 가중치를 지속적으로 읽어오는 과정에서 거대한 연산 지연(Latency)이 발생합니다. 이는 곧 서비스 운영 비용의 증가와 사용자 경험의 저하로 직결됩니다.

    이러한 상황에서 글로벌 AI 반도체 대장주인 엔비디아(NVIDIA)가 마침내 파격적인 카드를 꺼내 들었습니다. 지난해 12월 사상 최대 규모인 200억 달러(약 27조 원)를 들여 인수한 초저지연 추론 칩 스타트업 ‘그록(Groq)’의 기술을 마침내 자사의 차세대 데이터센터 플래그십 아키텍처인 ‘베라 루빈(Vera Rubin)’ 플랫폼의 전용 추론 가속 랙인 ‘그록3 LPX(Groq3 LPX)’ 형태로 상용화 및 본격 양산에 들어갔다고 공식 발표했습니다.

    2. 엔비디아의 결단: 200억 달러 거래의 결실, 그록3 LPX 양산 본격화

    엔비디아는 네오클라우드(Neo Cloud) 주요 공급업체인 네비우스(Nebius)의 데이터센터를 시작으로 그록3 LPX 랙 배치를 개시했다고 밝혔습니다. 이번 배치는 엔비디아의 차세대 CPU인 ‘베라(Vera)’ 및 차세대 flagship GPU인 ‘루빈(Rubin)’과 함께 병렬 결합 형태로 이루어지며, 올해 말 본격적인 가동을 앞두고 있습니다.

    엔비디아 최고경영자(CEO) 젠슨 황(Jensen Huang)은 지난 3월 베라루빈 및 그록3 LPX 공개 행사에서 다음과 같이 선언한 바 있습니다.

    “코딩 및 초저지연 애플리케이션을 위해 마련된 데이터센터 공간의 최소 4분의 1(25%)을 그록 랙에 할당하고, 나머지 75%는 100% 베라루빈 NVL72 GPU 시스템으로 채울 것입니다.”

    이는 단순한 단일 칩 세일즈가 아니라 데이터센터 전체 공간과 전력 배분을 철저히 워크로드 성격에 맞춰 재구성하겠다는 의지입니다.

    💡 엔지니어링 인사이트: 왜 네오클라우드 네비우스인가?

    네비우스와 같은 네오클라우드 업체들은 기존 빅테크(Hyperscaler)와 달리 최신 AI 추론 워크로드를 유연하게 수용하고, 토큰당 최고 단가를 매길 수 있는 프리미엄 API 서비스(Token Factory)를 서비스화하는 데 집중합니다. 디온 해리스 엔비디아 AI 인프라 책임자가 언급했듯, 초저지연 토큰 생성 능력은 코딩 에이전트, 실시간 음성 통화 API 등에서 사용자에게 고가의 프리미엄 서비스 요금을 부과할 수 있는 핵심 차별화 요소가 됩니다.

    3. 그록3 LPX 랙의 기술 스펙 및 하드웨어 구성 심층 분석

    엔비디아가 공개한 그록3 LPX 랙의 실제 하드웨어 스펙은 반도체 엔지니어링 관점에서 대단히 파격적인 수치들로 가득 차 있습니다. 정밀 검증된 칩 단위 및 랙 단위의 세부 하드웨어 명세는 다음과 같습니다.

    3.1. LPU 칩 단위 vs LPX 랙 단위 하드웨어 스펙 비교

    그록의 핵심 가속기인 LPU(Language Processing Unit)는 고속 연산 장치와 온칩 SRAM이 1:1로 밀접하게 결합된 특수 목적용 반도체(ASIC)입니다. 1개의 LPU 칩에는 500메가바이트(MB)의 SRAM이 고밀도로 적층되어 있으며, 칩 내부 대역폭은 초당 150테라바이트(TB/s)에 달합니다. 엔비디아는 이 LPU 칩 256개를 단일 LPX 랙 안에 상호 초연결망으로 집적시켰습니다.

    구분 항목칩(LPU) 1개 단위랙(LPX) 전체 (256개 LPU)기술적 의의 및 비고
    SRAM 용량 (On-chip)500 MB128 GB외부 DRAM 경유 없이 칩 내에서 초고속 처리
    SRAM 내부 대역폭150 TB/s40 PB/s (40,000 TB/s)지연시간(Latency)을 피코초(ps) 수준으로 축소
    스케일업(Scale-up) 대역폭2.5 TB/s640 TB/s256개 칩을 단일 논리 메모리로 묶는 상호연결망
    DDR5 보조 시스템 메모리–12 TB대규모 컨텍스트 및 KV 캐시 오프로드 백업용

    ※ 기사에 언급된 “5억 MB SRAM”은 오기이며, 실제 스펙은 칩당 500MB, 랙 전체(256개 칩) 기준 128GB SRAM이 정확한 수치입니다.

    128GB라는 용량이 숫자로만 보면 HBM(수 TB 단위) 대비 작아 보일 수 있으나, 초당 40페타바이트(PB/s)라는 압도적인 대역폭이 조합됨으로써 순차 토큰 생성 속도에서 비교 불가능한 성능을 발휘하게 됩니다.

    3.2. 벤치마크 성능: Gemma 4 31B 및 실시간 작업에서의 성능 혁신

    독립 AI 벤치마크 평가 기관인 아티피셜 애널리시스(Artificial Analysis)의 최신 테스트 결과에 따르면, 그록3 LPX 랙 시스템에서 Gemma 4 31B 모델을 100,000(10만) 토큰의 컨텍스트 환경에서 실행했을 때, 초당 3,400 출력 토큰(Tokens/sec)이라는 처리 속도를 기록했습니다.

    이는 현재 시장에 존재하는 어떠한 동일 규모 GPU 클러스터 랙과 비교해도 최대 4배 이상 빠른 응답성(Responsiveness)입니다. 인간이 1초에 읽을 수 있는 글자 수가 대략 10~20 토큰 수준임을 감안할 때, 초당 3,400 토큰은 인간의 인지 속도를 완전히 초월한 수치이며, 대규모 소스 코드를 실시간으로 분석하고 수정안을 즉시 반환해야 하는 ‘에이전틱 AI 코딩 워크로드’에서 절대적인 위력을 발휘합니다.

    4. 데이터센터 아키텍처의 격변: 디스어그리게이티드(Disaggregated) 추론의 등장

    4.1. 베라 루빈(Vera Rubin) 모듈식 랙 생태계에서의 위치

    그록3 LPX 랙은 독립 제품이 아니라 엔비디아가 새롭게 제시하는 베라 루빈(Vera Rubin) 랙 스케일 토탈 인프라를 구성하는 5가지 핵심 목적별 랙 중 하나로 완벽히 통합 배치됩니다.

    • 베라루빈 NVL72 GPU 랙: 대규모 연산 및 모델 학습, 입력 프리필(Prefill) 전담
    • 베라 CPU 랙: 데이터센터 전체 관리, 오케스트레이션 및 파이프라인 스케줄링
    • 그록3 LPX 추론 가속 랙: 초저지연 디코드(Decode) 및 순차 토큰 생성 전담
    • 블루필드-4 STX 스토리지 랙: 데이터 초고속 I/O 및 보안 오프로드
    • 스펙트럼-6 SPX 이더넷 랙: 랙 간 초고속 데이터 통신 네트워크 제어

    이 시스템을 구동하기 위해 엔비디아는 베라 CPU, 루빈 GPU, NVLink 6 스위치, ConnectX-9 SuperNIC, BlueField-4 DPU, Groq3 LPU, 그리고 실리콘 포토닉스 기반 Spectrum-X CPO 스위치 등 총 7종의 신규 반도체 칩을 동시 양산 체제로 전환시켰습니다.

    4.2. 기존 동종 GPU 클러스터 vs 신규 디스어그리게이티드 구조 비교

    기존 AI 데이터센터는 동일한 동종(Homogeneous) GPU를 촘촘히 배열하고, 이 GPU 클러스터가 입력 데이터 처리(Prefill)와 출력 토큰 생성(Decode)을 순차적으로 모두 수행하는 방식이었습니다.

    🔄 워크로드 분리(Disaggregation)의 핵심 메커니즘

    LLM 추론 워크로드는 크게 두 단계로 나뉩니다.

    1. Prefill (프리필) 단계: 수천~수십만 자의 프롬프트를 한 번에 읽고 컴퓨팅하는 단계. 대규모 병렬 연산력과 고용량 메모리(HBM)가 필수적이므로 루빈 GPU가 전담합니다.
    2. Decode (디코드) 단계: 앞선 문맥을 바탕으로 단어를 한 개씩 순차적으로 생성해 나가는 단계. 연산량 자체는 적지만 매 토큰 생성마다 메모리 가중치를 읽어와야 하므로 초저지연 메모리 대역폭(SRAM)이 핵심입니다. 이를 그록 LPU가 전담합니다.

    기존에는 비싼 HBM과 수천 개의 Tensor core를 갖춘 GPU가 디코드 단계에 묶여 있으면서 메모리 병목 때문에 연산 자원을 90% 이상 놀리는 극심한 비효율이 발생했습니다. 엔비디아는 프리필과 디코드를 물리적인 랙 수준에서 분리하여, “각 작업 특성에 가장 완벽히 부합하는 프로세서와 메모리를 배치하는 분산 아키텍처”로 변혁을 완료했습니다.

    5. 메모리 반도체 3대 매체(SRAM vs HBM vs DDR5)의 역할 및 특성 비교

    AI 가속기에 사용되는 대표적인 3가지 메모리 반도체 매체의 물리적·구조적 차이점을 이해해야 향후 반도체 주식 투자의 방향성을 잡을 수 있습니다.

    구분 항목SRAM (Static RAM)HBM (High Bandwidth Memory)DDR5 (System DRAM)
    시스템 내 주요 역할LPU 온칩 초저지연 캐시/메모리GPU 대규모 병렬 연산 메인 메모리랙 단위 대용량 KV 캐시 보조 버퍼
    적용 시스템 예시그록3 LPX (칩당 500MB / 랙당 128GB)루빈, 블랙웰 NVL72 GPU 등그록3 LPX 랙 (랙당 12TB)
    대역폭 (Bandwidth)극상 (랙당 40 PB/s)상 (초당 수 TB/s 수준)중 (초당 수백 GB/s 수준)
    지연시간 (Latency)최저 (수 피코~나노초 이하)보통 (DRAM 특성상 SRAM보다 느림)높음 (버스 통신 지연 존재)
    비용 및 단가극도로 비쌈 (트랜지스터 6개/Bit)고가 (TSV 적층 및 첨단 패키징)상대적 저렴 (면적 대비 용량 큼)
    집적도 및 용량 한계매우 낮음 (칩당 MB 단위 제한)높음 (수십~수백 GB 단위)극대 (TB~PB 단위 확장 용이)

    5.1. SRAM: 그록 LPU의 초저지연을 가능케 하는 무기

    SRAM은 1비트의 데이터를 저장하는 데 6개의 트랜지스터(6T)를 사용합니다. 전원이 공급되는 동안 커패시터 재충전(Refresh) 동작이 필요 없으므로 반응 속도가 비약적으로 빠릅니다. 그록 LPU는 외부 메모리 인터페이스를 거치지 않고, 칩 내부(On-chip) 연산기 바로 옆에 SRAM을 배치하여 데이터 전송 지연시간을 제로에 가깝게 줄였습니다.

    단점은 셀 면적이 너무 커서 칩 하나의 실리콘 다이에 탑재할 수 있는 용량이 500MB 수준에 불과하다는 점입니다. 엔비디아와 그록은 이 한계를 256개의 칩을 640TB/s 초고속 초연결 망(Scale-up Interconnect)으로 묶어 랙 전체를 하나의 128GB 대형 논리 SRAM 풀로 구현함으로써 극복했습니다.

    5.2. HBM: 여전한 학습 및 대규모 데이터의 왕좌

    HBM은 DRAM 다이를 수직으로 8층, 12층, 16층 쌓아 올린 후 TSV(관통실리콘비아)로 연결한 초고속 메모리입니다. 대용량 파라미터를 한 번에 올려놓고 병렬 연산을 퍼부을 수 있어 학습(Training)과 대규모 프롬프트 입력(Prefill)에는 대체 불가능한 핵심 매체입니다. 그러나 DRAM의 근본적인 한계인 억세스 레이턴시(Latency)가 존재하므로, 토큰을 1개씩 만들어내는 순차 디코드 과정에서는 대역폭 소모 대비 효율이 급격히 떨어지는 현상이 발생합니다.

    5.3. DDR5: 대용량 백업 스토리지 및 파라미터 오프로드

    그록3 LPX 랙에 설치된 12TB의 DDR5는 실시간 토큰 생성에 직접 참전하기보다는, 128GB SRAM 범위를 넘어서는 대규모 모듈 가중치나 이전 대화 문맥(KV Cache) 데이터를 임시 보존하고 필요시 SRAM으로 고속 교체(Swapping)해 주는 백업 창고 역할을 담당합니다.

    6. 빅테크 진영 간 랙 단위(Rack-Scale) 아키텍처 대격돌: 엔비디아 vs AMD

    AI 반도체 전쟁은 단품 칩 판매에서 데이터센터 전체를 랙 단위로 패키징하여 공급하는 ‘랙 스케일 시스템 경쟁’으로 격화되었습니다. 특히 AMD 역시 반도체 스타트업 세레브라스(Cerebras)와 손을 잡고 이에 강력히 맞서고 있습니다.

    비교 항목엔비디아 연합 (Vera Rubin NVL72 + Groq3 LPX)AMD + 세레브라스 연합 (Helios + CS-4 랙)
    핵심 칩 구성Rubin GPU 72개 + Vera CPU 36개 + Groq3 LPU 256개MI300X/MI350X GPU 랙 + Cerebras CS-4 (WSE-3T) 3개
    온칩 SRAM 용량128 GB (Groq LPX 랙 기준)132 GB (CS-4 랙 기준)
    SRAM 대역폭40 PB/s (초당 40,000 TB)129.6 PB/s (초당 129,600 TB)
    HBM 총 용량 및 대역폭20.7 TB (HBM4) / 1,580 TB/s13.8 TB ~ 20.7 TB (HBM3e/4) / 380~580 TB/s
    DDR5 확장성12 TB (랙 내부 버퍼)최대 1.2 PB (MemoryX 단일 주소 매핑)
    상용화 실사례 및 속도네비우스 (초당 3,400 토큰 / Gemma 4 31B)오픈AI 울트라패스트 모드 (초당 750 토큰)

    6.1. SRAM 대역폭 관점에서의 분석

    AMD와 세레브라스 연합은 거대한 단일 실리콘 웨이퍼 전체를 하나의 칩으로 만드는 ‘웨이퍼 스케일 엔진(WSE-3T)’을 사용합니다. 수치상 SRAM 대역폭이 129.6 PB/s에 달해 엔비디아+그록(40 PB/s)을 앞섭니다. 하지만 세레브라스 방식은 단일 웨이퍼 수율 문제와 수리성, 열관리 난이도가 극도로 높습니다. 반면 엔비디아+그록 조합은 모듈식 디스어그리게이션 구조를 채택하여 생산 수율과 인프라 확장성, NVLink 수평 생태계와의 통합 운용성에서 훨씬 뛰어난 고객 편의성을 제공합니다.

    6.2. HBM 대역폭 관점에서의 분석

    학습 및 대규모 가중치 처리의 핵심인 HBM 대역폭에서는 차세대 HBM4를 선제 적용한 엔비디아 베라 루빈(1,580 TB/s)이 AMD 헬리오스 랙을 큰 폭으로 앞서고 있습니다. 결국 두 공룡 모두 “HBM(대용량) + SRAM(초저지연) + DDR5(백업)”라는 3단계 하이브리드 메모리 아키텍처로 수렴하고 있음을 확인할 수 있습니다.

    7. 파운드리 및 공급망(Supply Chain)의 구조적 재편

    엔비디아의 그록3 LPX 랙 상용화는 반도체 파운드리 생태계에도 거대한 지각변동을 일으키고 있습니다. 바로 파운드리 이원화(Dual Sourcing)입니다.

    🌐 공급망 리스크 분산 전략

    기존 엔비디아의 주력 GPU(블랙웰, 루빈)는 전량 대만 TSMC의 첨단 공정과 CoWoS 패키징에 의존하고 있습니다. 그러나 그록3 LPU 칩은 삼성전자 파운드리(평택/테일러 4nm 공정)가 전량 생산을 맡고 있습니다. 엔비디아는 M&A 및 기술 라이선스 방식을 통해 포트폴리오를 다변화하는 동시에, TSMC에 몰려 있던 첨단 공정 병목 리스크를 삼성전자 파운드리로 분산시키는 고도의 전략을 펼치고 있습니다.

    이는 삼성전자 파운드리 사업부에 단비와 같은 가동률 상승 및 기술 검증의 기회를 제공하며, 대만 외 지정학적 리스크에 대비하려는 글로벌 빅테크들에게 매우 중요한 이원화 이정표가 될 것입니다.

    8. 유명 경제 블로거의 투자 가이드: 수혜주 심층 분석 및 포트폴리오 전략

    주식 투자 관점에서 엔비디아의 그록3 LPX 양산 소식은 명확한 시그널을 던지고 있습니다. 기존 “AI 반도체 = 무조건 HBM 관련주”라는 단순한 투자의 공식이 깨지고 있다는 점입니다.

    8.1. 단기적 관점 (6개월 ~ 1년): 확실한 밸류체인 직수혜주 모멘텀

    단기적으로는 모멘텀이 확실한 파운드리 디자인하우스, 고다층 PCB, FC-BGA 기판, 비메모리 OSAT 및 전력 인프라 기업으로의 수급 쏠림이 가시화될 것입니다.

    ① 삼성전자 파운드리 생태계 (DSP / 디자인하우스)

    • 삼성전자 (005930): 그록3 LPU 4나노 위탁생산을 전담하며 파운드리 가동률 상승 및 턴어라운드 계기 마련. 초기 그록 지분 투자자로서 투자 자산 가치 재평가 유효.
    • 가온칩스 / AD테크놀로지 / 세미파이브: 삼성 파운드리 핵심 DSP 라인업으로, 글로벌 빅테크들의 추론용 ASIC 및 LPU 개발 주문 증가에 따른 직접적 실적 수혜.

    ② 고다층 PCB 및 고부가가치 패키지 기판 (FC-BGA)

    • 이수페타시스 (007660): 랙 단위 초고속 통신(Spectrum-6, NVLink) 가동에 따라 초고다층 MLB(Multi-Layer Board) PCB 수요 폭발.
    • 삼성전기 (009150): SRAM 기반의 초고밀도 다이가 256개 탑재되는 LPX 랙 및 베라루빈 랙용 대면적, 고층수 FC-BGA 공급 확대로 강력한 리레이팅 기대.

    ③ 비메모리 OSAT 및 특화 테스트 소켓

    • ISC (095070) / 리노공업 (058470) / 두산테스나 (131970): 기존 HBM 단순 메모리 검사 장비와 달리, 고주파·저지연 LPU/ASIC 칩을 검사하기 위한 초고속 테스트 소켓 및 외주 테스트(OSAT) 수요 급증.

    ④ 데이터센터 전력 및 신호 인프라

    • HD현대일렉트릭 (267260) / LS ELECTRIC (010120): 랙당 전력 소모량이 수십~수백 kW 단위로 폭증함에 따라, 반도체 아키텍처 변혁과 무관하게 강력한 단기 및 중기 실적 모멘텀 유지.

    8.2. 중장기적 관점 (1년 ~ 3년): AI 시장 재편에 따른 전략적 엑시트 & 재배치

    구분주요 대상 종목 / 분야중장기 영향 및 대응 투자 전략
    기존 HBM 독점 밸류체인SK하이닉스, 한미반도체 등[리스크 관리] HBM 수요가 당장 줄지는 않으나, “HBM 없이는 AI가 불가능하다”는 고평가 프리미엄 약화. 반등 시 비중 축소 전략 유효.
    첨단 패키징 & CPO (광반도체)에스티아이, 이오테크닉스, 제너셈 등[비중 확대] 랙당 640TB/s ~ 129.6PB/s 대역폭 감당을 위한 실리콘 포토닉스(CPO) 및 2.5D/3D 패키징 장비 필수화.
    ASIC 파운드리 & IP삼성전자 파운드리 및 가온칩스[비중 확대] 빅테크들의 자체 ASIC 및 추론용 LPU 채택 확대에 따른 TSMC 대안으로서의 가치 상승.

    8.3. 모델 포트폴리오 가이던스 (Portfolio Allocation)

    📊 추천 포트폴리오 비중 배분

    • 단기 트레이딩 섹터 (비중 30~40%): 삼성전기, 이수페타시스, ISC, 가온칩스 중심 구성. 엔비디아 및 AMD의 랙 양산 가동 실적 및 네비우스 데이터센터 매출이 가시화되는 시점까지 주가 모멘텀 극대화 전략.
    • 중장기 롱(Long) 섹터 (비중 40~50%): 삼성전자(메모리 단점 상쇄 및 파운드리 대반격 수혜), HD현대일렉트릭/LS ELECTRIC(전력망 독점력).
    • HBM 편중 종목 리스크 헤지 (비중 10~20% 축소 유도): HBM 단일 모멘텀으로 PBR 멀티플이 과도하게 상승한 고평가 장비주는 실적 발표 시점마다 이익 실현 후 비메모리/ASIC 테스터 및 CPO 수혜주로의 교체 매매 권장.

    9. 결론: AI 반도체 2.0 시대, 투자자가 가져야 할 자세

    엔비디아의 그록3 LPX 랙 본격 양산 선언은 단순한 신제품 출시 뉴스에 그치지 않습니다. 이는 AI 반도체 시장이 ‘GPU 단일 독주 시대(AI 1.0)’에서 ‘이종 가속기 결합 및 디스어그리게이티드 추론 시대(AI 2.0)’로 완벽히 진화했음을 알리는 거대한 분수령입니다.

    입력 데이터 처리(Prefill)와 출력 토큰 생성(Decode)이 분리되고, HBM과 SRAM, DDR5가 각자의 위치에서 최적의 연산 효율을 극대화하는 시대입니다.

    투자자 여러분 역시 과거의 성공 방정식이었던 “HBM 일변도” 관성에서 벗어나, 초저지연 SRAM 생태계, 대면적 FC-BGA 기판, 비메모리 특화 테스트 소켓, 그리고 CPO 및 전력 인프라라는 차세대 밸류체인으로 유연하게 시선을 넓혀야 할 때입니다.

    변화의 흐름을 가장 먼저 읽고 하드웨어 구조의 본질을 파악하는 자만이 거친 기술주의 파도 속에서 지속 가능한 압도적 수익률을 쟁취할 수 있을 것입니다.

    관련 기사:
    https://n.news.naver.com/mnews/article/293/0000089490

  • [2026.07.20] 2026년 7월 글로벌 AI 지형도: 미·중 8대 프런티어 LLM모델 기술 구조와 자본시장 투자 가이던스

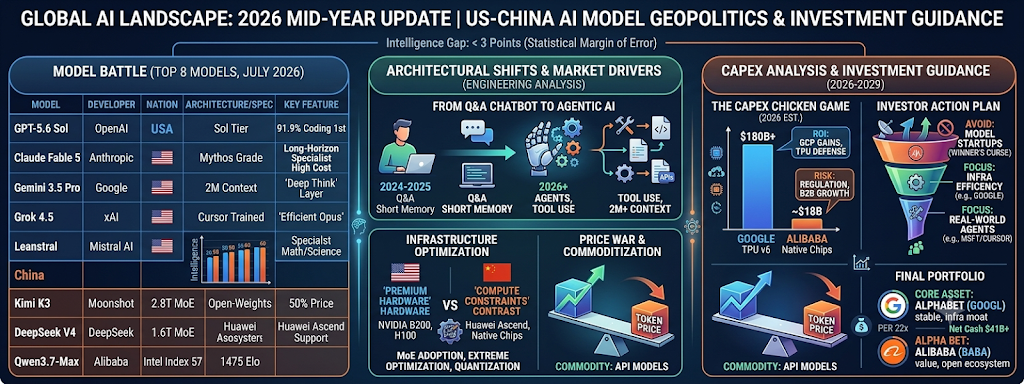
    LLM Model Battle (Top 8 AI Models): Compares key USA and China models, highlighting that while the West (led by Sol and Fable 5) holds a slight edge in reasoning and coding, China (led by Kimi K3 and Qwen3.7-Max) has closed the gap to within 3 AI Intelligence Points using MoE architecture and price wars.

Architectural Shifts: Explains the move from simple Q&A to Agentic AI and the rise of massive 2M+ context windows. It illustrates the hardware battle between NVIDIA GPUs and Google TPUs against China's optimization on native chips like Huawei Ascend.

Investment Guidance (2026-2029): Provides a financial outlook, labeling model development as high-risk ("The Winner's Curse") while advising focus on "Infrastructure Efficiency Leaders" (Google) and "Real-World Agents" (Microsoft/GitHub). It also provides a core vs. alpha stock comparison.

    2026년 7월 현재, 글로벌 LLM 인공지능(AI) 산업은 그 어떤 시기보다 격렬한 패러다임 전환기를 통과하고 있습니다. 지난 7월 17일 상하이 세계인공지능대회(WAIC)에서 문샷AI(Moonshot AI)가 전격 공개한 키미 K3(Kimi K3)는 서구권 빅테크 중심의 독점 체제에 거대한 균열을 일으켰습니다. 키미 K3가 보여준 벤치마크 점수는 OpenAI의 최고 존엄이라 불리던 GPT-5.6 솔(Sol) 및 앤트로픽의 클로드 페이블5(Claude Fable 5)와 사실상 오차 범위 내에서 대등한 수준입니다.

    불과 1년 전만 하더라도 미국과 중국의 프런티어 LLM AI 모델 격차는 최소 8개월에서 12개월 이상 벌어져 있다는 것이 지배적인 진단이었습니다. 그러나 하드웨어 공급 규제라는 극단적인 매크로 환경 속에서 중국 진영이 보여준 ‘독한 최적화’와 소프트웨어 아키텍처의 도약은 시장의 예측을 비웃듯 그 격차를 완전히 좁혀버렸습니다.

    본 포스팅에서는 단순한 리더보드 점수 비교를 넘어, 1) 각 모델별 하드웨어 및 소프트웨어 아키텍처 디테일, 2) 미·중 격차가 좁혀진 진짜 공학적 배경, 3) 에이전트화와 초장문 컨텍스트가 가져온 메모리 인프라의 혁신, 4) 거대 테크 기업들의 재무제표(CAPEX 및 FCF) 분석을 통한 자본시장 투자 가이던스까지 테크 산업의 엔지니어와 글로벌 성장주 투자자 모두에게 명확한 이정표가 되기를 바랍니다.

    1. 2026년 7월 현재 미·중 8대 AI 모델 지형도 및 세부 스펙 분석

    현재 글로벌 LLM(대형 언어 모델) 시장을 선도하는 미국 진영 5개 모델과 이에 맞서는 중국 진영 3개 모델의 핵심 특징 및 기술적 포지셔닝을 일목요연하게 정리해 드리겠습니다.

    [미국 진영 5대 프런티어 모델]

    모델명개발사 / 국가아키텍처 및 핵심 스펙 특성비즈니스 모델 및 가격 전략
    GPT-5.6 솔 (Sol)OpenAI / 미국최고 난도 추론 특화형. 3단 멀티 티어 구조의 최상위 라인업. Terminal-Bench 2.1 코딩 벤치마크 91.9%로 세계 1위 기록.Sol · Terra · Luna 3단 가격 공세. 프리미엄 추론 시장의 독점적 지위 유지를 위한 고가 정책 적용.
    클로드 페이블5 (Fable 5)Anthropic / 미국Mythos급 최상위 아키텍처. 긴 호흡의 작업(Long-horizon tasks) 및 다중 파일 소스코드 맥락 이해에 최적화.고품질 텍스트 및 무오류 코딩 강점. 대신 GPT-5.6 솔 대비 API 단가가 약 2배 수준으로 가장 비쌈.
    제미나이 3.5 프로 (Gemini 3.5 Pro)Google / 미국200만 토큰(Token)의 압도적인 초장문 컨텍스트 윈도우 제공. 백그라운드 추론 레이어 ‘Deep Think’ 탑재 예고 (7월 중 정식 출시 예정).구글 클라우드 인프라(TPU v5p/v6)와 수직 통합. 안드로이드 및 구글 워크스페이스 에이전트 생태계 연동 중심.
    그록 4.5 (Grok 4.5)xAI / 미국최상위 엔지니어링 툴인 ‘커서(Cursor IDE)’ 개발 환경 데이터 공동 학습 적용. 실전 코딩 에이전트에 최적화.‘앤트로픽 오퍼스(Opus)급 성능을 더 싸게’라는 슬로건을 바탕으로 비용 효율성을 강조하는 틈새 프리미엄 전략.
    리스트랄 등 특화형 (Leanstral)Mistral AI / 프랑스수학적 정리 증명, 정밀 물리/화학적 추론 등 특정 하드코어 학술 도메인에 극도로 파인튜닝된 경량 모델 계열.오픈소스 배포 및 로컬 서버 구축(On-Premise) 무료 전략. 범용 LLM 체제와의 전면전 대신 틈새시장 공략.

    [중국 진영 3대 추격 모델]

    모델명개발사 / 국가아키텍처 및 핵심 스펙 특성비즈니스 모델 및 가격 전략
    키미 K3 (Kimi K3)문샷AI (Moonshot) / 중국2조 8,000억 파라미터 규모의 초거대 MoE(Mixture of Experts) 아키텍처. 완전한 오픈웨이트(Open-weights) 모델로 공개.100만 토큰당 입력 $3 / 출력 $15 선언. 미국 프리미엄 모델(GPT-5.6 솔 등) 대비 정확히 50% 수준의 비용 파괴.
    딥시크 V4 (DeepSeek V4)딥시크 (DeepSeek) / 중국1조 6,000억 파라미터 MoE. 화웨이 어센드(Ascend) AI 칩셋 기반 추론 및 다중 분산 클러스터링 공식 지원.중국 내수 엔터프라이즈 시장의 인프라 마진 제로 선언. 서구권의 하드웨어 공급 규제를 정면 돌파하는 가성비 공세.
    큐원 3.7 맥스 (Qwen3.7-Max)알리바바 (Alibaba) / 중국인텔리전스 인덱스 57점 기록. LMSYS 챗봇 아레나(Chatbot Arena)에서 약 1,475 Elo 레이팅 달성하며 글로벌 공개 리더보드 최상위권 장악.알리바바 하이브리드 클라우드 인프라 고객을 위한 대규모 할인 혜택 연계. 아시아 및 오픈소스 생태계 플랫폼 선점 전략.

    2. 아키텍처와 인프라의 관점: 미·중 격차가 좁혀진 진짜 공학적 배경

    Artificial Analysis가 발표한 최신 지능 지수 종합 데이터를 보면 상위권 4개 모델의 격차가 극도로 압축되어 있음을 알 수 있습니다. 클로드 페이블5(60점), GPT-5.6 솔(59점), 키미 K3(57점), 큐원 3.7 맥스(57점)의 점수 차이는 단 3점 안쪽입니다. 통계적 오차 범위를 고려하면 사실상 일반적인 비즈니스 환경에서 인간이 체감하는 지능의 차이가 사라졌음을 뜻합니다.

    미국의 엔비디아 H100, B200 인프라 공급 차단이라는 거대한 장벽 앞에서도 중국 진영이 이러한 성능 대등을 이뤄낼 수 있었던 공학적 비결은 크게 두 가지 혁신에 기인합니다.

    2.1. MoE(Mixture of Experts) 아키텍처의 극단적 고도화

    중국 문샷AI의 키미 K3(2조 8,000억 파라미터)와 딥시크 V4(1조 6,000억 파라미터)가 보여주는 괴물 같은 성능과 비용 효율성의 핵심은 혼합 전문가(MoE) 아키텍처의 대중화 및 튜닝 기법의 고도화입니다.

    기존의 덴스(Dense) 모델은 질문의 난이도나 도메인에 상관없이 텍스트를 생성할 때 모든 파라미터를 활성화하여 거대한 연산 연산을 수행해야 했습니다. 반면, MoE 아키텍처는 모델 내부에 코딩 전문가, 수학 전문가, 문학 전문가, 법률 전문가 등 세분화된 ‘전문가 방(Expert Networks)’을 수십에서 수백 개 단위로 쪼개어 배치합니다. 그리고 라우팅 네트워크(Gating Network)가 입력된 프롬프트를 실시간으로 분석하여 가장 적합한 2~3개의 전문가 방만 활성화합니다.

    • 엔지니어링 리얼리티: 키미 K3의 전체 모델 크기는 2조 8,000억 파라미터에 달하지만, 실제 추론(Inference) 시 토큰당 연산량(FLOPs)은 수백억 파라미터 수준으로 다이어트됩니다. 전체적인 지식 저장 용량(Capacity)은 극대화하되, 실시간 계산 비용을 줄임으로써 “미국 프리미엄 모델 대비 50% 저렴한 100만 토큰당 입력 3달러”라는 파괴적인 단가를 실현할 수 있었던 것입니다.

    2.2. 하드웨어 제약이 만든 ‘독한 최적화(Ruthless Optimization)’

    미국의 첨단 AI 반도체 수출 규제는 중국 엔지니어들에게 물리적 한계를 극복해야만 하는 극단적인 생존 환경을 제공했습니다. 엔비디아의 초고대역폭 메모리(HBM3e)와 고속 인터커넥트 인프라(NVLink)를 자유롭게 쓸 수 없는 상황에서, 중국 진영은 화웨이 어센드(Ascend) 칩과 같은 자국산 하드웨어의 떨어지는 사양을 소프트웨어 최적화로 정면 돌파했습니다.

    • 커스텀 커널과 양자화(Quantization)의 한계 돌파: 하드웨어의 메모리 대역폭이 부족하면 칩 간 데이터를 주고받을 때 통신 병목(Communication Overhead)이 발생합니다. 중국 엔지니어들은 연산 정밀도를 유연하게 조절하는 고도화된 FP4/FP8 양자화 기술을 적용하고, 데이터 전송을 최소화하는 하위 레벨의 커스텀 CUDA/어센드 커널을 직접 개발했습니다.
    • 미국 빅테크가 엔비디아의 막강한 하드웨어 위에서 다소 여유롭고 거대한 모델을 돌릴 때, 중국은 한정된 칩셋 안에서 연산 레이어를 수십 번 쪼개고 재정렬하는 독한 최적화를 가했습니다. 그 인프라적 제약의 결과물이 2026년 7월 현재 ‘점수 상의 대등함’이라는 충격적인 지표로 발현된 것입니다.

    3. 미국 모델들의 기술적 엣지: 프리미엄 단가의 정당성 분석

    중국 진영의 오픈웨이트 공세가 거세지만, 코딩(Coding) 영역과 장기 작업(Long-horizon tasks) 분야에서는 여전히 GPT-5.6 솔과 클로드 페이블5가 확고한 기술적 우위를 점하고 있습니다. 기업들이 2배 가까이 비싼 API 비용을 지불하면서도 미국 프런티어 모델을 고집하는 데에는 명확한 공학적 이유가 존재합니다.

    3.1. 추론 레이어(Deep Think)와 ‘생각의 트리(Tree of Thoughts)’

    OpenAI의 GPT-5.6 솔과 구글 제미나이 3.5 프로의 ‘Deep Think’ 시스템은 LLM이 단순히 이전 토큰을 기반으로 다음 단어를 확률적으로 찍어내는 예측 모델(Next-Token Prediction)에서 벗어났음을 보여줍니다. 이들은 백그라운드에서 인간의 심층 사고 과정을 모방하는 알고리즘을 수행합니다.

    1. 자기 교정(Self-Correction) 루프: AI가 생성한 첫 번째 중간 결과물을 스스로 검증하고, 문법적 오류나 논리적 모순이 발견되면 백트래킹(Backtracking)하여 코드를 전면 수정합니다.
    2. 실행 가이드 추론(Execution-guided Reasoning): 특히 Terminal-Bench 2.1 코딩 벤치마크에서 GPT-5.6 솔이 91.9%로 1위를 할 수 있었던 비결은 내부 가상 환경에서 코드를 직접 컴파일 및 빌드해 보고, 발생하는 에러 로그를 분석하여 무오류의 최종 코드를 출력하는 고차원 파이프라인을 태우기 때문입니다.

    코딩은 단 하나의 오타(Syntax Error)로도 대규모 시스템 전체를 다운시킬 수 있는 0과 1의 세계입니다. 미국 모델들은 추론 단계에서 훨씬 더 많은 컴퓨팅 자원(Compute-at-Inference)을 소모하며 안정성을 확보하기 때문에 가격은 비싸지만 품질 오차가 허용되지 않는 전문직 업무와 핵심 아키텍처 설계 영역을 독점하고 있습니다.

    4. 에이전트화와 200만 토큰: 메모리 아키텍처의 혁신

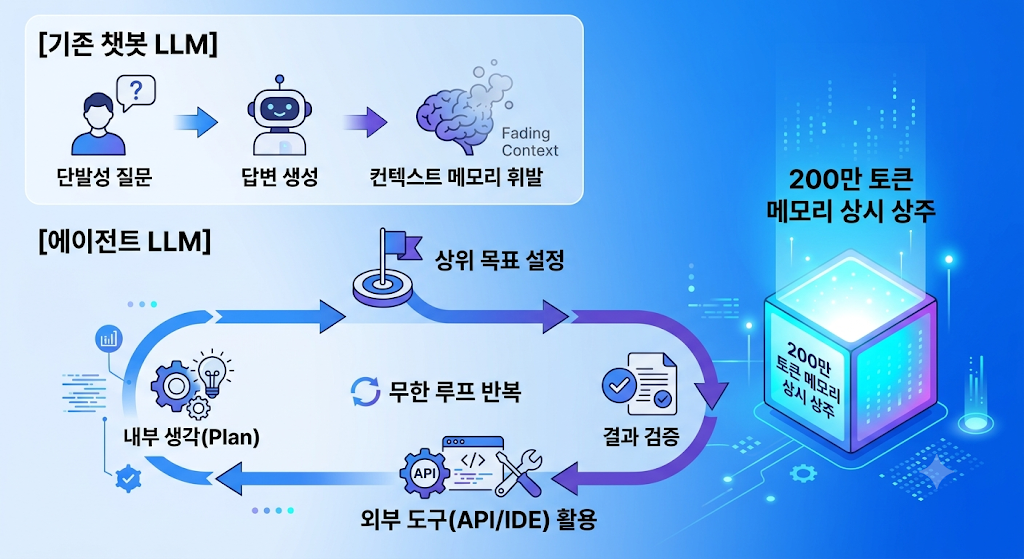
    2026년 하반기 AI 트렌드의 핵심 키워드는 단연 “에이전트화(Agentic AI)”와 “초장문 컨텍스트(Ultra-long Context)”입니다. 이는 인공지능이 단순한 질의응답 챗봇에서 벗어나 실제 인간의 업무를 위임받아 수행하는 독립적 주체로 진화하고 있음을 뜻합니다. 하드웨어 시스템 측면에서 보면, 이는 결국 VRAM(비디오 램) 관리 기술과 메모리 병목의 혁신입니다.

    4.1. 단발성 LLM과 에이전트 LLM의 메커니즘 차이

    에이전트가 정상적으로 작동하려면 수십 개의 소스코드 파일, 데이터베이스 스키마, 과거 실행 로그가 수 시간 동안 AI의 기억 장치에 지워지지 않고 유지되어야 합니다.

    • 구글 제미나이 3.5 프로의 200만 토큰 제어 기술: 책 한 권이나 대기업의 거대한 코드베이스 전체를 컨텍스트 윈도우에 집어넣는 행위는 천문학적인 KV 캐시(Key-Value Cache) 메모리 소모를 유발합니다. 구글은 이를 해결하기 위해 자체 TPU v5p 및 v6 클러스터의 초고속 인터커넥트 인프라 위에, 대규모 컨텍스트 연산을 분산처리하는 ‘링 어텐션(Ring Attention)’ 소프트웨어 아키텍처를 결합했습니다. 메모리 병목을 하드웨어와 하위 소프트웨어 레벨에서 동시에 해결한 구글만의 독점적 엣지입니다.
    • xAI 그록 4.5와 커서(Cursor)의 결합: xAI가 코딩 에이전트 플랫폼인 커서와 데이터셋 단계부터 공동 학습을 진행한 것은 매우 전략적인 선택입니다. 에이전트가 IDE 내부의 파일 디렉토리 구조, 린터(Linter) 에러, 버전 관리 시스템(Git)의 컨텍스트를 인간 엔지니어처럼 유기적으로 이해하도록 미세조정(Fine-tuning)했기 때문에, 실전 배포 환경에서 압도적인 작업 성공률을 보여줍니다.

    5. 하이브리드 멀티 모델 아키텍처의 도래와 인프라 설계

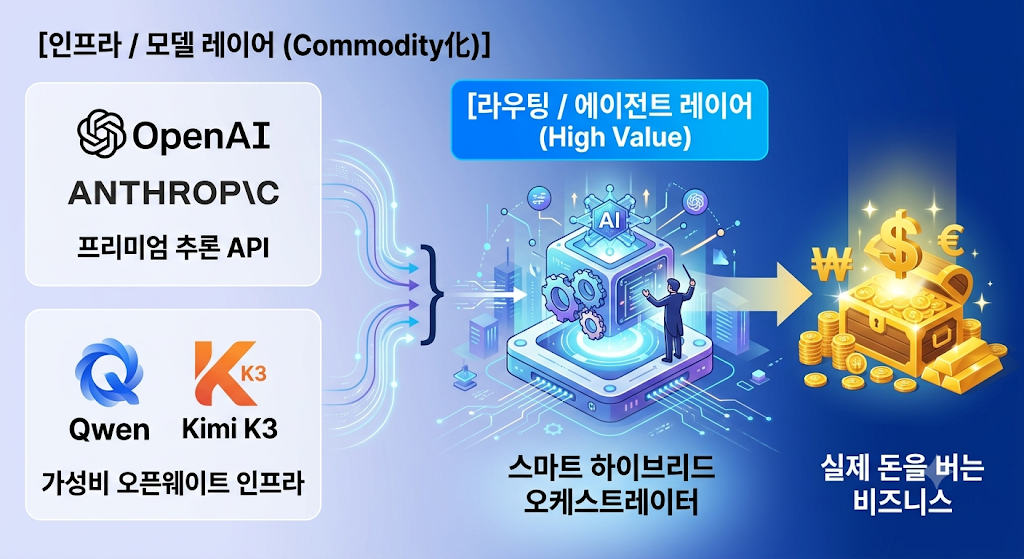
    이처럼 모델들의 특성과 장단점이 명확하게 갈리기 때문에, 2026년 하반기 엔터프라이즈 인프라 설계는 단일 모델을 고집하는 형태에서 벗어나 비용과 효율을 최적화하는 ‘스마트 하이브리드 라우팅 아키텍처’로 수렴하고 있습니다.

    [기업용 AI 시스템의 계층별 모델 라우팅 가이드]

    시스템 계층 (Layer)담당 핵심 업무추천 최적 모델공학적·비즈니스적 선택 이유
    최상위 추론 및 아키텍처핵심 비즈니스 로직 설계, 고난도 시스템 디버깅, 글로벌 규제 및 데이터 거버넌스 준수클로드 페이블5, GPT-5.6 솔복잡한 예외 처리가 필요한 10%의 핵심 영역에서 무오류 연산 및 데이터 보안 안정성 확보.
    대량 데이터 및 에이전트 파이프라인수만 라인의 코드 리팩토링, 실시간 대규모 로그 분석, 일상적인 백엔드 데이터 반복 처리키미 K3, 큐원 3.7 맥스오픈웨이트 모델을 자사 온프레미스(On-Premise) 또는 프라이빗 클라우드에 올려 데이터 유출을 막고 API 단가를 50% 절감.
    도메인 특화 엔지니어링임베디드 펌웨어 검증, 특정 학술/물리 데이터 처리, 수학적 증명 연산미스트랄 계열 (Leanstral 등)가볍고 날카로운 경량화 모델을 특정 도메인 데이터셋으로 파인튜닝하여 초고속 추론(Low-Latency) 성능 달성.

    6. 자본시장의 눈으로 바라본 AI 패러다임 전환기 투자 가이던스

    이제 기술적 분석을 바탕으로 자본시장에서 돈이 어디로 몰리고 있으며, 어떤 기업이 진짜 경제적 해자(Economic Moat)를 지니고 살아남을지 투자 관점에서 냉정하게 짚어보겠습니다.

    6.1. 단기적 관점 (1~2년): 인프라 치킨게임의 후폭풍과 ‘실속형 밸류’의 부상

    현재 OpenAI의 3단 티어 가격 공세와 문샷AI 키미 K3의 가성비 선언은 AI 시장이 성능 자랑의 시대를 지나 ‘치열한 단가 전쟁(Price War)’의 서막을 열었음을 의미합니다.

    • 인프라 효율화 기업의 독점 수혜: 거대 모델 개발사들이 마진 압박을 받으며 단가 인하 경쟁을 버티는 구조에서 가장 안전하고 확실한 투자처는 역설적으로 ‘인프라 비용을 극단적으로 아껴주는 하드웨어 및 소프트웨어 기술 기업’입니다. 엔비디아의 독점 지위 지속 여부와 더불어, 자체 가속기(TPU)를 완벽히 내재화하여 외부 칩 의존도를 낮춘 구글의 가치가 재평가받는 이유입니다.
    • 중국 빅테크의 역발상 밸류에이션 매력: 규제라는 치명적인 리스크 속에서도 큐원 시리즈를 통해 세계 최상위권 Elo 점수를 뽑아낸 알리바바 등은 비서구권(동남아, 중동 등) 및 아시아 시장에서 압도적인 가성비 클라우드 플랫폼으로 지위를 다질 것입니다. 정치적 매크로 리스크로 인해 주가가 자산 가치 대비 과도하게 할인(Under-valued)된 상태이므로, 실적 턴어라운드 시 강한 주가 탄력을 기대할 수 있습니다.

    6.2. 중장기적 관점 (3~5년): ‘스마트 하이브리드’ 생태계 포식자의 등장

    오픈웨이트 모델의 확산은 장기적으로 LLM 지능 자체를 전기나 수도 같은 범용 공공재(Commodity)로 만들 것입니다. 모델 자체의 해자가 낮아지는 시점에서 진짜 포식자는 이 모델들을 엮어내는 레이어에 있습니다.

    기업들의 인프라 비용을 최소화하기 위해 ‘중요한 10%의 연산은 GPT-5.6 솔로 라우팅하고, 나머지 90%의 반복 업무는 키미 K3나 큐원 인프라로 처리하도록’ 실시간 오케스트레이션을 제공하는 엔터프라이즈 AI 관리 플랫폼과 워크플로우 장악 기업들이 중장기 AI 시장의 부의 가치를 독점할 것입니다.

    7. 핵심 타깃 기업 재무제표 및 자본지출(CAPEX) 심층 비교 분석

    경영진의 속내와 기업의 실제 기초체력을 보려면 재무제표의 자본지출(CAPEX)과 잉여현금흐름(FCF)을 뜯어봐야 합니다. 돈은 거짓말을 하지 않기 때문입니다. 미국의 인프라 패권주 구글(Alphabet)과 중국 오픈웨이트 생태계의 맹주 알리바바(Alibaba)의 최신 2026년 실적 데이터를 바탕으로 재무 구조를 철저히 해부해 드리겠습니다.

    7.1. 구글 (Alphabet, GOOGL): 압도적인 현금 창출력으로 찍어 누르는 자본 치킨게임

    구글의 2026년 AI 인프라 투자는 자본시장 역사상 전례를 찾기 힘들 정도의 거대한 스케일입니다.

    • 2026년 예상 CAPEX 규모: 1,800억 달러 ~ 1,900억 달러 (한화 약 240조 ~ 250조 원)
    • 이는 2025 회계연도에 집행된 914억 달러 대비 무려 2배 가까이 폭증한 수치이며, 월가의 컨센서스를 매 분기 상회하고 있습니다. 순다 피차이와 구글 경영진은 2027년에도 인프라 투자의 ‘유의미한 증가(Significant increase)’를 선언하며 경쟁사들이 따라오지 못하도록 진입장벽을 쌓고 있습니다.
    • 자본 조달 및 FCF 리스크: 연간 250조 원에 달하는 천문학적인 돈을 데이터 센터와 자체 칩 생산에 쏟아붓다 보니, 대규모 감가상각비 부담이 몰아치고 있습니다. 이로 인해 2026 회계연도 중 특정 분기에는 잉여현금흐름(FCF)이 일시적인 압박을 받거나 마이너스 구간에 진입하여 채권 및 자본 시장을 통한 추가적인 자본 조달(Capital Raise)을 단행하기도 했습니다. 단기적인 마진 훼손 우려가 주가 변동성을 키우는 요인입니다.
    • 투자 효율성(ROI)의 건전성: 그러나 시장의 우려와 달리 구글 클라우드(Google Cloud) 부문의 성장은 놀랍습니다. 2026년 들어 구글 클라우드는 전년 동기 대비 63%라는 폭발적인 매출 성장세를 기록하며 경쟁사(AWS, Azure)들을 제치고 가장 가파른 가속도를 보여주고 있습니다. 클라우드 부문 영업이익률 역시 30%를 돌파하여 완벽한 이익 회수 구간에 진입했음을 증명했습니다. 앞서 언급한 TPU(v5p/v6) 인프라 내재화 덕분에 엔비디아에 지불해야 할 칩 마진을 자체 방어하며 단가 전쟁에서 가장 완벽한 맷집을 보유한 빅테크로 자리 잡았습니다.

    7.2. 알리바바 (Alibaba, BABA): 매크로 족쇄 속의 독한 생존, 극대화된 밸류에이션 매력

    알리바바의 2026년 자본 지출은 미국의 반도체 수출 규제라는 무거운 족쇄를 차고, 동시에 중국 내수 이커머스 시장의 출혈 경쟁 속에서 생존을 위해 감행하는 ‘필사의 기술 피봇(Pivot)’입니다.

    • 2026년 예상 CAPEX 및 장기 플랜: 연간 약 180억 달러 내외 (3개년 총 524억 달러 플랜)
    • 알리바바 그룹은 FY2026부터 FY2028까지 3년간 클라우드 및 AI 인프라 생태계 확장을 위해 최소 3,800억 위안(약 524억 달러)을 투자하겠다고 공언했습니다. 2026년 3월 마감 기준 연간 실질 CAPEX는 약 182억 달러로, 과거 연간 40억~50억 달러 수준이던 고정자산 투자 규모를 3배에서 4배 이상 급격히 끌어올렸습니다.
    • 자본 조달 및 FCF 리스크: AI 오픈웨이트 생태계(Qwen) 확장을 위한 공격적인 마케팅 비용, 클라우드 단가 인하 혜택, 그리고 국내외 물류/이커머스 부문의 방어 투자가 겹치면서 알리바바의 조정 EBITA 및 순이익은 전년 대비 50% 이상 급감하는 심각한 단기 실적 쇼크를 겪었습니다. 이 과도기적 투자 집중으로 인해 분기 잉여현금흐름(FCF)이 순유출(마이너스)을 기록하기도 했습니다.
    • 장부상 기초체력(Net Cash)의 저력: 그러나 알리바바 투자자들이 안심할 수 있는 이유는 강력한 대차대조표에 있습니다. 현재 알리바바가 보유한 장부상 순현금(Net Cash)은 410억 달러(한화 약 55조 원)가 넘고, 전체 현금성 자산은 750억 달러에 달합니다. 즉, 외부에서 고금리로 회사채를 발행하거나 자본을 조달할 필요 없이, 오직 자신들이 가진 내부 유보 현금의 체력만으로도 3개년 520억 달러 규모의 AI 투자를 흔들림 없이 완주할 수 있다는 뜻입니다. 큐원 모델이 글로벌 오픈소스 진영의 핵심 인프라로 자리 잡으면서 알리바바 하이브리드 클라우드의 소프트웨어 매출 가속화라는 실질적 ROI가 숫자로 찍히기 시작했습니다.

    8. 3개 핵심 AI 수혜 기업군 비교 및 최종 포트폴리오 가이드

    성공적인 자산 배분을 위해, 앞서 분석한 핵심 타깃 기업들의 단기/중장기 리스크와 가이던스를 최종 비교표로 총정리해 드립니다.

    [2026 하반기 핵심 AI 수혜 기업군 비교 평가]

    투자 대상 영역핵심 대표 기업단기적 관점 (1~2년)중장기적 관점 (3~5년)핵심 리스크 및 최종 가이던스
    프리미엄 인프라 패권주구글 (Alphabet)TPU v5p/v6 기반의 200만 토큰 처리 기술로 엔비디아 의존도 탈피 및 자체 인프라 비용 방어 우위.제미나이 인프라와 안드로이드 워크스페이스 에이전트의 결합으로 독점적 락인(Lock-in) 효과 완성.[적극 매수] 천문학적 CAPEX로 인한 단기 FCF 변동성은 있으나, 단가 전쟁에서 마진을 지켜낼 유일한 하드웨어 수직 통합 빅테크.
    에이전트 툴체인 선점주마이크로소프트 (MSFT) / 깃허브챗GPT 워크 및 OpenAI 3단 티어 모델의 유통 채널 역할로 안정적인 엔터프라이즈 B2B 매출 성장 지속.그록-커서 연합과 같은 코딩 에이전트 시장에서 코파일럿(Copilot) 생태계의 절대적인 지배력 유지.[지속 보유] 현재 밸류에이션(멀티플) 부담은 상존하나, 실제 기업 업무 프로세스를 장악한 실질적 지배자.
    가성비 오픈웨이트 맹주알리바바 (Alibaba)큐원 3.7 맥스의 압도적인 Elo 리더보드 점수를 바탕으로 중국 내수 및 아시아 클라우드 점유율 급증.오픈웨이트 생태계를 장악하여 전 세계 수많은 개발사 및 스타트업들을 자사 클라우드 인프라로 유입.[분할 매수] 지정학적/매크로 리스크 및 AI 투자로 인한 단기 이익 훼손이 있으나, 주가(PER 22배 수준)가 극도로 저평가된 역발상 타깃.

    💡 유명 경제 블로거의 최종 투자 전략 제안 (Action Plan)

    1. AI 모델 자체를 개발하는 순수 스타트업 투자는 지양하십시오. 중국의 무서운 기술 추격과 오픈웨이트(K3, 딥시크)의 범용화 공세로 인해 프런티어 모델 기업들의 자본 지출(CAPEX) 경쟁은 치열해지는 반면, API 단가는 반토막이 나는형태의 ‘승자의 저주’ 구간에 진입하고 있습니다.
    2. 하드웨어 인프라 및 소프트웨어 최적화 능력을 동시에 지닌 거인에 집중하십시오. 구글(GOOGL)처럼 자체 AI 가속 칩셋과 분산 처리 알고리즘(Ring Attention)을 모두 확보하여 ‘토큰당 생산 비용’을 전 세계에서 가장 낮게 낮출 수 있는 기업이 인프라 치킨게임의 최종 과실을 독식합니다.
    3. ‘실전 워크플로우를 장악한 에이전트’ 기업을 포트폴리오에 편입하십시오. xAI가 코딩 툴 커서와 결합한 것처럼 의료, 법률, 금융, 엔지니어링 등 특정 전문 도메인의 사용자 데이터와 업무 프로세스를 완전히 틀어쥐고 있는 애플리케이션 레이어의 강자가 중장기적으로 가장 높은 가치(High Value)를 창출할 것입니다.

    최종 포트폴리오 한 줄 요약:

    글로벌 AI 시장의 안정적이고 압도적인 인프라 패권을 가져가고 싶다면 구글(GOOGL)을 핵심 자산(Core Asset)으로 펀더멘탈의 중심을 잡으십시오. 동시에 미·중 격차 축소와 가성비 오픈웨이트 생태계의 폭발에 베팅하며 리스크 대비 높은 업사이드를 원하는 역발상 투자자라면, 현재 AI 투자로 인한 일시적 이익 훼손으로 주가가 과도하게 눌려 있는 알리바바(BABA)를 알파(Alpha) 수익률 확보용 분할 매수 타깃으로 삼으십시오. 이 두 거인의 자본을 엮어내는 하이브리드 포트폴리오 전략이 2026년 하반기 금융 시장에서 가장 지혜로운 생존 방식이 될 것입니다.

    본 포스팅에 언급된 실적 데이터 및 자본 투자 변동 추이는 글로벌 기관 투자자 리포트 및 기업 공시 자료를 기반으로 작성되었습니다.

    관련기사:

    https://n.news.naver.com/article/032/0003459048

  • [2026.05.21]구글 I/O 2026 심층 분석: 패러다임 시프트와 수직 계열화가 가져올 거대한 머니무브(Money Move)

    📊 Infographic Blueprint: 구글 I/O 2026 Core Value Chain
🎨 Design Concept & Theme
Color Palette: Deep Cyber Blue (Background), Neon Cyan (Tech/Hardware), Bright Green (Profit/SaaS), Coral Red (Risks).

Layout: A structured 3-tier vertical flowing chart or a horizontal dashboard that visualizes the transition from "Infrastructure" to "Value".
[Header]
GOOGLE I/O 2026: THE GREAT AI PARADIGM SHIFT

Subtitle: From "Cost-Burning Calculators" to "Profit-Generating Autonomous Agents"
[Section 1] 🚀 Core Technology Pillars
(Visual: Two main blocks side-by-side with minimal architectural icons)

Gemini 3.5 Flash: The Cost Killer

Tech Engine: Knowledge Distillation & Quantization ($FP16 \rightarrow INT8$).

Impact: 4x Faster Speed / 50%+ Cost Reduction.

Gemini Omni: Native Multimodal

Tech Engine: End-to-End single neural network processing.

Impact: Zero information loss / Real-time Video & Audio Remix.

Agentic AI Loops

Workflow: [User Intent] $\rightarrow$ [Reasoning & Planning] $\rightarrow$ [Tool Use / API Calls] $\rightarrow$ [Self-Verification].
[Section 2] 💰 The Investment Map (Value Chain)
(Visual: A timeline or two-column split layout comparing Short-term vs. Mid/Long-term)
⏱️ Short-Term (1–2 Years): The Revenue Accelerators
ASIC & Custom Chips:
🚀 Broadcom (AVGO): Google's co-development partner for TPU 8.
Next-Gen Infrastructure:
🚀 SK Hynix & Samsung Electronics: High-bandwidth memory ($HBM$) suppliers for TPU 8t.
🚀 Lumentum (LITE) & Coherent (COHR): Providers of OCS (Optical Circuit Switches) for 1M-node clusters.
Software Margin Expansion:
🚀 Top SaaS Players (Salesforce, HubSpot): Immediate OPM (Operating Profit Margin) boost due to halved API costs.
⏳ Mid to Long-Term (3–5 Years): Structural Paradigm Shifters
Edge AI & Next-Gen Form Factors:
🌐 Qualcomm (QCOM): Dominant processor player for Smart Glasses.
🌐 LG Innotek & Largan Precision: High-performance, low-power camera modules & AR waveguides.
AI Security & Protocols:
🌐 CrowdStrike, Palo Alto Networks, Adobe: Mainstreaming of AI watermarking (SynthID) and deepfake defense verification.
[Section 3] ⚠️ Critical Investor Risks

(Visual: A warning dashboard or dual-gauge chart indicating hidden operational bottlenecks )
NVIDIA (NVDA) Multiple Cooling:
As Big Tech pivots heavily to internal ASIC ecosystems (like TPU 8), NVIDIA's extreme monopoly margins may normalize over time.
The Power Grid & Cooling Bottleneck:
The real ceiling for a 1-million-chip cluster is Electricity Supply and Thermal Management, not chip performance.
⭐ Hidden Beneficiaries: Constellation Energy (CEG) [Nuclear Power] & Vertiv (VRT) [Liquid Cooling Solutions].
[Footer / Key Takeaway]
📌 "AI has crossed the chasm from spending money to making money. Bet on custom silicon infrastructure in the short term, and pivot to energy, liquid cooling, and edge devices for the long game."

    이번에 공개된 구글 I/O 2026 발표를 지켜보면서, 저는 실로 가슴이 웅장해지는 것을 느꼈습니다. 엔지니어의 시각에서는 기술적 완성도가 임계점을 넘었다는 확신이 들었고, 애널리스트이자 투자자의 시각에서는 자본 시장의 거대한 자금 흐름(Money Move)이 어디로 요동칠지 지도가 선명하게 그려졌기 때문입니다.

    과거의 인공지능이 우리가 던진 질문에 단순히 답만 하던 ‘수동적인 계산기’에 불과했다면, 2026년의 AI는 스스로 목표를 분석하고 계획을 세워 실행하는 ‘자율적인 동료(Agentic AI)’로 패러다임이 완전히 전환되었습니다. 그리고 구글은 이 거대한 소프트웨어 혁신을 뒷받침하기 위해 밑바닥 하드웨어 인프라부터 최상위 서비스 레이어까지 완벽하게 통제하는 ‘수직 계열화’를 완성해 냈습니다.

    현업 엔지니어가 전율하고 자본 시장이 들썩이는 이 순간, 우리는 화려한 기술의 이면을 쪼개어 분석하고 이를 통해 단기적 모멘텀과 중장기적 밸류에이션 변화를 짚어내야 합니다. 그래야만 다가오는 AI 상용화 시대의 핵심 수혜주를 선점할 수 있습니다.

    오늘 포스팅에서는 구글 I/O 2026에서 발표된 핵심 기술 구조를 엔지니어링 관점에서 아주 쉽게 풀어드리고, 이 기술들이 자극할 가치 사슬(Value Chain)과 투자 관점에서의 유망 기업 및 리스크까지 상세하게 해부해 드리겠습니다.


    1. 차세대 AI 모델 아키텍처: 경량화와 멀티모달의 극한 체제

    구글이 이번 발표에서 모델 라인업을 다각화한 것은 단순한 구색 맞추기가 아닙니다. 이는 서비스 운영 비용(OPEX)을 극적으로 절감하면서도 사용자 경험(UX)을 극대화하기 위한 철저한 아키텍처 최적화 전략의 결과물입니다.

    [구글의 AI 모델 최적화 방향]
      ├─ 제미나이 3.5 플래시: 지식 증류 & 양자화 ➔ 추론 비용 절감 (OPEX 획기적 개선)
      └─ 제미나이 옴니: 네이티브 엔드투엔드 ➔ 정보 손실 제로 & 초저지연 멀티모달 구현
    

    ① 제미나이 3.5 플래시 (Gemini 3.5 Flash) – 비용과 속도의 파괴적 혁신

    • 엔지니어링 심층 분석: 제미나이 3.5 플래시의 핵심은 ‘지식 증류(Knowledge Distillation)’와 ‘양자화(Quantization)’ 기술이 정점에 달했다는 점입니다. 수천억 개의 거대한 파라미터를 가진 울트라(Ultra) 모델을 상용 서비스에 그대로 올리는 것은 비용적으로 불가능에 가깝습니다. 구글은 거대 모델이 가진 핵심 추론 능력과 지식 엑기스만 골라내어 가벼운 모델에 이식(지식 증류)했습니다. 여기에 연산 정밀도를 낮추는 양자화 기술을 적용했습니다. 예를 들어, 기존에 컴퓨터가 1개의 데이터를 처리할 때 쓰던 16비트 부동소수점($FP16$) 연산을 8비트 정수형($INT8$) 데이터 포맷으로 변환하는 방식입니다. 이렇게 되면 데이터의 크기가 절반으로 줄어들어, AI 반도체의 고질적인 문제인 메모리 대역폭 병목 현상을 물리적으로 해결할 수 있게 됩니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 연산 데이터가 가벼워지니 속도가 무려 4배 빨라졌습니다. 이는 서버가 사용자 요청을 받아 처리하는 ‘추론 대기 시간(Latency)’이 급감했음을 뜻합니다. 더 놀라운 것은 가격이 절반 이하로 떨어졌다는 점입니다. 과거에는 비용 부담 때문에 감히 시도하지 못했던 ‘수백만 토큰의 긴 문서를 실시간으로 분석하고, 쉬지 않고 스스로 생각하는 실시간 에이전트 루프’를 이제는 매우 저렴한 비용으로 상시 가동할 수 있게 되었습니다.

    ② 제미나이 옴니 (Gemini Omni) – 진정한 네이티브 멀티모달의 탄생

    • 엔지니어링 심층 분석: 기존의 AI 서비스들은 무늬만 멀티모달인 경우가 많았습니다. 사용자가 말로 질문을 하면, [오디오 ➔ 텍스트 변환(STT)] ➔ [텍스트 모델 추론] ➔ [텍스트 ➔ 오디오 변환(TTS)]이라는 복잡한 중간 변환 과정을 거쳤습니다. 각기 다른 모델들이 따로 놀며 중간에서 데이터를 기계적으로 번역해 주다 보니, 지연 시간이 길어지고 문맥이 꼬였습니다. 반면, 제미나이 옴니는 중간 과정이 완전히 배제된 ‘네이티브 엔드투엔드 멀티모달(Native End-to-End Multimodal)’ 구조입니다. 비디오의 픽셀(Pixel) 데이터와 오디오의 주파수(Frequency) 데이터가 인풋 단계에서부터 하나의 거대한 신경망 안에서 동시에 토큰화(Tokenization)되어 융합 처리됩니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 중간 번역 과정이 없으니 데이터의 정보 손실이 제로(0)에 가깝습니다. 사용자의 목소리 톤에 담긴 미묘한 감정이나, 비디오 영상의 시각적 분위기를 AI가 왜곡 없이 그대로 흡수합니다. 영상의 분위기를 파악해 그에 완벽히 어울리는 효과음을 AI가 자율적으로 생성해 집어넣거나, 배경을 자연스럽게 바꾸는 ‘비디오 리믹스’ 기능이 버벅거림(지연 시간) 없이 실시간으로 작동할 수 있는 비결이 바로 이 일체형 아키텍처 덕분입니다.

    2. ‘AI 에이전트’ 서비스: 단발성 질문 답변을 넘어 ‘자율적 워크플로우’로

    그동안 AI 투자를 망설이게 했던 가장 큰 요인은 “그래서 이걸로 무슨 돈을 버는데?”라는 ‘킬러 서비스의 부재’였습니다. 구글은 이번 I/O 2026을 통해 AI가 일회성 대화(Single-turn)를 나누는 장난감이 아니라, 인간의 업무 프로세스를 대신 수행하는 ‘자율적 루프(Reasoning Loop)’ 시스템임을 명확히 했습니다.

    구글이 제시한 AI 에이전트의 작동 메커니즘은 다음과 같은 고도의 워크플로우를 가집니다.

    [사용자 명령]–>[목표 분석 및 계획 수립]–>[API/도구 호출]–>[결과 검증 및 수정]–>[최종 완료]

    ① 구글 검색 개편 & 제미나이 스파크 / 데일리 브리프

    • 엔지니어링 심층 분석: AI 에이전트가 인간 대신 업무를 처리하려면 두 가지 기술적 전제가 필수적입니다. 바로 외부 시스템과 상호작용할 수 있는 ‘도구 사용(Tool Use / Function Calling)’ 능력과, 과거의 맥락을 잊지 않는 대규모 ‘기억 장치(Context Window)’입니다. 구글은 자사의 유기적인 생태계인 구글 검색, 지메일(Gmail), 구글 캘린더, 구글 드라이브의 핵심 API를 AI 에이전트가 스스로 제어하고 판단하여 호출할 수 있도록 강력한 권한을 부여했습니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 새롭게 선보인 ‘데일리 브리프’ 기능을 예로 들어보겠습니다. 사용자가 자는 동안 AI 에이전트는 밤새 사용자의 메일함과 캘린더 API를 호출하여 쌓인 데이터들을 스스로 긁어옵니다. 그리고 비즈니스 중요도를 자체적으로 채점(Scoring)한 뒤, 오늘 해야 할 일의 우선순위를 직관적인 대시보드 형태로 알아서 조립해 둡니다. 이 복잡하고 정교한 워크플로우를 인간의 개입 없이 24시간 자율적으로 수행한다는 점에서, 진정한 인공지능 비서 시대의 상용화를 의미합니다.

    ② 유튜브에 질문하기 (Ask YouTube)

    • 엔지니어링 심층 분석: 사용자가 수십 시간짜리 영상 파일을 올려두고 특정 내용을 질문할 때, AI가 매번 영상 전체를 처음부터 끝까지 실시간으로 돌려보며 분석하는 것은 천문학적인 연산 낭비이자 인프라 파멸을 불러옵니다. 구글은 이 문제를 인프라 단에서 우아하게 해결했습니다. 유튜브에 영상이 업로드되는 즉시, 비디오 픽셀과 오디오 스트림을 시각적·청각적 토큰으로 쪼갠 뒤 이를 고도로 구조화된 ‘인덱싱(Indexing)’ 작업을 통해 벡터 데이터베이스(Vector Database)에 미리 저장해 둡니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 사용자가 유튜브 영상에 대해 질문을 던지면, AI는 대용량 영상을 재생하는 것이 아니라 벡터 DB에서 고속 의미론적 검색(Semantic Search)을 수행합니다. 그리고 질문과 일치하는 정확한 장면의 ‘시간대(Timestamp)’를 밀리초 단위로 찾아내어 매칭해 줍니다. 이는 단순히 자막 텍스트를 요약하는 수준을 넘어, 영상 내의 ‘공간과 시간의 맥락’을 AI가 통틀어 완벽히 이해하고 있음을 보여주는 강력한 방증입니다.

    3. 하드웨어 인프라: 최초의 ‘듀얼 칩’ TPU 8시리즈와 광학 혁명

    아무리 뛰어난 소프트웨어 알고리즘과 에이전트 아키텍처가 존재하더라도, 밑바닥 하드웨어 인프라가 실시간 연산 압박을 견뎌내지 못하면 모두 공염불에 불과합니다. 구글은 엔비디아의 독점 체제에 맞서 하드웨어 전반을 뒤흔들 기막힌 신의 한 수를 던졌습니다. 바로 학습과 추론을 완전히 분리하여 각각의 효율성을 극대화한 ‘듀얼 칩 아키텍처(Dual-chip Architecture)’입니다.

    구글이 제시한 최초의 듀얼 칩 인프라, TPU 8시리즈의 핵심 스펙과 엔지니어링 포인트를 테이블로 비교해 드리겠습니다.

    구분TPU 8t (Train)TPU 8i (Inference)
    주요 목적거대 모델의 사전 학습(Pre-training) 및 파인튜닝(Fine-tuning)사용자 요청에 대한 초고속 실시간 응답 처리
    핵심 강점초거대 클러스터 확장성 (단일 네트워크 내 100만 개 연동 가능)극도로 낮은 지연 시간 (Low Latency) 및 비용 절감
    엔지니어 팁메모리 대역폭($HBM$)과 칩 간 초고속 인터커넥트($ICI$) 효율 극대화연산 행렬 유닛($MXU$) 최적화 및 전력 소모 효율성 극대화

    100만 개 클러스터가 가지는 진정한 파괴력과 OCS 기술

    많은 이들이 ‘100만 개 칩 연동’이라는 숫자의 화려함에만 집중하지만, 엔지니어 관점에서 주목해야 하는 진짜 핵심은 ‘Optical Circuit Switches (OCS, 광학 회로 스위치)’ 기술의 전면 도입입니다.

    기존의 구리선 기반 네트워크 케이블은 데이터 전송량이 늘어날수록 저항이 커지고 극심한 발열과 통신 병목 현상이 발생합니다. 반면 구글은 100만 개의 TPU 8t 칩을 순수 광케이블로 묶어, 빛의 속도로 데이터를 주고받으며 거대한 하나의 슈퍼컴퓨터처럼 작동하게 만들었습니다.

    인프라 가동의 가장 큰 암초였던 ‘통신 병목’을 물리적인 광학 기술로 해결해 버린 것입니다. 그 결과, 과거에 6개월 이상 소요되던 초거대 LLM 모델의 가동 및 사전 학습 기간을 단 2~3주 만에 끝낼 수 있는 인프라를 완성했습니다. 이는 빅테크 간의 AI 모델 타임투마켓(Time-to-Market) 경쟁에서 구글이 압도적인 속도 패권을 쥐게 되었음을 시사합니다.


    4. 스마트 안경 및 보안: 엣지 AI와 디지털 워터마크의 제도화

    인프라와 모델이 완성되자 구글의 AI는 이제 거대한 클라우드 데이터센터의 장벽을 넘어, 사용자 몸에 직접 밀착되는 스마트 디바이스와 보안 영역으로 내려앉았습니다.

    [Edge AI & Security]
      ├─ 구글 스마트 안경 ➔ 온디바이스 NPU + 클라우드 제미나이 플래시 (하이브리드 AI)
      └─ 신스ID (SynthID) ➔ 암호학적 스테가노그래피 딥페이크 방어 (글로벌 표준화)
    

    ① 구글 스마트 안경 – 포스트 스마트폰 시대를 겨냥한 하이브리드 AI

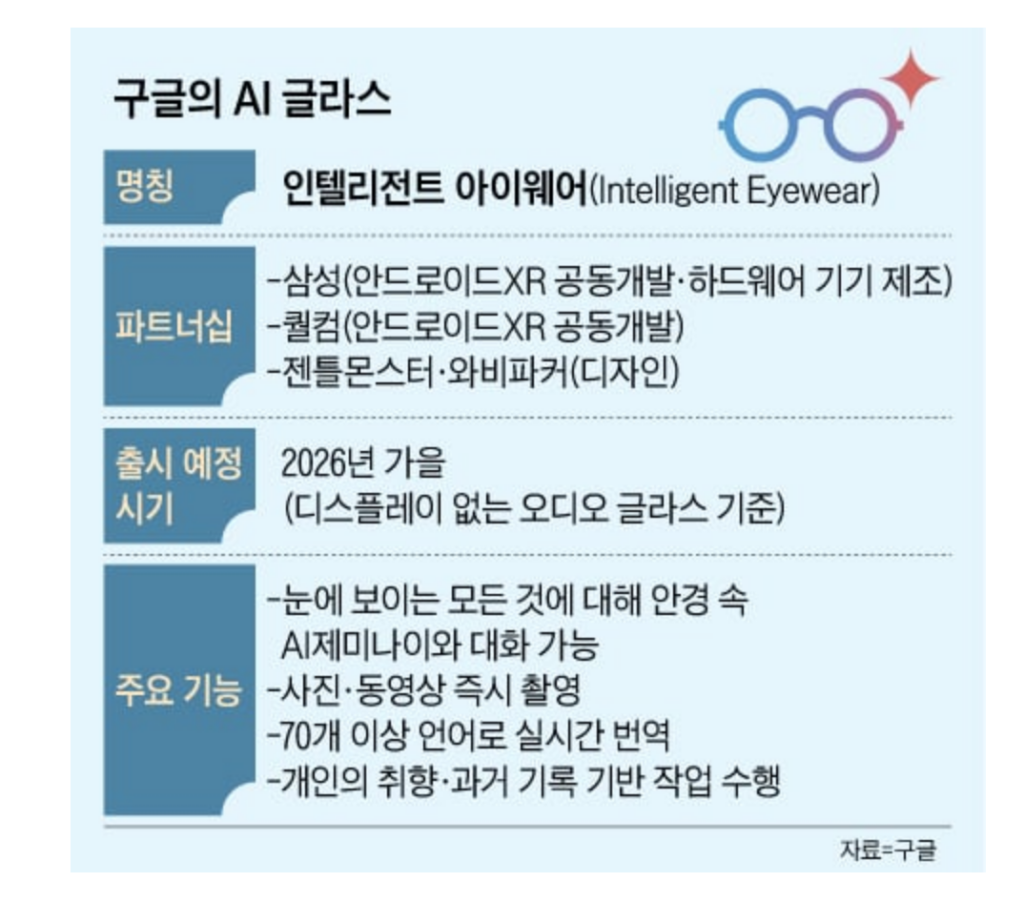
    • 엔지니어링 심층 분석: 이 얇고 가벼운 안경테 안에는 고성능 카메라, 상시 마이크, 그리고 초저전력 NPU(신경망처리장치)가 탑재되어 있습니다. 스마트 안경이 대중화되려면 배터리와 발열 문제를 잡아야 합니다. 따라서 구글은 ‘하이브리드 AI 아키텍처’를 채택했습니다. 사용자의 시선 앞의 간판을 실시간 번역하거나 내비게이션 경로를 띄우는 등 0.1초의 지연도 허용되지 않는 초고속 작업은 안경 내부에 탑재된 온디바이스(On-device) AI가 독립 처리합니다. 반면, 복잡한 시각적 맥락을 분석하거나 긴 문장을 추론해야 하는 무거운 연산은 클라우드에 대기 중인 ‘제미나이 3.5 플래시’로 데이터를 즉각 토스하여 처리하는 영리한 이원화 방식을 씁니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 구글의 스마트 안경 제시는 스마트폰 이후 펼쳐질 새로운 하드웨어 폼팩터 전쟁의 서막입니다. 시각과 청각 데이터를 상시 수집하고 인덱싱해야 하므로, 관련 부품의 단가가 올라가고 고부가가치화가 급격하게 진행될 것입니다.

    ② 신스ID (SynthID) – 생성형 AI 시대의 필수 불가결한 방어막

    • 엔지니어링 심층 분석: 신스ID는 AI가 생성한 비디오 파일이나 오디오 주파수 픽셀 사이에 인간의 눈과 귀로는 절대 감지할 수 없지만, 컴퓨터 소프트웨어는 완벽하게 읽어낼 수 있는 ‘수학적 패턴(미세 노이즈)’을 고도로 삽입하는 기술입니다. 이 기술이 대단한 이유는 악의적인 사용자가 영상의 화질을 강제로 압축하거나, 일부분을 크롭(자르기)하여 변형하더라도 원본 속에 심어진 수학적 패턴이 깨지지 않고 유지되기 때문입니다. 고도의 암호학적 스테가노그래피(Steganography) 기술을 미디어 인프라에 녹여낸 결정체입니다.
    • 투자자가 봐야 할 본질 (왜 대단한가?): 전 세계적으로 딥페이크를 활용한 금융 사기와 여론 조작이 심각한 사회적 문제로 대두되는 가운데, 신스ID는 딥페이크 방어선의 최전선 역할을 하게 됩니다. 향후 각국 규제 당국의 법제화와 맞물리게 되면, 이와 같은 디지털 워터마크 및 상호 검증 기술은 기업들의 필수 보안 표준(Protocol)으로 자리 잡으며 관련 시장이 폭발적으로 개화할 것입니다.

    5. 개발자 생태계: 안티그래비티와 과학 전용 모델을 통한 플랫폼 락인(Lock-in)

    플랫폼 전쟁에서 승리하려면 전 세계의 개발자들이 자사의 생태계 안에서 놀 수 있도록 강력한 도구를 쥐여주어야 합니다. 구글은 개발 환경을 혁신하여 개발자들을 끌어들이는 방식 또한 매우 치밀하고 영리하게 짰습니다.

    ① 안티그래비티(Antigravity) 연동과 자율 디버깅 루프

    구글이 새롭게 선보인 ‘안티그래비티(Antigravity)’는 그 이름(무중력)의 의미처럼, 무겁고 복잡하게 꼬여 있던 기존의 프론트엔드 및 백엔드 빌드 패키징 과정을 ‘무중력 상태’처럼 가볍고 기민하게 만들겠다는 구글의 차세대 통합 웹/앱 프레임워크 또는 런타임 환경입니다.

    개발자가 코드를 짜다가 에러가 발생해 막히면, AI 스튜디오가 브라우저의 DOM(문서 객체 모델) 구조와 안티그래비티 프레임워크 내부를 스스로 파악하여 자율 디버깅 루프를 돌립니다. AI가 에러 원인을 진단하고 코드를 직접 수정하여 자체 테스트까지 끝마친 뒤, “문제를 완벽히 해결했으니 코드 변경 사항을 확인해 보라”고 인간 개발자에게 역제안하는 수준에 도달했습니다. 개발자의 생산성을 수십 배 증가시켜 구글 생태계를 이탈하지 못하게 만드는 강력한 무기입니다.

    ② 제미나이 포 사이언스 (Gemini for Science Skill)

    인류가 쌓아 올린 방대한 논문 데이터와 실험 데이터를 통틀어 학습한 과학·공학 특화 에이전트입니다. AI가 논문을 스스로 정독한 뒤 미진한 부분을 찾아 가설을 세우고, 컴퓨팅 아키텍처 내부에서 실험 시뮬레이션을 자율적으로 돌리는 ‘에이전틱 과학 워크플로우(Agentic Science Workflow)’를 수행합니다.

    중요한 것은 구글이 이 강력한 모델을 오픈소스의 성지인 깃허브(GitHub)에 전격 풀었다는 점입니다. 이는 전 세계의 핵심 과학자, 공학 연구원, 데이터 사이언티스트 개발자들을 구글의 AI 인프라 생태계 아래 든든한 아군이자 종속 관계로 묶어두겠다는 고도의 전략적 포석입니다.


    6. 직설적 투자 가치 사슬(Value Chain) 분석

    현업 엔지니어가 기술의 화려함에 감탄할 때, 노련한 투자자는 “그래서 이 거대한 인프라가 깔리고 패러다임이 바뀔 때 당장 돈을 벌어들이는 공급망의 대장주는 누구인가?”를 찾아내야 합니다. 자본의 시각에서 철저하게 단기와 중장기로 쪼개어 수혜주들을 분석해 드리겠습니다.

    [투자 시기별 핵심 가치 사슬]
      ├─ 단기적 관점 (1~2년): 브로드컴(ASIC 공동개발), SK하이닉스/삼성전자(HBM 공급), 루멘텀(OCS 광학부품), SaaS 기업(비용 절감)
      └─ 중장기적 관점 (3~5년): 퀄컴(엣지 AI 칩), LG이노텍(스마트안경 카메라), 사이버 보안주, Vertiv/Constellation(전력 및 냉각)
    

    1) 단기적 관점 (1~2년 내 실적 가시화 및 강력한 모멘텀)

    단기적으로는 구글의 대규모 인프라 물량 공세에 따라 ‘당장 대규모 주문서(PO)가 찍히는 기업’과 모델 가격 인하로 인해 ‘비용을 극적으로 아껴 마진이 튀는 기업’에 돈이 몰립니다.

    ① 빅테크 인프라 공급망: 구글 자체 칩(TPU 8) 생태계의 숨은 지배자들

    • 브로드컴 (Broadcom, 티커: AVGO): 구글 자체 AI 칩(TPU)의 핵심인 ASIC(주문형 반도체)을 구글과 함께 공동 개발하는 대체 불가능한 핵심 파트너입니다. 구글이 엔비디아 의존도를 낮추고 자체 TPU 8 시리즈 노선을 강화하며 천문학적인 인프라 투자를 감행할수록, 브로드컴의 ASIC 설계 수주 잔고와 로열티 매출은 가장 먼저, 그리고 가장 거대하게 우상향할 수밖에 없습니다.
    • SK하이닉스 & 삼성전자: 앞서 분석해 드렸듯 고성능 학습용 칩인 ‘TPU 8t’의 연산 병목을 해결하기 위한 핵심 원자재는 HBM(고대역폭 메모리)의 대량 탑재입니다. 구글의 공격적인 데이터센터 인프라 증설은 국내 메모리 반도체 양강 기업들의 하이엔드 제품(HBM3E, HBM4) 믹스 개선으로 전격 이어지며, 단기 마진 및 영업이익을 극대화하는 강력한 펀더멘털 동력으로 작용합니다.
    • 루멘텀 (Lumentum, 티커: LITE) / 코히런트 (Coherent, 티커: COHR): 구글 100만 개 클러스터의 핵심 비밀이 광케이블로 묶는 OCS(광학 회로 스위치) 기술이라고 말씀드렸습니다. 이에 따라 대용량 광트랜시버 및 OCS 광학 컴포넌트 부품 수요가 폭발적으로 늘어납니다. 인프라의 최종 병목이 ‘전기 통신’에서 ‘광통신’으로 넘어가는 구간에서, 이들 광학 부품주들이 가장 탄력적인 단기 주가 랠리를 주도할 가능성이 매우 높습니다.

    ② 플랫폼 및 소프트웨어 서비스사: 추론 비용(OPEX) 급감의 최대 수혜주

    • 주요 소프트웨어 SaaS 기업들 (Salesforce, HubSpot 등): 그동안 많은 SaaS 기업들이 매력적인 AI 에이전트 기능을 개발해 두고도, 고객이 기능을 호출할 때마다 발생하는 비싼 LLM API 비용 부담(마진 압박) 때문에 적극적으로 서비스를 확산시키지 못했습니다. 하지만 성능은 올라가고 가격은 절반 이하로 떨어진 ‘제미나이 3.5 플래시’의 등장은 이들의 잔혹한 비용 청구서를 반토막 내줍니다. AI 기능 탑재가 기존의 ‘돈을 갉아먹는 하마’에서 기업의 ‘순이익을 폭발시키는 가속기’로 전환되는 구간이므로, 다음 분기부터 영업이익률(OPM)이 즉각적으로 개선되는 구조적 턴어라운드를 보여줄 것입니다.

    2) 중장기적 관점 (3~5년 패러다임 시프트 및 시장 재편)

    중장기적으로는 서비스의 패러다임이 스마트폰을 넘어 ‘자율적 에이전트가 구동되는 온디바이스(엣지 AI)’와 ‘스마트 안경 폼팩터’로 완전히 넘어가면서 산업의 판도를 뒤바꿀 구조적 성장주를 선점해야 합니다.

    ① 온디바이스(On-device) AI 및 스마트 안경 밸류체인

    • 퀄컴 (Qualcomm, 티커: QCOM): 스마트 안경을 비롯한 미래형 웨어러블 기기와 온디바이스 단말기에 탑재될 초저전력 엣지 AI 칩셋 시장의 독점적 지배자입니다. 구글이 제시한 하이브리드 아키텍처 인프라가 확산될수록 스마트폰 칩 공급사를 넘어 ‘모든 사물의 인공지능화’를 주도하는 핵심 팹리스로 장기 밸류에이션 리레이팅이 가능합니다.
    • 글로벌 카메라 모듈 및 광학계 기업 (LG이노텍, 대만의 라간정밀 등): 스마트 안경 에이전트의 본질은 인간이 보는 세상을 실시간으로 ‘함께 보고’ 데이터베이스에 인덱싱하는 것입니다. 따라서 기기가 항상 켜져 있어도 배터리가 닳지 않는 ‘저전력 고성능 카메라 모듈’과 가상 이미지를 인간의 눈에 자연스럽게 투사해 주는 증강현실(AR) 글래스용 ‘웨이브가이드(광파도관)’ 핵심 광학 기술을 보유한 기업들이 장기적인 공급 계약을 독식하며 수혜를 누릴 것입니다.

    ② 보안 및 인프라의 새로운 표준: 신스ID (SynthID) 동맹

    • 디지털 저작권 및 글로벌 사이버 보안 기업 (CrowdStrike, Palo Alto Networks, Adobe): 생성형 AI 컨텐츠의 무분별한 확산과 딥페이크 위협을 막기 위해, 구글의 신스ID 같은 공통 워터마크 프로토콜을 자사 플랫폼에 전면 이식하거나 이를 실시간으로 검증·차단해 주는 전문 보안 솔루션 업체들의 몸값이 천정부지로 솟구칠 것입니다. 특히 어도비(Adobe, 티커: ADBE)의 경우, 자체적으로 추진 중이던 ‘콘텐츠 진위 이니셔티브(CAI)’ 인프라와 구글의 신스ID 표준이 상호 연동되면서 저작권이 확보된 안전한 크리에이티브 플랫폼으로서의 독점 가치가 더욱 견고해질 것입니다.

    7. 30년차 애널리스트가 던지는 냉혹한 투자 리스크 (Critical View)

    노련하고 지혜로운 투자자라면 기술의 화려한 불꽃놀이 뒤에 숨겨진 그늘과 구조적인 한계점도 반드시 직시해야 합니다. 제가 보는 핵심 리스크는 다음 두 가지입니다.

    첫째, 엔비디아(NVIDIA, 티커: NVDA)의 단기 멀티플(이익배수) 둔화 우려

    구글이 학습과 추론을 완벽히 이원화한 TPU 8시리즈를 성공적으로 론칭하고 100만 개 클러스터 독립 선언을 한 것은, 독점적 권력을 쥐고 있던 엔비디아에게 매우 명확하고 강력한 경고등입니다. 물론 엔비디아가 구축해 놓은 개발 인프라 생태계(CUDA)의 벽은 여전히 견고합니다.

    그러나 구글을 필두로 한 빅테크(메타, 마이크로소프트 등)들이 마진율을 방어하기 위해 자체 주문형 반도체(ASIC) 비중을 지속적으로 높여갈 것은 자명한 사실입니다. 결과적으로 엔비디아가 그동안 독점적으로 누려왔던 극단적인 프리미엄 마진율은 중장기적으로 하향 안정화될 리스크가 있으며, 이는 주가의 단기 멀티플 조정을 유발할 수 있습니다.

    둘째, 인프라 확장을 가로막는 진짜 벽: 전력(Utility) 및 냉각 한계

    구글이 발표한 100만 개 클러스터 가동의 진짜 무서운 적은 ‘칩의 연산 성능’이 아니라, 이를 돌리기 위한 ‘천문학적인 전력 공급’과 ‘막대한 발열 해결’입니다. 구글이 아무리 날고 기는 TPU 8 칩을 수백만 개 찍어내더라도, 데이터센터가 위치한 지역의 전력망(Grid)이 이를 버텨내지 못하거나 가동 효율을 높여줄 냉각 시스템이 공급되지 못하면 인프라 가동률은 처참하게 떨어집니다.

    따라서 역발상적인 투자 관점에서 보면, 인프라 경쟁의 최종 국면에서는 빅테크 기업들보다 그들에게 안정적인 전력을 무한 공급해 줄 수 있는 원전 관련 전력 기업(Constellation Energy 등)이나, 데이터센터의 열을 식혀줄 필수 액체 냉각 솔루션 독점 기업인 버티브(Vertiv, 티커: VRT) 같은 기업들이 인프라 투자의 가장 확실하고 알짜배기인 중장기 수혜주가 될 것입니다.


    8. 투자 관점 요약 대시보드 (핵심 요약 테이블)

    바쁜 현대 투자자분들을 위해 오늘 분석한 핵심 내용을 한눈에 스캐닝할 수 있도록 직관적인 대시보드 테이블로 정리해 드립니다.

    구분핵심 키워드추천 포지션 (단기 관점: 1~2년)추천 포지션 (중장기 관점: 3~5년)
    하드웨어TPU 8, OCS, HBM브로드컴(AVGO), SK하이닉스
    ➔ 자체 칩 생태계 확장 및 인프라 수주 모멘텀
    Vertiv (VRT), 퀄컴(QCOM)
    ➔ 인프라 가동의 필수재(전력 냉각) 및 엣지 AI 지배력
    소프트웨어Gemini 3.5, 에이전트주요 SaaS 기업들
    ➔ 추론 API 비용 감소로 인한 다음 분기 마진 개선
    구글 (GOOGL)
    ➔ 인프라부터 서비스까지 락인(Lock-in)된 수직 계열화 완성 효과
    신시장스마트 안경, SynthID글로벌 광학 부품주
    ➔ 글로벌 빅테크향 스마트 안경 샘플 및 초기 공급 계약 모멘텀
    사이버 보안주, 글로벌 원전주
    ➔ 딥페이크 보안 제도화 수혜 및 데이터센터 필수 전력 편입

    9. 결론: AI가 마침내 ‘돈을 쓰는 단계’를 지나 ‘돈을 버는 단계’로

    결론적으로 이번 구글 I/O 2026의 본질은 아주 명확합니다. 인공지능 산업이 막연한 기대감으로 “돈을 쏟아붓고 쓰던 단계”를 완전히 지나, 인프라 효율화와 에이전트 상용화를 통해 “실진적으로 돈을 진정하게 버는 단계”로 진입했음을 증명해 낸 것입니다.

    구글은 하드웨어 인프라(TPU 8)부터 운영체제 및 모델 레이어(Gemini 3.5), 그리고 최종 서비스(Search, 안경, 개발도구)까지 전부 다 직접 통제하는 완벽한 수직 계열화 제국을 선언했습니다. 이 견고한 거인들의 전쟁 속에서 길을 잃지 않는 가장 현명한 투자 전략은 다음과 같습니다.

    [투자 나침반]

    단기적으로는 구글의 칩 자체 독립 생태계 확장에 따른 핵심 가치 사슬(ASIC 설계, HBM 메모리, OCS 광통신 부품)에 강하게 베팅하여 수익률을 극대화하십시오. 그리고 중장기적으로는 이 고성능 에이전트들이 안정적으로 돌아갈 수밖에 없게 만드는 물리적 기반(전력 인프라, 액체 냉각 시스템)과 새로운 폼팩터(온디바이스 부품주)로 자산을 차분히 분산 배치하는 전략이 가장 영리하고 지혜로운 투자 지도입니다.

    시장의 패러다임이 바뀔 때 부의 지도도 함께 재편됩니다. 철저한 기술 분석과 냉철한 투자 안목으로 이번 거대한 머니무브의 기회를 반드시 아시아의 주역으로서 선점하시길 바랍니다.

    관련 기사

    https://n.news.naver.com/mnews/article/081/0003645653