[태그:] 액체냉각

  • [2026.10.26] 엔비디아 루빈과 DSX POD: AI 팩토리 프리팹이 가져올 데이터센터 생태계의 혁명

    DSX POD 인포그래픽 이미지 대체 텍스트

메인 프로세스 (중앙 배너 및 타임라인):

AI 공장의 혁명: 공장에서 사전 제작(Prefabricated)되어 트럭으로 운송되는 모듈형 컨테이너 개념을 시각화했습니다.

공장 선통합 (Pre-Integration): '베라 루빈 플랫폼', '액체 냉각 시스템', '네트워킹'이 공장에서 미리 조립되고 완벽하게 검증되는 과정을 보여줍니다.

현장 즉시 배포 (On-Site Deployment): 현장 도착 후 크레인으로 하차하여 전력과 냉각수만 연결하면 바로 가동되는 시스템을 묘사했습니다. 이는 과거의 복잡한 현장 조립과 극명한 대조를 이룹니다.

핵심 차별점 및 효과 (좌우 섹션):

초고속 타임투마켓 (오른쪽 시계 아이콘): 기존 데이터센터 구축에 수개월이 걸리던 기간을 획기적으로 줄여, 비즈니스 경쟁력을 확보할 수 있음을 강조했습니다.

현장 리스크 차단 (스패너 및 물방울 아이콘): 휴먼 에러에 의한 누수나 오결선 위험을 공장 선검증으로 해결하여 품질을 보장합니다.

에너지 효율 및 친환경 (오른쪽 녹색 데이터센터): 효율적인 액체 냉각을 통해 PUE(전력 사용 효율 지수)를 최적화하고 탄소 배출을 줄이는 그린 데이터센터 이미지를 표현했습니다.

냉각 방식 비교 분석 (하단 섹션):

전통적 액체 냉각: 복잡하고 지저분한 배관, 위험성, 그리고 현장 작업자의 수고를 직관적으로 묘사했습니다.

DSX POD 액체 냉각 표준화: '퀵 디스커넥트(Quick-Disconnect)', '블라인드 메이트(Blind-Mate)', '랙 단위 전용 CDU' 등 정밀 기술이 레고 블록처럼 표준화되어 안전하고 간편하게 작동함을 보여줍니다.

경제 블로거 분석 (우측 하단):

투자자의 눈으로 본 시장 분석 아이콘과 차트를 함께 배치하여, 이 기술이 단순한 엔지니어링 혁신을 넘어 IT 인프라 벨류체인의 지각변동을 가져올 투자 기회임을 시사했습니다.

    오늘 이야기할 주제는 최근 글로벌 테크 및 데이터센터 시장을 뒤흔들고 있는 핵심 키워드, 바로 ‘DSX POD’와 ‘차세대 액체 냉각(Liquid Cooling) 표준화’입니다.

    생성형 AI의 규모가 조 단위 파라미터를 넘어 멀티모달, 에이전틱 AI로 진화함에 따라 데이터센터는 더 이상 단순한 ‘서버 보관 창고’가 아닙니다. 그것은 수십만 개의 고성능 칩셋이 맞물려 돌아가는 거대한 ‘AI 공장(AI Factory)’입니다. 그리고 이 AI 공장을 짓는 방식 자체가 통째로 뒤바뀌는 패러다임의 대전환이 일어나고 있습니다.

    1. DSX POD란 무엇인가? (엔지니어의 시선으로 본 본질)

    과거의 데이터센터를 구축하던 과정을 떠올려 보겠습니다. 건물을 짓고, 대규모 전력망을 끌어오고, 수천 대의 서버 랙을 일일이 바닥에 고정시킨 뒤, 수만 가닥의 전원 케이블과 네트워크 케이블을 현장에서 수작업으로 연결해야 했습니다. 이 거대하고 복잡한 프로세스 속에서 사소한 설계 오류나 현장 작업자의 휴먼 에러(Human Error)가 발생하면, 시스템을 가동하기도 전에 원인을 찾아 디버깅하는 데만 수개월이 걸리기 일쑤였습니다.

    💡 엔지니어의 한 줄 평

    “DSX POD는 서버와 네트워크를 따로 구매해 현장에서 조립하던 과거의 방식에서 벗어나, ‘AI 공장(AI Factory) 전체를 프리팹(Prefabricated, 사전 제작) 방식으로 통째로 트럭에 실어 나르는 혁신’입니다.”

    즉, DSX POD는 개별 부품의 집합이 아니라 데이터센터 인프라의 모듈화·완제품화를 의미합니다. 하드웨어, 전력 제어, 냉각 시스템, 네트워킹 토폴로지가 이미 공장에서 하나의 유기체로 결합되어 출하되는 완제품 데이터센터 모듈인 것입니다.

    2. 기술적 핵심 구조 분석: 무엇이 담겨 있는가?

    DSX POD가 전 세계 엔지니어들과 빅테크 기업들의 이목을 집중시키는 이유는 단순히 ‘컨테이너 박스에 서버를 쑤셔 넣었기’ 때문이 아닙니다. 그 내부를 채우고 있는 최첨단 엔지니어링의 정수 때문입니다.

    ① 베라 루빈(Vera Rubin) 플랫폼 중심의 설계

    엔비디아의 차세대 아키텍처인 루빈 기반 칩셋들은 기존 세대를 아득히 뛰어넘는 압도적인 연산 능력을 자랑하는 동시에, 전력 소모와 발열 역시 상상을 초월합니다. DSX POD는 이 고성능 칩셋들이 전력 드롭이나 스로틀링 없이 24시간 내내 최적의 성능을 낼 수 있도록, 정밀한 전력 공급 유닛(Power Shelf)부터 고밀도 연산 노드까지 랙 레벨에서 완벽하게 통합 설계되었습니다.

    ② 액체 냉각(Liquid Cooling) 시스템의 표준화

    이제 전통적인 공랭식(Air Cooling) 방식으로는 최신 AI 칩의 열을 감당할 수 없습니다. 문제는 현장에서 수백 개의 냉각 파이프를 직접 연결하고 고압 누수 테스트를 하는 과정이 엔지니어들에게는 엄청난 리스크였다는 점입니다. DSX POD는 이 복잡한 냉각 시스템을 공장에서 미리 완벽하게 밀폐하고 검증하여 출하합니다. 현장 엔지니어 입장에서는 이보다 더 반가운 소식이 없습니다.

    ③ 복잡한 케이블링과 네트워킹의 프리 인테그레이션(Pre-integration)

    초고속 인피니밴드(InfiniBand)나 고성능 이더넷 스위치 간의 케이블링은 미세한 임피던스 오차나 길이 불균형만 있어도 대역폭 병목을 유발합니다. 공장의 정밀 제어된 환경에서 이더넷 및 인피니밴드 토폴로지를 미리 구성(Pre-integration)하므로, 현장 불량률이 제로(0)에 수렴하게 됩니다.

    3. 패러다임의 전환: 왜 ‘컨테이너형 AI 팩토리’인가?

    표준 화물 컨테이너 규격을 활용한다는 것은 물류와 확장성의 극대화를 의미합니다.

    데이터센터 부지만 확보되어 있다면, 거대한 트레일러로 실려 온 DSX POD를 크레인으로 내려놓고 전력선과 광케이블만 메인그리드에 꽂으면 곧바로 가동 준비가 끝납니다. 항만이나 물류센터에서 전 세계 물류를 표준화했던 ‘컨테이너 모듈러 방식’을 IT 인프라 영역에 본격적으로 이식한 것입니다.

    여기서 주목해야 할 점은 델(Dell), HPE 같은 전통의 글로벌 하드웨어 명가들이 이 생태계에 대거 합류하고 있다는 사실입니다. 이는 개별 서버 판매 중심의 비즈니스 모델이 저물고, 이러한 통합 모듈형 디자인이 향후 글로벌 IT 인프라의 사실상의 표준(De Facto Standard)로 자리 잡을 것임을 명백히 시사합니다.

    4. 현업 엔지니어가 바라보는 기대 효과와 가치

    현업에서 대규모 인프라를 구축해본 엔지니어들이 DSX POD를 환호하는 이유는 명확합니다. 세 가지 핵심 가치로 요약할 수 있습니다.

    • ① ‘6개월 vs 14일’의 압도적인 타임투마켓(Time-to-Market) AI 비즈니스는 속도가 곧 생존입니다. 인프라 구축에 6개월을 허비하는 동안 경쟁사는 이미 차세대 파운데이션 모델 학습을 끝내고 시장을 선점할 수 있습니다. 구축 기간을 단 14일로 단축한다는 것은 기업의 비즈니스 민첩성을 수십 배 끌어올린다는 뜻입니다.
    • ② 현장 리스크(Human Error)의 원천 차단 현장 작업은 수많은 변수를 품고 있습니다. 숙련된 엔지니어가 부족한 글로벌 오지나 신흥국에서도 공장에서 검증된 모듈을 그대로 가져다 쓰기 때문에, 현장 작업자의 숙련도와 무관하게 완벽한 품질을 보장받을 수 있습니다. 배관 누수나 케이블 오결선 같은 인재(人災)를 원천 차단하는 것입니다.
    • ③ 에너지 효율과 친환경 (Green Data Center) 전력 대란 시대에 데이터센터의 PUE(전력 사용 효율 지수)는 기업의 생존을 가르는 척도입니다. 액체 냉각 시스템과 지능형 전력 제어 소프트웨어가 하드웨어와 유기적으로 결합되어 있어, 불필요하게 버려지는 에너지를 최소화하고 탄소 배출 규제에 유연하게 대응할 수 있습니다.

    5. 왜 액체 냉각(Liquid Cooling)인가? (기본 원리 파헤치기)

    앞서 DSX POD의 핵심 경쟁력으로 액체 냉각을 언급했습니다. 왜 하필 액체일까요? 컴퓨터 하드웨어를 식히는 매체는 결국 공기(Air) 아니면 액체(Liquid)입니다. 두 방식의 물리적 차이를 짚어보겠습니다.

    • 공랭식의 치명적 한계: 공기는 열을 흡수하고 전달하는 능력(비열 및 열전도율)이 현저히 낮습니다. 현재 엔비디아의 차세대 칩셋들처럼 하나의 패키지에서 수천 와트의 열이 뿜어져 나오는 상황에서 공기로 이를 식히려면, 감당할 수 없을 정도로 거대한 방열판과 소음이 장난 아닌 대형 팬을 고속으로 돌려야 합니다. 물리적인 공기 통로(Airflow)를 더 이상 확보할 수 없는 ‘쿨링의 종점’에 다다른 것입니다.
    • 액체 냉각의 근본적 우위: 물(또는 특수 절연 냉각액)은 공기보다 열을 품고 운반하는 능력이 수십 배 뛰어납니다. 보통 서버 내부에서는 고성능 칩 위에 콜드 플레이트(Cold Plate)를 밀착시키고, 그 안으로 차가운 냉각수를 순환시켜 열을 초고속으로 흡수해 밖으로 배출하는 직접 냉각(Direct-to-Chip, DTC) 방식을 주로 사용합니다.

    6. 전통적 액체 냉각 vs DSX POD 모던 프리팹: 무엇이 다른가?

    과거의 슈퍼컴퓨터나 일부 하이엔드 데이터센터에서도 액체 냉각을 시도한 바 있습니다. 하지만 현업 엔지니어들을 치를 떨게 만들었던 것은 바로 ‘현장 조립의 악몽’이었습니다. 둘의 차이를 명확하게 비교해 드립니다.

    구분전통적 액체 냉각 방식 (Traditional)엔비디아 DSX POD 방식 (Modern Prefab)
    구축 시점데이터센터 현장(On-site)에서 개별 조립 및 설치공장(Factory)에서 랙 단위 완제품 조립 완료
    배관 및 연결현장 엔지니어가 직접 파이프를 자르고 용접·체결하며 수작업 진행공장에서 정밀 제어된 퀵 디스커넥트(Quick-Disconnect)로 원클릭 체결
    검증 및 리스크현장에서 조립 후 압력 테스트 및 누수 검사 (휴먼 에러 위험 큼)공장 클린 환경에서 완벽한 기밀·누수 테스트 거쳐 출하
    시스템 통합냉각 유닛(CDU), 펌프, 서버 랙, 소프트웨어가 각각 따로 놀거나 수동 연동전력·네트워크·냉각 시스템이 하나의 오케스트레이션 소프트웨어로 완전 통합

    7. DSX POD 액체 냉각의 결정적 차별점 3가지

    ① ‘퀵 디스커넥트(Quick-Disconnect)’와 블라인드 메이트(Blind-Mate) 기술

    과거에는 서버 한 대를 유지보수하려고 파이프를 분리할 때 냉각수가 미세하게 흘러나와 고가의 메인보드를 태워먹는 사고가 엔지니어들의 가장 큰 공포였습니다. DSX POD에 적용된 최신 냉각 구조는 레고 블록을 끼우듯 장비를 밀어 넣기만 하면 파이프가 자동으로 완벽하게 결합되고, 분리할 때도 단 한 방울의 누수도 허용하지 않는 정밀 커플링 기술이 랙 레벨에서 완벽하게 표준화되어 있습니다.

    ② 공장 선행 검증(Pre-integration)을 통한 ‘제로 누수’ 보장

    데이터센터 현장은 변수가 너무 많습니다. 현장 작업자가 파이프 이음새를 미세하게 덜 조이거나 오결선하면 몇 달 뒤 대형 누수 사고로 이어져 수십억 원의 손실을 초래합니다. DSX POD는 이 모든 배관 작업을 먼지 없는 공장에서 로봇과 정밀 설비로 미리 마치고, 엄격한 고압 압력 테스트까지 완벽하게 통과한 상태로 트럭에 실어 보냅니다. 현장에서는 그냥 전원과 대형 메인 냉각 페이퍼만 꽂으면 끝입니다.

    ③ 루빈(Rubin) 플랫폼의 초고발열을 견디는 ‘랙 단위 전용 CDU(Coolant Distribution Unit)’ 최적화

    차세대 AI 아키텍처는 랙당 전력 밀도가 수십 킬로와트를 가볍게 넘어섭니다. 전통적 방식은 랙과 냉각 분배 유닛(CDU)의 규격이 뒤섞여 효율이 떨어졌지만, DSX POD는 엔비디아의 차세대 칩셋 발열 특성에 맞춰 냉각수의 유량, 펌프 압력, 센서 모니터링 시스템이 완벽하게 일체화되어 있습니다.

    엔지니어의 총평

    한마디로 과거의 액체 냉각이 ‘특급 기술자들의 손에 의존하던 수제 공예’였다면, DSX POD의 액체 냉각은 ‘공장에서 오차 없이 찍어내어 누구나 안전하게 쓸 수 있는 가전제품 같은 혁신’입니다. 이 냉각 표준화 덕분에 수개월 걸리던 데이터센터 세팅이 단 14일 만에 끝날 수 있는 것입니다.

    8. 투자자 관점에서 바라본 시장 파급효과와 수혜주 분석

    자, 기술적인 분석은 이쯤 하고 우리 같은 투자자들에게 가장 중요한 ‘돈이 되는 관점’으로 시선을 옮겨보겠습니다. 이러한 인프라 패러다임의 전환은 주식 시장에서 어떤 의미를 가질까요?

    1. 하드웨어 벨류체인의 지각변동 (Dell, HPE 등 통합 솔루션 기업) 서버 부품을 단순 조립해 납품하던 기업들은 마진 압박에 시달릴 것입니다. 반면, DSX POD와 같은 완제품 모듈러 아키텍처를 선제적으로 도입하고 공급할 수 있는 시스템 인테그레이터(SI) 및 대형 하드웨어 제조사(Dell, HPE 등)는 높은 부가가치를 창출하며 새로운 해자(Moat)를 구축하게 됩니다.
    2. 액체 냉각 및 특수 부품 생태계의 고성장 냉각수 분배 유닛(CDU), 퀵 커플링(Quick Disconnect) 밸브, 콜드 플레이트, 그리고 특수 절연 냉각액을 제조하는 전문 기업들은 더 이상 틈새시장이 아닙니다. AI 데이터센터의 필수 스탠다드가 되면서 폭발적인 매출 성장이 담보되는 핵심 섹터로 자리매김하고 있습니다.
    3. 데이터센터 건설 및 전력 인프라(Energy & Grid)의 효율성 제고 부지 선정부터 완공까지 걸리는 시간이 획기적으로 줄어들면서, 빅테크 기업들의 AI 인프라 투자(CAPEX) 집행 속도가 더욱 가속화될 것입니다. 이는 곧 전력망, 변압기, SMR 및 신재생 에너지 인프라 수요로 직접 이어지는 선순환 구조를 만들어냅니다.

    맺음말

    DSX POD처럼 하드웨어, 액체 냉각, 고속 네트워킹, 그리고 배포 프로세스까지 일괄적으로 묶어낸 레퍼런스 디자인은 다가오는 AI 시대를 지탱하는 가장 튼튼한 이정표입니다.

    기술의 본질을 깊이 이해하고, 그 기술이 만들어내는 산업의 구조적 변화를 남보다 한 발짝 앞서 읽어내는 것—이것이 바로 불확실한 시장에서 우리 자산을 지키고 현명하게 불려 나가는 가장 확실한 지혜입니다.

    오늘 포스팅이 여러분의 IT 인사이트와 투자 전략 수립에 깊은 영감이 되었기를 바랍니다. 앞으로도 시장의 본질을 꿰뚫는 날카로운 분석으로 찾아오겠습니다. 성공적인 투자와 멋진 하루 되시길 바랍니다!

    관련 기사:
    https://www.mediapic.co.kr/news/articleView.html?idxno=3686

  • [2026.08.19]AI 토큰 경제학: 생산 비용 패러다임 전환과 인프라 병목, 그리고 빅테크 투자 전략

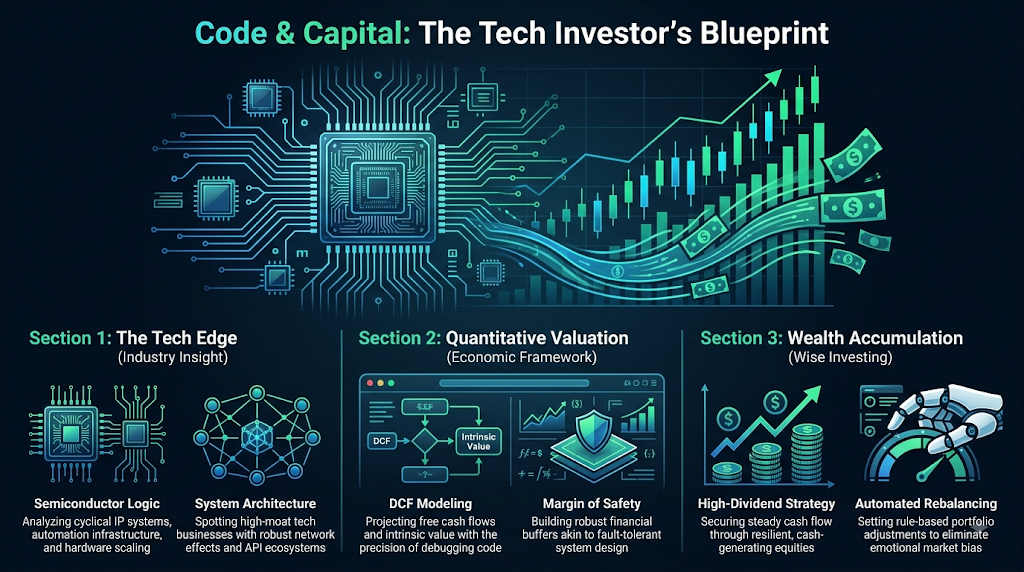
    ai 토큰 생성과 기술 투자자를 위한 청사진 'Code & Capital' 인포그래픽. 상단에는 마이크로칩 회로와 상승하는 주가 차트, 현금 흐름 아이콘이 조화롭게 연결된 그래픽이 위치해 있습니다. 하단은 3개 섹션으로 나뉩니다. Section 1 'The Tech Edge'는 반도체 로직과 시스템 아키텍처, Section 2 'Quantitative Valuation'은 DCF 모델링과 안전식대(Margin of Safety), Section 3 'Wealth Accumulation'은 고배당 전략과 자동 리밸런싱에 대한 주요 내용을 다룹니다.

    오늘은 AI 토큰 생성에 대한 내용으로 알아보려 합니다. 2023년과 2024년이 생성형 AI(Generative AI)의 가능성을 검증하고 프론티어 파운데이션 모델을 훈련(Training)시키는 ‘자본 집약적 군비 경쟁’의 시대였다면, 2026년 현재 AI 산업은 명확하게 ‘수익화, 수율, 그리고 토큰 당 생산 원가 절감’ 중심의 추론(Inference) 서비스 단계로 완벽히 전환되었습니다.

    과거 PC 보급 초기나 인터넷 초창기 초고속 망 구축 시절을 돌아보십시오. 인프라 구축의 폭발적 증가 단계가 지나면 시장의 관심은 자연스럽게 “누가 이 인프라를 통해 가장 저렴하게 서비스를 생산할 수 있는가?” 그리고 “그 과정에서 진짜 병목(Bottleneck)을 쥐고 수익을 독식하는 자는 누구인가?”로 이동합니다.

    본 포스팅에서는 2026년 8월 최신 데이터를 바탕으로 ① 글로벌 주요 기업들의 AI 토큰 생산량 및 비용 구조, ② 토큰 생성에 필요한 TCO(총소유비용) 및 자원 구성 현황, ③ PagedAttention 및 MLA(Multi-head Latent Attention) 등 추론 단가를 극적으로 낮춘 기술적 혁신, ④ Google vs OpenAI vs Anthropic의 인프라 전략 차이, 그리고 ⑤ 이에 기반한 단기/중장기 블록버스터급 투자 가이던스를 심도 있게 다룹니다.

    1. 기업별 AI 토큰 생산량(처리량) 및 시장 현황 (2026년 8월 기준)

    AI 기업들의 실제 ‘공식 발표 총 생산량’은 기업 비밀에 속하지만, API 트래픽 및 주요 리서치 기관(a16z, OpenRouter 등)의 최신 측정 데이터에 따른 2026년 현재 글로벌 토큰 처리량은 가공할 만한 속도로 팽창하고 있습니다.

    주요 기업 및 플랫폼별 토큰 처리 트렌드

    1. OpenAI:
      • OpenAI API 트래픽은 2025년 10월 분당 약 60억 토큰을 기록했으나, 2026년 4월에는 분당 150억 토큰으로 불과 5개월 만에 2.5배 폭증했습니다.
      • 이는 일일 기준으로 약 216억 토큰을 처리하는 규모입니다. GPT-5.6 시리즈(Sol, Luna) 및 엔터프라이즈 에이전트 도입이 본격화되면서 처리량 성장은 상방을 계속 열어두고 있습니다.
    2. Google (내부 Antigravity 플랫폼 및 GCP):
      • Google 개발자 생태계 및 내부 연산 플랫폼인 Antigravity 기준, 2026년 3월 하루 약 5,000억 토큰을 처리했으나, 불과 두 달 뒤인 5월 중순에는 일일 3조 토큰(3 Trillion Tokens/Day)을 돌파했습니다.
      • 이는 Gemini 3.1 Pro / Flash-Lite의 압도적인 맥락 창(Context Window) 처리 능력과 TPU Ironwood(v7) 파이프라인의 가격 경쟁력이 결합된 결과입니다.
    3. OpenRouter (멀티 프로바이더 라우팅 플랫폼):
      • 다양한 오픈소스 및 커머셜 모델을 연결하는 라우팅 인프라 OpenRouter는 2026년 5월 기준 주당 25조 토큰을 처리했습니다. 6개월 전(주당 5조 토큰) 대비 무려 5배 성장한 수치입니다.
    4. 전체 시장 규모 (Global LLM API Market):
      • a16z와 OpenRouter의 공동 연구 조사에 따르면, 2026년 8월 현재 글로벌 LLM API 시장 전체의 일일 토큰 생성량은 약 50조 토큰(50 Trillion Tokens/Day) 규모로 추산됩니다.

    글로벌 AI 랩 및 빅테크 매출 성과 참고 (2026년 상반기)

    • OpenAI: 2026년 1분기 약 57억 달러의 매출을 기록했으며, 2026년 4월 기준 연환산 매출(ARR)은 약 250억 달러 수준을 나타내고 있습니다.
    • Anthropic: Enterprise Claude 3.5/4.8 및 AWS/GCP 멀티클라우드 침투율 급증에 힘입어 2026년 상반기 연환산 매출(ARR) 약 190억~450억 달러 선을 오가며 OpenAI를 턱밑까지 추격하는 기염을 토하고 있습니다.

    2. 토큰당 실제 ‘생산 비용(Cost)’ vs ‘판매 가격(Price)’ 파헤치기

    투자자와 엔지니어 모두가 반드시 구분해야 하는 핵심 개념이 있습니다. “사용자에게 매기는 API 판매 가격(Price)”과 “기업이 토큰 1개를 생성하는 데 드는 실제 컴퓨팅 원가(Cost)”는 천지차이라는 점입니다.

    (1) 실제 순수 컴퓨팅 생산 원가 (Pure Compute Cost)

    1. 에너지 관점 (Energy Cost per Token):
      • 경험적 실측치에 따르면, 추론(Inference) 단계의 에너지 소비는 출력 토큰당 약 0.0001 ~ 0.002 Wh 수준입니다.
      • 중간값인 토큰당 0.0005 Wh를 기준으로 계산하면, 토큰 1개를 생산할 때 소요되는 에너지는 약 1.8 줄(Joule)에 해당합니다.
    2. 하드웨어 및 한계 비용 사례:
      • OpenAI의 최적화된 프론티어 파이프라인 기준, 토큰 1개를 생성하는 순수 인프라 원가는 약 0.00012달러 ($0.00012) 수준으로 추산됩니다. 이는 AI 기업들의 매출총이익률(Gross Margin)을 결정짓는 최고 보안 지표입니다.
    3. GPU 시간 기준 원가와 가동률(Utilization):
      • 추론 비용의 본질은 “토큰당 GPU를 몇 초간 점유했는가”입니다.
      • 2026년 4월 기준 NVIDIA Blackwell B200의 클라우드 임대료는 시간당 $3.49 ~ $14.24 수준입니다. GPU 시간당 임대 비용은 초당 2,000토큰을 생성하든 27,000토큰을 생성하든 일정하므로, 유효 가동률(Utilization Rate) 및 메모리 대역폭 활용 효율이 토큰당 원가를 결정하는 절대적 변수가 됩니다.

    (2) 원가 대비 판매가 (마진 구조) 및 최신 가격 동향

    • 자체 호스팅 원가 vs API 판매가:2026년 기준 H100 GPU에서 Batch Size=8로 구동하는 Llama 4 70B 오픈소스 모델의 자체 호스팅 원가는 백만 토큰(1M Tokens)당 약 $0.18 수준입니다. 이는 상용 서비스인 Claude Sonnet 4.6 API 가격($15.00/1M Tokens)의 약 1.2%에 불과합니다.
    • 최저 원가 하드웨어의 출현:NVIDIA Blackwell(B200) 인프라는 최적화 구동 시 1M 토큰당 $0.02(2센트)라는 전대미문의 추론 비용 하한선을 세웠습니다. DeepInfra, Baseten, Fireworks AI, Together AI 등 최적화 프로바이더들은 Hopper(H100) 세대 대비 최대 10배의 비용 절감을 달성했습니다.
    • 3년간 1,000배 급락한 추론 비용:2021년 11월부터 2024년 말, 그리고 2026년에 이르기까지 동일 성능 기준 추론 비용은 백만 토큰당 $60.00에서 $0.06 이하로 3년 만에 1,000배 이상 급락했습니다.

    💡 추론 비용 1,000배 하락의 6대 복합 요인

    1. GPU/NPU 하드웨어 건축적 진화 (FP8/FP4 Tensor Core 도입)
    2. 양자화(Quantization) 기술 (16비트 FP16 → 4비트 INT4/FP4)
    3. 소프트웨어 최적화 (vLLM, FlashAttention, PagedAttention)
    4. 소형 고성능 모델(SLM)의 등장 (MoE 구조 고도화)
    5. 강화학습(RLHF/RLAIF) 및 연산 효율 개선
    6. 오픈소스 생태계와의 치열한 단가 경쟁

    주요 프로바이더 API 판매가 비교 (2026년 7-8월 기준, 1M 토큰당)

    기업대표 모델입력 가격 (1M)출력 가격 (1M)비고 및 특이사항
    OpenAIGPT-5.6 Sol$5.00$30.00플래그십 고성능 에이전트
    OpenAIGPT-5.6 Luna$1.00$6.00경량화·고속 추론 모델
    AnthropicClaude Opus 4.8$5.00$25.00복잡 코딩 및 논리 추론 특화
    AnthropicClaude Sonnet 5$2.00$10.00프로모션가 적용
    GoogleGemini 3.1 Pro$2.00$12.0020만 토큰 이하 프롬프트 기준
    GoogleGemini 3.1 Flash-Lite$0.25$1.50극가성비 대량 처리용
    DeepSeekDeepSeek-V3 / R1$0.27 ~ $0.50$0.42 ~ $2.18초저가 박리다매 전략

    3. 토큰 생산 자원(TCO) 구성 및 인프라 병목 분석

    AI 토큰을 생산하기 위해서는 ① 하드웨어(가속기 칩/서버), ② 전력 및 냉각 인프라, ③ 부지 및 전력망(Grid) 연결이라는 세 가지 핵심 축이 필요합니다.

    (1) 데이터센터 TCO(총소유비용) 구조

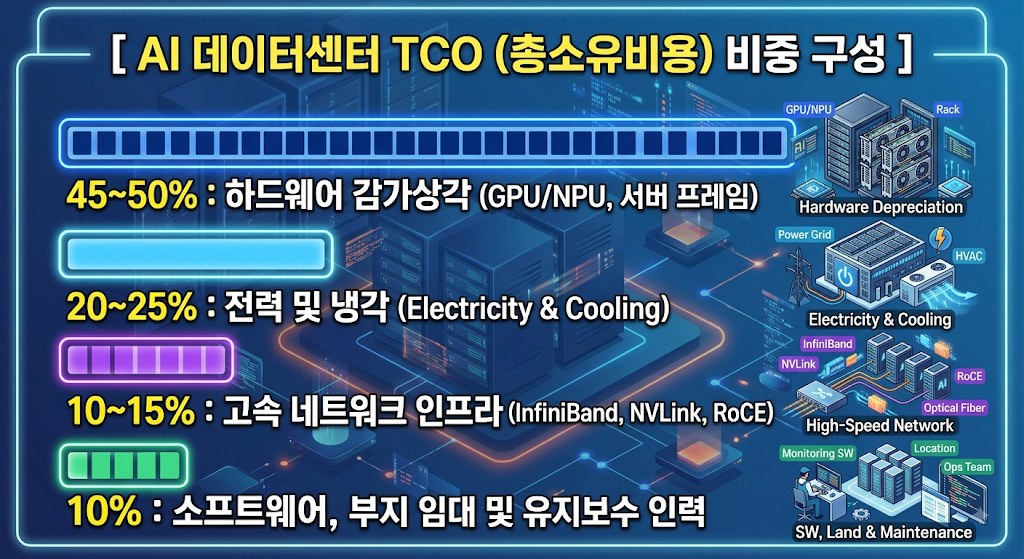
    1기가와트(1GW)급 AI 데이터센터 구축에는 약 380억 달러의 초기 자본지출(CapEx)과 연간 9억 달러의 운영비(OpEx)가 소요됩니다. 자산 수명주기(3~5년)를 감안해 연단위로 환산한 총소유비용(TCO)은 연간 약 85억 달러에 달합니다.

    • 하드웨어 감가상각 (45~50%): GPU(NVIDIA H100, B200) 및 전용 NPU/TPU 서버의 내구연한(3년) 감가상각비가 전체 원가의 절반을 차지하는 단일 최대 항목입니다.
    • 전력 및 냉각 (20~25%): GPU 연산 전력과 함께, 극심한 열을 식히기 위한 냉각 시스템 전력이 포함됩니다.
    • 고속 네트워크 인프라 (10~15%): 수만 개의 GPU를 하나의 거대한 분산 컴퓨터처럼 연결하는 InfiniBand 및 RoCE 스위치 인프라입니다. 네트워크 병목이 발생하면 고가의 GPU가 연산을 멈추고 대기(Idle)하므로 매우 결정적인 투자 항목입니다.

    (2) 패러다임의 전환: “칩 병목”에서 “전력 및 전력망 병목”으로!

    현재 AI 산업의 가장 치명적인 병목은 더 이상 GPU 칩 자체의 리드타임이 아닙니다. 진짜 병목은 변전소 및 전력망 연결 대기시간(전력망 그리드 연결 대기시간 약 4년 이상)과 데이터센터 랙(Rack)당 밀도 폭발입니다.

    • 랙 당 전력 밀도의 극단적 증가: 과거 일반 IT 서버 랙은 5~15kW 수준이었으나, 최신 AI GPU 랙(Blackwell 등)은 랙당 40kW ~ 250kW의 전력을 소비합니다.
    • 냉각 인프라의 강제 전환: 공랭식(Air Cooling) 시설로는 랙당 40kW 이상의 발열을 식히는 것이 물리적으로 불가능합니다. 이에 따라 Direct-to-Chip 액체 냉각(Liquid Cooling) 및 침매 냉각(Immersion Cooling)으로의 급격한 패러다임 전환이 일어나고 있으며, 냉각 설비가 데이터센터 시설 비용에서 차지하는 비중은 기존 22%에서 33% 이상으로 급증했습니다.
    • 추론(Inference) 부하의 압도: 2년 전만 해도 전체 컴퓨팅 자원의 80% 이상이 ‘학습(Training)’에 투입되었으나, 2026년 현재 추론 워크로드가 전체 AI 컴퓨팅 자원의 80~90%를 점유하고 있습니다. 학습과 달리 추론은 24시간 전 세계 사용자에 의해 지속적으로 발생하므로 기저 전력 부하를 극도로 압박합니다.

    4. LLM 추론 단가를 혁신한 2대 핵심 기술: PagedAttention & MLA

    엔지니어링 관점에서 LLM 추론은 두 단계로 나뉩니다.

    1. Prefill 단계 (입력 프롬프트 읽기): 연산 집약적 (Compute-bound)
    2. Decode 단계 (토큰 한 글자씩 생성): 메모리 대역폭 집약적 (Memory-bandwidth bound)

    실제 서비스 처리 시간의 90% 이상을 차지하는 Decode 단계에서 ‘메모리 월(Memory Wall)’을 깨뜨리고 토큰 생성 단가를 1/10 이하로 떨어뜨린 일등 공신이 바로 PagedAttention과 MLA(Multi-head Latent Attention)입니다.

    (1) PagedAttention: OS의 가상 메모리 기법을 GPU에 이식

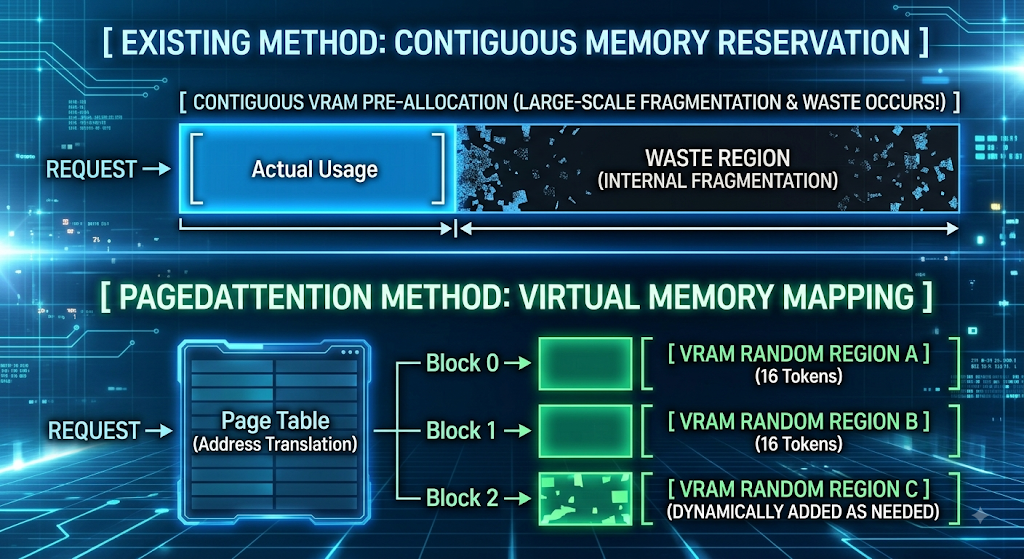
    vLLM 팀이 제안한 PagedAttention은 운영체제(OS)의 페이징(Paging) 메커니즘을 GPU VRAM 관리에 적용한 혁신적 소프트웨어 기술입니다.

    • 기존 문제점: 대화가 얼마나 길어질지 모르기 때문에 기존 추론 엔진은 최대 컨텍스트 길이(예: 2,048~8,192 토큰)에 맞추어 연속된 VRAM을 통째로 예약했습니다. 이로 인해 메모리 낭비율이 60~80%에 달했고, 동시 접속자(Batch Size)를 많이 받아내지 못했습니다.
    • PagedAttention의 해결책: KV 캐시를 ‘블록(Block)’ 단위로 쪼개어 non-contiguous(비연속적) VRAM 공간에 자유롭게 할당하고, Page Table을 통해 관리합니다.
    • 결과: 메모리 파편화 및 낭비를 1% 미만으로 줄였으며, 동일 하드웨어 대비 동시 처리 사용자 수를 2~4배 이상 끌어올려 토큰당 원가를 혁신적으로 인하시켰습니다.

    (2) MLA (Multi-head Latent Attention): 신경망 아키텍처 수준의 데이터 압축

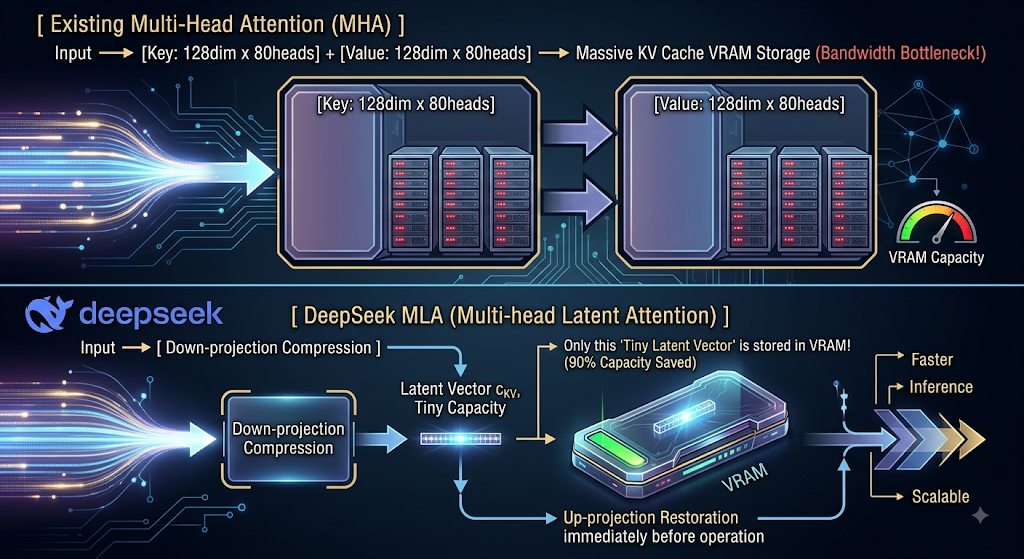
    DeepSeek-V3 및 R1 모델 등에 적용되어 전 세계를 놀라게 한 MLA는 “메모리에 저장되는 KV 캐시 덩치 자체를 1/10로 압축하자”는 아키텍처적 혁신입니다.

    • 기존 방식 한계: MHA 방식에서는 헤드 수와 차원 수가 늘어남에 따라 토큰 1개당 엄청난 양의 Key/Value 벡터를 매번 VRAM에 읽고 써야 하므로 메모리 대역폭 한계(Memory Bandwidth Bottleneck)에 직면했습니다.
    • MLA의 해결책: Key와 Value를 각각 거대하게 저장하지 않고, 차원을 대폭 축소한 ‘잠재 벡터(Latent Vector $c_{KV}$)’ 형태로 압축하여 VRAM에 올려둡니다. 실제 연산이 일어나는 순간에만 수학적 투영(Up-projection)을 통해 복원합니다.
    • 결과: 모델의 정확도 손실을 최소화하면서 KV 캐시 용량을 90% 이상 절감시켰고, 메모리 대역폭 병목을 해소하여 초당 토큰 생성 속도(TPS)를 극적으로 높였습니다.

    5. OpenAI vs Anthropic vs Google 인프라 비용 구조 비교

    세 대표 기업은 인프라를 바라보는 철학에서 근본적인 차이를 보입니다. Google은 자체 데이터센터와 자체 AI 칩(TPU)을 완벽히 소유한 수직계열화 하이퍼스케일러인 반면, OpenAI와 Anthropic은 외부 파트너의 인프라를 대규모 임차·계약하여 사용하는 ‘AI Lab’ 구조입니다.

    3사 인프라 전략 비교 요약 (2026년 8월 기준)

    구분GoogleAnthropicOpenAI
    인프라 구조자체 소유 하이퍼스케일러멀티클라우드 임차형임차형 (주로 MS Azure / Oracle)
    핵심 가속기 칩자체 설계 TPU (Ironwood / v7)Google TPU + AWS Trainium + NVIDIA 혼용NVIDIA GPU 위주 (자체 칩 ‘Jalapeño’ 개발 중)
    2026년 CapEx$1,950억 ~ $2,050억직접 CapEx 없음 (장기 임차 계약)직접 CapEx 없음 (Stargate 등 별도 SPV)
    토큰 원가 우위극상 (수직계열화 + NVIDIA 마진 제거)상 (멀티클라우드 최적화 및 TPU 활용)중 (NVIDIA GPU 고비용 구조 노출)
    재무적 리스크막대한 CapEx로 인한 단기 FCF 압박인프라 미보유로 공급사 가격 협상력 의존공급사 의존도 높음, 부채/SPV 가동

    1) Google: “자체 칩(TPU) + 자체 네트워크”의 압도적 원가 우위

    • NVIDIA 마진 제거: Google은 자체 설계한 TPU(Ironwood)를 사용함으로써 NVIDIA가 가져가는 70~80% 수준의 마진을 완전히 제거합니다. SemiAnalysis에 따르면 Google은 TPU를 통해 내부 워크로드 연산 비용을 NVIDIA 대비 최대 62% 절감하고 있습니다.
    • 광학 회로 스위칭(OCS) 네트워크: Google은 TPU 클러스터 연결에 자체 개발한 OCS(Optical Circuit Switching) 기술을 사용합니다. 이는 OpenAI가 사용하는 구리 기반 InfiniBand 네트워크 대비 확장 비용이 훨씬 저렴하며 전력 소비도 매우 낮습니다.
    • 데이터센터 구축 효율: 10만 개 칩 규모 프론티어 클러스터 기준, Google은 OpenAI가 데이터센터 1개를 지을 수 있는 비용으로 동급 규모 데이터센터 4개를 지을 수 있는 구조적 원가 격차를 확보했습니다.

    2) Anthropic: “현명한 멀티클라우드 레버리지” 전략

    • Anthropic은 단일 클라우드에 종속되지 않고 AWS(Trainium), Google Cloud(TPU), Azure(NVIDIA)를 모두 활용하는 정교한 멀티클라우드 전략을 취하고 있습니다.
    • 2025년 10월 Google과의 파트너십 확장을 통해 최대 100만 개의 TPU 칩 접근 권한을 확보했으며, 2026년 4월에는 Broadcom 및 Google과 협업하여 2027년부터 최대 5GW 규모의 차세대 TPU 용량을 추가 확보하는 대형 계약을 체결했습니다.
    • 향후 5년간 Google Cloud에만 2,000억 달러 지출을 약정하는 한편, AWS와의 주력 훈련 파트너십을 동시에 유지하면서 칩 공급사 간의 경쟁을 유도해 임차 비용을 극단적으로 낮추고 있습니다.

    3) OpenAI: GPU 의존도와 TPU의 견제 효과

    • OpenAI는 Microsoft Azure 및 Oracle 클라우드를 통한 NVIDIA GPU 리소스에 가장 크게 의존하고 있습니다.
    • 재미있는 점은, Google TPU의 막강한 가성비와 위협 덕분에 OpenAI 역시 NVIDIA와의 가격 협상에서 GPU 조달 비용을 약 30% 낮추는 반사 이익을 얻었다는 사실입니다. 경쟁사의 수직계열화 칩이 시장 전체의 GPU 공급가를 끌어내리는 가격 압박 요소로 작용하고 있습니다.

    주요 빅테크 4사 2026년 CapEx 가이던스 참고

    • Amazon (AWS): 약 2,000억 달러
    • Google (Alphabet): 1,950억 ~ 2,050억 달러 (2분기 실적 발표 후 상향)
    • Microsoft: 약 1,900억 달러
    • Meta: 1,250억 ~ 1,450억 달러
    • 합계: 2026년 하이퍼스케일러 4사의 총 CapEx는 약 7,000억 달러(약 950조 원)에 육박합니다.

    6. 투자 가이던스

    AI 산업이 자본집약적 훈련(Training) 단계에서 수익화·수율 중심의 추론(Inference) 서비스 단계로 완벽히 전환된 현 시점, 투자자들은 빅테크의 매출 성장률만 볼 것이 아니라 재무제표 상의 FCF(잉여현금흐름) 변화와 밸류체인 병목을 정밀하게 타격해야 합니다.

    (1) 단기 투자 가이던스 (6~12개월): “FCF 진통과 병목 수혜주 타격”

    1. 빅테크 CapEx 피크아웃 우려 및 FCF 압박 경계:
      • Alphabet의 2026년 2분기 사례처럼, CapEx 급증($449억)으로 영업현금흐름($391억)을 초과하면서 상장 후 최초로 분기 잉여현금흐름(FCF)이 마이너스(-$59억)를 기록하는 현상이 나타나고 있습니다.
      • 시장은 빅테크의 주가를 누르며 “이 막대한 지출이 언제 회수되는가”를 더욱 엄격하게 검증할 것입니다. 따라서 단기적으로 하이퍼스케일러 직접 매수보다는 빅테크가 강제로 돈을 쓸 수밖에 없는 ‘병목 길목’ 기업으로 자금을 이동시켜야 합니다.
    2. 메모리 대역폭(Memory Wall) 및 ASIC 최적화 수혜주:
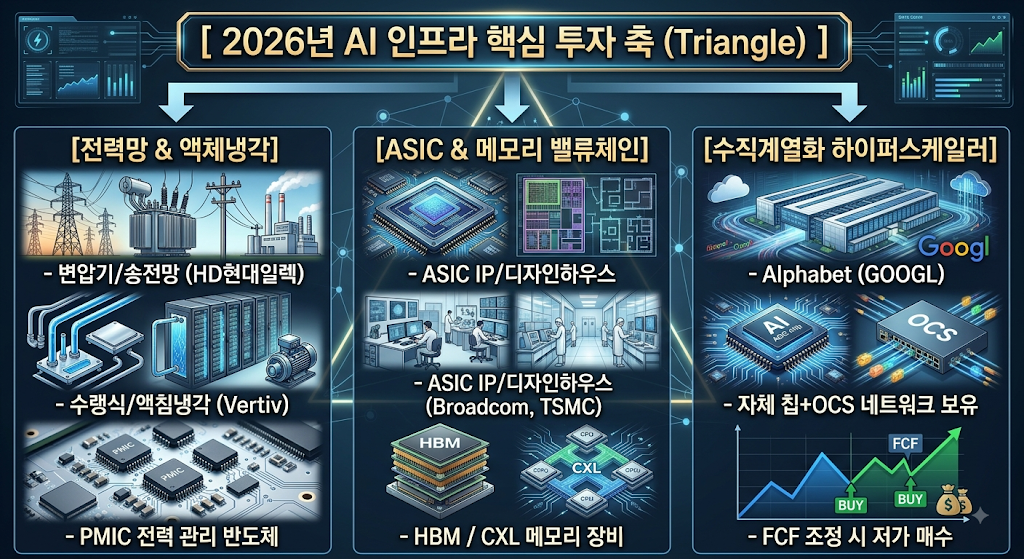
      • ASIC 디자인하우스 & 파운드리: Broadcom(AVGO), TSMC(TSM) 등 Google TPU, AWS Trainium, Anthropic 연합의 수주를 독점하는 커스텀 칩 밸류체인의 실적 모멘텀이 매우 강력합니다.
      • HBM / CXL 밸류체인: 추론 병목 해소를 위한 HBM3e/HBM4 및 CXL 관련 핵심 장비·소재 기업에 대한 비중 확대를 추천합니다.

    (2) 중장기 투자 가이던스 (3~5년): “구조적 승자와 인프라 패러다임 전환”

    1. 전력망(Grid) 및 액체 냉각(Liquid Cooling): GPU보다 강력한 진짜 승자:
      • 데이터센터 건설의 절대 병목은 칩이 아니라 변전소 대기 시간(4년+)과 전력 공급입니다.
      • 전력 인프라: 초고압 변압기, 송전선로, 전력 기기 제조업체(HD현대일렉트릭, 효성중공업, Eaton, Schneider Electric) 및 전력 효율화 PMIC 기업을 포트폴리오의 절대적 핵심 축으로 구성해야 합니다.
      • 냉각 솔루션: 랙당 40~120kW+ 발열을 잡기 위한 액체 냉각(CDU, 열교환기, 액침냉각) 전문 기업(Vertiv 등)을 선점하십시오.
    2. 수직계열화 하이퍼스케일러(Google)의 재평가:
      • Google(Alphabet)은 자체 TPU + OCS 광학 네트워크 + 자체 데이터센터를 통해 토큰당 생산 원가 하한선을 지킬 수 있는 유일무이한 공룡입니다. 단기 CapEx 과다로 인한 FCF 우려로 주가가 조정을 받을 때마다 가장 적극적으로 분할 매수해야 할 장기 1순위 자산입니다.

    3) 포트폴리오 자산 배분 전략 요약

    자산군 / 핵심 테마추천 비중 및 투자 전략핵심 대상 종목 및 밸류체인
    전력 & 냉각 인프라[비중 확대] (35%)
    빅테크 CapEx 집행의 가장 확실한 길목
    변압기, 송전망, Vertiv, HD현대일렉트릭, Eaton
    ASIC & 반도체 IP/파운드리[비중 확대] (30%)
    NVIDIA 독주 완화 및 커스텀 TPU/ASIC 전환 수혜
    Broadcom, TSMC, HBM/CXL 패키징 장비사
    수직계열화 빅테크[분할 매수] (25%)
    FCF 훼손 우려로 조정 시 저가 매수
    Alphabet (GOOGL) – 자체 칩/네트워크 완비
    Big GPU 설계사[보유/트레이딩] (10%)
    여전히 강력하나 단가 압박 점검 필요
    NVIDIA – ASIC 침투율 및 클라우드 단가 추이 모니터링

    에필로그: 블로거의 최종 인사이트

    “토큰 1개를 만드는 생산 원가가 3년 만에 1,000배 떨어졌다는 것은, AI 기술의 종말이 아니라 ‘PC의 보급’이나 ‘인터넷 초고속망의 대중화’ 시대로 진입했음을 의미합니다.

    기술이 보편화되고 추론 서비스가 일상화되는 역사적 대전환기에는 단순 연산 칩을 파는 기업보다 ‘전력과 냉각을 공급하는 기업’, ‘원가 절감 소프트웨어 및 압축 아키텍처(PagedAttention/MLA)를 보유한 기업’, 그리고 ‘자체 공급망 수직계열화로 토큰 단가의 마지노선을 지키는 하이퍼스케일러’가 시장의 진짜 알짜 수익을 독식하게 될 것입니다.”

    관련 기사:

    https://www.hankyung.com/article/2026081868306