[태그:] 베라루빈

  • [2026.10.26] 엔비디아 루빈과 DSX POD: AI 팩토리 프리팹이 가져올 데이터센터 생태계의 혁명

    DSX POD 인포그래픽 이미지 대체 텍스트

메인 프로세스 (중앙 배너 및 타임라인):

AI 공장의 혁명: 공장에서 사전 제작(Prefabricated)되어 트럭으로 운송되는 모듈형 컨테이너 개념을 시각화했습니다.

공장 선통합 (Pre-Integration): '베라 루빈 플랫폼', '액체 냉각 시스템', '네트워킹'이 공장에서 미리 조립되고 완벽하게 검증되는 과정을 보여줍니다.

현장 즉시 배포 (On-Site Deployment): 현장 도착 후 크레인으로 하차하여 전력과 냉각수만 연결하면 바로 가동되는 시스템을 묘사했습니다. 이는 과거의 복잡한 현장 조립과 극명한 대조를 이룹니다.

핵심 차별점 및 효과 (좌우 섹션):

초고속 타임투마켓 (오른쪽 시계 아이콘): 기존 데이터센터 구축에 수개월이 걸리던 기간을 획기적으로 줄여, 비즈니스 경쟁력을 확보할 수 있음을 강조했습니다.

현장 리스크 차단 (스패너 및 물방울 아이콘): 휴먼 에러에 의한 누수나 오결선 위험을 공장 선검증으로 해결하여 품질을 보장합니다.

에너지 효율 및 친환경 (오른쪽 녹색 데이터센터): 효율적인 액체 냉각을 통해 PUE(전력 사용 효율 지수)를 최적화하고 탄소 배출을 줄이는 그린 데이터센터 이미지를 표현했습니다.

냉각 방식 비교 분석 (하단 섹션):

전통적 액체 냉각: 복잡하고 지저분한 배관, 위험성, 그리고 현장 작업자의 수고를 직관적으로 묘사했습니다.

DSX POD 액체 냉각 표준화: '퀵 디스커넥트(Quick-Disconnect)', '블라인드 메이트(Blind-Mate)', '랙 단위 전용 CDU' 등 정밀 기술이 레고 블록처럼 표준화되어 안전하고 간편하게 작동함을 보여줍니다.

경제 블로거 분석 (우측 하단):

투자자의 눈으로 본 시장 분석 아이콘과 차트를 함께 배치하여, 이 기술이 단순한 엔지니어링 혁신을 넘어 IT 인프라 벨류체인의 지각변동을 가져올 투자 기회임을 시사했습니다.

    오늘 이야기할 주제는 최근 글로벌 테크 및 데이터센터 시장을 뒤흔들고 있는 핵심 키워드, 바로 ‘DSX POD’와 ‘차세대 액체 냉각(Liquid Cooling) 표준화’입니다.

    생성형 AI의 규모가 조 단위 파라미터를 넘어 멀티모달, 에이전틱 AI로 진화함에 따라 데이터센터는 더 이상 단순한 ‘서버 보관 창고’가 아닙니다. 그것은 수십만 개의 고성능 칩셋이 맞물려 돌아가는 거대한 ‘AI 공장(AI Factory)’입니다. 그리고 이 AI 공장을 짓는 방식 자체가 통째로 뒤바뀌는 패러다임의 대전환이 일어나고 있습니다.

    1. DSX POD란 무엇인가? (엔지니어의 시선으로 본 본질)

    과거의 데이터센터를 구축하던 과정을 떠올려 보겠습니다. 건물을 짓고, 대규모 전력망을 끌어오고, 수천 대의 서버 랙을 일일이 바닥에 고정시킨 뒤, 수만 가닥의 전원 케이블과 네트워크 케이블을 현장에서 수작업으로 연결해야 했습니다. 이 거대하고 복잡한 프로세스 속에서 사소한 설계 오류나 현장 작업자의 휴먼 에러(Human Error)가 발생하면, 시스템을 가동하기도 전에 원인을 찾아 디버깅하는 데만 수개월이 걸리기 일쑤였습니다.

    💡 엔지니어의 한 줄 평

    “DSX POD는 서버와 네트워크를 따로 구매해 현장에서 조립하던 과거의 방식에서 벗어나, ‘AI 공장(AI Factory) 전체를 프리팹(Prefabricated, 사전 제작) 방식으로 통째로 트럭에 실어 나르는 혁신’입니다.”

    즉, DSX POD는 개별 부품의 집합이 아니라 데이터센터 인프라의 모듈화·완제품화를 의미합니다. 하드웨어, 전력 제어, 냉각 시스템, 네트워킹 토폴로지가 이미 공장에서 하나의 유기체로 결합되어 출하되는 완제품 데이터센터 모듈인 것입니다.

    2. 기술적 핵심 구조 분석: 무엇이 담겨 있는가?

    DSX POD가 전 세계 엔지니어들과 빅테크 기업들의 이목을 집중시키는 이유는 단순히 ‘컨테이너 박스에 서버를 쑤셔 넣었기’ 때문이 아닙니다. 그 내부를 채우고 있는 최첨단 엔지니어링의 정수 때문입니다.

    ① 베라 루빈(Vera Rubin) 플랫폼 중심의 설계

    엔비디아의 차세대 아키텍처인 루빈 기반 칩셋들은 기존 세대를 아득히 뛰어넘는 압도적인 연산 능력을 자랑하는 동시에, 전력 소모와 발열 역시 상상을 초월합니다. DSX POD는 이 고성능 칩셋들이 전력 드롭이나 스로틀링 없이 24시간 내내 최적의 성능을 낼 수 있도록, 정밀한 전력 공급 유닛(Power Shelf)부터 고밀도 연산 노드까지 랙 레벨에서 완벽하게 통합 설계되었습니다.

    ② 액체 냉각(Liquid Cooling) 시스템의 표준화

    이제 전통적인 공랭식(Air Cooling) 방식으로는 최신 AI 칩의 열을 감당할 수 없습니다. 문제는 현장에서 수백 개의 냉각 파이프를 직접 연결하고 고압 누수 테스트를 하는 과정이 엔지니어들에게는 엄청난 리스크였다는 점입니다. DSX POD는 이 복잡한 냉각 시스템을 공장에서 미리 완벽하게 밀폐하고 검증하여 출하합니다. 현장 엔지니어 입장에서는 이보다 더 반가운 소식이 없습니다.

    ③ 복잡한 케이블링과 네트워킹의 프리 인테그레이션(Pre-integration)

    초고속 인피니밴드(InfiniBand)나 고성능 이더넷 스위치 간의 케이블링은 미세한 임피던스 오차나 길이 불균형만 있어도 대역폭 병목을 유발합니다. 공장의 정밀 제어된 환경에서 이더넷 및 인피니밴드 토폴로지를 미리 구성(Pre-integration)하므로, 현장 불량률이 제로(0)에 수렴하게 됩니다.

    3. 패러다임의 전환: 왜 ‘컨테이너형 AI 팩토리’인가?

    표준 화물 컨테이너 규격을 활용한다는 것은 물류와 확장성의 극대화를 의미합니다.

    데이터센터 부지만 확보되어 있다면, 거대한 트레일러로 실려 온 DSX POD를 크레인으로 내려놓고 전력선과 광케이블만 메인그리드에 꽂으면 곧바로 가동 준비가 끝납니다. 항만이나 물류센터에서 전 세계 물류를 표준화했던 ‘컨테이너 모듈러 방식’을 IT 인프라 영역에 본격적으로 이식한 것입니다.

    여기서 주목해야 할 점은 델(Dell), HPE 같은 전통의 글로벌 하드웨어 명가들이 이 생태계에 대거 합류하고 있다는 사실입니다. 이는 개별 서버 판매 중심의 비즈니스 모델이 저물고, 이러한 통합 모듈형 디자인이 향후 글로벌 IT 인프라의 사실상의 표준(De Facto Standard)로 자리 잡을 것임을 명백히 시사합니다.

    4. 현업 엔지니어가 바라보는 기대 효과와 가치

    현업에서 대규모 인프라를 구축해본 엔지니어들이 DSX POD를 환호하는 이유는 명확합니다. 세 가지 핵심 가치로 요약할 수 있습니다.

    • ① ‘6개월 vs 14일’의 압도적인 타임투마켓(Time-to-Market) AI 비즈니스는 속도가 곧 생존입니다. 인프라 구축에 6개월을 허비하는 동안 경쟁사는 이미 차세대 파운데이션 모델 학습을 끝내고 시장을 선점할 수 있습니다. 구축 기간을 단 14일로 단축한다는 것은 기업의 비즈니스 민첩성을 수십 배 끌어올린다는 뜻입니다.
    • ② 현장 리스크(Human Error)의 원천 차단 현장 작업은 수많은 변수를 품고 있습니다. 숙련된 엔지니어가 부족한 글로벌 오지나 신흥국에서도 공장에서 검증된 모듈을 그대로 가져다 쓰기 때문에, 현장 작업자의 숙련도와 무관하게 완벽한 품질을 보장받을 수 있습니다. 배관 누수나 케이블 오결선 같은 인재(人災)를 원천 차단하는 것입니다.
    • ③ 에너지 효율과 친환경 (Green Data Center) 전력 대란 시대에 데이터센터의 PUE(전력 사용 효율 지수)는 기업의 생존을 가르는 척도입니다. 액체 냉각 시스템과 지능형 전력 제어 소프트웨어가 하드웨어와 유기적으로 결합되어 있어, 불필요하게 버려지는 에너지를 최소화하고 탄소 배출 규제에 유연하게 대응할 수 있습니다.

    5. 왜 액체 냉각(Liquid Cooling)인가? (기본 원리 파헤치기)

    앞서 DSX POD의 핵심 경쟁력으로 액체 냉각을 언급했습니다. 왜 하필 액체일까요? 컴퓨터 하드웨어를 식히는 매체는 결국 공기(Air) 아니면 액체(Liquid)입니다. 두 방식의 물리적 차이를 짚어보겠습니다.

    • 공랭식의 치명적 한계: 공기는 열을 흡수하고 전달하는 능력(비열 및 열전도율)이 현저히 낮습니다. 현재 엔비디아의 차세대 칩셋들처럼 하나의 패키지에서 수천 와트의 열이 뿜어져 나오는 상황에서 공기로 이를 식히려면, 감당할 수 없을 정도로 거대한 방열판과 소음이 장난 아닌 대형 팬을 고속으로 돌려야 합니다. 물리적인 공기 통로(Airflow)를 더 이상 확보할 수 없는 ‘쿨링의 종점’에 다다른 것입니다.
    • 액체 냉각의 근본적 우위: 물(또는 특수 절연 냉각액)은 공기보다 열을 품고 운반하는 능력이 수십 배 뛰어납니다. 보통 서버 내부에서는 고성능 칩 위에 콜드 플레이트(Cold Plate)를 밀착시키고, 그 안으로 차가운 냉각수를 순환시켜 열을 초고속으로 흡수해 밖으로 배출하는 직접 냉각(Direct-to-Chip, DTC) 방식을 주로 사용합니다.

    6. 전통적 액체 냉각 vs DSX POD 모던 프리팹: 무엇이 다른가?

    과거의 슈퍼컴퓨터나 일부 하이엔드 데이터센터에서도 액체 냉각을 시도한 바 있습니다. 하지만 현업 엔지니어들을 치를 떨게 만들었던 것은 바로 ‘현장 조립의 악몽’이었습니다. 둘의 차이를 명확하게 비교해 드립니다.

    구분전통적 액체 냉각 방식 (Traditional)엔비디아 DSX POD 방식 (Modern Prefab)
    구축 시점데이터센터 현장(On-site)에서 개별 조립 및 설치공장(Factory)에서 랙 단위 완제품 조립 완료
    배관 및 연결현장 엔지니어가 직접 파이프를 자르고 용접·체결하며 수작업 진행공장에서 정밀 제어된 퀵 디스커넥트(Quick-Disconnect)로 원클릭 체결
    검증 및 리스크현장에서 조립 후 압력 테스트 및 누수 검사 (휴먼 에러 위험 큼)공장 클린 환경에서 완벽한 기밀·누수 테스트 거쳐 출하
    시스템 통합냉각 유닛(CDU), 펌프, 서버 랙, 소프트웨어가 각각 따로 놀거나 수동 연동전력·네트워크·냉각 시스템이 하나의 오케스트레이션 소프트웨어로 완전 통합

    7. DSX POD 액체 냉각의 결정적 차별점 3가지

    ① ‘퀵 디스커넥트(Quick-Disconnect)’와 블라인드 메이트(Blind-Mate) 기술

    과거에는 서버 한 대를 유지보수하려고 파이프를 분리할 때 냉각수가 미세하게 흘러나와 고가의 메인보드를 태워먹는 사고가 엔지니어들의 가장 큰 공포였습니다. DSX POD에 적용된 최신 냉각 구조는 레고 블록을 끼우듯 장비를 밀어 넣기만 하면 파이프가 자동으로 완벽하게 결합되고, 분리할 때도 단 한 방울의 누수도 허용하지 않는 정밀 커플링 기술이 랙 레벨에서 완벽하게 표준화되어 있습니다.

    ② 공장 선행 검증(Pre-integration)을 통한 ‘제로 누수’ 보장

    데이터센터 현장은 변수가 너무 많습니다. 현장 작업자가 파이프 이음새를 미세하게 덜 조이거나 오결선하면 몇 달 뒤 대형 누수 사고로 이어져 수십억 원의 손실을 초래합니다. DSX POD는 이 모든 배관 작업을 먼지 없는 공장에서 로봇과 정밀 설비로 미리 마치고, 엄격한 고압 압력 테스트까지 완벽하게 통과한 상태로 트럭에 실어 보냅니다. 현장에서는 그냥 전원과 대형 메인 냉각 페이퍼만 꽂으면 끝입니다.

    ③ 루빈(Rubin) 플랫폼의 초고발열을 견디는 ‘랙 단위 전용 CDU(Coolant Distribution Unit)’ 최적화

    차세대 AI 아키텍처는 랙당 전력 밀도가 수십 킬로와트를 가볍게 넘어섭니다. 전통적 방식은 랙과 냉각 분배 유닛(CDU)의 규격이 뒤섞여 효율이 떨어졌지만, DSX POD는 엔비디아의 차세대 칩셋 발열 특성에 맞춰 냉각수의 유량, 펌프 압력, 센서 모니터링 시스템이 완벽하게 일체화되어 있습니다.

    엔지니어의 총평

    한마디로 과거의 액체 냉각이 ‘특급 기술자들의 손에 의존하던 수제 공예’였다면, DSX POD의 액체 냉각은 ‘공장에서 오차 없이 찍어내어 누구나 안전하게 쓸 수 있는 가전제품 같은 혁신’입니다. 이 냉각 표준화 덕분에 수개월 걸리던 데이터센터 세팅이 단 14일 만에 끝날 수 있는 것입니다.

    8. 투자자 관점에서 바라본 시장 파급효과와 수혜주 분석

    자, 기술적인 분석은 이쯤 하고 우리 같은 투자자들에게 가장 중요한 ‘돈이 되는 관점’으로 시선을 옮겨보겠습니다. 이러한 인프라 패러다임의 전환은 주식 시장에서 어떤 의미를 가질까요?

    1. 하드웨어 벨류체인의 지각변동 (Dell, HPE 등 통합 솔루션 기업) 서버 부품을 단순 조립해 납품하던 기업들은 마진 압박에 시달릴 것입니다. 반면, DSX POD와 같은 완제품 모듈러 아키텍처를 선제적으로 도입하고 공급할 수 있는 시스템 인테그레이터(SI) 및 대형 하드웨어 제조사(Dell, HPE 등)는 높은 부가가치를 창출하며 새로운 해자(Moat)를 구축하게 됩니다.
    2. 액체 냉각 및 특수 부품 생태계의 고성장 냉각수 분배 유닛(CDU), 퀵 커플링(Quick Disconnect) 밸브, 콜드 플레이트, 그리고 특수 절연 냉각액을 제조하는 전문 기업들은 더 이상 틈새시장이 아닙니다. AI 데이터센터의 필수 스탠다드가 되면서 폭발적인 매출 성장이 담보되는 핵심 섹터로 자리매김하고 있습니다.
    3. 데이터센터 건설 및 전력 인프라(Energy & Grid)의 효율성 제고 부지 선정부터 완공까지 걸리는 시간이 획기적으로 줄어들면서, 빅테크 기업들의 AI 인프라 투자(CAPEX) 집행 속도가 더욱 가속화될 것입니다. 이는 곧 전력망, 변압기, SMR 및 신재생 에너지 인프라 수요로 직접 이어지는 선순환 구조를 만들어냅니다.

    맺음말

    DSX POD처럼 하드웨어, 액체 냉각, 고속 네트워킹, 그리고 배포 프로세스까지 일괄적으로 묶어낸 레퍼런스 디자인은 다가오는 AI 시대를 지탱하는 가장 튼튼한 이정표입니다.

    기술의 본질을 깊이 이해하고, 그 기술이 만들어내는 산업의 구조적 변화를 남보다 한 발짝 앞서 읽어내는 것—이것이 바로 불확실한 시장에서 우리 자산을 지키고 현명하게 불려 나가는 가장 확실한 지혜입니다.

    오늘 포스팅이 여러분의 IT 인사이트와 투자 전략 수립에 깊은 영감이 되었기를 바랍니다. 앞으로도 시장의 본질을 꿰뚫는 날카로운 분석으로 찾아오겠습니다. 성공적인 투자와 멋진 하루 되시길 바랍니다!

    관련 기사:
    https://www.mediapic.co.kr/news/articleView.html?idxno=3686

  • [2026.08.25] 엔비디아 그록3(Groq3) LPX 랙 양산과 AI 반도체 패러다임의 대전환: SRAM vs HBM 구조 분석 및 밸류체인 투자 전략

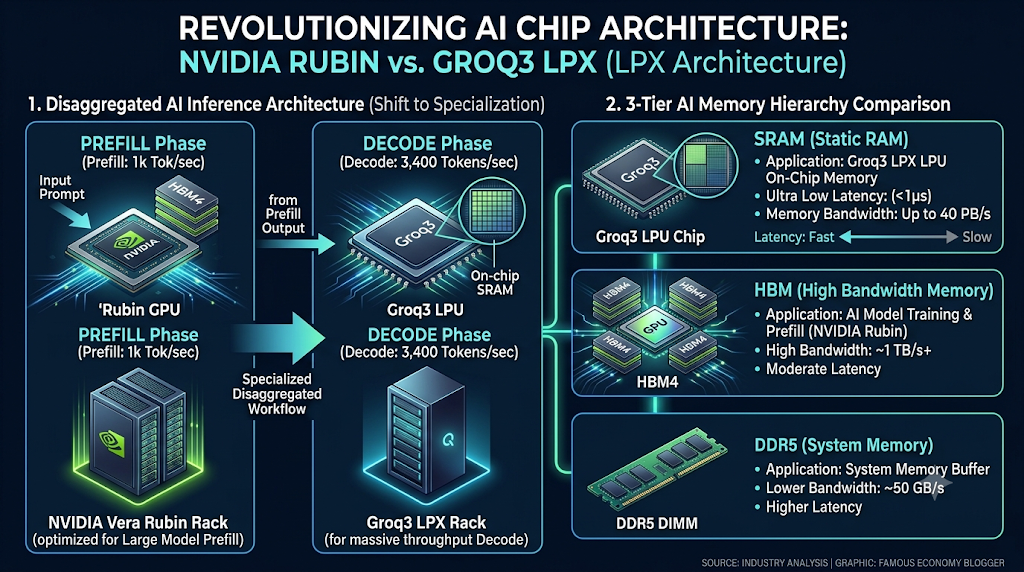
    엔비디아 그록랙 구조
디스어그리게이티드 추론 구조 (Disaggregated AI Inference Architecture)

Rubin GPU (HBM4): 입력 데이터 분석 및 문맥 파악을 전담하는 Prefill 단계

Groq3 LPU (On-chip SRAM): 초당 3,400 토큰 생성을 전담하는 초저지연 Decode 단계

3단계 메모리 계층 구조 비교 (3-Tier Memory Hierarchy)

SRAM: Ultra Low Latency / 40 PB/s Bandwidth (실시간 순차 토큰 생성)

HBM: High Bandwidth / Large Capacity (학습 및 병렬 연산)

DDR5: System Memory Buffer (대용량 KV 캐시 및 백업)

디자인 톤앤매너: 글로벌 테크 및 금융 분야에 어울리는 다크 네이비 & 네온 블루/그린 아키텍처 비주얼로 완성되었습니다.

    📌 엔비디아 그록3 LPX Executive Summary

    1. 역대 최대 라이선스 계약의 상용화: 엔비디아가 200억 달러(약 27조 원) 규모의 라이선스 계약으로 확보한 그록(Groq) 기술 기반 ‘그록3 LPX’ 랙 양산에 돌입했습니다. 네오클라우드 네비우스(Nebius) 데이터센터에 베라 CPU, 루빈 GPU와 함께 첫 배치되며 올해 말 가동됩니다.
    2. 추론 시장의 게임 체인저 (Disaggregated Architecture): 프롬프트 입력(Prefill)은 고성능 GPU(루빈)가, 실시간 응답 토큰 생성(Decode)은 초저지연 SRAM 기반 LPU(그록3)가 분담하는 ‘디스어그리게이티드(분산) 추론’이 본격 적용됩니다.
    3. 압도적인 초저지연 성능: Gemma 4 31B 모델(10만 토큰 컨텍스트) 기준 초당 3,400 토큰을 처리하며, 경쟁사 대비 최대 4배 빠른 반응성을 확보하여 실시간 AI 코딩 및 에이전트 서비스의 핵심으로 부상했습니다.
    4. 투자의 패러다임 변화: ‘GPU + HBM’ 단일 공식에서 벗어나 SRAM, 비메모리 OSAT/테스트, 대면적 FC-BGA 기판, CPO(광반도체), 데이터센터 전력 인프라 중심으로 수혜주 밸류체인이 이동합니다.

    1. 서론: AI 데이터센터 시장의 미세 균열과 대변혁의 시작

    AI 반도체 시장을 수년간 지배해 온 패러다임은 명확했습니다. “더 커다란 GPU에 더 넓은 대역폭의 HBM(고대역폭 메모리)을 부착하여 거대한 단일 클러스터로 묶는다.” 이 공식은 거대언어모델(LLM)의 사전 학습(Training) 및 대규모 컨텍스트 입력 처리에는 최적의 성능을 발휘해 왔습니다.

    하지만 AI 시장의 중심축이 단순 모델 개발과 학습을 넘어 실질적인 상용 서비스, 즉 ‘AI 에이전트(AI Agent)’, ‘실시간 자율 코딩’, ‘초저지연 대화형 AI’ 형태의 추론(Inference) 단계로 빠르게 이동함에 따라 기존 GPU 단일 구조의 치명적인 한계가 드러나기 시작했습니다.

    가장 큰 문제는 바로 ‘디코드(Decode) 단계에서의 메모리 병목 현상’입니다. AI 모델이 응답 토큰을 하나씩 순차적으로 생성할 때, GPU 내부 연산기(ALU)는 일거리가 부족해 노놀 정도로 놀고 있는 반면, 외부 메모리에서 파라미터 가중치를 지속적으로 읽어오는 과정에서 거대한 연산 지연(Latency)이 발생합니다. 이는 곧 서비스 운영 비용의 증가와 사용자 경험의 저하로 직결됩니다.

    이러한 상황에서 글로벌 AI 반도체 대장주인 엔비디아(NVIDIA)가 마침내 파격적인 카드를 꺼내 들었습니다. 지난해 12월 사상 최대 규모인 200억 달러(약 27조 원)를 들여 인수한 초저지연 추론 칩 스타트업 ‘그록(Groq)’의 기술을 마침내 자사의 차세대 데이터센터 플래그십 아키텍처인 ‘베라 루빈(Vera Rubin)’ 플랫폼의 전용 추론 가속 랙인 ‘그록3 LPX(Groq3 LPX)’ 형태로 상용화 및 본격 양산에 들어갔다고 공식 발표했습니다.

    2. 엔비디아의 결단: 200억 달러 거래의 결실, 그록3 LPX 양산 본격화

    엔비디아는 네오클라우드(Neo Cloud) 주요 공급업체인 네비우스(Nebius)의 데이터센터를 시작으로 그록3 LPX 랙 배치를 개시했다고 밝혔습니다. 이번 배치는 엔비디아의 차세대 CPU인 ‘베라(Vera)’ 및 차세대 flagship GPU인 ‘루빈(Rubin)’과 함께 병렬 결합 형태로 이루어지며, 올해 말 본격적인 가동을 앞두고 있습니다.

    엔비디아 최고경영자(CEO) 젠슨 황(Jensen Huang)은 지난 3월 베라루빈 및 그록3 LPX 공개 행사에서 다음과 같이 선언한 바 있습니다.

    “코딩 및 초저지연 애플리케이션을 위해 마련된 데이터센터 공간의 최소 4분의 1(25%)을 그록 랙에 할당하고, 나머지 75%는 100% 베라루빈 NVL72 GPU 시스템으로 채울 것입니다.”

    이는 단순한 단일 칩 세일즈가 아니라 데이터센터 전체 공간과 전력 배분을 철저히 워크로드 성격에 맞춰 재구성하겠다는 의지입니다.

    💡 엔지니어링 인사이트: 왜 네오클라우드 네비우스인가?

    네비우스와 같은 네오클라우드 업체들은 기존 빅테크(Hyperscaler)와 달리 최신 AI 추론 워크로드를 유연하게 수용하고, 토큰당 최고 단가를 매길 수 있는 프리미엄 API 서비스(Token Factory)를 서비스화하는 데 집중합니다. 디온 해리스 엔비디아 AI 인프라 책임자가 언급했듯, 초저지연 토큰 생성 능력은 코딩 에이전트, 실시간 음성 통화 API 등에서 사용자에게 고가의 프리미엄 서비스 요금을 부과할 수 있는 핵심 차별화 요소가 됩니다.

    3. 그록3 LPX 랙의 기술 스펙 및 하드웨어 구성 심층 분석

    엔비디아가 공개한 그록3 LPX 랙의 실제 하드웨어 스펙은 반도체 엔지니어링 관점에서 대단히 파격적인 수치들로 가득 차 있습니다. 정밀 검증된 칩 단위 및 랙 단위의 세부 하드웨어 명세는 다음과 같습니다.

    3.1. LPU 칩 단위 vs LPX 랙 단위 하드웨어 스펙 비교

    그록의 핵심 가속기인 LPU(Language Processing Unit)는 고속 연산 장치와 온칩 SRAM이 1:1로 밀접하게 결합된 특수 목적용 반도체(ASIC)입니다. 1개의 LPU 칩에는 500메가바이트(MB)의 SRAM이 고밀도로 적층되어 있으며, 칩 내부 대역폭은 초당 150테라바이트(TB/s)에 달합니다. 엔비디아는 이 LPU 칩 256개를 단일 LPX 랙 안에 상호 초연결망으로 집적시켰습니다.

    구분 항목칩(LPU) 1개 단위랙(LPX) 전체 (256개 LPU)기술적 의의 및 비고
    SRAM 용량 (On-chip)500 MB128 GB외부 DRAM 경유 없이 칩 내에서 초고속 처리
    SRAM 내부 대역폭150 TB/s40 PB/s (40,000 TB/s)지연시간(Latency)을 피코초(ps) 수준으로 축소
    스케일업(Scale-up) 대역폭2.5 TB/s640 TB/s256개 칩을 단일 논리 메모리로 묶는 상호연결망
    DDR5 보조 시스템 메모리–12 TB대규모 컨텍스트 및 KV 캐시 오프로드 백업용

    ※ 기사에 언급된 “5억 MB SRAM”은 오기이며, 실제 스펙은 칩당 500MB, 랙 전체(256개 칩) 기준 128GB SRAM이 정확한 수치입니다.

    128GB라는 용량이 숫자로만 보면 HBM(수 TB 단위) 대비 작아 보일 수 있으나, 초당 40페타바이트(PB/s)라는 압도적인 대역폭이 조합됨으로써 순차 토큰 생성 속도에서 비교 불가능한 성능을 발휘하게 됩니다.

    3.2. 벤치마크 성능: Gemma 4 31B 및 실시간 작업에서의 성능 혁신

    독립 AI 벤치마크 평가 기관인 아티피셜 애널리시스(Artificial Analysis)의 최신 테스트 결과에 따르면, 그록3 LPX 랙 시스템에서 Gemma 4 31B 모델을 100,000(10만) 토큰의 컨텍스트 환경에서 실행했을 때, 초당 3,400 출력 토큰(Tokens/sec)이라는 처리 속도를 기록했습니다.

    이는 현재 시장에 존재하는 어떠한 동일 규모 GPU 클러스터 랙과 비교해도 최대 4배 이상 빠른 응답성(Responsiveness)입니다. 인간이 1초에 읽을 수 있는 글자 수가 대략 10~20 토큰 수준임을 감안할 때, 초당 3,400 토큰은 인간의 인지 속도를 완전히 초월한 수치이며, 대규모 소스 코드를 실시간으로 분석하고 수정안을 즉시 반환해야 하는 ‘에이전틱 AI 코딩 워크로드’에서 절대적인 위력을 발휘합니다.

    4. 데이터센터 아키텍처의 격변: 디스어그리게이티드(Disaggregated) 추론의 등장

    4.1. 베라 루빈(Vera Rubin) 모듈식 랙 생태계에서의 위치

    그록3 LPX 랙은 독립 제품이 아니라 엔비디아가 새롭게 제시하는 베라 루빈(Vera Rubin) 랙 스케일 토탈 인프라를 구성하는 5가지 핵심 목적별 랙 중 하나로 완벽히 통합 배치됩니다.

    • 베라루빈 NVL72 GPU 랙: 대규모 연산 및 모델 학습, 입력 프리필(Prefill) 전담
    • 베라 CPU 랙: 데이터센터 전체 관리, 오케스트레이션 및 파이프라인 스케줄링
    • 그록3 LPX 추론 가속 랙: 초저지연 디코드(Decode) 및 순차 토큰 생성 전담
    • 블루필드-4 STX 스토리지 랙: 데이터 초고속 I/O 및 보안 오프로드
    • 스펙트럼-6 SPX 이더넷 랙: 랙 간 초고속 데이터 통신 네트워크 제어

    이 시스템을 구동하기 위해 엔비디아는 베라 CPU, 루빈 GPU, NVLink 6 스위치, ConnectX-9 SuperNIC, BlueField-4 DPU, Groq3 LPU, 그리고 실리콘 포토닉스 기반 Spectrum-X CPO 스위치 등 총 7종의 신규 반도체 칩을 동시 양산 체제로 전환시켰습니다.

    4.2. 기존 동종 GPU 클러스터 vs 신규 디스어그리게이티드 구조 비교

    기존 AI 데이터센터는 동일한 동종(Homogeneous) GPU를 촘촘히 배열하고, 이 GPU 클러스터가 입력 데이터 처리(Prefill)와 출력 토큰 생성(Decode)을 순차적으로 모두 수행하는 방식이었습니다.

    🔄 워크로드 분리(Disaggregation)의 핵심 메커니즘

    LLM 추론 워크로드는 크게 두 단계로 나뉩니다.

    1. Prefill (프리필) 단계: 수천~수십만 자의 프롬프트를 한 번에 읽고 컴퓨팅하는 단계. 대규모 병렬 연산력과 고용량 메모리(HBM)가 필수적이므로 루빈 GPU가 전담합니다.
    2. Decode (디코드) 단계: 앞선 문맥을 바탕으로 단어를 한 개씩 순차적으로 생성해 나가는 단계. 연산량 자체는 적지만 매 토큰 생성마다 메모리 가중치를 읽어와야 하므로 초저지연 메모리 대역폭(SRAM)이 핵심입니다. 이를 그록 LPU가 전담합니다.

    기존에는 비싼 HBM과 수천 개의 Tensor core를 갖춘 GPU가 디코드 단계에 묶여 있으면서 메모리 병목 때문에 연산 자원을 90% 이상 놀리는 극심한 비효율이 발생했습니다. 엔비디아는 프리필과 디코드를 물리적인 랙 수준에서 분리하여, “각 작업 특성에 가장 완벽히 부합하는 프로세서와 메모리를 배치하는 분산 아키텍처”로 변혁을 완료했습니다.

    5. 메모리 반도체 3대 매체(SRAM vs HBM vs DDR5)의 역할 및 특성 비교

    AI 가속기에 사용되는 대표적인 3가지 메모리 반도체 매체의 물리적·구조적 차이점을 이해해야 향후 반도체 주식 투자의 방향성을 잡을 수 있습니다.

    구분 항목SRAM (Static RAM)HBM (High Bandwidth Memory)DDR5 (System DRAM)
    시스템 내 주요 역할LPU 온칩 초저지연 캐시/메모리GPU 대규모 병렬 연산 메인 메모리랙 단위 대용량 KV 캐시 보조 버퍼
    적용 시스템 예시그록3 LPX (칩당 500MB / 랙당 128GB)루빈, 블랙웰 NVL72 GPU 등그록3 LPX 랙 (랙당 12TB)
    대역폭 (Bandwidth)극상 (랙당 40 PB/s)상 (초당 수 TB/s 수준)중 (초당 수백 GB/s 수준)
    지연시간 (Latency)최저 (수 피코~나노초 이하)보통 (DRAM 특성상 SRAM보다 느림)높음 (버스 통신 지연 존재)
    비용 및 단가극도로 비쌈 (트랜지스터 6개/Bit)고가 (TSV 적층 및 첨단 패키징)상대적 저렴 (면적 대비 용량 큼)
    집적도 및 용량 한계매우 낮음 (칩당 MB 단위 제한)높음 (수십~수백 GB 단위)극대 (TB~PB 단위 확장 용이)

    5.1. SRAM: 그록 LPU의 초저지연을 가능케 하는 무기

    SRAM은 1비트의 데이터를 저장하는 데 6개의 트랜지스터(6T)를 사용합니다. 전원이 공급되는 동안 커패시터 재충전(Refresh) 동작이 필요 없으므로 반응 속도가 비약적으로 빠릅니다. 그록 LPU는 외부 메모리 인터페이스를 거치지 않고, 칩 내부(On-chip) 연산기 바로 옆에 SRAM을 배치하여 데이터 전송 지연시간을 제로에 가깝게 줄였습니다.

    단점은 셀 면적이 너무 커서 칩 하나의 실리콘 다이에 탑재할 수 있는 용량이 500MB 수준에 불과하다는 점입니다. 엔비디아와 그록은 이 한계를 256개의 칩을 640TB/s 초고속 초연결 망(Scale-up Interconnect)으로 묶어 랙 전체를 하나의 128GB 대형 논리 SRAM 풀로 구현함으로써 극복했습니다.

    5.2. HBM: 여전한 학습 및 대규모 데이터의 왕좌

    HBM은 DRAM 다이를 수직으로 8층, 12층, 16층 쌓아 올린 후 TSV(관통실리콘비아)로 연결한 초고속 메모리입니다. 대용량 파라미터를 한 번에 올려놓고 병렬 연산을 퍼부을 수 있어 학습(Training)과 대규모 프롬프트 입력(Prefill)에는 대체 불가능한 핵심 매체입니다. 그러나 DRAM의 근본적인 한계인 억세스 레이턴시(Latency)가 존재하므로, 토큰을 1개씩 만들어내는 순차 디코드 과정에서는 대역폭 소모 대비 효율이 급격히 떨어지는 현상이 발생합니다.

    5.3. DDR5: 대용량 백업 스토리지 및 파라미터 오프로드

    그록3 LPX 랙에 설치된 12TB의 DDR5는 실시간 토큰 생성에 직접 참전하기보다는, 128GB SRAM 범위를 넘어서는 대규모 모듈 가중치나 이전 대화 문맥(KV Cache) 데이터를 임시 보존하고 필요시 SRAM으로 고속 교체(Swapping)해 주는 백업 창고 역할을 담당합니다.

    6. 빅테크 진영 간 랙 단위(Rack-Scale) 아키텍처 대격돌: 엔비디아 vs AMD

    AI 반도체 전쟁은 단품 칩 판매에서 데이터센터 전체를 랙 단위로 패키징하여 공급하는 ‘랙 스케일 시스템 경쟁’으로 격화되었습니다. 특히 AMD 역시 반도체 스타트업 세레브라스(Cerebras)와 손을 잡고 이에 강력히 맞서고 있습니다.

    비교 항목엔비디아 연합 (Vera Rubin NVL72 + Groq3 LPX)AMD + 세레브라스 연합 (Helios + CS-4 랙)
    핵심 칩 구성Rubin GPU 72개 + Vera CPU 36개 + Groq3 LPU 256개MI300X/MI350X GPU 랙 + Cerebras CS-4 (WSE-3T) 3개
    온칩 SRAM 용량128 GB (Groq LPX 랙 기준)132 GB (CS-4 랙 기준)
    SRAM 대역폭40 PB/s (초당 40,000 TB)129.6 PB/s (초당 129,600 TB)
    HBM 총 용량 및 대역폭20.7 TB (HBM4) / 1,580 TB/s13.8 TB ~ 20.7 TB (HBM3e/4) / 380~580 TB/s
    DDR5 확장성12 TB (랙 내부 버퍼)최대 1.2 PB (MemoryX 단일 주소 매핑)
    상용화 실사례 및 속도네비우스 (초당 3,400 토큰 / Gemma 4 31B)오픈AI 울트라패스트 모드 (초당 750 토큰)

    6.1. SRAM 대역폭 관점에서의 분석

    AMD와 세레브라스 연합은 거대한 단일 실리콘 웨이퍼 전체를 하나의 칩으로 만드는 ‘웨이퍼 스케일 엔진(WSE-3T)’을 사용합니다. 수치상 SRAM 대역폭이 129.6 PB/s에 달해 엔비디아+그록(40 PB/s)을 앞섭니다. 하지만 세레브라스 방식은 단일 웨이퍼 수율 문제와 수리성, 열관리 난이도가 극도로 높습니다. 반면 엔비디아+그록 조합은 모듈식 디스어그리게이션 구조를 채택하여 생산 수율과 인프라 확장성, NVLink 수평 생태계와의 통합 운용성에서 훨씬 뛰어난 고객 편의성을 제공합니다.

    6.2. HBM 대역폭 관점에서의 분석

    학습 및 대규모 가중치 처리의 핵심인 HBM 대역폭에서는 차세대 HBM4를 선제 적용한 엔비디아 베라 루빈(1,580 TB/s)이 AMD 헬리오스 랙을 큰 폭으로 앞서고 있습니다. 결국 두 공룡 모두 “HBM(대용량) + SRAM(초저지연) + DDR5(백업)”라는 3단계 하이브리드 메모리 아키텍처로 수렴하고 있음을 확인할 수 있습니다.

    7. 파운드리 및 공급망(Supply Chain)의 구조적 재편

    엔비디아의 그록3 LPX 랙 상용화는 반도체 파운드리 생태계에도 거대한 지각변동을 일으키고 있습니다. 바로 파운드리 이원화(Dual Sourcing)입니다.

    🌐 공급망 리스크 분산 전략

    기존 엔비디아의 주력 GPU(블랙웰, 루빈)는 전량 대만 TSMC의 첨단 공정과 CoWoS 패키징에 의존하고 있습니다. 그러나 그록3 LPU 칩은 삼성전자 파운드리(평택/테일러 4nm 공정)가 전량 생산을 맡고 있습니다. 엔비디아는 M&A 및 기술 라이선스 방식을 통해 포트폴리오를 다변화하는 동시에, TSMC에 몰려 있던 첨단 공정 병목 리스크를 삼성전자 파운드리로 분산시키는 고도의 전략을 펼치고 있습니다.

    이는 삼성전자 파운드리 사업부에 단비와 같은 가동률 상승 및 기술 검증의 기회를 제공하며, 대만 외 지정학적 리스크에 대비하려는 글로벌 빅테크들에게 매우 중요한 이원화 이정표가 될 것입니다.

    8. 유명 경제 블로거의 투자 가이드: 수혜주 심층 분석 및 포트폴리오 전략

    주식 투자 관점에서 엔비디아의 그록3 LPX 양산 소식은 명확한 시그널을 던지고 있습니다. 기존 “AI 반도체 = 무조건 HBM 관련주”라는 단순한 투자의 공식이 깨지고 있다는 점입니다.

    8.1. 단기적 관점 (6개월 ~ 1년): 확실한 밸류체인 직수혜주 모멘텀

    단기적으로는 모멘텀이 확실한 파운드리 디자인하우스, 고다층 PCB, FC-BGA 기판, 비메모리 OSAT 및 전력 인프라 기업으로의 수급 쏠림이 가시화될 것입니다.

    ① 삼성전자 파운드리 생태계 (DSP / 디자인하우스)

    • 삼성전자 (005930): 그록3 LPU 4나노 위탁생산을 전담하며 파운드리 가동률 상승 및 턴어라운드 계기 마련. 초기 그록 지분 투자자로서 투자 자산 가치 재평가 유효.
    • 가온칩스 / AD테크놀로지 / 세미파이브: 삼성 파운드리 핵심 DSP 라인업으로, 글로벌 빅테크들의 추론용 ASIC 및 LPU 개발 주문 증가에 따른 직접적 실적 수혜.

    ② 고다층 PCB 및 고부가가치 패키지 기판 (FC-BGA)

    • 이수페타시스 (007660): 랙 단위 초고속 통신(Spectrum-6, NVLink) 가동에 따라 초고다층 MLB(Multi-Layer Board) PCB 수요 폭발.
    • 삼성전기 (009150): SRAM 기반의 초고밀도 다이가 256개 탑재되는 LPX 랙 및 베라루빈 랙용 대면적, 고층수 FC-BGA 공급 확대로 강력한 리레이팅 기대.

    ③ 비메모리 OSAT 및 특화 테스트 소켓

    • ISC (095070) / 리노공업 (058470) / 두산테스나 (131970): 기존 HBM 단순 메모리 검사 장비와 달리, 고주파·저지연 LPU/ASIC 칩을 검사하기 위한 초고속 테스트 소켓 및 외주 테스트(OSAT) 수요 급증.

    ④ 데이터센터 전력 및 신호 인프라

    • HD현대일렉트릭 (267260) / LS ELECTRIC (010120): 랙당 전력 소모량이 수십~수백 kW 단위로 폭증함에 따라, 반도체 아키텍처 변혁과 무관하게 강력한 단기 및 중기 실적 모멘텀 유지.

    8.2. 중장기적 관점 (1년 ~ 3년): AI 시장 재편에 따른 전략적 엑시트 & 재배치

    구분주요 대상 종목 / 분야중장기 영향 및 대응 투자 전략
    기존 HBM 독점 밸류체인SK하이닉스, 한미반도체 등[리스크 관리] HBM 수요가 당장 줄지는 않으나, “HBM 없이는 AI가 불가능하다”는 고평가 프리미엄 약화. 반등 시 비중 축소 전략 유효.
    첨단 패키징 & CPO (광반도체)에스티아이, 이오테크닉스, 제너셈 등[비중 확대] 랙당 640TB/s ~ 129.6PB/s 대역폭 감당을 위한 실리콘 포토닉스(CPO) 및 2.5D/3D 패키징 장비 필수화.
    ASIC 파운드리 & IP삼성전자 파운드리 및 가온칩스[비중 확대] 빅테크들의 자체 ASIC 및 추론용 LPU 채택 확대에 따른 TSMC 대안으로서의 가치 상승.

    8.3. 모델 포트폴리오 가이던스 (Portfolio Allocation)

    📊 추천 포트폴리오 비중 배분

    • 단기 트레이딩 섹터 (비중 30~40%): 삼성전기, 이수페타시스, ISC, 가온칩스 중심 구성. 엔비디아 및 AMD의 랙 양산 가동 실적 및 네비우스 데이터센터 매출이 가시화되는 시점까지 주가 모멘텀 극대화 전략.
    • 중장기 롱(Long) 섹터 (비중 40~50%): 삼성전자(메모리 단점 상쇄 및 파운드리 대반격 수혜), HD현대일렉트릭/LS ELECTRIC(전력망 독점력).
    • HBM 편중 종목 리스크 헤지 (비중 10~20% 축소 유도): HBM 단일 모멘텀으로 PBR 멀티플이 과도하게 상승한 고평가 장비주는 실적 발표 시점마다 이익 실현 후 비메모리/ASIC 테스터 및 CPO 수혜주로의 교체 매매 권장.

    9. 결론: AI 반도체 2.0 시대, 투자자가 가져야 할 자세

    엔비디아의 그록3 LPX 랙 본격 양산 선언은 단순한 신제품 출시 뉴스에 그치지 않습니다. 이는 AI 반도체 시장이 ‘GPU 단일 독주 시대(AI 1.0)’에서 ‘이종 가속기 결합 및 디스어그리게이티드 추론 시대(AI 2.0)’로 완벽히 진화했음을 알리는 거대한 분수령입니다.

    입력 데이터 처리(Prefill)와 출력 토큰 생성(Decode)이 분리되고, HBM과 SRAM, DDR5가 각자의 위치에서 최적의 연산 효율을 극대화하는 시대입니다.

    투자자 여러분 역시 과거의 성공 방정식이었던 “HBM 일변도” 관성에서 벗어나, 초저지연 SRAM 생태계, 대면적 FC-BGA 기판, 비메모리 특화 테스트 소켓, 그리고 CPO 및 전력 인프라라는 차세대 밸류체인으로 유연하게 시선을 넓혀야 할 때입니다.

    변화의 흐름을 가장 먼저 읽고 하드웨어 구조의 본질을 파악하는 자만이 거친 기술주의 파도 속에서 지속 가능한 압도적 수익률을 쟁취할 수 있을 것입니다.

    관련 기사:

    https://n.news.naver.com/mnews/article/293/0000089490

  • [2026.08.07]우주는 데이터센터의 미래인가: 스페이스X ‘스타마인드 AI’ 집중 분석

    스페이스X '스타마인드 AI' 프로젝트 분석 및 인포그래픽 대체 텍스트
[블로거의 서문]

안녕하십니까. 유명 경제 블로거입니다.

IT 인프라 산업에서 가장 큰 병목 중 하나는 데이터센터의 전력 수급과 냉각 문제입니다. 전 세계 빅테크 기업들이 원자력 발전소까지 계약하며 지상 데이터센터의 한계를 넘으려 애쓰는 지금, 일론 머스크의 스페이스X는 아예 데이터센터를 우주로 띄우겠다는 파격적인 해법을 내놓았습니다.

바로 '스타마인드 AI(StarMind AI)' 프로젝트입니다.

이 프로젝트는 단순히 위성을 띄우는 것이 아니라, 궤도 상에 대규모 AI 데이터센터를 구축하는 것을 목적으로 합니다. 성공한다면 지상의 전력, 용수, 규제 한계를 한 번에 뛰어넘는 패러다임 전환이 될 것입니다.

함께 첨부한 인포그래픽은 스타마인드 AI의 핵심 4대 구성 요소와 경제적 관점의 총평을 디테일하게 잘 보여주고 있습니다. 인포그래픽을 직접 보기 어려운 분들을 위해 경제 에디터의 시각을 담아 상세한 대체 텍스트를 작성했습니다.

[인포그래픽 대체 텍스트: 스페이스X 스타마인드 AI 딥다이브]
본 인포그래픽은 'STARMIND AI: SPACEX’S ORBITAL DATA CENTER INITIATIVE (스타마인드 AI: 스페이스X의 궤도 데이터센터 이니셔티브)'라는 제목 아래, 우주 공간을 배경으로 화려한 미래형 위성과 네 가지 핵심 요소, 그리고 경제학적 총평을 담고 있습니다.

[메인 비주얼 및 상단]
인포그래픽 상단에는 푸른 지구 곡선 위로 'STARMIND AI'라는 글자가 선명한 거대한 미래형 데이터센터 위성이 떠 있습니다. 이 위성에는 'AI1'이라는 모델명이 새겨져 있으며, 마치 심장처럼 파랗게 빛나는 AI 연산 노드가 데이터 스트림을 우주로 뿜어내고 있습니다.

[4대 핵심 구성 요소 분석]
그 아래로 핵심 미션, 전력원, 데이터 통신, 핵심 기술의 4가지 부문이 상세한 아이콘 및 설명과 함께 배치되어 있습니다.

CORE MISSION (핵심 미션)

아이콘: 위성 내부에 서버 랙이 꽉 차 있고, 그 중심에 'AI'라고 새겨진 두뇌가 빛나고 있습니다.

설명: 궤도 상에 AI 데이터센터 구축. 우주 환경에서 대규모 AI 연산 직접 처리.

일정: 'LAUNCH: ~2027 (PROTOTYPE)' (2027년 경 시제품 발사 목표)

POWER SOURCE (전력원)

아이콘: 새의 날개처럼 활짝 펼쳐진 거대한 태양광 패널 배열.

설명: 보잉 747기 동체보다 넓은 70m급 초대형 태양광 패널. 평균 출력 약 120kW, 최대 150kW급 전력 공급. 열은 우주 진공으로 방출하는 패시브 복사 냉각 방식 활용.

DATA TRANSMISSION (데이터 통신)

아이콘: 4기의 위성이 붉은색 레이저로 촘촘하게 메시(Mesh) 네트워크를 형성하고 있습니다.

설명: 기존 스타링크의 위성 간 광학 레이저 통신망을 연산 데이터 전송의 '백홀'로 활용. 현재 초당 200Gbps 수준이며, 향후 1Tbps까지 업그레이드 계획. 연산이 끝난 결과값만 지상으로 전송.

KEY TECHNOLOGY & INFRASTRUCTURE (핵심 기술 및 인프라)

아이콘: 방패 모양의 보호막 아래 'NVIDIA VERA RUBIN'이라고 쓰인 엔비디아의 차세대 GPU 칩이 빛나고 있습니다.

설명: 엔비디아의 차세대 GPU 아키텍처인 '베라 루빈(Vera Rubin)' 탑재 가능성 시사. 최첨단 미세 공정 칩을 우주 방사선으로부터 보호하기 위한 물리적 차폐(Radiation Hardening) 및 소프트웨어 차원의 TMR(삼중 다중화) 설계가 필수적.

[경제학적 시각 (ECONOMIST’S VIEW)]
인포그래픽 하단에는 돋보기로 지구본과 상승하는 경제 그래프를 관찰하는 아이콘과 함께 경제학자/투자자의 관점에서 이 프로젝트를 총평하는 섹션이 있습니다.

총평: 수송(스타십)+통신(스타링크)+AI(xAI)를 일원화한 독보적인 시스템 통합 프로젝트.

리스크 및 체크포인트: 기술적 실현 가능성을 넘어 실제 지상 데이터센터보다 저렴할지에 대한 경제성(Economic Viability), 우주 방사선으로 인한 하드웨어 수명 단축 및 교체 주기 비용, 궤도 혼잡 및 우주 쓰레기 논란, 규제 승인 불확실성.

[하단 일정표 (로드맵)]
오른쪽 하단에는 규제 승인부터 양산까지의 타임라인을 나타내는 화살표가 있습니다.

REGULATORY APPROVAL (PENDING) (규제 승인 대기 중): FCC 등 규제 당국의 심사 단계.

2027 PROTOTYPE (2027년 시제품): 첫 하드웨어(AI1) 궤도 발사 및 검증.

2027+ MASS PRODUCTION (GIGASAT) (2027년 이후 양산): 텍사스 '기가샛' 시설에서의 대량 생산.

    최근 우주에 대한 관심이 높아지고 있는 가운데 스타마인드 AI에 대한 관심이 뜨겂습니다. 이유는 생성형 AI 기술의 폭발적 성장과 함께 전 세계 빅테크 기업들이 공통적으로 직면한 최대 병목 현상은 바로 ‘데이터센터 전력 공급’과 ‘부지 및 용수 확보’인데 이 해답을 우주에서 찾고 있기 때문입니다. AI 모델이 고도화될수록 지상 데이터센터가 소모하는 전력과 냉각수 비용은 기하급수적으로 증가하고 있으며, 탄소 배출 규제 및 지역 사회의 반발 또한 거세지고 있습니다.

    이러한 지상 인프라의 한계를 근본적으로 깨부수기 위해, 일론 머스크의 스페이스X(SpaceX)와 xAI가 파격적인 해법을 제시했습니다. 바로 우주 궤도 상에 대규모 AI 데이터센터를 구축하는 ‘스타마인드 AI(StarMind AI)’ 프로젝트입니다.

    오늘은 스페이스X가 FCC(미국 연방통신위원회)에 제출한 신청서와 공식 발표 내용, 그리고 그 뒤에 숨겨진 엔지니어링 이슈와 투자 시장에 미칠 파급력을 디테일하게 분석해 보겠습니다.

    1. 스타마인드 AI(StarMind AI) 핵심 개요 정리

    많은 분들이 기존의 스타링크(Starlink)와 스타마인드를 혼동하시곤 합니다. 두 시스템의 차이점을 한 문장으로 요약하자면 다음과 같습니다.

    “스타링크가 지구 표면을 연결하는 ‘파이프(관)’라면, 스타마인드는 그 관 속을 흐르는 데이터를 직접 연산하는 ‘서버(데이터센터)’이다.”

    주요 발표 및 신청 내용 요약

    • 프로젝트명: 스타마인드 AI (StarMind AI)
    • 임무: 지구 저궤도(LEO)상에서 대규모 AI 연산을 처리하는 궤도 데이터센터 구축
    • 최초 하드웨어 모델명: AI1 (프로토타입 2기, 2027년 초 발사 목표)
    • 양산 목표: 2027년 말, 텍사스 배스트롭의 ‘기가샛(Gigasat)’ 시설에서 양산 개시
    • 운용 규모 및 고도: FCC 신청서 기준 최대 100만 기의 위성, 지표면 500~2,000km 고도 궤도 셸에서 운용
    • 핵심 연산 반도체: 엔비디아(NVIDIA)의 차세대 GPU 아키텍처인 베라 루빈(Vera Rubin) 탑재 가능성 시사
    • 에너지 및 냉각: 위성당 확장 시 날개폭 70m급 태양광 패널 적용 (평균 출력 약 120kW, 최대 150kW), 우주 진공 환경을 활용한 복사 냉각
    • 통신 백홀: 기존 스타링크의 광학 레이저 통신망(Inter-Satellite Laser Link, 초당 200Gbps -> 향후 1Tbps) 활용

    서비스 구동 방식: B2C가 아닌 백엔드 인프라(Back-end Infrastructure)

    일반 사용자가 “스타마인드 위성에 직접 접속”하거나 전용 프로그램에 로그인하는 형태가 아닙니다. 우리가 AWS나 MS Azure의 물리적 서버 위치를 인식하지 않고 클라우드 서비스를 이용하듯, xAI의 챗봇 서비스인 ‘그록(Grok)’ 등을 이용할 때 내부적인 추론(Inference) 연산 일부가 우주에 떠 있는 스타마인드 위성 네트워크에서 자동 처리되는 구조입니다.

    2. 기술적 난제와 물리적 한계 분석

    지상 데이터센터를 우주로 옮기는 작업은 단순한 발상의 전환을 넘어 심각한 물리적 한계 극복을 요구합니다.

    ① 방열(Thermal Management)의 역설: 대류가 없는 진공의 함정

    스페이스X의 발표나 일부 매체에서는 “우주의 진공 상태를 이용해 자연 냉각을 하므로 냉각수가 필요 없다”고 설명하지만, 이는 열역학 관점에서 오해의 소지가 큽니다.

    열전달의 3대 요소는 전도, 대류, 복사입니다. 지구상에서는 공기나 물을 이용한 ‘대류’로 열을 손쉽게 식히지만, 우주 진공 환경에는 매질(공기)이 없어 대류가 불가능합니다. 따라서 위성에서 발생하는 열은 오직 ‘복사(Radiation)’ 형태로만 외부로 방출해야 합니다.

    • 열밀도 문제: 엔비디아 베라 루빈급 최첨단 GPU는 칩 하나당 수백 W에서 1kW 이상의 열을 발생시킵니다. 위성 전체의 150kW 전력 중 대부분은 결국 열 에너지로 전환됩니다.
    • 열 불균형: 태양을 직접 받는 면은 100℃ 이상으로 가열되고, 반대쪽 그늘진 면은 -100℃ 이하로 떨어집니다.
    • 해결 기술 추정: 칩에서 발생하는 열을 빠르게 외곽 방열판으로 전달하기 위한 루프 히트파이프(Loop Heat Pipe, LHP) 및 대형 복사 라디에이터 패널 설계가 필수적입니다. 지상보다 냉각 효율이 현저히 떨어지는 우주 진공에서 GPU의 쓰로틀링(성능 저하) 없는 동적 온도 제어는 미증유의 과제입니다.

    ② 방사선 차폐(Radiation Hardening)와 칩의 수명 주기

    지구 대기권과 자기장의 보호를 받지 못하는 저궤도 환경은 태양 양성자(Proton) 및 은하 우주선(GCR)에 직접 노출됩니다.

    • SEU / SEL 위험: 베라 루빈 GPU처럼 3nm 이하의 초미세 공정으로 제조된 칩은 트랜지스터 게이트가 극도로 작아, 단 하나의 방사선 입자 타격으로도 데이터가 뒤집히는 SEU(Single Event Upset)나 칩이 파괴되는 SEL(Single Event Latch-up)에 매우 취약합니다.
    • 해결 전략: 우주 전용 RAD-Hard 칩은 성능이 일반 GPU의 1,000분의 1에 불과하여 대규모 LLM 연산이 불가능합니다. 결국 상용 COTS(Commercial Off-The-Shelf) GPU를 사용하되, 삼중 다중화(Triple Modular Redundancy, TMR) 소프트웨어 알고리즘 및 텅스텐·알루미늄 합성 신소재 차폐를 적용할 것으로 보입니다.
    • 경제성 변수: 방사선 노출로 인해 궤도 상 GPU의 실사용 수명이 지상(3~5년)보다 훨씬 단축된다면, 지속적인 재발사 비용으로 인해 프로젝트의 경제성이 크게 훼손될 수 있습니다.

    ③ 전력 분배 및 정밀 지향 통신 (OWC)

    70m급 대형 태양광 패널에서 생산되는 150kW 전력을 손실 없이 GPU 서버로 전달하기 위해서는 광반도체(GaN/SiC) 기반의 전력 변환 분배 장치(PDU)가 고도화되어야 합니다.

    또한, 시속 27,000km로 회전하는 위성 간에 초당 테라비트(Tbps)급 데이터를 주고받기 위한 광학 레이저 통신(ISL) 정밀 지향 제어(Fine Pointing and Tracking)와, 위성 간 분산 AI 추론(Pipeline/Tensor Parallelism) 기술의 구현 난이도는 지상 데이터센터 내부 네트워크 환경과 비교할 수 없을 정도로 복잡합니다.

    3. 글로벌 Big Tech 기술 및 인프라 구도 비교

    현재 AI 인프라 시장을 주도하는 주요 글로벌 기업들과 스페이스X의 스타마인드 AI 전략을 비교 정리했습니다.

    구분스페이스X (StarMind AI)엔비디아 (NVIDIA)구글 (Google)아마존 (Amazon)
    핵심 역할우주 AI 데이터센터 플랫폼 구축AI 연산 아키텍처 및 GPU 제공지상 데이터센터 & TPU 클라우드Kuiper 통신망 & AWS 클라우드
    강점• 수송(Starship) + 통신(Starlink) + AI(xAI) 통합
    • 지상 부지/전력/탄소 규제 완전 회피
    • AI 반도체 독점적 지위
    • HBM4 등 최상위 대역폭
    • 최고 수준의 TPU 전력 효율성
    • 자체 AI 알고리즘(Gemini) 보유
    • AWS 생태계와의 완벽한 연동성
    • 우주 Edge 컴퓨팅 검증 경험
    약점/한계• 방사선/열관리로 인한 짧은 하드웨어 수명
    • 궤도 혼잡 및 규제 승인 불확실성
    • 우주용 환경 신뢰성 검증을 외부(스페이스X 등)에 의존• 지상 데이터센터 전력망 난관 직면
    • 우주 데이터센터 시도 미진
    • 스페이스X 대비 발사체/위성 수량 열세

    핵심 시사점

    빅테크 기업들이 지상 데이터센터 전력 수급을 위해 원자력 발전소(SMR) 계약까지 체결하는 상황에서, 스페이스X는 스타십(Starship)이라는 독점적 수송 수단을 바탕으로 “데이터센터 부지 자체를 우주로 옮기는” 파격적 패러다임 전환을 시도하고 있습니다.

    단위 전력당 최고 연산 성능(TFLOPS/Watt)을 내는 엔비디아의 베라 루빈 칩과 스페이스X의 우주 인프라 결합은 지상 클라우드 기업들에게 강력한 위협이자 새로운 협력 모델이 될 수 있습니다.

    4. 투자자 관점에서의 리스크 및 체크포인트

    투자자 입장에서 스타마인드 AI 프로젝트를 바라볼 때는 화려한 비전 속에 숨겨진 리스크 요인을 엄밀히 따져보아야 합니다.

    1. 공식 스펙 vs 합리적 추정의 구분: 현재 FCC에 제출된 신청서 등 공식 문서에는 탑재 칩 종류, 세부 전력 예산, 방사선 차폐 방식 등 구체적 하드웨어 사양이 비어 있습니다. 즉, 언론에 보도되는 다수의 세부 기술 스펙은 엔지니어링 관점의 합리적 추정일 가능성이 높으므로 최종 승인 및 프로토타입 발사(2027년) 결과를 주시해야 합니다.
    2. 규제 승인 장벽: FCC 승인 절차가 장기화될 수 있으며, 이미 스타링크로 인해 제기된 천문학계의 관측 방해 논란 및 우주 쓰레기(Orbital Debris) 및 궤도 과밀화 문제는 100만 기 배치 구상의 큰 걸림돌입니다.
    3. 경제성 검증: 스타십을 통한 발사 비용 절감에도 불구하고, 궤도 상 하드웨어의 짧은 교체 주기와 유지보수 불가능성을 고려할 때 실제 지상 데이터센터 대비 TCO(총소유비용) 경쟁력을 확보할 수 있을지 검증이 필요합니다.

    5. 결론 및 요약

    스페이스X의 스타마인드 AI는 단순히 위성 몇 대를 더 띄우는 프로젝트가 아닙니다. [스타십 발사체 + 스타링크 레이저 통신 + xAI 소프트웨어 + 엔비디아 최첨단 GPU]라는 독보적 밸류체인이 결합하여 지상 데이터센터의 전력 및 환경적 한계를 우주 공간에서 극복하려는 거대한 인프라 혁신입니다.

    2027년 예정된 AI1 프로토타입 발사와 FCC의 규제 승인 향방은 우주 항공 산업뿐만 아니라 AI 반도체, 클라우드 인프라, 우주용 신소재 부품주 시장 전체의 향방을 가름할 핵심 관전 포인트가 될 것입니다.

    관련 기사:

    https://www.edaily.co.kr/News/Read?newsId=02256646645544368&mediaCodeNo=257&OutLnkChk=Y

  • [2026.06.01]컴퓨텍스 2026 분석: ‘AI 에이전트’ 동맹의 해체와 대한민국 반도체·소부장 ‘슈퍼 을’ 투자 가이드북

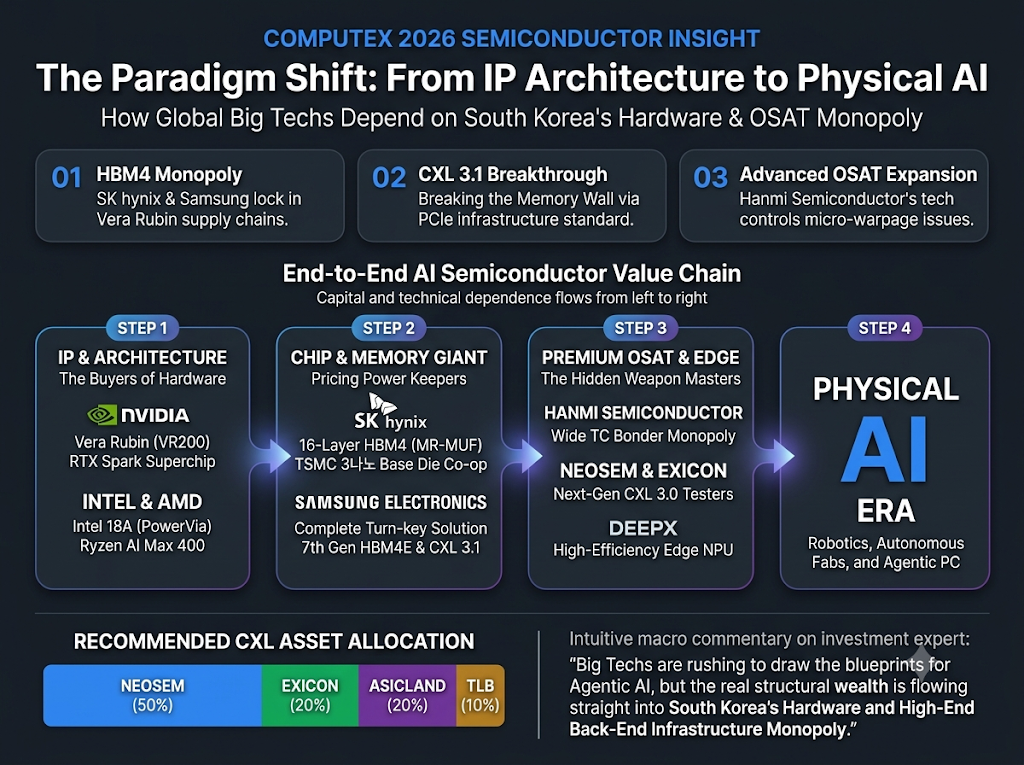
    컴퓨텍스 2026을 기념하여 제작된 반도체 가치사슬(Value Chain) 인포그래픽 이미지입니다. 'IP 아키텍처에서 물리적 AI로의 패러다임 전환'을 주제로, 글로벌 빅테크 기업들이 한국의 하드웨어 및 OSAT(반도체 후공정) 독점 구조에 어떻게 의존하고 있는지 설명하고 있습니다. 다크 블루 배경에 세련된 네온 블루, 그린, 퍼플 컬러가 강조된 프리미엄 미래지향적 디자인입니다.

[상세 구조 및 텍스트 정보]

헤더 영역

상단 타이틀: COMPUTEX 2026 SEMICONDUCTOR INSIGHT

메인 타이틀: The Paradigm Shift: From IP Architecture to Physical AI

서브 타이틀: How Global Big Techs Depend on South Korea's Hardware & OSAT Monopoly

3대 핵심 거시 지표 요약 카드 (상단)

01 HBM4 Monopoly: SK hynix & Samsung lock in Vera Rubin supply chains. (SK하이닉스와 삼성이 엔비디아 베라 루빈 공급망을 선점하고 있음을 명시)

02 CXL 3.1 Breakthrough: Breaking the Memory Wall via PCIe infrastructure standard. (PCIe 인프라 표준을 통해 메모리 벽을 깨는 기술 혁신)

03 Advanced OSAT Expansion: Hanmi Semiconductor's tech controls micro-warpage issues. (한미반도체의 기술이 마이크로 워피지/반전 문제를 제어함)

엔드투엔드 AI 반도체 가치사슬 흐름도 (중앙)
좌측에서 우측으로 갈수록 자본과 기술적 의존도가 흐르는 4단계 구조입니다.

STEP 1: IP & ARCHITECTURE ("The Buyers of Hardware")

NVIDIA: Vera Rubin (VR200), RTX Spark Superchip

INTEL & AMD: Intel 18A (PowerVia), Ryzen AI Max 400

STEP 2: CHIP & MEMORY GIANT ("Pricing Power Keepers")

SK hynix: 16-Layer HBM4 (MR-MUF), TSMC 3나노 Base Die Co-op

SAMSUNG ELECTRONICS: Complete Turn-key Solution, 7th Gen HBM4E & CXL 3.1

STEP 3: PREMIUM OSAT & EDGE ("The Hidden Weapon Masters")

HANMI SEMICONDUCTOR: Wide TC Bonder Monopoly

NEOSEM & EXICON: Next-Gen CXL 3.0 Testers

DEEPX: High-Efficiency Edge NPU

STEP 4: PHYSICAL AI ERA

Robotics, Autonomous Fabs, and Agentic PC (로봇 공학, 자율형 팹, 에이전틱 PC로 연결되는 물리적 AI 시대 기술 적용)

하단 섹션: 자산 배분 전략 및 전문가 평론

RECOMMENDED CXL ASSET ALLOCATION (추천 CXL 자산 배분 바 차트)

NEOSEM (50%), EXICON (20%), ASICLAND (20%), TLB (10%)

하단 주석: 차세대 메모리 병목 현상을 타겟으로 한 다변화된 방어 전략

투자 대가의 직관적 매크로 평론

"Big Techs are rushing to draw the blueprints for Agentic AI, but the real structural wealth is flowing straight into South Korea's Hardware and High-End Back-End Infrastructure Monopoly."

(해석: 빅테크 기업들이 에이전틱 AI의 청사진을 그리기 위해 질주하고 있지만, 실제 구조적인 부는 한국의 하드웨어 및 고엔드 후공정 인프라 독점권으로 곧장 흘러 들어가고 있다.)

    타이베이 컴퓨텍스(COMPUTEX) 2026 현장의 생생한 단서들은 지금 자본 시장이 어디로 미친 듯이 몰려가고 있는지, 그리고 향후 수년간 어떤 기업이 거대한 부를 쥐게 될지 증명하는 강력한 선행 지표입니다.

    올해 컴퓨텍스의 슬로건은 “AI Together”이지만, 투자자의 스크린에 투사된 진짜 본질은 “을(Supplier)의 초격차 무기와 갑(Buyer)의 종속”입니다. 설계 자산(IP)을 가진 빅테크들이 화려한 스포트라이트를 받으며 무대에 서지만, 이를 물리적 실체로 구현해 내는 하드웨어 인프라와 독점적 후공정 장비 공급망을 쥔 기업들이 가격 결정권(Pricing Power)을 완벽하게 장악했기 때문입니다.

    엔지니어님의 기술 분석을 경제학적 밸류체인(Value Chain)과 자본의 역학 구조로 치환하여, 투자자가 반드시 거머쥐어야 할 ‘컴퓨텍스 2026 핵심 투자 바이블’을 아주 딥하게 전해드립니다.

    1. Macro 관점의 판도 변화 및 투자 요약

    시장의 판도가 요동치고 있습니다. 이번 컴퓨텍스 2026에서 드러난 거시적 변화는 크게 두 가지 타임라인으로 요약됩니다.

    ⏳ 단기적 관점 (6개월~1년): 메모리 쇼티지(Shortage)와 수율 통제력

    엔비디아의 차세대 아키텍처 ‘베라 루빈(Vera Rubin, VR200)’의 본격 양산 스케줄이 당초 예상보다 빨라졌습니다. 이 거대한 가속기 랙 인프라가 요구하는 부품 수는 무려 200만 개에 달합니다.

    그중에서도 가장 극심한 병목이 걸린 곳은 단연 6세대 고대역폭 메모리인 HBM4와 이종 집적 패키징을 위한 초정밀 후공정 장비입니다. 당장 올해 하반기부터 내년까지 실적의 숫자가 가장 확실하고 가시적으로 찍힐 밸류체인 최상위 포지션 기업에 자본을 압축 대응해야 하는 이유입니다.

    🔭 중장기적 관점 (3년~5년): ‘Wintel’ 동맹의 해체와 물리적 에이전트의 대중화

    엔비디아가 미디어텍과 손잡고 출시한 ‘RTX Spark’ 슈퍼칩은 단순한 신제품이 아닙니다. 지난 수십 년간 전 세계 PC 생태계를 지배해 온 ‘윈텔(Wintel: Windows + Intel)’ 동맹의 몰락을 알리는 서막입니다.

    향후 온디바이스(On-device) 디바이스 시장은 ‘더 저렴한 프로세서’가 아니라, ‘OS 레벨에서 AI 에이전트를 독립적으로 구동할 수 있는 저전력 고효율 아키텍처’와 ‘이종 집적 패키징 역량’을 내재화한 진영이 헤게모니를 쥘 것입니다. 자본은 이 아키텍처 전환 과정에서 필수재를 공급하는 생태계 지배자들에게 장기 정착할 것입니다.

    2. 반도체 양대 거인 분석: SK하이닉스 vs 삼성전자

    엔비디아, 인텔, AMD의 화려한 연설 뒤에서 실제 주가를 움직이는 가장 큰 에너지는 한국의 메모리 반도체 밸류체인입니다. 젠슨 황 CEO가 직접 “루빈 플랫폼에 한국의 HBM4가 탑재된다”고 공식 확인해 주면서 양사의 주도권 싸움은 한층 더 격렬해졌습니다.

    🥇 SK하이닉스(000660): 엔비디아-TSMC 삼각동맹의 절대적 수혜주

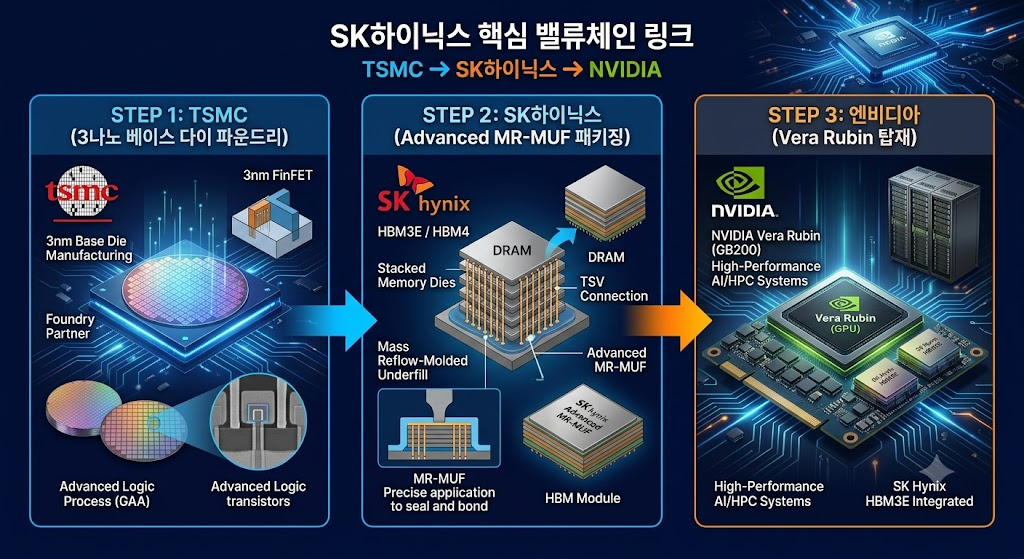
    “Advanced MR-MUF 기반 16단 HBM4 선점으로 탑티어(Top-tier) 권력 수성”

    💡 기술적 자산과 투자 가치

    SK하이닉스가 세계 최초로 실물을 공개한 16단 HBM4(48GB)는 동사의 기술적 해자(Moat)가 얼마나 단단한지 보여줍니다. 6세대 HBM부터는 베이스 다이(Base Die)를 기존 메모리 공정이 아닌 TSMC의 최첨단 파운드리 공정(3나노 등)으로 제작해야 합니다.

    이는 단순히 제품을 잘 만드는 것을 넘어, ‘TSMC-하이닉스-엔비디아’로 이어지는 삼각 원팀 동맹에 균열을 내기가 후발주자 입장에서 대단히 어렵다는 뜻입니다. 베라 루빈 초기 물량의 약 60~70%를 하이닉스가 선점할 것이라는 시장의 관측은 하반기 주가 리레이팅(Re-rating)의 강력한 촉매입니다.

    ⚠️ 재무적 리스크 및 모니터링 포인트

    가장 큰 변수는 대규모 설비투자(CAPEX)의 효율성입니다. 칩이 얇아지면서 발생하는 휘어짐 현상과 발열을 잡기 위해 소재 비용이 상승하고 있습니다.

    이번에 발표한 엔비디아 옴니버스 기반의 ‘디지털 트윈(Digital Twin) 팹’ 구축은 단순한 기술 자랑이 아니라, 수백 단계 공정의 병목을 가상 시뮬레이션으로 제어하여 초기 수율 리스크를 비용 측면에서 얼마나 방어해 내느냐가 핵심입니다. 수율 안정화 속도가 동사의 2026년 하반기 영업이익률의 스윗 스팟을 결정할 것입니다. [중장기 Buy & Hold 전략 유효]

    🥈 삼성전자(005930): 턴키(Turn-key) 솔루션을 무기로 한 거대한 역습

    “루빈 공급망 진입 확정과 7세대 HBM4E 선공개를 통한 판도 뒤집기”

    💡 기술적 자산과 투자 가치

    그간 시장에서 삼성전자를 짓누르던 HBM 검증 불확실성이 이번 컴퓨텍스 2026을 기점으로 완전히 해소되었습니다. 루빈 플랫폼 공급망의 약 25~30% 물량을 확보한 것으로 추정되는 가운데, 삼성은 시장의 예상을 깨고 2027년 출시 예정인 베라 루빈 울트라향 7세대 ‘HBM4E’ 샘플을 선제적으로 출하하며 전면에 전시했습니다. 이는 후발주자로서의 추격 속도가 무서운 수준에 도달했음을 의미합니다.

    🌟 종합 반도체 기업(IDM)의 진가: 원스톱 패키지

    삼성전자의 진짜 무서운 무기는 ‘종합 턴키(Turn-key) 솔루션’ 능력에 있습니다. 하이닉스 연합군과 달리 삼성은 다음을 자체적으로 해결할 수 있는 지구상 유일한 기업입니다.

    • 메모리(HBM4) 제조
    • 파운드리(베이스 다이) 생산
    • 어드밴스드 패키징(I-Cube) 공정

    글로벌 빅테크(CSP)들이 엔비디아의 독점을 깨기 위해 맞춤형(Custom) AI 가속기를 자체 설계할 때, 개발 기간을 극적으로 줄이고 비용(TCO)을 아낄 수 있는 삼성의 턴키 솔루션은 거부할 수 없는 대안이 됩니다.

    더불어, 엔지니어님께서 강조하신 데이터센터의 용량 한계를 깨는 CXL 3.0/3.1 기반 메모리 모듈(CMM) 생태계 선점은 HBM 이후 삼성전자의 중장기 밸류에이션을 지탱할 거대한 캐시카우가 될 것입니다. [단기 트레이딩 펀더멘털 회복 및 중장기 비중 확대 전략]

    3. 무대 뒤의 진짜 지배자: 국내 소부장 및 강소기업 정밀 분석

    자본 시장에서 진짜 폭발적인 수익률(멀티플)은 모두가 아는 거인들이 아니라, 그 거인들의 손에 독점 작전 무기를 쥐여주는 ‘슈퍼 을’ 기업에서 나옵니다. 이번 컴퓨텍스 2026에서 글로벌 빅테크들의 러브콜을 받으며 밸류체인의 핵심 축으로 우뚝 선 국내 기업들을 정밀 해부합니다.

    🚀 한미반도체(042700): HBM 패키징 공정의 대체 불가능한 지배자

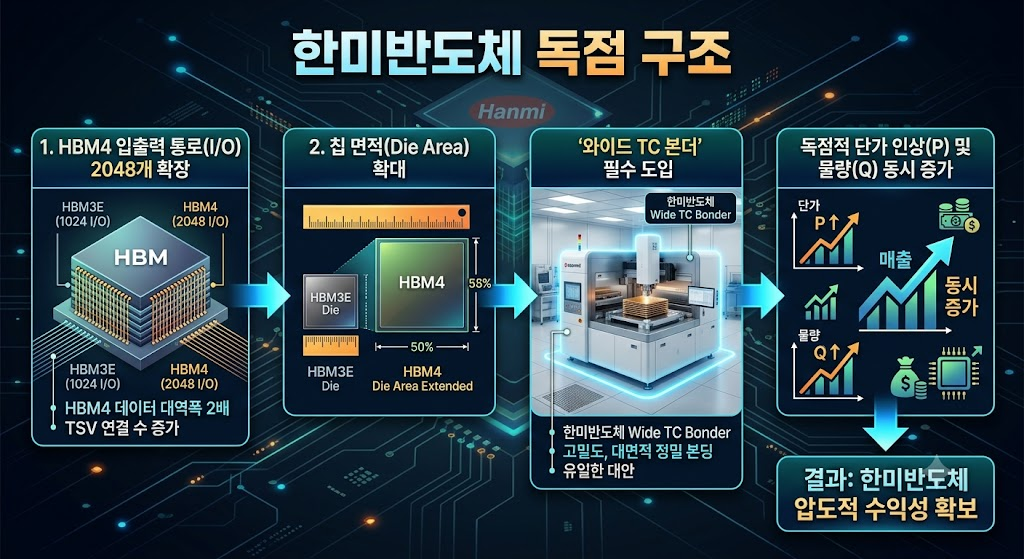
    “칩 면적 확대(Wide) 트렌드에 따른 ‘와이드 TC 본더’ 독점 공급망 장악”

    📊 투자 핵심 요약

    HBM4부터는 데이터 고속도로(I/O)가 2048개로 기존보다 2배 넓어집니다. 실리콘 다이의 면적 자체가 옆으로 넓어진다는 뜻입니다. 한미반도체가 이번 컴퓨텍스에서 최초로 공개한 ‘와이드 TC 본더(Wide Thermocompressor Bonder)’는 이 넓어진 칩을 마이크로미터 단위의 오차 없이 정밀하게 수직 적층하는 장비입니다.

    📈 밸류에이션 및 아웃룩

    하이닉스의 16단 HBM4 독점 공급망을 뒷받침하는 핵심 뼈대일 뿐만 아니라, 컴퓨텍스 현장에서 대만 TSMC의 최첨단 패키징 라인(CoWoS) 관계자들이 줄을 서서 미팅을 진행한 점에 주목해야 합니다. 현재 주가가 다소 높은 멀티플(PER)을 적용받고 있는 것은 사실이나, HBM의 단수 증가와 면적 확대에 따른 장비 교체 주기는 동사의 매출 패스를 가파른 우상향으로 이끌 것입니다. 시장의 조정을 받을 때마다 무조건 주워 담아야 할 0순위 장비주입니다.

    🧠 딥엑스(DEEPX – 상장 준비 중): 피지컬 AI 시대의 엣지(Edge) 제왕

    “전력 제약이 극심한 로봇 및 온디바이스 환경을 저격하는 독보적 가성비 NPU”

    📊 투자 핵심 요약

    엔비디아가 데이터센터라는 거대한 전력 괴물을 움직인다면, 딥엑스는 공장, 자율주행 로봇, CCTV 등 단 몇 와트(W)의 전력만 허용되는 가혹한 환경을 지배할 ‘DX-M1’ 칩을 보유하고 있습니다. 이번 컴퓨텍스 2026에 신설된 ‘AI 로보틱스 존’에서 30여 개 글로벌 기업과의 협력을 발표하며 현지 분위기를 뒤흔들었습니다.

    📈 밸류에이션 및 아웃룩

    이들의 핵심 자산은 인공지능 모델의 정확도 손실 없이 데이터 연산 정밀도를 낮추어 속도를 극대화하는 양자화(Quantization) 및 압축 알고리즘 기술력입니다. 가상 세계의 AI 에이전트가 현실 세계의 기기(Physical AI)로 튀어나오는 현시점에서 가장 가파른 성장 모멘텀을 가졌습니다. IPO(기업공개) 진행 시 공모주 청약은 물론, 프리 IPO 지분을 보유한 상장사나 관련 펀드까지 추적하여 포트폴리오에 반드시 편입해야 할 숨은 보석입니다.

    💻 알세미(ALSEMI) & SK텔레콤(017670): 제조 공정용 ‘에이전틱 디지털 트윈’의 심장

    “물리 법칙 기반 시뮬레이션과 LLM 에이전트 아키텍처의 결합”

    📊 투자 핵심 요약

    반도체와 디스플레이 공정은 눈에 보이지 않는 화학 반응과 유체역학 등 가혹한 물리 법칙의 지배를 받습니다. 인공지능 스타트업 ‘알세미’와 LG디스플레이가 연합하여 엔비디아의 ‘피직스니모(PhysicsNeMo)’를 이식해 만든 디지털 트윈 생산 시스템(DPS)은 단순한 모니터링 툴이 아닙니다.

    “특정 챔버의 온도가 미세하게 변했을 때 회로막 수율이 어떻게 변하는지”를 실시간 시뮬레이션해 내는 소프트웨어 공학의 결정체입니다. 여기에 SK텔레콤의 ‘에이전틱 디지털 트윈 모델링’ 기술이 결합되어, 사람이 도면을 입력하지 않아도 AI 에이전트가 공장의 구동 데이터를 스스로 학습해 디지털 트윈 환경을 자동 업데이트합니다.

    📈 밸류에이션 및 아웃룩

    SK텔레콤은 이제 단순한 통신 배당주가 아닙니다. 엔비디아 오케스트레이션(Omniverse) 생태계 위에서 자율 제조 공장(Autonomous Factory)의 뼈대를 구축하는 ‘AI 인프라 프로바이더’로의 체질 개선(Valuation Multiple 격상)이 진행 중입니다. 수율 향상에 목마른 글로벌 반도체 Fab들이 대거 도입을 검토하고 있어, 기업향(B2B) AI 소프트웨어 부문에서 가장 먼저 대규모 매출 유입이 기대되는 확실한 모멘텀입니다.

    📺 삼성디스플레이: AI PC 하드웨어 설계 마진의 구원투수

    “울트라 슬림(Ultra Slim) OLED 패키징을 통한 물리적 공간 확보”

    📊 투자 핵심 요약

    인텔의 노바레이크(Nova Lake)와 엔비디아의 RTX Spark 등 온디바이스 AI 칩셋들의 성능이 폭발하면서 노트북 제조사들은 고질적인 문제에 직면했습니다. 발열을 잡기 위한 쿨링 솔루션(히트파이프, 대형 팬)과 고전력 소모를 버틸 대용량 배터리가 하판 공간을 가득 채워야 하기 때문입니다.

    📈 밸류에이션 및 아웃룩

    삼성디스플레이가 컴퓨텍스에서 선보인 ‘울트라 슬림 노트북 OLED’ 패널은 기존 양산품 대비 모듈 두께를 20% 이상 줄였습니다. 디스플레이 패널 두께를 극단적으로 깎아준 덕분에, 에이수스(ASUS), MSI 같은 PC 제조사들은 슬림한 디자인을 유지하면서도 고성능 쿨러를 박아 넣을 수 있는 ‘하드웨어 설계 마진’을 확보하게 되었습니다.

    AI PC 시대로의 강제 전환 흐름 속에서 완제품의 승패와 무관하게 모든 글로벌 PC 제조사에 패널을 공급할 수 있는 독점적 지위를 가진 숨은 수혜주입니다. 모회사인 삼성전자 주가에 긍정적인 자회사 지분 가치로 반영될 핵심 트리거입니다.

    4. 블루오션 집중 분석: ‘메모리 벽’을 깨는 CXL 생태계 투자 전략

    30년 동안 시장의 사계절을 겪으며 제가 깨달은 자본 시장의 절대 진리는 하나입니다. “기술의 임계점(Bottleneck)이 발생하는 곳에 언제나 가장 큰 투자 기회와 폭발적인 멀티플이 존재한다”는 점입니다.

    HBM 밸류체인(한미반도체 등)이 이미 거대한 멀티플을 받아 시장의 눈높이가 하늘 높이 가 있다면, 엔지니어님께서 무대 뒤의 핵심 열쇠로 짚어주신 CXL(Compute Express Link)과 메모리 풀링(CMM) 생태계는 이제 막 실적의 숫자가 찍히기 시작하는 ‘무릎’ 단계의 블루오션입니다.

    HBM이 도로의 속도(대역폭)를 극한으로 올리는 기술이라면, CXL은 PCIe 인터페이스 슬롯을 활용해 서버의 메모리 용량을 테라바이트(TB) 단위로 유연하게 확장하고 공유하는 ‘용량과 자원 효율화’의 기술입니다. 가 비싼 GPU의 연산 부담을 메모리가 나누어 갖는 CMM-Ax 아키텍처는 데이터센터의 TCO(총소유비용)를 극적으로 낮출 수 있어 빅테크들이 목을 매고 있는 영역입니다.

    CXL 밸류체인의 단기·중장기 투자 스크린을 낱낱이 파헤쳐 드리겠습니다.

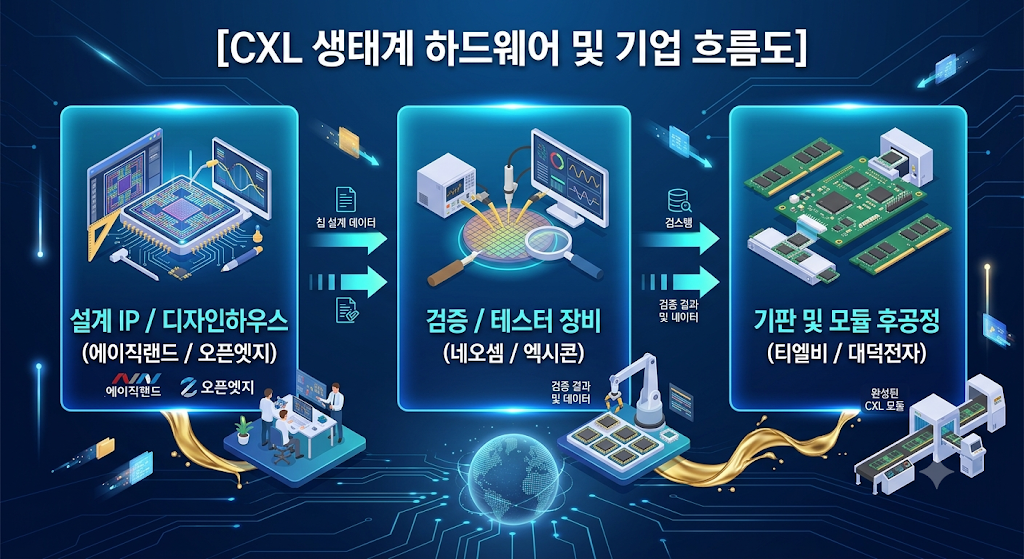
    ❶ 네오셈(253590): CXL 테스터 시장의 글로벌 독점적 지위

    “세계 최초 CXL 2.0 테스터 개발 완료 및 3.0/3.1 상용화의 최대 수혜주”

    📊 투자 분석 (단기 주도주 & 중장기 실적주)

    동사는 SSD 검증 장비 세계 1위 기업이자, CXL 상용화 가시성에서 가장 앞서 있는 명실상부한 대장주입니다. 삼성이 컴퓨텍스 2026에서 CXL 기반 CMM 라인업을 대거 쏟아내면서, 이 제품들을 전수 검사해야 하는 네오셈의 ‘CXL Gen5 테스터 장비’ 수주가 올해 하반기부터 실적으로 직결됩니다.

    🎯 투자자 체크포인트

    CXL 3.0/3.1 프로토콜로 전환될수록 고주파 신호 무결성(Signal Integrity) 테스트의 난이도가 기하급수적으로 올라갑니다. 글로벌 메모리 제조사 두 곳(삼성전자, SK하이닉스)을 모두 핵심 고객사로 두고 있어, 두 거인의 CXL 주도권 싸움에서 ‘누가 이기든 무조건 돈을 버는’ 가장 편안한 포지션에 있습니다.

    ❷ 엑시콘(092870): 삼성전자 핵심 파트너, 차세대 CXL 3.0 테스터 국산화

    “삼성의 ‘턴키(Turn-key)’ 공세에 발맞춘 하드웨어 검증 동반자”

    📊 투자 분석 (단기 모멘텀 및 가파른 턴어라운드)

    삼성전자가 주도하는 CXL 컨소시엄의 핵심 협력사입니다. 메모리 내부에 연산 기능을 넣은 CMM-Ax 같은 차세대 지능형 메모리를 테스트하기 위해서는 컴포넌트 레벨의 고성능 테스터가 필수적인데, 동사가 이 국산화 밸류체인의 최전선에 서 있습니다.

    🎯 투자자 체크포인트

    그간 전방 산업의 디램(DRAM) 업황에 따라 실적 변동성이 컸으나, CXL 테스터 매출이 본격적으로 가세하는 2026년 하반기를 기점으로 이익 체력이 한 단계 레벨업(Re-rating)될 가능성이 매우 높습니다. 기술 난이도가 높은 차세대 3.0 스펙 장비의 샘플 공급 소식이 나올 때마다 강력한 단기 주가 촉매로 작용할 것입니다.

    ❸ 에이직랜드(445090) / 오픈엣지테크놀로지(394280): CXL 컨트롤러 및 IP의 심장

    “TSMC 파운드리와 국내 메모리 생태계를 잇는 CXL 디자인하우스 및 IP 제왕”

    📊 투자 분석 (중장기 성장의 핵심, Buy & Accumulate)

    엔지니어님께서 “HBM4부터는 베이스 다이를 TSMC 파운드리 공정으로 제작하며 TSMC-하이닉스 동맹이 강해질 것”이라 간파하셨습니다. 바로 이 지점에서 에이직랜드의 가치가 폭발합니다. 동사는 국내 유일의 TSMC VCA(공식 가치사슬 협력사, 디자인하우스)입니다. 국내 팹리스나 메모리사가 CXL 컨트롤러 칩을 TSMC 공정을 통해 맞춤형으로 깎을 때 반드시 거쳐야 하는 관문입니다.

    🎯 투자자 체크포인트

    오픈엣지테크놀로지는 CXL 호스트와 메모리 간의 초고속 데이터 전송을 제어하는 CXL PHY 및 컨트롤러 IP를 자체 보유한 기업입니다. 기술적 진입장벽이 가장 높은 ‘설계 자산’ 영역을 담당하므로, 중장기적으로 CXL 시장이 성숙기에 접어들 때 러닝 로열티(Royalty) 구조로 매출 마진율이 극대화되는 매력적인 비즈니스 모델을 가졌습니다. 주가가 눌릴 때마다 수량을 모아가는 장기 적립식 투자가 유효합니다.

    ❹ 티엘비(356860): CXL 전용 고다층 기판(PCB)의 표준 선점

    “DDR5 기반 CUDIMM 및 CXL 모듈용 High-layer 기판의 숨은 강자”

    📊 투자 분석 (중장기 안정적 캐시카우)

    CXL은 기존 메인보드의 PCIe 슬롯에 꽂히는 구조이기 때문에, 기판 자체의 적층 구조와 신호 왜곡을 막는 소재 기술이 완전히 달라집니다. 동사는 국내 최초로 CXL용 대용량 고다층 기판 개발에 성공하여 샘플을 공급 중입니다.

    🎯 투자자 체크포인트

    컴퓨텍스에서 언급된 PC용 CUDIMM(클럭 버퍼 내장 메모리)의 도입과 서버용 CXL 확산은 동사에게 쌍두마차 호재입니다. 메모리 폼팩터가 바뀔 때마다 기판의 판가(P)가 20~30% 이상 격상되므로, 변동성 리스크가 적으면서 안정적인 실적 성장을 바라는 보수적 자산가들에게 훌륭한 대안적 포트폴리오가 될 것입니다.

    5. 리스크 매트릭스 및 투자자 가이드라인

    현직 엔지니어님의 날카로운 아키텍처 경고령을 기반으로, 투자자가 자산을 지키기 위해 반드시 상시 모니터링해야 할 3대 리스크 매트릭스를 구성했습니다.

    리스크 요인핵심 모니터링 포인트투자 대응 전략
    인텔 18A 공정 수율 불확실성PowerVia(후면 전력 공급) 및 RibbonFET 안정화 속도인텔 파운드리 부문의 분기별 흑자 전환 시점 확인 전까지는 인텔 본주에 대한 접근은 보수적으로 제한. 반대로 인텔 가치사슬 내 국내 I/O 부품 벤더의 단기 모멘텀만 취하는 전략.
    액체 냉각(Liquid Cooling) 표준화 지연데이터센터 내 CPO(광집적 패키징) 및 액체 냉각 인프라 도입 속도엔비디아 루빈 랙 인프라 도입 스케줄에 맞춰 국내 냉각 공조 솔루션 관련주(매니폴드, 퀵커넥터 기술 보유사)의 특허 및 공급 계약 체결 여부 선제 선점.
    Wintel 해체에 따른 단기 변동성RTX Spark 탑재 노트북의 2026년 하반기 실제 출하량 지표x86 진영과 Arm 진영의 점유율 싸움 속에서, 어느 쪽이 이기든 필수적으로 들어가는 ‘대용량 통합 메모리(CUDIMM)’ 및 ‘울트라 슬림 OLED 패널’ 제공사로 자산 헤징(Hedging).

    6. 결론

    “글로벌 빅테크들이 ‘AI 에이전트’라는 화려한 신기루의 지도(소프트웨어)를 그릴 때, 자본 시장의 진짜 부는 그 지도를 따라 실제 도로를 닦고 콘크리트를 붓는 한국의 고하이엔드 후공정 장비 및 CXL 가치사슬로 부드럽게 흘러 들어오고 있습니다. 무대 위 젠슨 황의 화려한 프레젠테이션 뒤에 숨겨진 국내 필수재 기업들의 ‘가격 결정권’에 베팅하십시오.”

    HBM에서 소외되었던 자본이 CXL과 이종 집적 패키징이라는 새로운 탈출구를 찾고 있는 지금이 가장 외롭고도 뜨거운 기회입니다.

    💡 투자 시야를 더 넓혀줄 기술 검증 노트

    이번 컴퓨텍스 2026에서 한국 반도체 생태계의 주도권 변화를 이해하는 데 결정적인 도움을 주는 현장 분석 영상을 공유합니다. 엔비디아 기조연설의 이면에 숨겨진 HBM4 수급 가이드라인과 글로벌 빅테크들의 물량 확보전 흐름을 아주 쉽게 정리해 줍니다.

    컴퓨텍스 엔비디아 기조연설, HBM 기대 포인트 분석

    이 영상은 대만 현지에서 진행된 각 기업 간의 검증 타임라인과 향후 실적 램프업 일정을 파악하는 데 유용한 투자 나침반이 될 것입니다.